그동안 서버 개발을 먼저 학습하고 그 과정속에 있던 아키텍처 설계를 간단하게 클라이언트-서버-데이터베이스 이런 구조만 반복하고 생각하다보니 당연하게 사용하고 쓰던 형식이 되어버렸습니다.
소규모로 서비스 하는 것과 대규모로 서비스를 하는 것에 대해, 어떤 차이가 있을지?
그리고 대중화된 서비스들이 설계들이 간단하지 않을텐데.. 라는 생각이 들어서 찾아봤습니다.
먼저 고민들을 정리 하자면,
- 작은 프로젝트가 점점 서비스가 커질때, 해야하는 설계 및 환경
- MSA가 가끔 보이는데 어떤 형식이고, 장점이 무엇일까?
- 트래픽이 늘면 서버를 늘릴텐데 어떤 기준으로 트래픽을 나눌까?
- 최적화를 해서 응답속도를 올리는데 어떤 방식으로 올릴까?
- DB를 늘리면 어떤 방식으로 DB을 늘릴까?
- 채팅 서비스 같은 실시간성이 있는 서비스를 어떤 형식으로 설계할까?
위와 같은 궁금한 점이 많은데, 프로젝트 마다 상황과 환경이 다 다르기 때문에 아키텍처 설계를 다 다르게 해야한다. 그래서 찾아보면서 정리 해보고자 이글을 작성 합니다.
가장 기본적인
단일서버
클라이언트(웹,앱)과 웹,DB,캐시 등등 모든것이 서버 한대에서 처리 되는 구조
여기서 데이터 계층을 불리시키면 데이터베이스를 사용해 분리
사용자가 늘어났을때 서버를 많이 둔다?
수평적, 수직적 규모 확장
- 수평적 규모 확장 (scale up)
- 서버 사양(CPU,) - 수평적 규모 확장 (scale out)
- 서버를 추가해서 트래픽을 분산시켜서 개선
이런 방식으로 웹 서버나 데이터베이스 서버 성능을 개선할 수 있다.
수직적 규모 확장은 단점이 있다.
- 비용 및 자원을 무제한으로 증설은 못한다.
- 장애 대응이 안되어 있어서 장애 발생시 중단된다.
이래서 대규모 트래픽이 발생하는 서비스에는 수평적 규모 확장법을 사용한다.
Scale out을 한다면?
요청을 분산시킨다면 어떻게 할까?
로드 밸런서
서버를 증설하고, 트래픽 부하들을 분산 시킨다.
로드밸런서가 트래픽 부하를 이 웹 서버들에 맞게 고르게 분산시킨다.
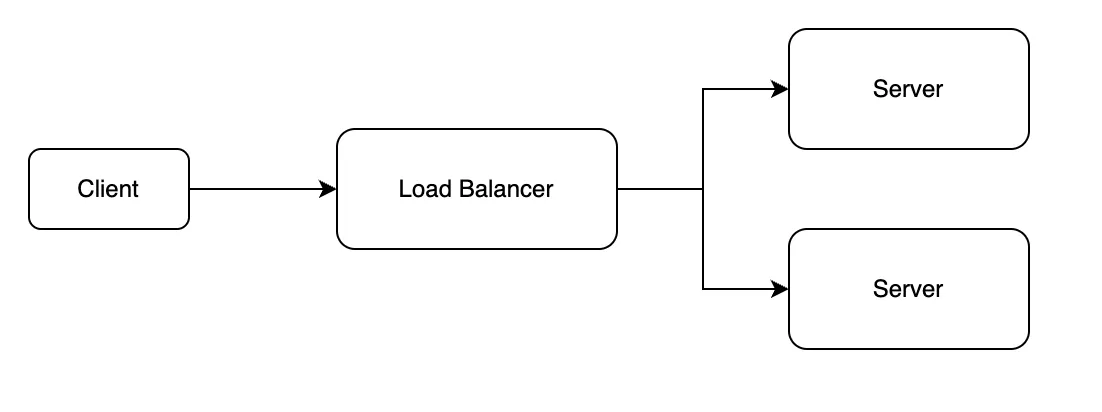
- 클라이언트가 접속하고 로드 밸런서가 IP 주소를 이용해 요청 처리한다.
- 서버 하나가 장애 나면, 다른 서버로 처리.
- 트래픽 증가하면 바로 웹 서버 추가하면 로드 밸런서가 알아서 처리해준다.
웹 서버의 트래픽 처리는 해결했고, 데이터베이스는?
데이터베이스 다중화
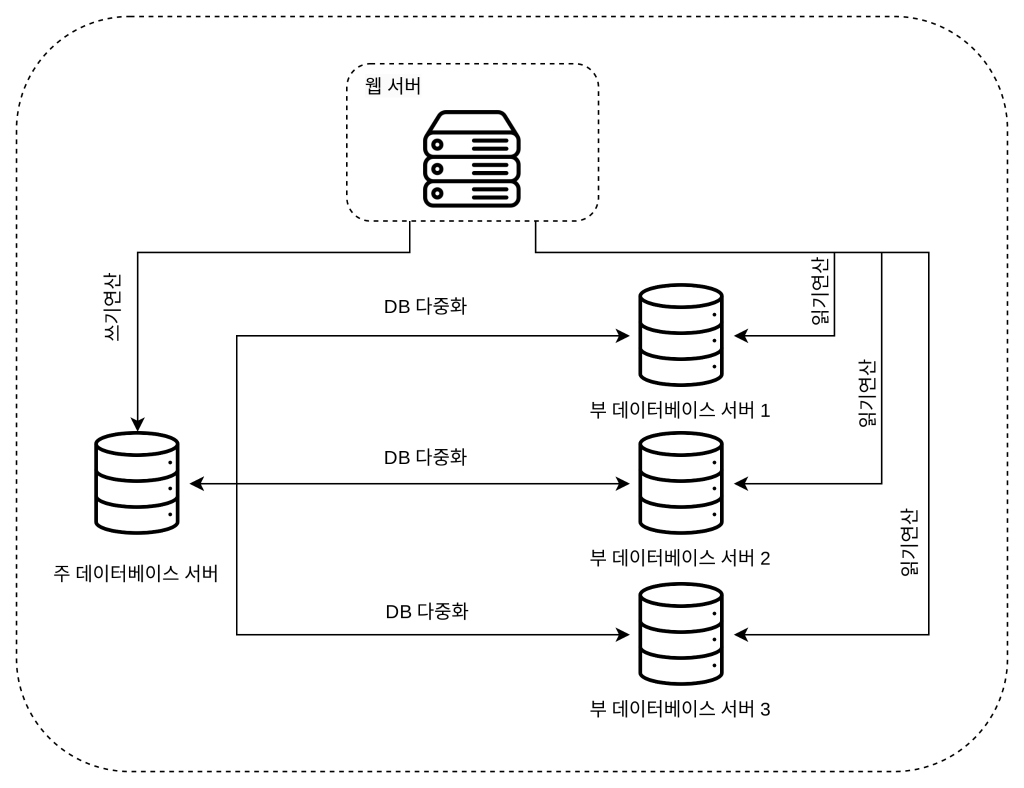
다중화는 서버사이에 주-부 관계를 설정해 데이터 원본은 주서버, 사본은 부 서버에 저장하는 방식.
주로 주서버는 쓰기 연산, 데이터 원본
부 서버는 앍가 연산,데이터 사본
- 보통 애플리케이션은 읽기 연산 비중이 많아서 부 서버가 많다
- 부 서버가 전부 장애시에 주 서버가 읽기 연산 처리.
- 주 서버가 장애 발생 시, 부 서버중 하나가 주서버가 된다.
그런데, 부 서버의 데이터가 최신 상태가 아닐 가능성이 있다, 그래서 없거나 최신 상태가 아니라면, 복구 스크립트로 추가해야 한다. - 이런 문제를 해결 할려면 다중 마스터, 원형 다중화 방식을 고려할수 있다.
출처 : https://jonghoonpark.com/2023/05/01/%EC%82%AC%EC%9A%A9%EC%9E%90-%EC%88%98%EC%97%90-%EB%94%B0%EB%A5%B8-%EA%B7%9C%EB%AA%A8-%ED%99%95%EC%9E%A5%EC%84%B1-2
장점
-
더 나은 성능
데이터 변경 연산은 주 DB에 전달, 읽기 연산은 부 DB로 분산 되서 병렬로 처리될 수 있는 질의 수가 늘어나서 성능이 좋아진다. -
안정성
서버 중 하나가 파괴 및 장애 되도 데이터 보존 가능. -
가용성
데이터를 여러 지역에 복제함으로써, 하나의 DB에 장애 발생하더라도 다른 서버의 데이터를 가져와서 계속 서비스 할 수 있다
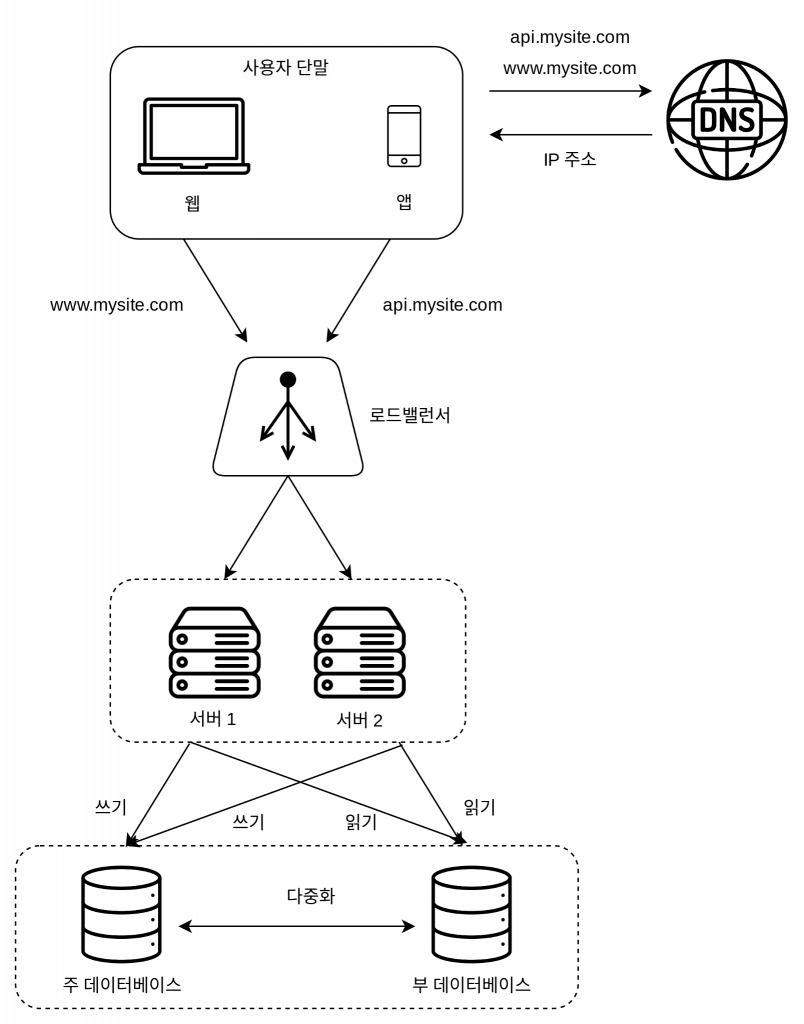
로드 밸런서, 데이터베이스 다중화를 고려한 구조는?
정리
기본 적인 아키텍처 구조에서 살이 붙힌다.
- 웹 계층, 데이터 계층 분리, 각 계층마다 Scale Out
- 트래픽 증가하면 서버를 추가해서 로드 밸런서로 분산
- 데이터 베이스 다중화로 연산 분산.