디자인 패턴 공부 - 인터프리터 패턴
인터프리터 패턴
인터프리터 패턴이란 자주 등장하는 문제를 언어로 정의하고, 재사용할 수 있게 하는 패턴이다. 무슨 말이냐면, 다음의 문제가 있다고 하자
- 숫자는 그대로 스택에 넣는다.
- +가 있다면, 이전의 숫자 두 개를 꺼내고, 그 합을 스택에 넣는다.
- -가 있다면, 이전의 숫자 두 개를 꺼내고, 그 차를 넣는다.
- 123+4+- => -8, 11+2+1- => 3 이런 식이다.
저 숫자로 된 식을 매번 문자열로 넣기는 좀 불편하다. 인터프리터 패턴을 쓰면 그냥 xyz+w+-나 x+y+z-이런식으로 식을 쓰고, 해당되는 값만 map으로 넘겨주면 된다. 마치 SQL문이나 프로그래밍 언어랑 비슷한데, 작은 문제마다 언어를 정의하여 해결할 수 있게 하는 느낌이다.
구현
구현은 컴포지트 패턴이랑 비슷하다. Expression 이라는 인터페이스가 있고, 그것을 구현하는 TerminalExpression과 NonTerminalExpression혹은 Expression의 다양한 구현체들이 있다. 실제로 이것들은 트리 형태로 구현된다.
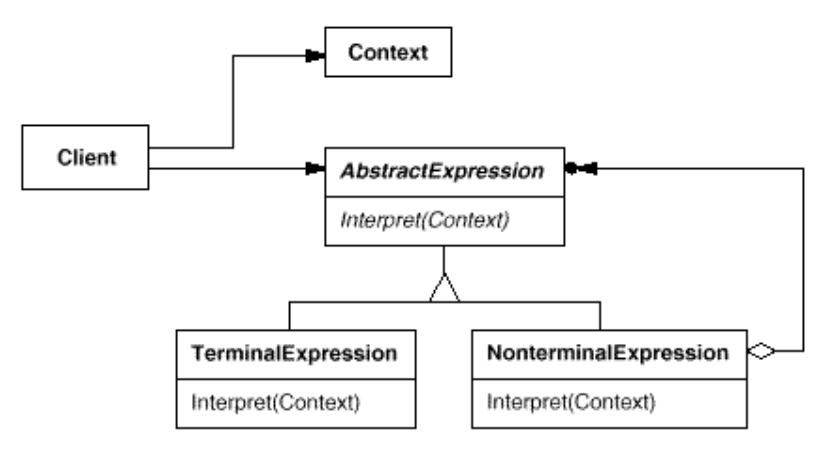
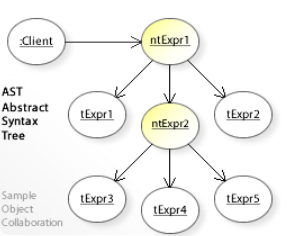
컴포지트 패턴처럼 자기 자식의 메소드를 재귀적으로 호출하는 interpret(Context)라는 함수가 있고, 다형성에 의해서 일률적인 방식으로 재귀적 처리가 가능함을 알 수 있다.
그리고 각 Expression 구현체들은 생성자로 그들이 수행할 규칙을 입력받는다. 무슨 말이냐면, PlusExpression이면 덧셈을 수행할 두 피연산자 Expression을 입력받고, Minus에서는 뺄셈을 수행할 Expression을 받게 된다.
TerminalExpression이면 interpret 메소드에서 값을 바로 리턴(종료되는 식)하고, 아니면(NonTerminal) 자식 Expression들의 interpret 메소드를 다시 호출해 리턴할 것이다.
이때 자식을 가지는 TerminalExpressino이 컴포지트 패턴에서 Composite, NonTerminalExpression이 Leaf에 해당한다고 볼 수 있겠다.
컨텍스트는 규칙에 들어가는 실제 값의 정보를 말한다. 값을 일단 부모 Expression에 넣으면 트리를 타고 계속 넘어가면서 연산에 필요한 실제 값을 알려주게 된다.
일단 인터프리터 패턴을 적용하기 전의 코드이다. 문자열로 아까 패턴 소개에 있었던 규칙을 적용해 결과를 출력하는 것이다.
public class Parser {
	private final String expression;

    public Parser(String expression) {
    	this.expression = expression;
    }

    public void calculate() {
    	Stack<Integer> numbers = new Stack<>();

        for (char c : this.expression.toCharArray()) {
        	switch(c) {
            	case '+':
                	numbers.push(numbers.pop() + numbers.pop());
                    break;
                case '-':
                	int right = numbers.pop();
                    int left = numbers.pop();
                    numbers.push(left - right);
                    break;
                default:
                    numbers.push(Integer.parseInt(c + ""));
            }
        }

        System.out.println(numbers.pop());
    }
}

public class Main {
	public static void main(String[] args) {
    	Parser parser = new Parser("123+-");
        parser.calculate();
    }
}
인터프리터 패턴을 쓰면, Context는 그냥 Map<Character, Integer>으로 대체한다.
public interface Expression {
	public int interpret(Map<Character, Integer> context);
}

public class VariableExpression implements Expression {
	private final Character variable;

    public VariableExpression(Character variable) {
    	this.variable = variable;
    }

    @Override
    public int interpret(Map<Character, Integer> context) {
    	return context.get(variable);
    }

}

public class PlusExpression implements Expression {
	private final Expression left;
    private final Expression right;

    public PlusExpression(Expression left, Expression right) {
    	this.left = left;
        this.right = right;
    }

    @Override
    public int interpret(Map<Character, Integer> context) {
    	return left.interpret(context) + right.interpret(context);
    }
}

public class MinusExpression implements Expression {
	private final Expression left;
    private final Expression right;

    public MinusExpression(Expression left, Expression right) {
    	this.left = left;
        this.right = right;
    }

    @Override
    public int interpret(Map<Character, Integer> context) {
    	return left.interpret(context) - right.interpret(context);
    }
}

public class Main {
	public static void main(String[] args) {
    	// xyz+-a+의 식 정의, AST 정의(Abstract Syntax Tree)
 		Expression x = new VariableExpression('x');
        Expression y = new VariableExpression('y');
        Expression z = new VariableExpression('z');
        Expression plus1 = new PlusExpression(y, z);
        Expression minus = new MinusExpression(x, plus1);
        Expression a = new VariableExpression('a');
        Expression plus2 = new PlusExpression(minus, a);

        // context1 만들기
        Map<Character, Integer> context1 = new HashMap<>();
        context1.put('x', 3);
        context1.put('y', 6);
        context1.put('z', -1);
        context1.put('a', 4);

        // 아까 AST의 루트에 context1 넣은 결과
        int result = plus2.interpret(context1);

        // context2 만들기
        Map<Character, Integer> context2 = new HashMap<>();
        context2.put('x', 2);
        context2.put('x', 0);
        context2.put('x', 1);
        context2.put('x', 9);

        // 아까 AST의 루트에 context2 넣은 결과
        int result = plus2.interpret(context2);

        // 아까 AST의 minus 노드에 context1 넣은 결과
        int result = minus.interpret(context1);
    }
}
이렇게 된다. 생각해보니까 인터프리터 패턴은 기존에 구문 해석 과정과 그 처리가 혼재되어있던 것을 컴포지트 패턴을 활용해 구문 해석을 AST 트리로 분리했다는 점(컴포지트는 객체의 관계를 트리로 바꾸는 패턴)에 의의가 있는 듯 하다. 덕분에 AST 트리의 노드가 전부 공통 인터페이스를 따르므로 일률적인 처리가 가능하고 구조를 변경하는 데에 있어서 유연함을 제공하게 된다. 일단 AST 트리로 분리를 했으니 다음과 같이 트리의 처리를 실제 값(Context)를 제공하는 부분(Main)으로부터 분리할 수도 있다.
public class StringExpression implements Expression {
	private Expression ast;

    public StringExpression(String syntax) {
    	Stack<Expression> stack = new Stack<>();

        for (char c : syntax.toCharArray()) {
        	switch (c) {
            	case '+':
                	stack.push(new PlusExpression(
                    	stack.pop(), stack().pop())
                    );
                    break;
                case '-':
                	Expression left = stack.pop();
                    Expression right = stack.pop();
                	stack.push(new MinusExpression(
                    	left, right)
                    );
                    break;
                default:
                	stack.push(new VariableExpression(c + ""));
            }
        }

        ast = stack.pop();
    }

    @Override
    public int interpret(Map<Character, Integer> context) {
    	return ast.interpret(context);
    }
}
이렇게 문자열 받아서 ast로 구성하고 해석하는 트리 만들면 된다. 근데 이러면 각 노드들을 문자열 노드가 의존하므로 유연성은 좀 줄어들겠다. 다음과 같이 사용한다.
public class Main {
	public static void main(String[] args) {
    	// 첫 번째 ast
    	Expression ast1 = new StringExpression("abc+-");

        // 컨텍스트 미리 준비
        Map<Character, Integer> context = new HashMap<>();
        context.put('a', 1);
        context.put('b', 2);
        context.put('c', 3);
        context.put('d', 100);

        // ast1의 결과
        int res1 = ast1.interpret(context);

        // ast1을 왼쪽 자식, d를 오른쪽 자식으로 가지는 뺄셈 노드, ast2
        Expression d = new VariableExpression('d');
        Expression ast2 = new MinusExpression(ast1, d);

        // ast2의 결과
        int res2 = ast2.interpret(context);
    }
}
물론 이거 돌아가는지는 모른다;; 근데 그것은 중요한 것이 아니므로 넘어간다.
장점
첫 번째 장점은 반복되는 문제를 ast트리로 따로 만들어서, (구문화와 처리의 분리) 실제 값을 의미하는 context만 바꿔주면 구문트리를 재사용할 수 있다는 점이다.
두 번째 장점은 컴포지트 패턴과 동일하게, 새로운 expression 노드를 기존 코드의 변경 없이 추가할 수 있다는 점이다.(OCP)
단점은 구조가 복잡해진다는 점;
예시1 - 자바 정규 표현식
정규표현식 혹은 정규식이란 특정 규칙을 가진 문자열의 집합을 표현하는 언어이다. 프로그래밍 할 때 코드가 아니라 그냥 규칙에 따르는 문자열로 처리를 할 수 있게 하는 기능인 것 같다.(질의 기능) 자바에서도 프로그래머가 정규표현식을 사용할 수 있도록 util이 제공된다.
java.util.regax.Pattern 클래스는 matches() 메소드가 지원된다. 이걸로 특정 문자열이 주어진 정규식에 매칭되는지 테스트할 수 있다.
String pattern = "^[0-9]*$"; // 숫자만 등장하는지 판별
String str = "123321";
boolean result = Pattern.matches(pattern, str);
첫 번째 인자는 정규 표현, 두 번째는 확인하고자 하는 문자열이다. 정규 표현에는 문자가 몇번 들어갔는지, 어디서부터 어디까지는 숫자만 잇는지 등의 검색 기능을 pattern이라는 문자열만으로 수행할 수 있다.
예시2 - SpEL(Spring Expression Language)
SpEL은 스프링에서 스프링 객체들의 정보를 질의하거나 조작하여 어떤 값을 표현할 수 있는 표현식 언어이다.(IoC 덕분인 듯) SpEL은 내부적으로 ExpressionParser로 SpEL을 파싱하여 스프링 빈이 가진 객체 정보를 구한다. 이걸로 SpEL의 값을 결정한다. 그리고 어노테이션으로 쓸 수도 있다.
@Value("#{1+1}")
int value;
이런 식으로
예시는 다음과 같다. 일단 ExpressionParser로 하는 방식
public class AppRunner implements ApplicationRunner {
	@Override
    public void run(ApplicationArguments args) throws Exception {
    	ExpressionParser parser = new SpelExpressionParser();
        Expression expression = parser.parseExpression("2 + 100");
        Integer value = expression.getValue(Integer.class);
        System.out.println(value);
    }
}
아래는 어노테이션으로 데이터를 바인딩하는 방식. 특히 빈으로 등록된 Sample의 객체를 바인딩하는 부분에 집중.
# application.properties
my.val=100

@Component
public class Sample {

	private int data = 200;

	public int getData() {
		return data;
	}

	public void setData(int data) {
		this.data = data;
	}
}

@Component
public class AppRunner implements ApplicationRunner {

	@Value("#{1+1}")
	int value;

	@Value("#{'Hello ' + ' World'}")
	String hello;

	@Value("#{1 eq 1}")
	boolean trueOrFalse;

	@Value("you are great")
	String great;

	@Value("${my.val}") // 프로퍼티 값 읽어올 수 있음
	String myName;

	@Value("#{${my.val} eq 100}") // 프로퍼티 값과의 비교 가능
	boolean isMyNameSaelobi;

	@Value("#{sample.data}") // Bean으로 등록된 객체 참조 가능
	int sampleData;

	@Override
	public void run(ApplicationArguments args) throws Exception {
		System.out.println("==============");
		System.out.println(value);
		System.out.println(hello);
		System.out.println(trueOrFalse);
		System.out.println(great);
		System.out.println(myName);
		System.out.println(isMyNameSaelobi);
		System.out.println(sampleData);
	}
}