1. Alarm Clock
기존 Alarm Clock의 문제
기존 timer_sleep은 지정한 틱이 지날 때까지 경과 시간을 확인하고 CPU를 다른 스레드에 양보하는 동작을 반복한다. 스레드가 차단되지 않고 다시 실행될 때마다 시간을 확인하므로, 불필요하게 CPU를 사용하는 busy waiting 방식이다.
void timer_sleep (int64_t ticks)
{
	int64_t start = timer_ticks ();

	ASSERT (intr_get_level () == INTR_ON);
	while (timer_elapsed (start) < ticks)
		thread_yield ();
}
해결 과정
cpu 내부적으로 시간을 재는 타이머를 활용하면 된다. 이는 timer_interrupt란 함수에 연결되어 1초에 TIMER_FREQ만큼 실행된다.
static void timer_interrupt (struct intr_frame *args UNUSED)
{
	ticks++;
	thread_tick ();
}
여기서 스레드가 시간이 지났는지 확인하면, 각 스레드가 직접 시간이 지났는지 확인하지 않아도 스레드를 깨워줄 수 있다.
이를 위해 잠든 스레드들을 담는 sleep_list를 제작하였고, 각 스레드가 언제 깨어나야 하는지도 저장하였다.struct thread { + struct list_elem sleep_elem; + int64_t timer_tick; ...}이후 스레드를 sleep_list에 넣으며 block()하였다. 또한 sleep_list에 스레드를 incert_sleep()으로 tick을 기준으로 정렬하여 넣었다.
void timer_sleep (int64_t ticks)
{
	int64_t start = timer_ticks ();
	int64_t awake_ticks = start + ticks;

	ASSERT (intr_get_level () == INTR_ON);
	thread_current()->timer_tick = awake_ticks;

	if (timer_elapsed (start) < ticks)
	{
		enum intr_level old_level = intr_disable();
		list_insert_ordered(&sleep_list, &thread_current()->sleep_elem, incert_sleep, NULL);
		thread_block();
		intr_set_level (old_level);
	}
}

static bool incert_sleep (const struct list_elem *a,const struct list_elem *b, void *aux UNUSED)
{
	int64_t a_tick = list_entry(a, struct thread, sleep_elem)->timer_tick;
	int64_t b_tick = list_entry(b, struct thread, sleep_elem)->timer_tick;

	if (a_tick < b_tick) return true;
	return false;
}
이제 timer_interrupt()에서 while문을 돌며, sleep_list 앞에서부터 돌며 tick이 지났으면 스레드를 깨우고 다음 스레드를 보고, 안 지났으면 종료한다. 종료하는 이유는 위에서 tick을 기준으로 정렬하였기 때문이다.
static void timer_interrupt (struct intr_frame *args UNUSED)
{
	ticks++;
	while (list_empty (&sleep_list) != true && list_entry(list_front(&sleep_list), struct thread, sleep_elem)->timer_tick <= ticks)
	{
		thread_unblock(list_entry(list_pop_front(&sleep_list), struct thread, sleep_elem));
	}
	thread_mlfqs_calculate(ticks, TIMER_FREQ);
	thread_tick();
}
2. Priority Scheduling
우선순위 스케쥴링?
실행 가능한 스레드 중 우선순위가 가장 높은 스레드에 CPU를 배정하는 방식이다.
기존 방식의 문제점
ready_list에 넣을 때 push_back()으로 넣은 후 list에서 뺄 때 pop_front()을 한다. 따라서 우선순위가 높은 스레드가 리스트에 있어도 뽑히지 않을 수 있다.
void thread_unblock (struct thread *t) {
...
list_push_back (&ready_list, &t->elem);
...}

void thread_yield (void) {
...
list_push_back (&ready_list, &curr->elem);
...}

static struct thread* next_thread_to_run (void) {
...
return list_entry (list_pop_front (&ready_list), struct thread, elem);
... }
해결 과정
이를 해결하기 위해선 ready_list에 thread를 넣을 때 우선순위로 정렬이 되어야하고, 우선순위가 바꼈을 때 양보를 할지 말지 정해야한다.
void thread_unblock (struct thread *t) {
...
bool priority_sort(const struct list_elem *a,const struct list_elem *b, void *aux UNUSED)
{
	int64_t a_priority = list_entry(a, struct thread, elem)->priority;
	int64_t b_priority = list_entry(b, struct thread, elem)->priority;

	if (a_priority > b_priority) return true;
	return false;
}

list_insert_ordered (&ready_list, &t->elem, &priority_sort, NULL);
...}

void thread_yield (void) {
...
list_insert_ordered (&ready_list, &curr->elem, &priority_sort, NULL);
...}

static struct thread* next_thread_to_run (void) {
...
return list_entry (list_pop_front (&ready_list), struct thread, elem);
... }
이렇게 삽입할 때, priority_sort를 기준으로 insert하면 list의 front를 뽑아도 우선순위가 가장 높은 스레드를 가장 먼저 뽑을 수 있게된다.
3. Priority Donation
우선순위 기부?
이는 높은 우선순위를 가진 스레드가 낮은 우선순위를 가진 스레드를 기다리는 상황일 때, 일시적으로 높은 우선순위로 높여주는 방식이다.
왜 필요할까?
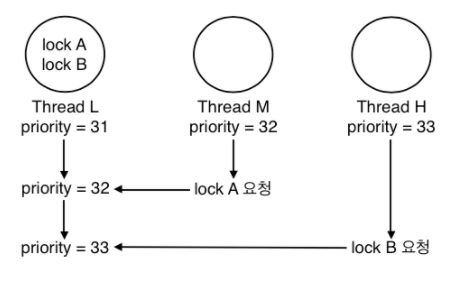
사진과 같은 상황에서 Thread C가 우선순위 32로 cpu를 사용하고, 우선순위 기부가 없다고 해보자. 그러면 Thread H가 우선순위가 가장 높지만 lock B를 Thread L이 사용하고 있고 Thread C가 cpu를 사용 중이기에 Thread L은 lock B를 해제할 수 없다. 따라서 우선순위가 낮은 Thread C가 보다 높은 Thread H보다 먼저 실행되는 우선순위 역전이 발생하게 된다.
해결 과정
우선 단일 기부를 먼저 구현하였다. 단일 기부는 매우 쉽게 lock_acquire()했을 때, lock의 holder가 있다면 holder에게 내 priority를 넘겨주면 된다.
다만 이러면 기부 받기 전 priority로 돌아갈 수 없기에 thread에 og_priority를 저장하도록 한다.
이후 lock_release()에서 holder의 priority를 og로 변경해주면 된다.
다중 기부부턴 많은 생각이 요구되었다. 기부를 여러 스레드 통해서 받을 수도 있고, 타고타고 받을 수도 있기 때문이였다.
이를 위해 thread에 어떤 lock때문에 막혀있는지 저장할 lock, 후원받은 list, 후원한 thread의 리스트에 저장될 list_elem을 추가하였습니다.struct thread { ... struct list donation_list; struct lock *lock_to_stop; struct list_elem donation_elem; ...}이후 lock_aquire 땐 추가 lock_release 땐 해제 하였습니다.
lock_acquire (struct lock *lock) {
	if(lock->holder != NULL){
		curr->lock_to_stop = lock; // 어떤 lock때문에 멈춰 있는지 기록

		// donation_list에 추가
		list_insert_ordered (&lock->holder->donation_list, &curr->donation_elem, &donate_priority_sort, NULL);

		if (lock->holder->priority < curr->priority){	// lock 되어있는 스레드보다 우선순위가 높다면
			// donation_list에서 가장 우선순위가 높은 값(가장 앞의 값)을 lock->holder->priority로 저장
			lock->holder->priority = list_entry (list_begin (&lock->holder->donation_list), struct thread, donation_elem)->priority;
		}

	}
...}

void lock_release (struct lock *lock) {
...
struct thread *curr = thread_current();
	// 해제한 lock을 기다리던 스레드들을 donation에서 제거
	struct list_elem *e = list_begin (&curr->donation_list);
	while (e != list_end (&curr->donation_list)) {
		struct thread *t = list_entry (e, struct thread, donation_elem);
		if (t->lock_to_stop == lock) {
			/* 지우면서 동시에 다음 노드 주소를 받아서 e에 넣어줌! */
			e = list_remove (e);
		} else {
			e = list_next (e);
		}
	}
	curr->priority = curr->my_priority;
	if(!list_empty (&curr->donation_list)){
		// 남은 기부자 중 최대값으로 priority 재계산 후 내 원래 우선순위보다 높다면 교체 진행
		int highest_donation_priority = list_entry (list_begin (&curr->donation_list), struct thread, donation_elem)->priority;
		if(curr->priority < highest_donation_priority) curr->priority = highest_donation_priority;
	}
...}
이렇게 하면 접근한 락에 holder가 있을 때, 우선순위를(더 크다면) 기부해주고 list에 넣게되었습니다. 하지만 아직 중간에 스레드의 우선순위가 변경되었을 때에 대한 처리는 존재하지 않습니다.
void thread_set_priority (int new_priority) {
	if(thread_mlfqs == false){
	    struct thread *curr = thread_current ();

   	curr->my_priority = new_priority;

	    curr->priority = new_priority;

	    /* 기부받았다면, donation_list의 최고 우선순위와(donation_list의 첫번째 thread의 우선순위) 비교하여 더 큰 값 유지 */
   	if (!list_empty (&curr->donation_list)) {
       	int highest_donation = list_entry (list_begin (&curr->donation_list), struct thread, donation_elem)->priority;
       	if (highest_donation > curr->priority) {
           	curr->priority = highest_donation;
       	}
   	}

   	priority_thread_yield ();
	}else return;
}
중첩 기부는 락을 잡고있는 홀더도 락을 잡고있을 때, 락의 홀더의 락의 홀더에게도 우선순위를 기부해줘야한다. 이를 해결하기 위해 락이 있거나 락의 홀더가 있을때까지 재귀로 우선순위를 비교하며 변경해주었다.
bool nest_donation (struct thread *t){
	// 기다리는 lock이 없을 때나 락을 한 스레드가 없을 경우 return
	if (t == NULL || t->lock_to_stop == NULL || t->lock_to_stop->holder == NULL) return false;

	if(t->lock_to_stop->holder->priority < t->priority){
		t->lock_to_stop->holder->priority = t->priority;
		list_sort(&t->lock_to_stop->holder->donation_list, donate_priority_sort, NULL);
	}

	return nest_donation(t->lock_to_stop->holder);
}
위 함수를 lock_aquire의 priority를 변경해준 후 실행해주어야 한다.
4. MLFQS
기존 우선순위 스케줄링의 문제
기존 방식은 설정된 우선순위를 기준으로 스레드를 실행한다. 높은 우선순위의 스레드가 계속 실행 가능한 상태라면 낮은 우선순위의 스레드는 CPU를 얻기 어렵다. 이를 개선하기 위해 최근 CPU 사용량과 nice 값을 기준으로 우선순위를 자동으로 계산하는 MLFQS를 구현하였다.
해결 과정
1. 고정소수점과 필요한 값 준비
MLFQS 계산에 필요한 nice, recent_cpu와 전체 스레드 목록에 사용할 allelem을 추가하였다. nice는 CPU를 얼마나 양보할지 나타내고, recent_cpu는 최근 CPU 사용량을 나타낸다. load_avg는 시스템 전체에서 관리한다.
struct thread {
...
    int nice;
    int recent_cpu;
    struct list_elem allelem;
...};
계산에는 소수가 필요하지만 커널에서는 부동소수점 연산을 사용하지 않는다. 따라서 실제 값에 2¹⁴를 곱해 정수로 저장하는 고정소수점 연산을 구현하였다. 계산 과정에서는 정수와 고정소수점을 구분하고, 곱셈과 나눗셈의 중간 결과는 64비트로 처리하였다.
2. 타이머 인터럽트에서 주기별 계산
매 틱에는 현재 스레드의 recent_cpu를 증가시키고, 매 1초에는 load_avg와 모든 스레드의 recent_cpu를 갱신한다. 매 4틱에는 모든 스레드의 우선순위를 재계산한다. 주기가 겹칠 때는 load_avg → recent_cpu → priority 순서로 계산한다.
// timer_interrupt 내부
if (thread_mlfqs) {
    mlfqs_increment_recent_cpu();

    if (timer_ticks() % TIMER_FREQ == 0) {
        mlfqs_calculate_load_avg();
        mlfqs_recalculate_all_recent_cpu();
    }

    if (timer_ticks() % 4 == 0) {
        mlfqs_recalculate_all_priority();
    }
}
매 틱의 CPU 사용량 증가는 실제로 실행 중인 스레드에만 적용한다. idle 스레드는 제외한다.
void mlfqs_increment_recent_cpu(void) {
    if (thread_current() == idle_thread) return;

    thread_current()->recent_cpu =
        add_fp_int(thread_current()->recent_cpu, 1);
}
load_avg는 실행 중이거나 실행을 기다리는 스레드 수의 이동 평균이다. ready_list의 크기에 현재 실행 중인 스레드를 더하되, idle이면 더하지 않는다.
void mlfqs_calculate_load_avg(void) {
    int ready_threads = 0;
    if (thread_current() != idle_thread)
        ready_threads = list_size(&ready_list) + 1;
    else
        ready_threads = list_size(&ready_list);

    load_avg = add_fp(
        mult_fp(div_fp(int_to_fp(59), int_to_fp(60)), load_avg),
        mult_fp_int(div_fp(int_to_fp(1), int_to_fp(60)), ready_threads)
    );
}
recent_cpu는 갱신한 load_avg를 이용해 재계산한다. 이 계산은 현재 스레드뿐 아니라 잠든 스레드와 락을 기다리는 스레드에도 적용해야 하므로, 전체 스레드 목록인 all_list를 순회한다.
void mlfqs_calculate_recent_cpu(struct thread *t) {
    if (t == idle_thread) return;

    t->recent_cpu = add_fp_int(
        mult_fp(
            div_fp(
                mult_fp_int(load_avg, 2),
                add_fp_int(mult_fp_int(load_avg, 2), 1)
            ),
            t->recent_cpu
        ),
        t->nice
    );
}

void mlfqs_recalculate_all_recent_cpu(void) {
    struct list_elem *e;
    for (e = list_begin(&all_list);
         e != list_end(&all_list);
         e = list_next(e)) {
        struct thread *t = list_entry(e, struct thread, allelem);
        mlfqs_calculate_recent_cpu(t);
    }
}
우선순위는 recent_cpu와 nice를 기준으로 계산한다. 소수 부분을 버린 후 PRI_MIN부터 PRI_MAX 사이로 제한한다.
void mlfqs_calculate_priority(struct thread *t) {
    if (t == idle_thread) return;

    int fp_result = sub_fp(
        sub_fp(int_to_fp(PRI_MAX), div_fp_int(t->recent_cpu, 4)),
        int_to_fp(t->nice * 2)
    );
    int new_priority = fp_to_int(fp_result);

    if (new_priority > PRI_MAX)
        new_priority = PRI_MAX;
    if (new_priority < PRI_MIN)
        new_priority = PRI_MIN;

    t->priority = new_priority;
}
모든 스레드의 우선순위를 변경한 뒤에는 ready_list도 다시 정렬한다. 기존 순서를 유지하면 갱신된 우선순위와 실제 실행 순서가 달라질 수 있기 때문이다.
void mlfqs_recalculate_all_priority(void) {
    struct list_elem *e;
    for (e = list_begin(&all_list);
         e != list_end(&all_list);
         e = list_next(e)) {
        struct thread *t = list_entry(e, struct thread, allelem);
        mlfqs_calculate_priority(t);
    }

    list_sort(&ready_list, priority_sort, NULL);
}
3. 스레드 생성과 nice 변경 처리
최초 스레드는 nice와 recent_cpu를 0으로 시작한다. 이후 생성되는 스레드는 부모 스레드의 값을 상속하고 우선순위를 계산한다. 등록을 init_thread에서 수행해 메인 스레드도 전체 목록에 포함하였다.
// init_thread 내부
if (thread_mlfqs == true) {
    if (t == initial_thread) {
        t->nice = 0;
        t->recent_cpu = 0;
    } else {
        t->nice = thread_current()->nice;
        t->recent_cpu = thread_current()->recent_cpu;
    }

    mlfqs_calculate_priority(t);
}

list_push_back(&all_list, &t->allelem);
nice가 변경되면 다음 4틱을 기다리지 않고 현재 스레드의 우선순위를 즉시 다시 계산한다. 이후 더 높은 우선순위의 스레드가 준비되어 있다면 CPU를 양보한다.
void thread_set_nice(int nice) {
    enum intr_level old_level = intr_disable();

    struct thread *curr = thread_current();
    curr->nice = nice;

    mlfqs_calculate_priority(curr);
    priority_thread_yield();

    intr_set_level(old_level);
}
처음에는 nice 변경 시 타이머 갱신 함수 전체를 호출했다. 이로 인해 같은 틱에서도 CPU 사용량 증가와 load_avg 계산이 반복될 수 있었다. 따라서 우선순위 계산을 별도 함수로 분리해 필요한 계산만 수행하도록 변경하였다.