플래그는 CBC로 암호화된 상태지만, 서버가 제공하는 복호화 함수는 동일한 키를 사용하는 ECB 복호화 함수이다.
학습 목표 : ECB 복호화 결과를 이용해 CBC 평문을 복원하기
사전 지식
암호화와 복호화에 다른 방식이 사용되었는데 어떻게 복원이 가능하냐고 생각할 수도 있을 것이다.
이는 ECB와 CBC의 작동 원리를 이해하면 가능하다는 것을 쉽게 알 수 있다.
ECB (Electronic Codebook)
각 평문 블록을 서로 독립적으로 암호화하는 방식이다.
P1 ── AES(K) ── C1
P2 ── AES(K) ── C2
P3 ── AES(K) ── C3
CBC (Cipher Block Chaining)
현재 평문 블록을 이전 암호문 블록과 XOR한 뒤 AES로 암호화하는 방식이다.
첫 번째 블록에는 이전 암호문이 없기 때문에 IV(Initialization Vector)를 사용한다.
P1 XOR IV ── AES(K) ── C1
P2 XOR C1 ── AES(K) ── C2
P3 XOR C2 ── AES(K) ── C3
이 과정을 이해했다면 다음 질문에 대한 답을 생각해보자.
Q : CBC 암호화를 거친 암호문에서 ECB 복호화를 한다면?
A : 평문 블록과 암호문 블록을 XOR한 블록들이 남는다.
이 답은 ECB 복호화를 거치면 CBC 복호화의 중간 과정에 도달한다는 것을 의미한다.
결론적으로, 남은 블록들을 가장 처음 단계인 CBC 암호화 과정에서 사용한 IV, C1, C2와 XOR 연산을 진행하면 원래 평문으로의 복원이 가능하다는 사실을 알 수 있다.
풀이
STEP 1 : API를 활용하여 CBC 암호화하기
import requests # API 사용

# 서버 기본 주소
BASE = "https://aes.cryptohack.org/ecbcbcwtf"

# 서버에 저장된 플래그를 CBC로 암호화하고 [IV][C1][C2]... 형식으로 반환
response = requests.get(f"{BASE}/encrypt_flag/", timeout=10)
response.raise_for_status()

data = bytes.fromhex(response.json()["ciphertext"])

print('1. CBC 암호문 바이트 길이 : ' + (str)(len(data)))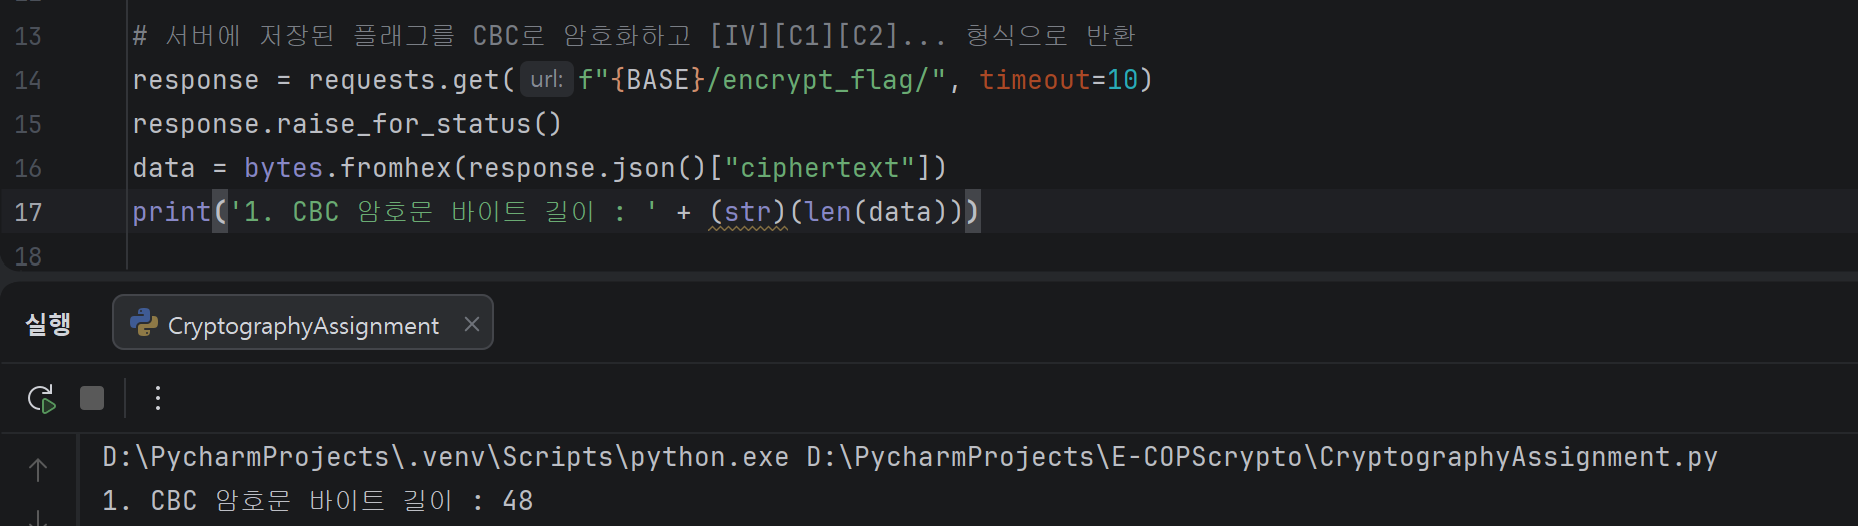
실행 결과를 보면 data 의 바이트 길이는 48이다.
16바이트씩 블록을 이루기 때문에 현재 data 의 형식은 [IV][C1][C2] 라는 사실을 알 수 있다.
IV = data[:16] # 앞의 16바이트 = IV
ciphertext = data[16:] # 그 이후 = 전체 암호문

# 암호문의 길이가 32바이트 이므로 16바이트씩 C1, C2 존재함
C1 = ciphertext[:16]
C2 = ciphertext[16:]
뒤에서 XOR 연산에 사용되기 때문에 C1과 C2를 구해준다.
STEP 2 : API를 활용하여 ECB 복호화하기
# 암호문을 ECB로 복호화하여 CBC 복호화에 필요한 중간 결과를 [D(C1)][D(C2)]... 형식으로 반환
response = requests.get(f"{BASE}/decrypt/{ciphertext.hex()}/", timeout=10)
response.raise_for_status()

ecb_result = bytes.fromhex(response.json()["plaintext"])

D1 = ecb_result[:16]
D2 = ecb_result[16:]
D1에는 P1 XOR IV , D2에는 P2 XOR C1 결과의 바이트 값이 들어있다.
STEP 3 : XOR 연산
# 두 바이트 열을 XOR하는 함수
def xor_bytes(a, b):
    return bytes(x ^ y for x, y in zip(a, b))

P1 = xor_bytes(D1, IV)
P2 = xor_bytes(D2, C1)
다음과 같은 XOR 연산의 Self-Inverse 성질에 따라 평문 블록 P1과 P2를 구한다.
D1 ⊕ IV = P1 ⊕ IV ⊕ IV = P1 , D2 ⊕ C1 = P2 ⊕ C1 ⊕ C1 = P2
STEP 4 : FLAG 출력
# 원래의 평문 복원
plaintext = P1 + P2

print('2. FLAG : ' + (str)(plaintext))
최종적으로 b'crypto{...}' 형식의 바이트 값을 확인할 수 있다.
별첨
사실 CBC 복호화는 일반화된 공식이 존재한다.
Pi = D_K(Ci) ⊕ C(i-1) 이고, 첫 번째 블록에서 C0 = IV 가 된다.
따라서 필자처럼 C1, C2, D1, D2, ... 로 세분화 할 필요 없이 더 짧은 코드로 일반화 할 수 있다.
ecb_result = bytes.fromhex(response.json()["plaintext"])

previous = data[:len(ecb_result)]
plaintext = xor_bytes(ecb_result, previous)
previous = [IV][C1][C2]...[C(N-1)]
ecb_result = [D1][D2]...[D(N)] = [P1⊕IV][P2⊕C1]...[P(N)⊕C(N-1)]
각 블록[]은 16바이트의 길이를 고정적으로 가지고 있으므로,
previous와 ecb_result를 인자로 받아 XOR 연산을 진행하면 연산되어야 하는 블록끼리 바로 매치되어 블록 단위로 분리할 필요가 없게 된다.
따라서
1. 바로 전체 평문이 복원되면서
2. 블록 구분 과정을 생략할 수 있다.