Apache Paimon 정리 — Iceberg와 무엇이 다를까
Iceberg를 운영하다 보면 "스트리밍 upsert는 Paimon이 낫다"는 얘기를 자주 듣게 된다.
예전부터 관심은 있었는데 제대로 들여다본 적은 없어서, 생각난 김에 정리하면서 공부해보려고 한다.
이번 글은 Paimon이 무엇이고, Iceberg와 어디서 갈라지는지에 집중한다.
Apache Paimon
레이크 테이블 포맷에 LSM 트리를 결합해, 데이터 레이크 위에서 실시간 upsert와 변경 스트림(changelog)을 다룰 수 있게 만든 테이블 포맷.
Flink 커뮤니티의 Flink Table Store에서 출발했고, 지금은 Apache Top-Level 프로젝트다.
1. Paimon은 어디서 왔나
Paimon의 전신은 Flink Table Store다. 그래서 설계 자체가 Flink 스트리밍 처리를 1순위로 두고 만들어졌다.
재밌는 점은 README에 "아키텍처는 Iceberg의 설계 개념을 일부 참고했다"고 직접 적혀 있다는 것이다.
즉, 메타데이터 구조는 Iceberg와 닮았고, 데이터 파일을 쌓는 방식은 DB(LSM)를 닮았다.
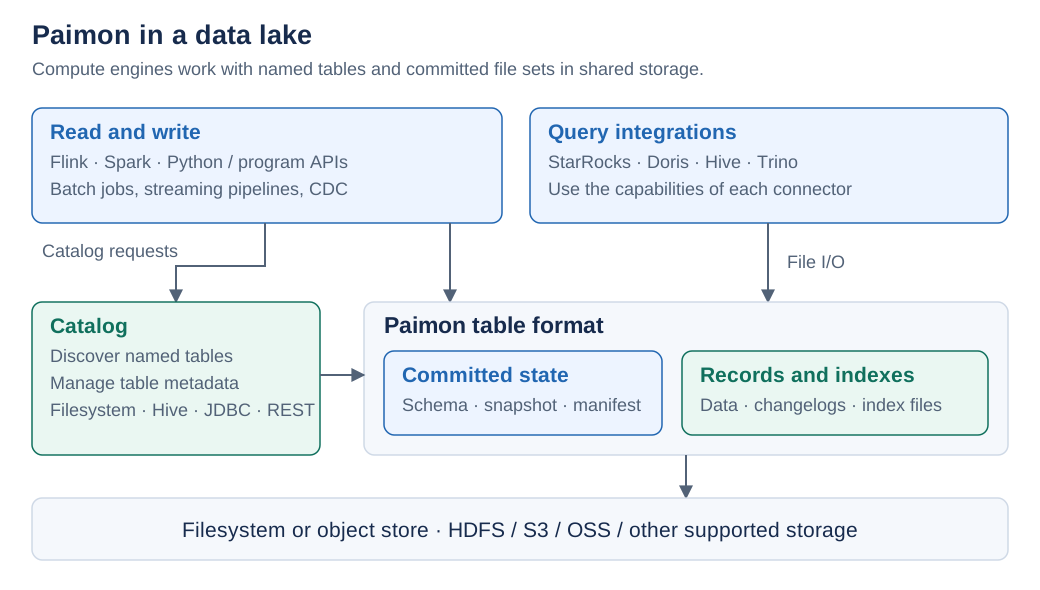
출처: Apache Paimon 공식 문서 — Concepts Overview
| 구성 | 역할 |
|---|---|
| 컴퓨트 엔진 | Flink, Spark가 주력. StarRocks·Doris·Trino·Hive 등은 읽기 위주 |
| Catalog | 테이블 이름·메타데이터 관리 (Filesystem, Hive, REST 등) |
| Storage | HDFS, S3 호환 오브젝트 스토리지(MinIO 등)에 파일 저장 |
2. 결정적인 차이: 데이터를 LSM 트리로 쌓는다
이전에 정리한 RocksDB 글의 LSM 트리가 그대로 등장한다.
Paimon의 Primary Key 테이블은 버킷마다 LSM 트리를 하나씩 가진다.
[Paimon - Primary Key 테이블]

 쓰기 ──▶ 메모리 버퍼 ──(가득 차면 정렬 후 flush)──▶ Sorted Run (L0)
                                                     │
                                         백그라운드 Compaction
                                                     ▼
                                     L1, L2 ... (PK 기준 병합, 최신 값만 유지)

 읽기 ──▶ 여러 Sorted Run을 PK 기준으로 merge 해서 반환
출처: Apache Paimon 공식 문서 — Primary-Key Table
- 하나의 Sorted Run 안에서는 PK 범위가 겹치지 않는다
- Sorted Run끼리는 PK가 겹칠 수 있다 → 읽을 때 merge 필요
- Compaction이 Sorted Run을 합치면서 읽기 비용을 줄인다
반면 Iceberg는 데이터 파일 자체는 불변이고, 업데이트를 delete file로 표현한다.
[Iceberg - MOR 업데이트]

 업데이트 ──▶ 새 data file + delete file(position / equality / DV) 추가
 읽기     ──▶ data file - delete file 을 쿼리 시점에 적용
정리 ──▶ rewrite_data_files 로 delete file 흡수| 구분 | Paimon (PK 테이블) | Iceberg |
|---|---|---|
| 업데이트 표현 | 같은 PK의 새 레코드를 LSM에 추가 | delete file + 새 data file |
| 병합 시점 | 읽기 시 merge + 백그라운드 compaction | 읽기 시 delete 적용(MOR) 또는 쓰기 시 재작성(COW) |
| 데이터 정렬 | 버킷 내부가 항상 PK 정렬 | 정렬은 sort order / compaction 시 선택 |
| 정리 작업 | 쓰기 잡 안에서 compaction이 함께 돈다(기본) | 별도 유지보수 잡으로 돌리는 게 일반적 |
tradeoff
잦은 upsert에서는 Paimon이 유리하다. 같은 키 업데이트가 delete file로 쌓이는 대신 LSM compaction으로 흡수된다.
대신 compaction이 쓰기 경로에 붙어 있어서 버킷 수·compaction 설정이 곧 쓰기 성능이 된다. 공식 문서는 버킷당 200MB~1GB를 권장한다.
3. 메타데이터 구조는 Iceberg와 거의 같다
Iceberg를 알고 있다면 이 부분은 익숙하다.
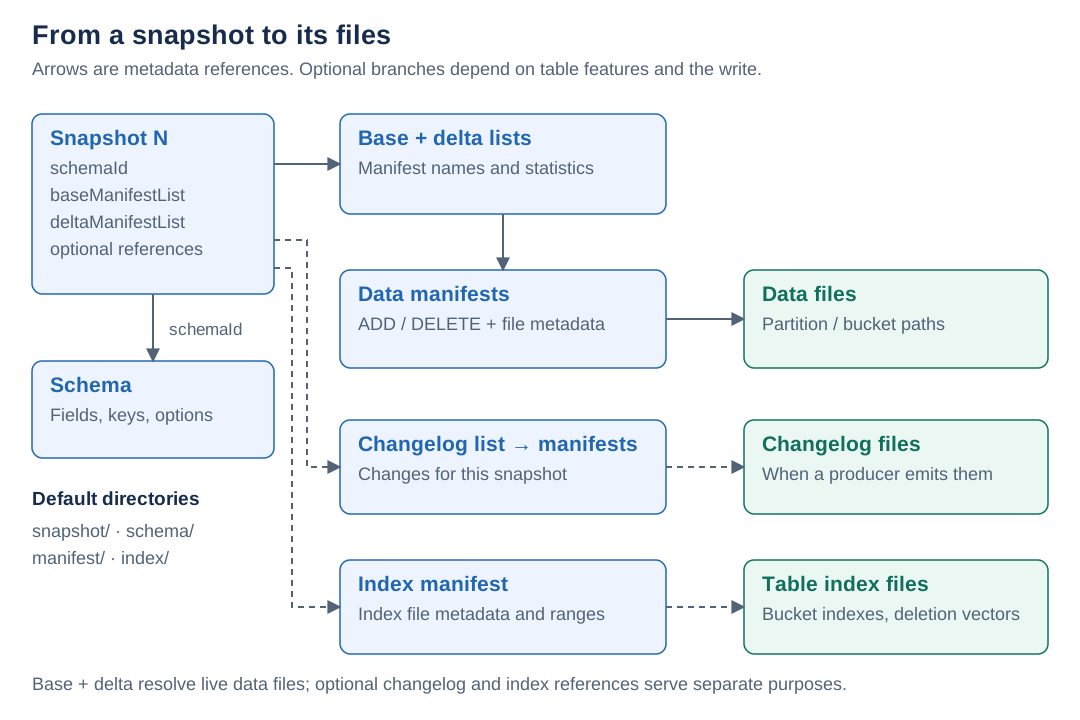
출처: Apache Paimon 공식 문서 — Basic Concepts
snapshot-N (JSON)
   ├── schema
   ├── base manifest list  ─┐
   ├── delta manifest list ─┼──▶ manifest ──▶ data file (Parquet 기본)
   ├── changelog manifest  ─┘              └─▶ changelog file
└── index manifest ──▶ dynamic bucket index, deletion vector| Iceberg | Paimon | 비고 |
|---|---|---|
| metadata.json + snapshot | snapshot-N | 스냅샷 단위 원자적 커밋, 타임트래블 |
| manifest list | base / delta manifest list | Paimon은 base + delta로 나눠 관리 |
| manifest | manifest | 파일 추가/삭제 + 통계 |
| delete file / DV | (LSM 병합) + deletion vector | Paimon도 DV 모드 지원 |
| — | changelog manifest / file | Iceberg에 대응 개념 없음 |
스냅샷 만료 후에야 물리 파일이 지워지는 점, manifest의 delete는 논리 삭제라는 점도 Iceberg와 같다.
4. Primary Key 테이블과 Merge Engine
Paimon 테이블은 두 종류다.
| 테이블 | 동작 | 용도 |
|---|---|---|
| Append 테이블 | PK 없이 그대로 쌓음 | 로그, 이벤트, 배치 데이터 |
| Primary Key 테이블 | 같은 PK를 merge engine 규칙으로 병합 | CDC, upsert |
PK 테이블에서 "같은 키가 두 번 들어오면 어떻게 합칠지"를 정하는 게 merge engine이다. Iceberg에는 없는 개념이다.
| Merge Engine | 결과 | 예시 |
|---|---|---|
deduplicate (기본) | 최신 행만 유지 | 주문 테이블 CDC |
partial-update | null 아닌 컬럼만 갱신 | 주문 정보 + 배송 정보 → 하나의 와이드 테이블 |
aggregation | 컬럼별 집계 함수 적용 | 상품별 누적 판매량 |
first-row | 최초 행만 유지 | 중복 이벤트 제거 |
partial-update가 특히 흥미롭다. 주문 스트림과 배송 스트림을 조인 없이 같은 PK 테이블에 각각 써 넣으면 하나의 와이드 행이 완성된다.
주문 스트림  → (주문번호=1001, 금액=35000, 배송상태=null)
배송 스트림  → (주문번호=1001, 금액=null,  배송상태='배송중')
-----------------------------------------------------------
결과         → (주문번호=1001, 금액=35000, 배송상태='배송중')
Iceberg에서 같은 걸 하려면 스트리밍 조인이나 MERGE INTO를 직접 짜야 한다.
5. Changelog Producer — Iceberg에 없는 것
Paimon PK 테이블은 배치로 조회하는 테이블이면서, 동시에 하위 Flink 잡의 변경 스트림 소스가 될 수 있다.
이때 하위 잡이 받는 변경 내용(+I, -U, +U, -D)을 어떻게 만들지 정하는 옵션이 changelog-producer다.
예를 들어 금액이 4 → 5로 바뀌면, 하위의 합계 집계는 4를 빼고 5를 더해야 한다. 즉 이전 값(-U)이 필요하다.
| Producer | 이전 값을 어디서 얻나 | 언제 쓰나 |
|---|---|---|
none (기본) | 소비자가 직접 상태로 관리 | 하위가 upsert만 받아도 될 때 |
input | 입력 자체가 완전한 changelog | MySQL CDC처럼 before/after가 이미 있을 때 |
lookup | compaction 중 기존 값 조회 | before 값이 없는데 완전한 변경 스트림이 필요할 때 |
full-compaction | full compaction 결과 간 diff | 수십 분 지연이 허용될 때 |
tradeoff
changelog 파일을 만드는 만큼 쓰기 비용과 저장 공간이 늘어난다. 공식 문서도 "소비자 요구를 만족하는 가장 싼 producer"를 고르라고 한다.
Iceberg도 Spark의 changelog view처럼 스냅샷 간 변경을 계산하는 방법은 있지만, 테이블 옵션으로 스트리밍 소비자용 changelog를 쓰기 시점에 생성하는 구조는 아니다. Kafka 없이 레이크 테이블끼리 스트리밍 파이프라인을 잇는다는 Paimon의 그림이 여기서 나온다.
6. Iceberg 호환 — 둘 중 하나만 고를 필요는 없다
Paimon은 Iceberg 메타데이터를 추가로 발행할 수 있다. 데이터는 복사하지 않고, 같은 데이터 파일을 가리키는 Iceberg 메타데이터만 만든다.
'metadata.iceberg.storage' = 'hadoop-catalog' -- 기본값은 disabledPaimon 커밋 ──▶ Paimon snapshot
└─▶ Iceberg manifest / metadata 생성 ──▶ Trino, Spark 등 Iceberg reader가 조회
(데이터 파일은 공유)다만 PK 테이블은 Iceberg reader에게 바로 보이지 않는다.
| Paimon 테이블 | Iceberg reader에 보이는 시점 |
|---|---|
| Append 테이블 | 커밋 후 메타데이터 발행 시 |
| PK 테이블 (DV 미사용) | full compaction 후 최상위 LSM 레벨 파일만 |
| PK 테이블 (Iceberg v3 DV 사용) | L0 위 레벨로 내려간 후 |
tradeoff
Iceberg 쪽은 읽기 전용 인터페이스다. 쓰기, 스키마 변경, compaction, 스냅샷 만료, 파일 정리는 모두 Paimon에서 해야 한다.
Iceberg 쪽에서expire_snapshots나 orphan 정리를 돌리면 Paimon이 보는 파일이 깨질 수 있다.
7. 한눈에 비교
| 항목 | Apache Paimon | Apache Iceberg |
|---|---|---|
| 출발점 | Flink Table Store (스트리밍 우선) | Netflix (대규모 배치 분석) |
| 데이터 구조 | 버킷별 LSM 트리 | 불변 data file + delete file |
| upsert | PK 테이블 기본 기능 | MERGE INTO / Flink upsert(equality delete) |
| 병합 규칙 | merge engine (dedup / partial / agg / first-row) | 없음 (쿼리로 직접 구현) |
| 변경 스트림 | changelog producer로 생성 | 스냅샷 diff 기반 |
| 버킷 | PK 테이블의 핵심 단위 (fixed / dynamic) | 파티션 transform 중 하나 |
| compaction | 쓰기 잡에 내장 (비동기·전용 잡도 가능) | 별도 유지보수 프로시저 |
| 엔진 생태계 | Flink·Spark 중심 | Spark·Trino·Flink·Snowflake 등 폭넓음 |
| 상호 운용 | Iceberg 메타데이터 발행 가능 | — |
8. 언제 무엇을 써야 하나
| 상황 | 선택 | 이유 |
|---|---|---|
| 일 단위 배치 적재 + Trino/Spark 분석 | Iceberg | 엔진 생태계와 운영 도구가 더 성숙 |
| MySQL CDC를 레이크에 실시간 upsert | Paimon | LSM으로 잦은 업데이트를 흡수, delete file 누적 부담 적음 |
| 여러 스트림을 조인 없이 와이드 테이블로 | Paimon (partial-update) | 조인 상태 없이 PK 병합으로 해결 |
| 레이크 테이블의 변경을 하위 스트리밍 잡이 소비 | Paimon (changelog-producer) | Kafka 중간 계층 없이 changelog 제공 |
| 실시간 적재는 Paimon, 조회는 기존 Iceberg 엔진 | Paimon + Iceberg 호환 | 데이터 복사 없이 Iceberg reader로 조회 (compaction 후 노출) |
| Spark 배치 위주에 업데이트가 가끔 | Iceberg | COW/MOR + 주기적 rewrite로 충분 |
참고