실습 목표
이 실습의 목적은 자연어 문장을 단순한 단어 나열이 아닌,
문법 규칙에 기반한 계층적 구조(Tree) 로 분석하는 과정을 이해하는 것이다.
NLTK의 CFG(Context-Free Grammar)와 ChartParser를 사용하여
한국어 문장을 사람이 정의한 문법 규칙으로 직접 파싱해본다.
실습 환경
- Python 3.11
- NLTK 3.9.1
- 가상환경: venv_nltk
- Jupyter Notebook
1. 규칙 기반 구문 분석이란?
규칙 기반 구문 분석은 사람이 직접 문법 규칙을 정의하고,
문장이 그 규칙을 만족하는지 판단하여 구문 트리(parse tree) 를 생성하는 방식이다.
핵심 개념은 다음과 같다.
- 문장은 계층적 구조를 가진다.
- 문장은 더 작은 단위(구, 형태소)로 재귀적으로 분해될 수 있다.
- 이 구조를 문법 규칙(CFG)으로 명시할 수 있다.
2. 문법 규칙(CFG) 정의
이번 실습에서는 다음 문장을 분석 대상으로 사용했다.
아이들이 케이크를 먹었다
이를 형태소 단위로 분해하면 다음과 같다.
아이 / 들 / 이 / 케이크 / 를 / 먹 / 었 / 다
이를 바탕으로 CFG 문법을 정의한다.
grammar = nltk.CFG.fromstring("""
S -> NP VP
NP -> NN XSN JK | NN JK
VP -> NP VP | VV EP EF
NN -> '아이' | '케이크'
XSN -> '들'
JK -> '이' | '를'
VV -> '먹'
EP -> '었'
EF -> '다'
""")
각 규칙의 의미는 다음과 같다.
- S: 문장
- NP: 명사구
- VP: 동사구
- NN: 명사
- XSN: 복수 접미사
- JK: 조사
- VV: 동사
- EP: 선어말 어미
- EF: 종결 어미
3. ChartParser 생성
정의한 문법 규칙을 기반으로 ChartParser를 생성한다.
parser = nltk.ChartParser(grammar)
ChartParser는 가능한 모든 부분 구조를 차트에 저장하며,
중복 계산을 피하면서 문장의 구문 트리를 탐색한다.
4. 문장 파싱 수행
분석할 문장을 형태소 단위 리스트로 정의한다.
sent = ['아이', '들', '이', '케이크', '를', '먹', '었', '다']
이 문장을 파서에 전달하여 구문 분석을 수행한다.
for tree in parser.parse(sent):
print(tree)
5. 구문 분석 결과
출력된 구문 트리는 다음과 같은 구조를 가진다.
(S
(NP (NN 아이) (XSN 들) (JK 이))
(VP
(NP (NN 케이크) (JK 를))
(VP (VV 먹) (EP 었) (EF 다))))
이 결과는 다음 사실을 의미한다.
- 문장이 명사구(NP)와 동사구(VP)로 올바르게 분해되었다.
- 모든 형태소가 정의한 문법 규칙에 맞게 결합되었다.
- 해당 문장은 CFG 규칙상 문법적으로 타당하다.
6. 이 실습의 핵심 포인트
이 실습을 통해 다음을 이해할 수 있다.
- 문장은 트리 구조를 가진다.
- 형태소 분석 이후에는 구문 분석 단계가 존재한다.
- CFG는 사람이 직접 언어 규칙을 정의하는 방식이다.
- 규칙 기반 구문 분석은 직관적이지만 확장성이 낮다.
- 현대 NLP(딥러닝 기반)가 등장한 이유를 이해할 수 있다.
7. 규칙 기반 구문 분석의 한계
- 규칙을 사람이 모두 작성해야 한다.
- 예외 처리 비용이 매우 크다.
- 실제 자연어의 다양성을 모두 포괄하기 어렵다.
이러한 한계 때문에,
현대 NLP에서는 통계 기반 및 딥러닝 기반 구문 분석(spaCy, Transformer 등)이 주류가 되었다.
8. KoNLPy 개념
KoNLPy를 알아 보기에 앞서 NLP라는 개념에 대해 먼저 알아보자.
NLP (Natural Language Processing : 자연어처리)는 텍스트에서 의미있는 정보를 분석, 추출하고 이해하는 일련의 기술집합이다.NLP는 컴퓨터와 인간 언어 사이의 상호 작용하는 기술로 인공지능의 핵심 기능 중 하나이다. 자연어처리가 되면, 컴퓨터는 이 처리된 정보를 바탕으로 음성 인식, 내용 요약, 번역, 감성 분석, 텍스트 분류 작업을 할 수 있다.
우리 일상에서 자주 쓰이는 애플의 Siri 나 구글 번역기가 NLP의 대표적인 응용 사례이다.
아름답지만 다소 복잡하기도한 한국어는 전세계에서 13번째로 많이 사용되는 언어이다. 복잡미묘한 한국어 텍스트에서 유용한 특성을 추출하기 위해 그 동안 수많은 한국어 정보처리 도구가 개발되었다.
한국어 텍스트를 분석할 때 가장 기본적으로 행해야하는 것은 형태소 분석이다. 형태소를 나눈다면 크게 명사, 동사, 형용사, 부사, 조사, 접사, 관형사, 어미 등으로 나뉜다. 한국어를 처리 할때는 대체로 KoNLPy(코엔엘파이) 라이브러리를 많이 사용한다.
즉 KoNLPy(코엔엘파이)는 한국어 정보처리를 위한 파이썬 패키지이다. KoNLPy는 파이썬 프로그래밍 언어로 사용할 수 있도록 만들어졌다. 파이썬이 간결하고 우아한 문법구조, 강력한 스트링 연산 기능을 가지고 있을 뿐 아니라 크롤링, 웹프로그래밍, 그리고 데이터 분석을 수행할 수 있는 다양한 패키지를 사용할 수 있는 언어이기 때문이다.
실습
#!/usr/bin/env python
# coding: utf-8
# ------------------------------------------------------------
# (헤더 설명)
# - 첫 줄(셔뱅): 리눅스/맥에서 이 파일을 "실행 파일"처럼 실행할 때
#   어떤 파이썬을 사용할지 지정합니다.
#   예) chmod +x script.py 후 ./script.py
# - encoding: utf-8
#   한글 문자열이 포함되므로 UTF-8 인코딩을 명시해두면 안전합니다.
# ------------------------------------------------------------

# In[1]:

# ------------------------------------------------------------
# konlpy 패키지 다운로드
# - Jupyter Notebook 환경에서 셀 단위로 pip 설치할 때 사용
# - 이미 venv(가상환경)에 konlpy가 설치되어 있으면 실행할 필요 없음
# - "get_ipython().system(...)" 형태는 노트북에서 !pip install 과 같은 의미
# - 주의: 노트북 커널이 사용하는 파이썬(venv)이 맞는지 확인해야 함
#   (pip 설치했는데 import가 안 된다면 커널 파이썬이 다른 환경일 가능성이 큼)
# ------------------------------------------------------------
# get_ipython().system("pip install konlpy")

# In[2]:

# ------------------------------------------------------------
# konlpy 관련 패키지 import
# - KoNLPy는 한국어 형태소 분석기들을 파이썬에서 쉽게 쓰게 해주는 래퍼(library)
# - 내부적으로 Java 기반 분석기(Kkma, Hannanum 등) 또는 JVM 연동이 필요한 경우가 많음
# - Okt(구 Twitter)는 비교적 설치/사용이 쉬운 편(자바 의존성 상대적으로 낮음)
# - Kkma/Hannanum 등은 JVM(자바) 설정이 필요할 수 있음
# ------------------------------------------------------------
from konlpy.tag import Okt
from konlpy.tag import Kkma
from konlpy.tag import Hannanum
from konlpy.tag import Komoran
from konlpy.tag import Twitter

# In[3]:

# ------------------------------------------------------------
# 형태소 분석기 인스턴스 생성
# ------------------------------------------------------------

# kkma = Kkma()
# - 원래는 위처럼 JVM 경로 지정 없이도 동작해야 하지만,
#   Windows에서는 JAVA_HOME / PATH / jvm.dll 탐지 문제로
#   "JVMNotFoundException"이 자주 발생합니다.

# ✅ JVM 경로를 직접 지정해서 Kkma를 초기화
# - jvmpath에는 "jvm.dll"의 "정확한 파일 경로"가 들어가야 함
# - 현재 코드 경로: C:\Program Files\Java\jdk-17\bin\server\jvm.dll
#   -> 시스템에 따라 jvm.dll이 보통
#      C:\Program Files\Java\jdk-17\lib\server\jvm.dll
#      쪽에 존재하는 경우가 더 흔합니다.
#   -> 만약 여기 경로에 실제 파일이 없으면 WinError 126 발생
# - jvmpath 문자열 앞에 r"" 를 붙인 이유:
#   Windows 경로의 역슬래시(\)가 이스케이프 문자로 처리되는 걸 방지
#   예: "\n" 같은 문자 문제가 생기지 않도록 Raw string 사용
kkma = Kkma()


# Okt 분석기
# - 트위터(Twitter) 형태소 분석기의 새 이름(클래스명)이 Okt
# - KoNLPy 버전에 따라 Twitter 클래스가 deprecated(권장되지 않음)일 수 있음
okt = Okt()

# Komoran 분석기
# - Java 기반 분석기이며, 비교적 안정적으로 사용되는 편
komoran = Komoran()

# Hannanum 분석기
# - KAIST의 한나눔 형태소 분석기 기반
# - Java 기반이라 환경에 따라 JVM/자바 연동 이슈가 날 수 있음
hannanum = Hannanum()

# Twitter 분석기
# - Okt의 구 버전 이름/호환용 클래스 (KoNLPy 버전에 따라 존재)
# - 실무에서는 보통 Okt를 권장
twitter = Twitter()

# In[ ]:

# ------------------------------------------------------------
# Kkma의 문장 분리(sentence splitting)
# - KoNLPy 분석기 중 Kkma는 "문장 분리" 기능을 제공하는 것으로 유명합니다.
# - 예: "네 안녕하세요 반갑습니다." -> 문장 단위로 쪼개서 리스트로 반환
# - 문장 분리는 전처리에서 매우 중요:
#   (문서 -> 문장 -> 토큰/형태소) 파이프라인에 자주 사용됨
# ------------------------------------------------------------
print("kkma 문장 분리 : ", kkma.sentences("네 안녕하세요 반갑습니다."))

# In[ ]:

# ------------------------------------------------------------
# 형태소 분석 결과 비교
# - 같은 문장이라도 분석기마다 토큰화/품사 처리 기준이 다르므로 결과가 다르게 나옵니다.
# - 비교를 통해 어떤 분석기가 내 프로젝트 목적에 더 적합한지 판단할 수 있습니다.
#
# 문장: "집에 가면 감자 좀 쪄줄래?"
# - 구어체/의문형/축약 표현("쪄줄래")이 포함되어 있어 분석기별 차이가 잘 드러남
#
# ✅ 반환 형태:
# - morphs(): 형태소(토큰) 리스트만 반환
# - (추가로 자주 쓰는 메서드)
#   - pos(): (형태소, 품사) 튜플 리스트
#   - nouns(): 명사만 추출
# ------------------------------------------------------------

# Okt 형태소 분석
# - 속도가 빠르고 대중적으로 많이 사용
# - 신조어/비정형 텍스트에 비교적 강하다는 평가가 많음
print("okt 형태소 분석 :", okt.morphs("집에 가면 감자 좀 쪄줄래?"))

# Kkma 형태소 분석
# - 문장분리+정교한 분석이 강점으로 알려져 있으나 상대적으로 느릴 수 있음
# - JVM 설정 필요
print("kkma 형태소 분석 : ", kkma.morphs("집에 가면 감자 좀 쪄줄래?"))

# Hannanum 형태소 분석
# - 분석 기준이 다르며 결과가 비교적 "전통적인" 형태로 나올 때가 있음
print("hannanum 형태소 분석 : ", hannanum.morphs("집에 가면 감자 좀 쪄줄래?"))

# Komoran 형태소 분석
# - 비교적 성능/정확도가 안정적이라고 많이 사용됨
print("komoran 형태소 분석 : ", komoran.morphs("집에 가면 감자 좀 쪄줄래?"))

# Twitter 형태소 분석
# - 구 버전 이름/호환 클래스라, 결과는 Okt와 유사하거나 동일할 수 있음
# - KoNLPy 버전에 따라 경고가 뜰 수 있음
print("twitter 형태소 분석 : ", twitter.morphs("집에 가면 감자 좀 쪄줄래?"))
결과
kkma 문장 분리 : ['네 안녕하세요', '반갑습니다.']
okt 형태소 분석 : ['집', '에', '가면', '감자', '좀', '쪄줄래', '?']
kkma 형태소 분석 : ['집', '에', '가', '면', '감자', '좀', '찌', '어', '주', 'ㄹ래', '?']
hannanum 형태소 분석 : ['집', '에', '가', '면', '감', '자', '좀', '찌', '어', '줄', '래', '?']
komoran 형태소 분석 : ['집', '에', '가', '면', '감자', '좀', '찌', '어', '주', 'ㄹ래', '?']
twitter 형태소 분석 : ['집', '에', '가면', '감자', '좀', '쪄줄래', '?']
## 1. NLTK 라이브러리 로드

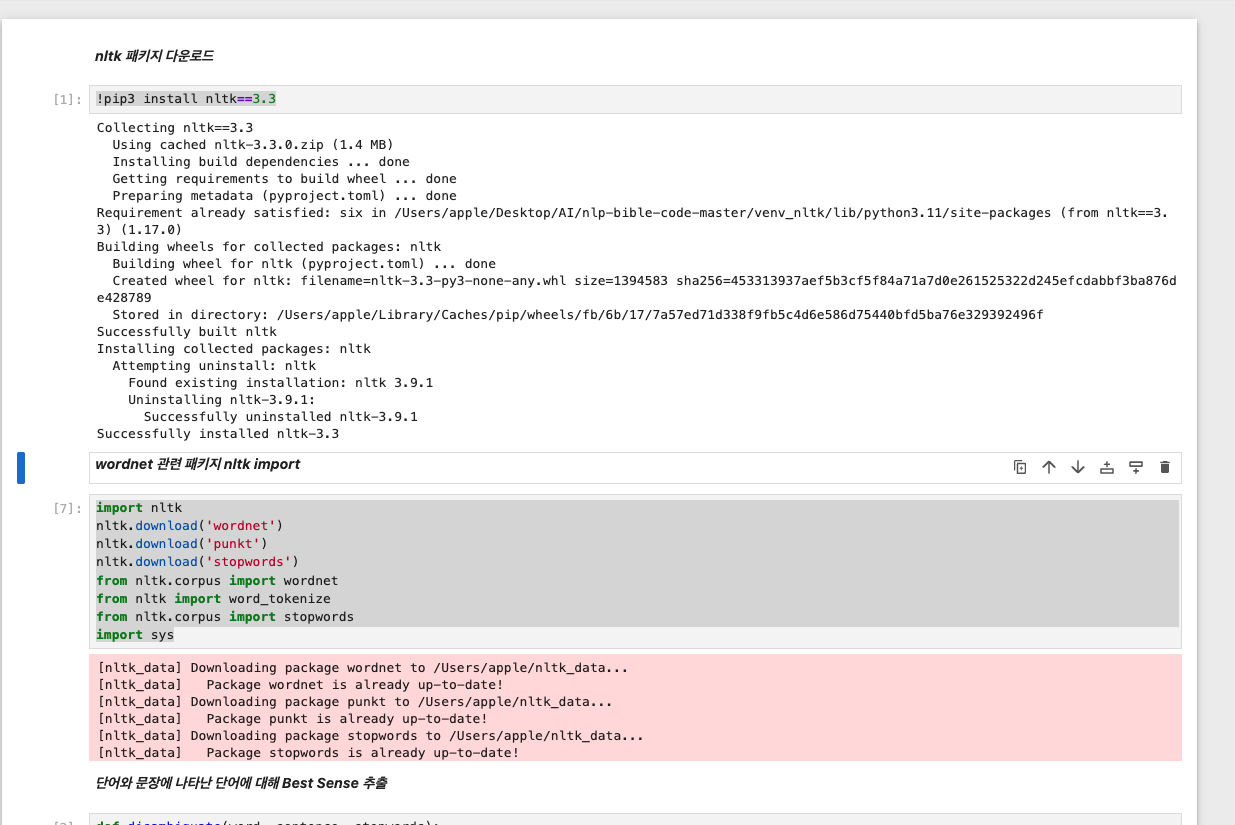
import nltk

- Python에서 자연어 처리를 수행하기 위한 NLTK(Natural Language Toolkit)를 불러온다.
- 이후 토큰화, 불용어 처리, WordNet 사용의 기반이 된다.

---

## 2. NLTK 데이터 리소스 다운로드

nltk.download('wordnet')
nltk.download('punkt')
nltk.download('stopwords')

- NLTK는 코드와 데이터가 분리되어 있어 필요한 리소스를 별도로 다운로드해야 한다.
- wordnet: 단어의 의미(sense), 정의(definition), 예문(example)을 제공
- punkt: 문장 및 단어 토큰화를 위한 사전 학습 모델
- stopwords: 의미 분석에서 제거할 불용어(i, my, they 등)

---

## 3. 필요한 모듈 import

from nltk.corpus import wordnet
from nltk import word_tokenize
from nltk.corpus import stopwords

- wordnet: 단어 의미 사전 접근
- word_tokenize: 문장을 단어 단위로 분리
- stopwords: 의미 없는 단어 제거용 리스트 제공

---

## 4. Lesk 알고리즘용 함수 정의

### 4-1. 단어 의미 선택 함수 (disambiguate)

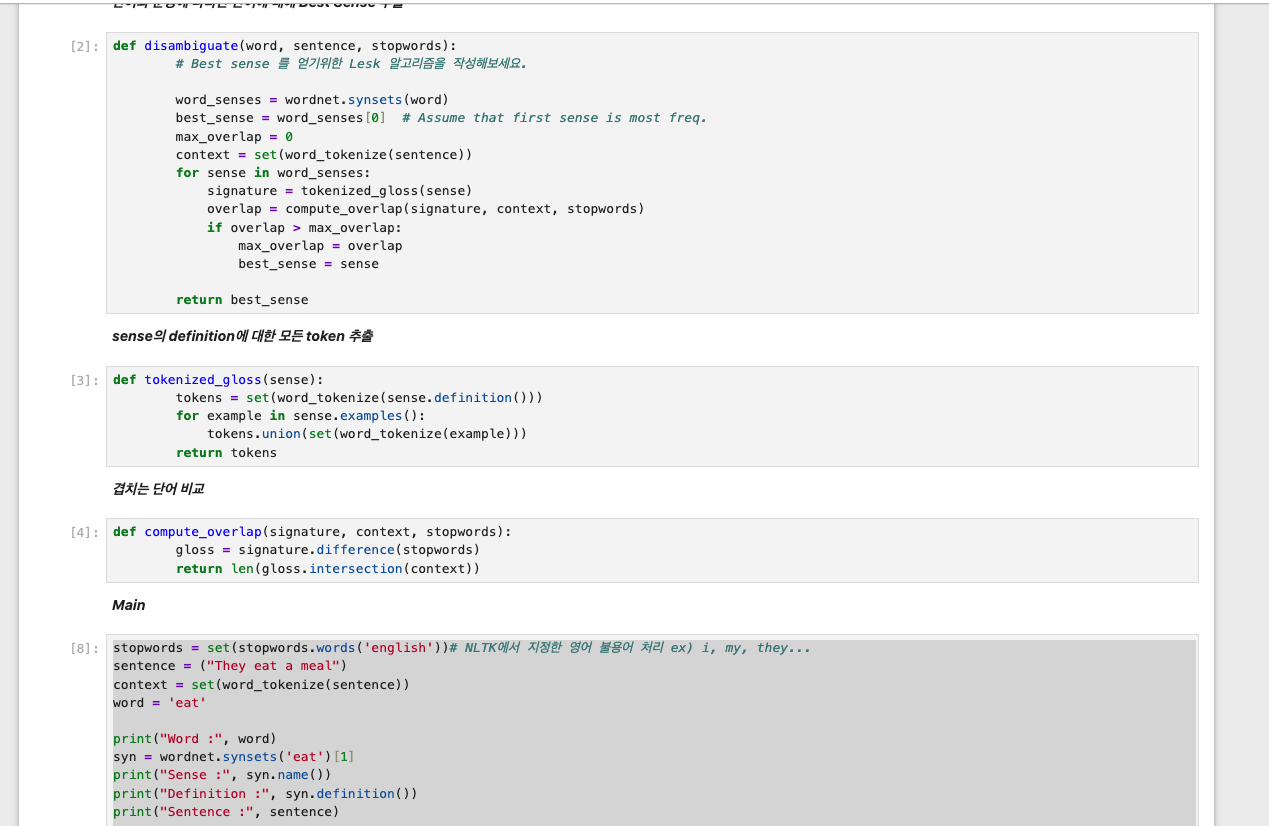
def disambiguate(word, sentence, stopwords):

- 하나의 단어가 여러 의미(sense)를 가질 때 가장 적절한 의미를 선택하는 함수
- Lesk 알고리즘 기반 구현

word_senses = wordnet.synsets(word)

- WordNet에서 해당 단어의 모든 의미 목록을 가져온다.

best_sense = word_senses[0]

- 기본값으로 첫 번째 의미를 선택
- WordNet은 일반적으로 첫 번째 의미를 가장 빈도 높은 의미로 정렬한다.

max_overlap = 0

- 문맥과 정의 간 겹치는 단어 수의 최댓값을 저장하기 위한 변수

context = set(word_tokenize(sentence))

- 입력 문장을 토큰화하여 문맥(Context) 생성

for sense in word_senses:

- 모든 의미를 하나씩 비교

signature = tokenized_gloss(sense)

- 해당 의미의 정의(definition) + 예문(example)에서 토큰 집합 생성

overlap = compute_overlap(signature, context, stopwords)

- 정의 토큰과 문장 토큰이 얼마나 겹치는지 계산

if overlap > max_overlap:

- 더 많이 겹치는 의미가 나오면 해당 의미를 best_sense로 갱신

return best_sense

- 최종적으로 가장 적합한 의미 반환

---

### 4-2. 의미 정의 토큰 생성 함수

def tokenized_gloss(sense):

- 하나의 의미(sense)에 대한 설명 토큰을 만드는 함수

tokens = set(word_tokenize(sense.definition()))

- 의미의 정의 문장을 토큰화

for example in sense.examples():

- 해당 의미의 예문들을 순회

tokens.union(set(word_tokenize(example)))

- 예문에 등장하는 단어들도 토큰 집합에 추가

return tokens

- 정의 + 예문 기반 토큰 집합 반환

---

### 4-3. 겹치는 단어 수 계산 함수

def compute_overlap(signature, context, stopwords):

- 의미 정의 토큰과 문맥 토큰의 겹침 정도 계산

gloss = signature.difference(stopwords)

- 의미 없는 불용어 제거

return len(gloss.intersection(context))

- 의미 정의와 문장 사이의 공통 단어 개수 반환

---

## 5. 메인 실행 코드

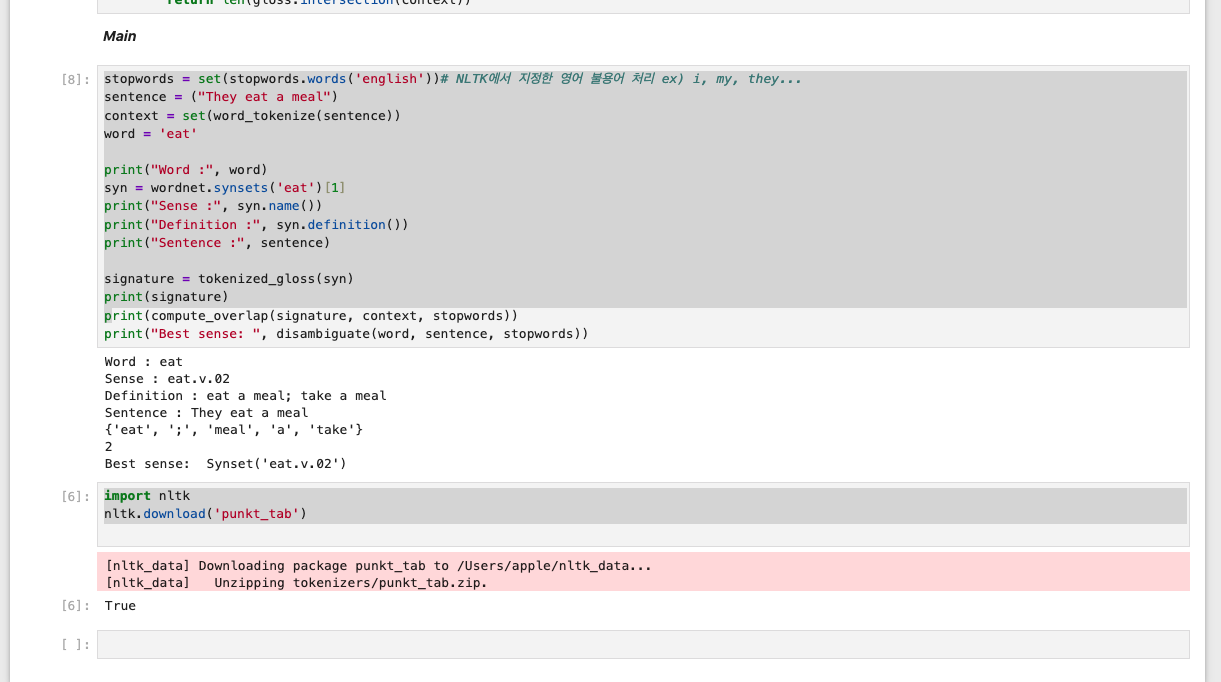
stopwords = set(stopwords.words('english'))

- NLTK에서 제공하는 영어 불용어 목록 로드

sentence = "They eat a meal"

- 분석 대상 문장

context = set(word_tokenize(sentence))

- 문장을 토큰화하여 문맥 생성

word = "eat"

- 의미를 분석할 대상 단어

---

## 6. WordNet을 이용한 의미 확인

print("Word :", word)

syn = wordnet.synsets("eat")[1]

- eat의 여러 의미 중 두 번째 의미 선택

print("Sense :", syn.name())

- 의미 ID 출력 (eat.v.02)

print("Definition :", syn.definition())

- 해당 의미의 정의 출력

print("Sentence :", sentence)

- 원본 문장 출력

---

## 7. Lesk 알고리즘 결과 출력

signature = tokenized_gloss(syn)

- 선택된 의미의 정의 기반 토큰 집합 생성

print(signature)

- 의미 정의에 포함된 단어 확인

print(compute_overlap(signature, context, stopwords))

- 문장과 정의가 공유하는 단어 수 출력

print("Best sense :", disambiguate(word, sentence, stopwords))

- 문맥 기반으로 최종 선택된 단어 의미 출력

---
8. 실습 결과 해석
- 단어 eat은 여러 의미를 가질 수 있으나
- "They eat a meal" 문맥에서는
- "eat a meal; take a meal" 의미(eat.v.02)가 가장 적합하다고 판단됨
- 이는 문장 속 단어와 정의 속 단어 간의 겹침 정도를 기반으로 결정됨
9. 이번 실습을 통해 알게 된 점
- 단어 의미 분석은 단순히 사전 조회가 아니라 문맥 기반 판단이 중요함
- Lesk 알고리즘은 통계나 딥러닝 없이도 의미 중의성을 해결할 수 있음
- NLP의 많은 기초 개념(토큰화, 불용어 제거, 의미 비교)은 지금 구조 위에서 확장됨
NLTK 영어 문장 개체명 인식(NER) 실습 정리
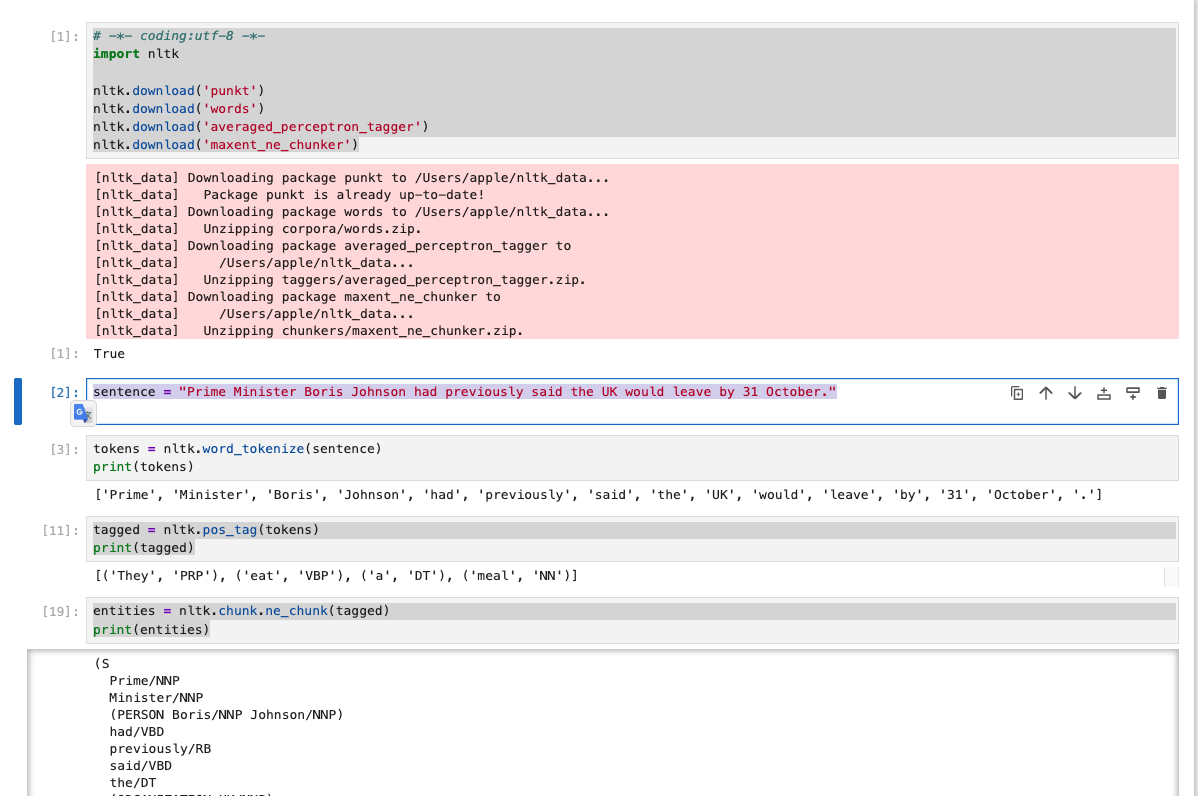
이번 실습에서는 NLTK(Natural Language Toolkit)를 사용해
영어 문장에서 사람(Person), 조직(Organization)과 같은
개체명(Named Entity)을 인식하는 과정을 단계별로 실습했다.
자연어 처리의 기본 파이프라인인
Tokenization → POS Tagging → Named Entity Recognition
흐름을 실제 코드 실행을 통해 확인하는 것이 목적이다.
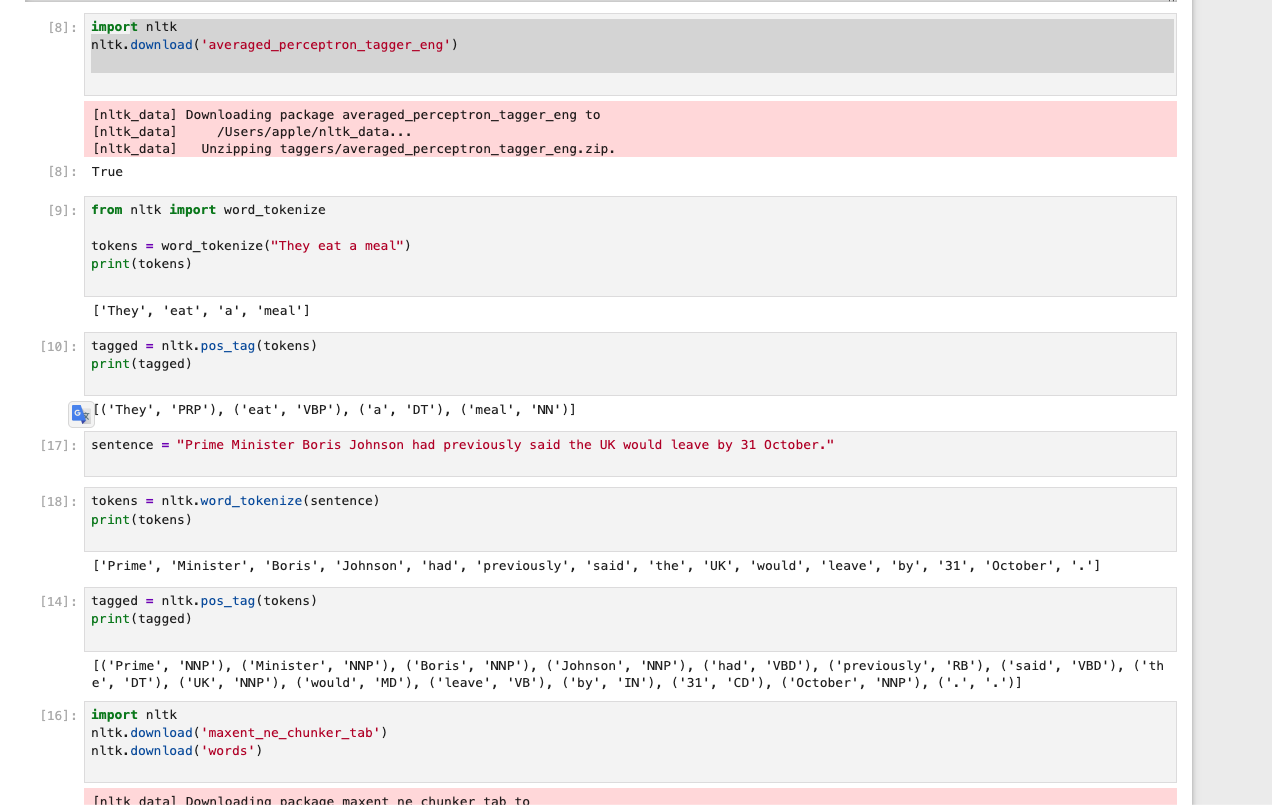
1. NLTK 리소스 다운로드
NLTK는 라이브러리만 설치해도 바로 동작하지 않고,
내부에서 사용하는 학습 데이터(모델)를 별도로 다운로드해야 한다.
다운로드한 주요 리소스는 다음과 같다.
-
punkt
문장 및 단어 토큰화를 담당하는 모델 -
words
영어 단어 사전 데이터 -
averaged_perceptron_tagger / averaged_perceptron_tagger_eng
품사 태깅(POS Tagging)에 사용되는 통계 기반 모델 -
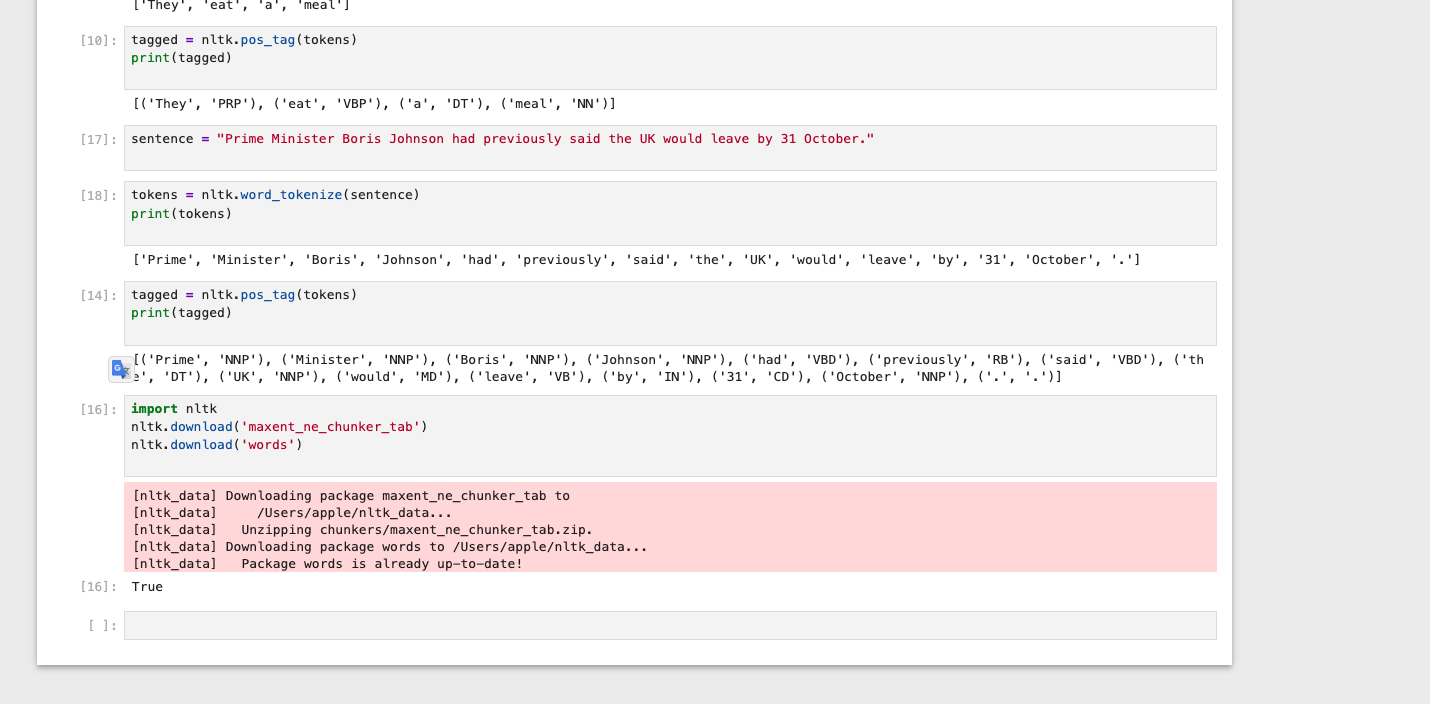
maxent_ne_chunker / maxent_ne_chunker_tab
개체명 인식(NER)을 위한 최대 엔트로피(MaxEnt) 모델
이 리소스들이 없으면 실행 중 LookupError가 발생한다.
2. 분석할 문장 정의
실습에서는 다음과 같은 뉴스 문장 형태의 예문을 사용했다.
Prime Minister Boris Johnson had previously said the UK would leave by 31 October.
이 문장은 인물(Boris Johnson)과 조직(UK)이 포함되어 있어
개체명 인식 실습에 적합하다.
3. Tokenization (토큰화)
문장을 단어 단위로 분리하는 단계이다.
결과:
Prime, Minister, Boris, Johnson, had, previously, said, the, UK, would, leave, by, 31, October, .
토큰화는 이후 모든 NLP 처리의 기반이 된다.
4. POS Tagging (품사 태깅)
각 토큰에 대해 품사를 부여한다.
예시 결과:
- Prime / NNP
- Minister / NNP
- Boris / NNP
- Johnson / NNP
- had / VBD
- previously / RB
- said / VBD
- the / DT
- UK / NNP
- would / MD
- leave / VB
- by / IN
- 31 / CD
- October / NNP
NNP(고유명사), VBD(과거동사), DT(관사) 등 문법 정보가 부여된다.
5. Named Entity Recognition (NER)
품사 태깅 결과를 기반으로 개체명을 인식한다.
실행 결과에서 확인된 주요 개체는 다음과 같다.
- Boris Johnson → PERSON
- UK → ORGANIZATION
출력은 트리(Tree) 구조로 나타나며,
PERSON, ORGANIZATION 같은 라벨이 자동으로 부여된다.
6. 실습 결과 요약
이번 실습을 통해 다음 과정을 직접 확인했다.
- NLTK는 코드 + 데이터 리소스가 함께 있어야 정상 동작한다.
- 개체명 인식은 단독으로 수행되지 않고,
토큰화 → 품사 태깅 → NER의 순차적인 파이프라인 위에서 동작한다. - 통계 기반 모델을 사용해 사람, 조직 같은 의미 단위를 자동으로 분류할 수 있다.
7. 배운 점
NLTK의 NER은 단순 규칙이 아니라
통계 모델과 언어적 특징을 결합한 전통적인 자연어 처리 방식이다.
비록 최신 딥러닝 기반 모델에 비해 성능은 제한적이지만,
자연어 처리의 기본 개념과 흐름을 이해하기에는 매우 좋은 실습이었다.
이 과정을 이해하면 이후 spaCy, BERT 기반 NER 모델을 학습할 때도
전체 구조를 훨씬 쉽게 받아들일 수 있다.
LSTM 기반 문자 단위 텍스트 생성 (Nietzsche Dataset)
이 코드는 Keras(TensorFlow)를 사용하여
니체(Nietzsche) 텍스트 데이터를 기반으로
문자 단위(Character-level) LSTM 언어 모델을 학습하고,
학습 과정에서 다양한 temperature(diversity) 값으로 텍스트를 생성하는 예제이다.
1. 라이브러리 임포트
from __future__ import print_function

from tensorflow.keras.callbacks import LambdaCallback
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, LSTM
from tensorflow.keras.optimizers import RMSprop
from tensorflow.keras.utils import get_file

import numpy as np
import random
import sys
import io
# 텍스트 파일 다운로드
fpath = get_file(
    'nietzsche.txt',
    origin='https://s3.amazonaws.com/text-datasets/nietzsche.txt'
)

# 텍스트 읽기
with io.open(fpath, encoding='utf-8') as f:
    text = f.read().lower()

# 문자 사전 생성
chars = sorted(list(set(text)))
char2index = dict((c, i) for i, c in enumerate(chars))
index2char = dict((i, c) for i, c in enumerate(chars))

maxlen = 40   # 입력 시퀀스 길이
step = 3      # 이동 간격

sentences = []
next_chars = []

for i in range(0, len(text) - maxlen, step):
    sentences.append(text[i:i + maxlen])
    next_chars.append(text[i + maxlen])

print('The number of sentences:', len(sentences))

# One-hot 인코딩
x = np.zeros((len(sentences), maxlen, len(chars)), dtype=bool)
y = np.zeros((len(sentences), len(chars)), dtype=bool)

for i, sentence in enumerate(sentences):
    for t, char in enumerate(sentence):
        x[i, t, char2index[char]] = 1
    y[i, char2index[next_chars[i]]] = 1
model = Sequential()
model.add(LSTM(128, input_shape=(maxlen, len(chars))))
model.add(Dense(len(chars), activation='softmax'))

optimizer = RMSprop(learning_rate=0.01)
model.compile(
    loss='categorical_crossentropy',
    optimizer=optimizer
)
def sample(preds, temperature=1.0):
    preds = np.asarray(preds).astype('float64')
    preds = np.log(preds) / temperature
    exp_preds = np.exp(preds)
    preds = exp_preds / np.sum(exp_preds)
    probas = np.random.multinomial(1, preds, 1)
    return np.argmax(probas)
def on_epoch_end(epoch, _):
    print('\nEpoch: %d' % epoch)

    start_index = random.randint(0, len(text) - maxlen - 1)

    for diversity in [0.2, 0.5, 1.0, 1.2]:
        print('\nDiversity:', diversity)

        generated = ''
        sentence = text[start_index:start_index + maxlen]
        generated += sentence

        print('Seed:', sentence)
        sys.stdout.write(generated)

        for i in range(400):
            x_pred = np.zeros((1, maxlen, len(chars)))

            for t, char in enumerate(sentence):
                x_pred[0, t, char2index[char]] = 1.0

            preds = model.predict(x_pred, verbose=0)[0]
            next_index = sample(preds, diversity)
            next_char = index2char[next_index]

            sentence = sentence[1:] + next_char
            sys.stdout.write(next_char)
            sys.stdout.flush()
print_callback = LambdaCallback(on_epoch_end=on_epoch_end)

model.fit(
    x, y,
    batch_size=128,
    epochs=60,
    callbacks=[print_callback]
)
코드 기능 정리
이 코드는 TensorFlow(Keras)를 사용해 문자 단위(Character-level) LSTM 언어 모델을 학습하고, 학습 과정 중에 생성된 텍스트를 출력하는 기능을 수행한다. 전체적인 목적은 LSTM이 연속된 문자 시퀀스를 입력받아 다음에 등장할 문자를 예측하도록 학습시키는 것이다.
먼저, 니체(Nietzsche)의 텍스트 파일을 다운로드하여 하나의 긴 문자열로 불러온다. 이후 텍스트에 등장하는 모든 고유 문자를 추출해 문자 사전을 생성하고, 각 문자를 정수 인덱스로 매핑한다. 이 과정은 모델이 문자를 숫자로 처리할 수 있도록 하기 위한 준비 단계이다.
다음으로, 원본 텍스트를 길이 40의 문자 시퀀스로 잘라 학습 데이터를 만든다. 각 시퀀스는 입력 데이터가 되며, 해당 시퀀스 바로 뒤에 오는 한 글자가 정답 데이터가 된다. 즉, 모델은 “앞의 40글자를 보고 다음 1글자를 예측”하도록 학습된다. 이 입력과 정답은 모두 one-hot 인코딩 방식으로 변환되어 LSTM 모델에 전달된다.
모델 구조는 단순한 LSTM 기반의 시퀀스 예측 모델이다. 하나의 LSTM 레이어가 문자 시퀀스의 시간적 패턴을 학습하고, 마지막 Dense 레이어가 다음에 등장할 문자에 대한 확률 분포를 출력한다. 출력층에서는 softmax 함수를 사용하여 각 문자가 다음에 등장할 확률을 계산한다.
학습 과정에서는 epoch이 끝날 때마다 콜백 함수를 통해 텍스트 생성이 수행된다. 랜덤하게 선택한 시작 문장을 seed로 사용하고, 모델이 예측한 확률을 기반으로 다음 문자를 하나씩 생성한다. 이때 temperature(diversity) 값을 조절하여, 예측 결과의 보수성 또는 랜덤성을 변화시킨다. temperature가 낮으면 확률이 높은 문자 위주로 선택되어 안정적인 문장이 생성되고, 값이 높아질수록 더 다양한 문자가 선택되어 창의적이지만 불안정한 문장이 생성된다.
결과적으로 이 코드는 LSTM이 문자 수준에서 텍스트의 통계적 패턴을 학습하고, 학습된 모델이 어떤 방식으로 문자를 생성하는지를 관찰하기 위한 실습용 예제이다. 자연어의 의미를 이해하기보다는, 시퀀스 데이터 예측과 텍스트 생성의 기본 원리를 경험하는 데 목적이 있다.
정리
이번 실습은
"사람이 정의한 문법 규칙으로 문장을 구조화하고,
그 구조를 트리 형태로 확인하는 경험"을 하는 시간이었다.
딥러닝 기반 NLP를 이해하기 위해 반드시 거쳐야 할
전통적인 자연어 처리 사고방식을 직접 체험한 실습이다.