들어가기전에
알고리즘 문제를 풀다 보면 스택(Stack) 을 사용하는 문제를 정말 자주 접하게 된다.
처음에는 “괄호 검사할 때 쓰는 자료구조” 정도로만 생각했는데, 문제를 많이 풀어보니 스택은 훨씬 더 다양한 방식으로 등장했다.
이번 글에서는 코딩 테스트에서 자주 등장하는 스택 패턴을 실제 문제 예시와 함께 정리해보려고 한다.
스택이란?
1. 기본 개념
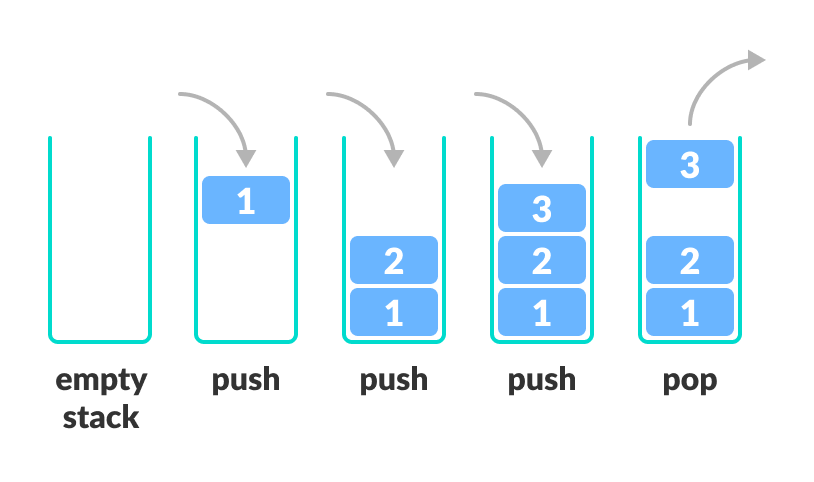
스택은 LIFO (Last In, First Out) 구조이다.
- push → 맨 위에 추가
- pop → 맨 위에서 제거
- top → 맨 위 값 확인
가장 최근에 들어온 값부터 처리한다는 점이 핵심이다.
2. 왜 스택을 쓰는가?
스택은 단순히 “저장하는 용도”가 아니라,
이전 값들과 현재 값을 빠르게 비교하고 정리하는 도구 로 사용된다.
특히 이런 상황에서 자주 쓰인다.
- 현재 값이 이전 값보다 크거나 작은 경우
- 어떤 조건이 깨질 때까지 이전 값들을 정리해야 하는 경우
- 다시 돌아올 수 있는 값인지 판단해야 하는 경우
예제로 살펴보기
프로그래머스도 좋지만 LeetCode가 굉장히 문제은행? 같은 느낌으로 난이도별로 나열이 잘 되어있었기에 LeetCode 예제로 스택을 살펴보려고한다.
Valid Parentheses(Easy)
문제) 괄호 문자열이 올바른지 판단하라. ()[]{} → true (] → false
// 가장 최근에 열린 괄호부터 닫혀야 한다 → LIFO 구조
var isValid = function(s) {
    let stack = [];
    let map = {
        ')': '(',
        '}': '{',
        ']': '['
    };

    for (let char of s) {
        if (char === '(' || char === '{' || char === '[') {
            stack.push(char);
        } else {
            if (stack.length === 0) return false;
            let top = stack.pop();
            if (top !== map[char]) return false;
        }
    }

    return stack.length === 0;
};
이 문제는 진짜 쉬웠다.
Daily Temperatures(Midium)
문제) 각 날짜마다 더 따뜻해지는 날까지 며칠 걸리는지 구하라.
입력: [73,74,75,71,69,72,76,73]
출력: [1,1,4,2,1,1,0,0]
//각 인덱스는 push 1번, pop 1번 → O(N)
//“다음 큰 값” 유형의 대표 문제
var dailyTemperatures = function(temperatures) {
    let stack = [];
    let answer = new Array(temperatures.length).fill(0);

    for (let i = 0; i < temperatures.length; i++) {

        while (
            stack.length &&
            temperatures[stack[stack.length - 1]] < temperatures[i]
        ) {
            let prevIndex = stack.pop();
            answer[prevIndex] = i - prevIndex;
        }

        stack.push(i);
    }

    return answer;
};
아.. 이문제는 푸는데 생각보다 꽤 걸렸다.
멍청하게도 Index를 Stack에 저장해서 쓴다는 아이디어를 생각하지 못했다.
30분넘게 끙끙거리다 GPT한테 힌트를 얻으니 금방 풀렸던 문제였다.
Remove Duplicate Letters(Midium)
문제) 중복 문자를 제거하면서 사전순으로 가장 작은 문자열 만들기.
//더 작은 문자가 나오면 이전 문자를 제거할지 판단
//단, 그 문자가 나중에 다시 등장해야 제거 가능

var removeDuplicateLetters = function(s) {
    let stack = [];
    let seen = new Set();
    let lastIndex = {};

    // 각 문자의 마지막 등장 위치 저장
    for (let i = 0; i < s.length; i++) {
        lastIndex[s[i]] = i;
    }

    for (let i = 0; i < s.length; i++) {
        let char = s[i];

        if (seen.has(char)) continue;

        while (
            stack.length &&
            stack[stack.length - 1] > char &&
            lastIndex[stack[stack.length - 1]] > i
        ) {
            seen.delete(stack.pop());
        }

        stack.push(char);
        seen.add(char);
    }

    return stack.join('');
};
처음에 풀 땐 stack.indexOf(char)로 이미 들어간 문자인지 확인하고,
substr로 잘라내는 방식을 반복했다.
이렇게 하니 정답은 통과했지만 런타임이 좋지 않았다.
GPT에게 물어보니 Set이나 Map을 활용해 인덱스를 O(1)로 체크하면 성능을 개선할 수 있다고 했고, 실제로 33ms 정도 나오던 코드가 11ms 수준으로 줄어들었다.
스택 문제를 언제 떠올려야 하는가?
다음과 같은 문장이 보이면 스택을 의심해볼 수 있다:
- 다음에 더 큰 값
- 이전 값과 비교”
- 조건이 깨질 때까지 제거”
- 사전순으로 가장 작은 결과”
- 중복 제거”
특히 “다음 큰 값”, “이전 작은 값” 이런 표현이 나오면 거의 스택 문제다.
스택 문제의 핵심은 단순하다.
지금 상태를 더 좋게 만들기 위해, 이전 상태를 정리한다
그래서 대부분 O(N)으로 해결된다.
마무리
스택이 가장 쉽고 자신있었던 파트였는데 살짝 문제를 꼬아버리면 어렵게 느껴졌다.
특히 인덱스를 저장해서 사용하는 방법 이런 아이디어 요소들이 부족했던 것 같다.
아직 완벽하진 않지만, 이런 패턴들을 하나씩 정리해가면서 점점 더 빠르게 문제를 인식할 수 있게 되는 것 같다.
앞으로도 자주 틀리고, 또 정리하면서 익숙해져보려고 한다.
솔직히 한글이 제일 어렵다.. 책 좀 읽자