1. 배경 및 목적
과제를 통해 이상 감지가 필요한 업무영역 에서는 방대한 양의 데이터가 있고 정답이 명확하지 않았습니다.
따라서, 전체 데이터에서 이상여부를 명확하게 구분하기가 쉽지 않았고, 많은 리소스를 들여 이상패턴을 파악하더라도 이상패턴에 대한 조치활동은 상대적으로 제한적일 수 있었습니다.
현업에서 이상 감지(Anomaly Detection)를 활용할 때 대부분의 데이터는 정상 범위에 속하는 반면 이상 패턴은 극히 소수에 불과합니다.
-
은행: 대부분의 은행 거래는 일반적인 송금, 출금, 입금과 같은 정상적인 패턴을 보입니다.
그러나 특정 거래는 이상거래로 간주될 수 있는데, 예를 들면 동시에 큰 금액이 여러 계좌로 분할 이체되는 경우, 평소 거래 패턴과 크게다른 지역에서의 큰 금액 거래 등이 있습니다.
이러한 이상거래는 전체 거래의 아주 작은 부분만을 차지합니다. -
제조업: 대규모 제조 공장에서 생산하는 제품들 중 대부분은 품질 테스트를 통과합니다.
그러나 소수의 제품은 결함이 있을 수 있으며, 이러한 결함 제품은 전체 생산량의 작은 비율을 차지 합니다. -
웹 트래픽: 웹 사이트에 방문하는 트래픽 중 대부분은 정상적인 사용자들의 요청에 의한 것입니다.
그러나 DDoS 공역이나 다른 형태의 악의적인 행위를 수행하는 트래픽은 전체 트래픽 중 작은 부분만을 차지합니다.
저희는 각 센서값의 이상탐지를 위해 Threshold를 사용했는데 이럴경우, 점차적으로 오르는 경우나, 날씨에 따른 온도 변화등 다양한 변수가 적용이 되는데 이것을 값에 적용하기가 어렵다는 사실을 확인했습니다.
이를 개선하기 위해 머신 러닝(Machine Learning)기법을 도입하여 비정상 포인트를 자동으로 식별하고 점수화하여 추천하는 방식을 구현하고, 비정상 건수의 원인이 되는 상위 객체를 매핑하고 그룹화하여 분류 기준을 정립했습니다.
머신 러닝을 이용한 이상 탐지에는 지도 이상탐지, 준지도 이상탐지, 비지도 이상탐지 등 세 가지 접근 방식이 있습니다.
이상탐지 접근방식은 데이터 라벨 유무와 사용 목적에 따라 선택됩니다.
이번 과제수행을 위해 활용한 데이터는 라벨이 없으며,
초기 필터링은 규칙 기반으로 이루어졌기 때문에 비지도 이상 탐지 방법을 채택했습니다.
- 데이터의 현실
제조 데이터의 극심한 클래스 불균형(Class lmbalance)때문 입니다.
스마트 팩토리 환경에서 설비는 99.9% 정상 가동되며, 고장 데이터는 매우 희귀합니다.
지도 학습을 하려면 충분한 양의 '고장(Label)'데이터가 필요한데, 현실적으로 이를 수집하기 위해 일부러 설비를 고장 내기에는 힘듭니다. 따라서 라벨 없이도 데이터 분포를 통해 이상을 탐지할 수 있는 비지도 학습이 필요하다고 생각합니다.
-
미지의 이상 탐지
알려지지 않은 새로운 유형의 이상(Unknown Anomalies)을 탐지하기 위해서 입니다.
지도 학습은 '과거에 발생했던 고장'만 학습하므로, 새로운 부품이나 환경 변화로 인해 발생하는 예측 불가능한 이상 패턴은 놓칠 위험이 큽니다.
비지도 학습(Outlier Detection)방식은 정상 범주에서 벗어나는 모든 패턴을 감지하므로,
우리가 정의하지 못한 잠재적 위험까지 포착할 수 있다는 장점이 있습니다. -
라벨링 비용과 유지보수
세번째는 운영 효율성입니다. 수집되는 방대한 IoT센서로그(RPM, 소음, 진동 등)에 일일이 '정상/비정상' 라벨을 붙이는 것은 막대한 도메인 지식과 인적 비용이 듭니다.
비지도 학습은 라벨링 과정 없이 실시간으로 유입되는 데이터 스트림에 바로 적용할 수 있어,
시스템 구축 속도와 유지 보수 측면에서 효율적 이라고 판단합니다. -
기술 스택과의 정합성
데이터 저장소인 OpenSearch의 Anomaly Detection 플러그인이 Random Cut Forest(RCF)라는 비지도 학습 알고리즘을 기반으로 하고 있기 때문에, 이는 대용량 스트리밍 데이터 처리에 최적화되어 있으며,
별도의 복잡한 모델 파이프라인 구축 없이도 데이터 적재와 동시에 실시간 이상 탐지가 가능하다는 점에서 기술적 적합성이 높습니다.
| 구분 | 지도 학습 (Supervised) | 반지도 학습 (Semi-supervised) | 비지도 학습 (Unsupervised) |
|---|---|---|---|
| 공식 용어 (Scikit-learn) | Classification (Imbalanced) | Novelty Detection | Outlier Detection |
| 레이블 | O | O | X |
| 학습 데이터 상태 | 정상 + 비정상 (모두 라벨 O) | 정상 데이터만 (Clean Data) | "데이터 패턴을 학습하여 통계적, 구조적 특성 등을 기반으로 이상패턴을 탐지한다." |
| 핵심 논리 | "이것은 A(정상)이고, 저것은 B(불량)다." (패턴 매칭) | "이것이 정상이다. 이 범위를 벗어나면 모두 이상이다." | "대다수는 정상이다. 동떨어진 소수의 데이터가 이상이다." |
| 주요 역할 | 이미 알려진 특정 공격이나 불량 유형을 정확히 탐지 | 초기 불량 데이터가 없는 환경에서 새로운 유형의 이상 탐지 | 데이터 정제 없이 전체 로그나 트래픽에서 특이점 발굴 |
| 장점 | - 가장 높은 정확도 - 명확한 라벨이 있어 학습결과 성능 평가 가능 (Precision/Recall) | - 비정상 데이터 수집 불필요 - 처음 보는(Unknown) 이상 탐지 가능 | - 라벨링이 필요하지 않다. - 데이터 내부의 숨겨진 인사이트 발견 가능 |
| 단점 | - 비정상 데이터 확보 및 라벨링 비용 과다 - 학습하지 않은 새로운 이상 탐지 불가 | - 학습 데이터(정상)에 노이즈가 섞이면 성능 저하 - 과적합(Overfitting) 가능성 | - 지도/반지도 대비 낮은 정확도 - 노이즈와 실제 이상의 구분이 모호함 - 모델의 성능 검증이 어려울수 있다. |
| 추천 알고리즘 | XGBoost, LightGBM, Random Forest, CNN, LSTM | One-Class SVM, Local Outlier Factor (novelty=True), Autoencoder | Isolation Forest, Elliptic Envelope, DBSCAN, PCA |
| 적합한 상황 | "불량 유형을 이미 알고 있고, 샘플 데이터도 충분할 때" | "불량 샘플은 없지만, 깨끗한 정상 데이터는 많을 때" | "정답도 없고, 데이터에 무엇이 섞여 있는지 모를 때" |
알고리즘&핵심모델링
비지도 이상탐지를 위해서, Amazon Sagemaker 플랫폼에 내장된 RCF(Random Cut Forest)알고리즘을 채택했습니다. 이 알고리즘은 SageMaker플랫폼에 기본적으로 포함되어 있어 접근성이 용이하며 Amazon Lookout for Metrics와 같은 완전관리형 솔루션에 비해 비용 효율적 입니다.
용어정리
Amazon Sagemaker: AWS에서 제공하는 완전 관리형 클라우드 기계 학습(ML) 플랫폼 입니다.
Amazon Lookout for Metrics: 기계 학습(ML)을 활용해 운영 지표에서 발생하는 이상(anomaly)을 자동으로 탐지하고, 그 원인을 파악하여 신속하게 문제 해결을 돕는 AWS 서비스 입니다.
Amazon SageMaker AI Random Cut Forest(RCF)는
데이터 세트 내에서 이상 데이터 포인트를 감지하기 위한 비지도 알고리즘 입니다.
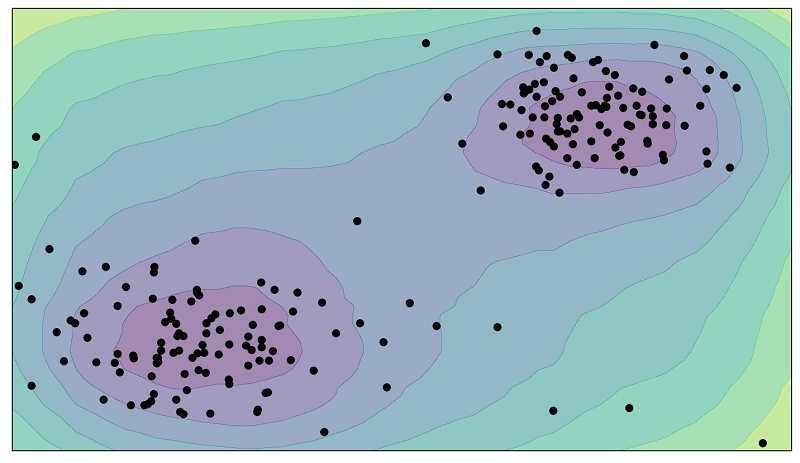
RCF의 핵심 원리: "이상한 데이터는 고립시키기 쉽다"
RCF는 "데이터를 무작위로 자를 때, 튀는 데이터(이상치)는 정상 데이터보다 더 빨리 분리된다." 라는 아이디어에서부터 출발한다.
- 정상 데이터: 데이터들이 뭉쳐 있기 때문에, 하나를 분리해 내려면 여러 번 잘라야(Cut) 해야 한다.
- 이상 데이터: 다른 데이터와 동떨어져 있기 때문에, 적은 횟수의 자르기만으로도 금방 고립(isolation)된다.
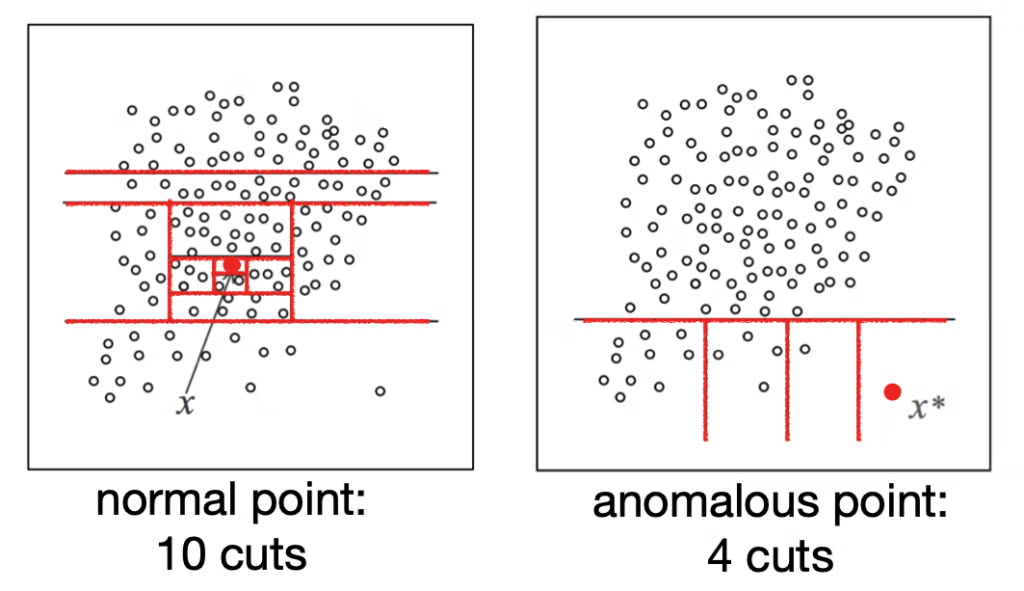
위 그림을 보면 2차원 평면에(네모 박스)위에 점들이 찍혀 있습니다.
- 대부분의 점들은 한곳에 뭉쳐 있고(정상)
- 몇 개의 점만 멀리 떨어져 있습니다.(이상)
데이터를 자르는(Cut/Split)핵심 기준은 데이터의 변동폭(Range)에 비례하는 확률 입니다.
일반적인 Isolation Forest가 변수를 완전히 무작위로 선택하는 것과 달리,
RCF는 데이터가 넓게 퍼져 있는 차원을 더 우선적으로 자르도록 설계되어 있습니다.
1. RCF의 자르는 기준
RCF는 트리를 구성할 때마다 다음의 두 단계를 거쳐 데이터를 분할합니다.
- 차원(Dimension)선택
데이터를 자를 변수(차원)를 선택할 때, 값의 범위(Mac - Min)가 큰 차원일수록 선택될 확률이 높습니다.
- 공식: 특정 차원 가 선택될 확률은 그 차원의 데이터 범위 에 비례합니다.
-
여기서 입니다.
-
의미: 데이터가 좁게 모여 있는 차원보다는, 넓게 퍼져 있는(변동성이 큰)차원을 잘라야 이상치(Anomaly)를 더 효율적으로 격리할 수 있기 때문입니다.
2.절단 지점(Cut Value)선택
차원이 결정되면, 그 차원의 최솟값과 최댓값 사이에서 무작위(Uniformly Random)로 값을 하나 선택 하여 자릅니다.
- 즉" 데이터가 가장 널리 분포된 속성을 기준으로 자를 확률이 높고, 그 범위 안에서 무작위로 자른다."
정상 데이터(Normal Point)의 경우
- 상황: 다른 점들과 빽빽하게 뭉쳐 있습니다.
- 과정: 이 점 하나만 따로 떼어내려면(고립시키려면),
수많은 선을 그어서 쪼개고 또 쪼개야 합니다. - 트리 그림: 아래쪽 트리 구조에서
깊이(Depth)가 아주 깊게 내려감 - 결론: 애는 평범한 애들 틈에 섞여 있어서 찾아내기 힘들다 ->
정상
이상 데이터(Anomaly Point)의 경우
- 상황: 뭉쳐 있는 그룹에서 멀리 떨어져 혼자 있습니다.
- 과정: 무작위로 선을 대충 한두 번만 그어도, 금방 그룹과 분리되어 혼자 남게 됩니다.
- 트리 그림: 트리 구조의 맨 위쪽(Root) 근처에서 바로 끝납니다(깊이가 얕음)
- 결론: 대충 잘라도 금방 눈에 띄네? ->
이상징후
즉 트리의 깊이가 얕을수록(빨리 분리될수록) 이상점수(Anomaly Score)가 높다.
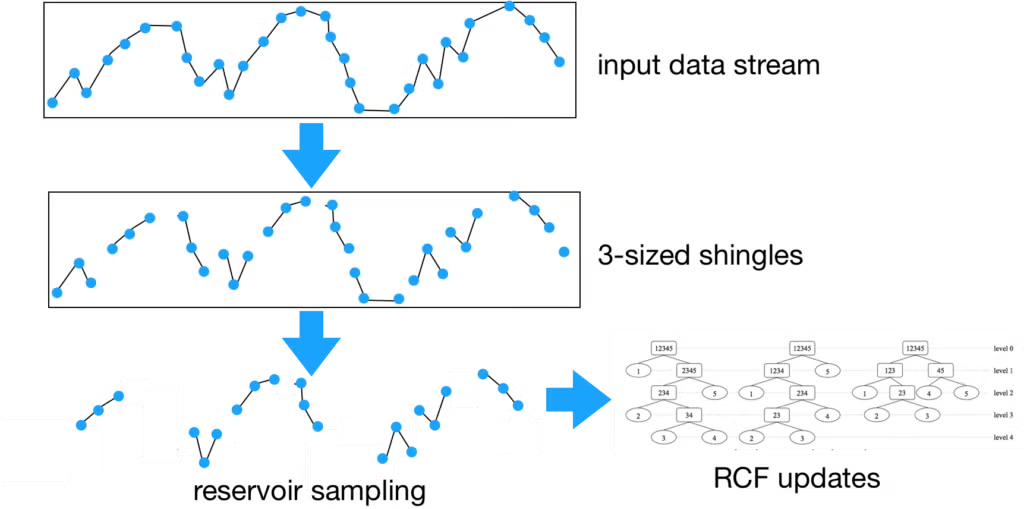
위 그림은 점 하나(point)가 아니라 흐름의 모양(shape)을 기억하기 위해 데이터를 조각내어(Shingling) 효율적으로 저장(Sampling)하는 과정입니다.
input data stream(입력 데이터 스트림)
- 실시간으로 계속 들어오는 원본 시계열 데이터 입니다.
- 점들이 선으로 연결되어 오르락내리락 하는 하나의 긴 흐름입니다.
3-sized Shingles (3개 짜리 싱글링/묶음)
- 데이터를 점 하나씩 보는 게 아니라, 연속된 3개의 점을
하나의 세트(shingle)로 묶습니다.
왜 그렇게 할까? 의문이 생기기 마련 입니다.
- 점 하나만 보면: 값이
50이라는 것만 알 수 있습니다. - 3개를 묶어 보면:
[40, 50, 60]이면 상승세라는 모양(shape)를 알 수 있고,[60, 50, 40]이면 하강세 라는 모양을 알 수 있습니다.
이 과정 덕분에 RCF는 단순한 값의 크기뿐만 아니라 패턴이 갑자기 깨지는 것(예: 계속 오르다가 갑자기 뚝 떨어짐)을 이상 징후로 잡아낼 수 있습니다.
참고
openSearch 설정에서shingle_size가 자르는 크기를 의미합니다 (기본값은 8)
Reservoir Sampling (레저버 샘플링)
저수지(Reservoir)에 물을 담아두듯 샘플을 추출하는 기법입니다.
문제점
데이터는 24시간 365일 무한히 들어오는데, 컴퓨터 메모리는 한정되어 있습니다. 모든 데이터를 다 저장할 순 없습니다.
해결책
들어오는 수많은 싱글(묶음)중에서 '전체를 잘 대표할 수 있는 일부'만 확률적으로 뽑아서 메모리(저수지)에 남깁니다.
효과
오래된 데이터라도 무조건 버리지 않고 통계적으로 중요한 샘플을 유지하면서, 적은 메모리로도 전체 데이터의 특징을 기억할 수 있게 합니다.
RCF updates (RCF 모델 업데이트)
위에서 잘 뽑힌 '대표 샘플(모양 조각들)'을 가지고, 숲(Forest)속의 나무(Tree) 구조를 업데이트 합니다.
결과
숲은 이제 "아, 평소에는 이런 '상승모양'이나 '하강 모양'이 많구나"라고 학습하게 되며, 나중에 본 적 없는 이상한 모양의 조각이 들어오면 "이건 이상하다!"라고 탐지하게 됩니다.
Define detector (detector interval)
Interval (인터벌 /감지간격)
그림 맨 위[input data stream]박스의 파란점 하나하나
-
그림 맨 윗부분을 보면 파란 점들이 선으로 이어져 있습니다.
여기서 점 하나가 차지하는 시간의 길이가 바로interval입니다. -
설명: 그림 속 파란 점 하나가 "1분 동안의 평균값"인지, "1시간 동안의 평균값" 인지를 결정합니다.
- 이 간격이 좁으면(예:1분): 점이 촘촘하게 찍혀서 미세한 변화를 잡지만 노이즈가 많아집니다.
- 이 간격이 넓으면(예 1시간): 점이 드문드문 찍혀서 큰 흐름만 보게 됩니다.
- 만약
interval = 10분으로 설정했다면, 그림 속 파란 점 1개는 10분 동안의 데이터 평균값 dlqslek. - 이 점과 다음 점 사이의 간격도 10분이 됩니다.
- 즉, 데이터를 얼마나 잘게 쪼개서 점을 찍을 것인가? 를 결정합니다.
Frequency (프리퀀시 / 실행 빈도)
그림 중앙의 '파란색 굵은 화살표들 입니다.
설명: 위쪽 박스(Input)에서 아래쪽 박스(Shingles -> Sampling)로 데이터가 내려가는 흐름(Action) 자체 입니다.
- 작동원리
- 이 화살표 작업을 몇 분마다 수행할 것인가? 이빈다
Frequency = 10분이면, 시스템은 10분마다 깨어나서 " 새로 들얻온 점 없나?" 확인하고, 새로운 점들을 아래쪽shingles박스로 밀어 넣습니다.- 이 화살표가 움직여야 비로소 RCF 숲이 업데이트되고 이상 참지 결과가 나옵니다.
- 보통은
interval과 똑같이 설정합니다. (예: 데이터가 5분마다 점이 찍히니, 기계도 5분마다 돌림). - 하지만 효율을 위해 "점은 1분마다 찍히지만(interval), 기계는 15분마다 몰아서 돌리자(Frequency)"라고 설정할 수도 있습니다.
고급 설정이나 API설정에서 detection_interval또는 스케줄링 설정으로 다뤄집니다.(기본 UI에서는 Interval과 연동되는 경우가 많습니다.)
Window Delay
맨 위[input data stream] 박스의 '가장 오른쪽 끝(최신 데이터)'
그림설명: 맨 위 박스의 가장 오른쪽 끝(방금 들어온 데이터)를 상상해보세요
- 작동원리
- 시스템이 데이터를 읽어들일 때, 가장 오른쪽 끝에 있는 점을 즉시 가져가지 않고 잠시 기다리는 시간 입니다.- 설령 지금 시간이 12:00가 되었다고 해도, 12:00에 해당하는 점을 바로 그림에 그리지 않고
window Delay만큼 (예1분) 기다렸다가 데이터가 완벽하게 도착하면 그때 점을 찍고 아래 단계(화살표)로 내려 보냅니다.
- 설령 지금 시간이 12:00가 되었다고 해도, 12:00에 해당하는 점을 바로 그림에 그리지 않고
History( 학습 데이터)
맨 아래 [RCF updates]의 트리(Tree)구조 전체
그림 설명: 오른쪽 아래에 있는 복잡한 트리 그림(RCF update)을 보세요. 이 트리를 '최초로' 만들 기 우해 필요함 샘플의 개수 입니다.
- 작동원리
- 왼쪽의
Reservoir Sampling박스에 점(샘플)들이 충분히 쌓여야 오른쪽의RCF Updates트리를 그릴 수 있습니다. History = 40이라면, 샘플이 최소 40개가 모일 때까지는 오른쪽 트리 그림이 생성되지 않습니다.(탐지 불가)- 이 기간 동안은 그림의 마지막 단계가 멈춰 있는 상태(Initializing)이 됩니다.
- 왼쪽의
그러면 RCF 알고리즘은 어떻게 비지도 학습을 할까?
밀집도 (Density): 데이터들이 어디에 옹기종기 모여 있는가? (모여 있으면 정상)
거리 (Distance): 데이터 간의 거리가 얼마나 가까운가? (멀면 이상)
차원 간 관계 (Dimension Relation): 변수 A가 증가할 때 변수 B도 증가하는가? (이 규칙이 깨지면 이상)
RCF알고리즘의 기본 개념은 훈련 데이터의 샘플 분할을 사용하여 얻은 각각의 트리를 통해 하나의 포레스트로 만드는 것과 같습니다.
-
입력 데이터의 입력 샘플이 우선 결정된다.
-
임의 샘플은 이후 포레스트에 있는 트리의 수에 따라 분할됩니다.
-
각각의 트리에 이러한 분할이 제공되고,
트리는 지점의 하위 세트를 k-d 트리로 구성합니다.
-
트리별 데이터 지점에 할당된 변칙 점수는 트리의 복잡성에 대한 예상된 변경으로 정의되고 그에 따라 트리에 점수를 추가합니다.
-
이는 평균적으로 트리 지점의 결과 깊이에 반비례 합니다.
-
Random Cut Forest는 각각을 구성하는 트리로부터 평균 점수를 컴퓨팅하고 샘플 크기에 따라 결과를 조정함으로써 이상 점수를 할당합니다.
참고문헌
- https://docs.aws.amazon.com/ko_kr/sagemaker/latest/dg/rcf_how-it-works.html
- https://opensearch.org/blog/real-time-anomaly-detection-in-open-distro-for-elasticsearch/
- https://www.youtube.com/watch?v=9BWHR4JsTNU
- https://techblog.uplus.co.kr/amazon-sagemaker%EC%9D%98-rcf-random-cut-forest-%EC%95%8C%EA%B3%A0%EB%A6%AC%EC%A6%98%EC%9D%84-%ED%99%9C%EC%9A%A9%ED%95%9C-%EC%9D%B4%EC%83%81-%EA%B0%90%EC%A7%80-%EC%8B%9C%EC%8A%A4%ED%85%9C-%EB%A7%8C%EB%93%A4%EA%B8%B0-419123061bfd
- LG유플러스테크블로그
- Robust Random Cut Forest Based Anomaly Detection On Streams