
1. JPA 외부 빈 등록 이슈 해결
SpringBootTest는 Kafka, Redis, Elasticsearch 등 테스트 목적과 무관한 외부 의존성까지 모두 로드하여 속도가 느리고, 환경 설정이 복잡하다는 단점이 있었다. 이를 해결하기 위해 JPA 관련 빈만 로드하는 슬라이스 테스트인 @DataJpaTest를 도입하였다.
하지만 @DataJpaTest는 @Service, @Component 등을 스캔하지 않으므로, 내가 작성한 비즈니스 로직 빈들은 자동으로 등록되지 않는다. 특히 현재 프로젝트의 Persistence Layer는 포트-어댑터패턴의 헥사고날 아키텍처를 따르고 있어, JpaRepository를 직접 상속받지 않는 별도의 Adapter가 존재한다.
따라서 테스트에 필요한 핵심 클래스들을 @Import를 통해 명시적으로 등록해주었다.
@DataJpaTest
@Import({
	CouponService.class,
	CouponJpaAdapter.class,
	JpaAuditingConfig.class
})
2. 쿠폰 발급 비즈니스 로직
@Transactional
public void issueCoupon(CouponType type, User user) {
	Coupon coupon = couponRepository.findByType(type);
	if (coupon == null) throw new EntityNotFoundException("쿠폰이 없습니다.");

	coupon.increaseCount();
	UserCoupon userCoupon = UserCoupon.from(user, coupon);
	userCouponRepository.save(userCoupon);
}
쿠폰이 존재하면 수량을 증가시키고 UserCoupon 테이블에 저장하는 방식이다.
수량 증가 로직은 객체지향적으로 쿠폰 도메인 엔티티 내부에서 처리하도록 구현하였다.
public void increaseCount() {
	if (this.issuedCount >= this.maxCount) {
		throw new IllegalArgumentException("발급 가능 개수를 초과하였습니다.");
	}
	this.issuedCount++;
}
3. 동시성 테스트 환경 구성
100명의 유저가 동시에 쿠폰 발급을 요청하는 상황을 가정하여 멀티 스레드 테스트를 작성하였다.
int taskCount = 100; // 전체 요청 수

ExecutorService executorService = Executors.newFixedThreadPool(32);
CountDownLatch latch = new CountDownLatch(taskCount);
32개의 스레드 풀이 100개의 요청 작업을 병렬로 처리하도록 구성하였다. CountDownLatch는 100개의 작업이 모두 완료될 때까지 메인 스레드가 대기하도록 하는 역할을 한다.
4. 트랜잭션 격리 문제와 해결
@DataJpaTest는 기본적으로 메서드 단위로 트랜잭션이 적용되며, 테스트가 끝나면 자동 롤백된다.
하지만 멀티 스레드 환경에서는 이 방식이 문제가 되었다.
메인 스레드에서 given 절을 통해 유저 데이터를 save 하더라도, 트랜잭션이 아직 커밋되지 않은 상태이기 때문에 다른 스레드(Worker Thread)에서는 해당 유저 데이터를 조회할 수 없었다. (트랜잭션의 격리성으로 인해 커밋되지 않은 데이터 접근 불가)
이 문제를 해결하기 위해 해당 테스트 메서드에만 트랜잭션 전파 속성을 NOT_SUPPORTED로 설정하여 트랜잭션을 껐다.
@DisplayName("...")
@Test
@Transactional(propagation = Propagation.NOT_SUPPORTED) // 트랜잭션 비활성화 (즉시 커밋)
void issueCoupon_Concurrency() { ... }
5. 데이터 초기화 (TearDown)
트랜잭션을 껐기 때문에 @DataJpaTest의 자동 롤백 기능이 동작하지 않는다.
따라서 테스트가 끝난 후 데이터가 DB에 남게 되므로, 다음 테스트에 영향을 주지 않도록 수동으로 데이터를 삭제하는 tearDown 메서드를 작성하였다.
@AfterEach
void tearDown() {
	// FK 제약 조건을 고려하여 자식 테이블부터 삭제
	userCouponRepository.deleteAllInBatch();
	couponRepository.deleteAllInBatch();
	userRepository.deleteAllInBatch();
}
6. 테스트 결과 및 회고
테스트 결과, 100개의 쿠폰 발급을 기대했으나 실제로는 그보다 훨씬 적은 수량만 발급되었다.
// then
assertThat(findCoupon.getIssuedCount()).isEqualTo(100);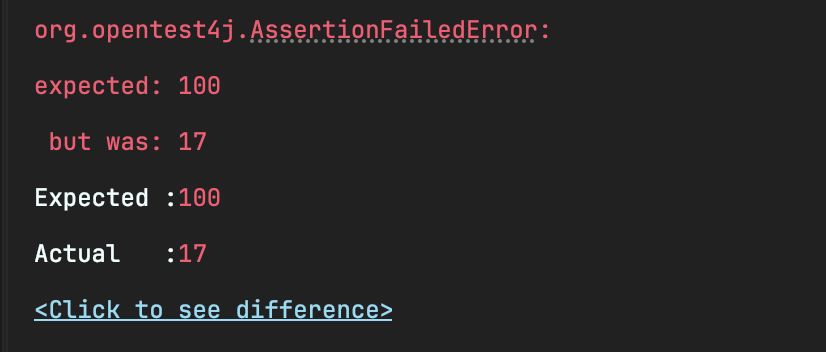
이는 동시에 여러 스레드가 수량을 조회하고 업데이트하는 과정에서 갱신 손실이 발생했기 때문이다. 이를 통해 동시성 처리가 되지 않았음을 명확히 확인할 수 있었다
동시성 충돌 이슈를 해결하기 위한 방법으로 생각나는 몇가지는 아래와 같다
- JPA Lock: 낙관적 락또는 비관적 락 적용
- Redis: Redis의 싱글 스레드 특성을 활용한 원자적 연산 또는 분산 락 도입
- Database: Named Lock 활용
이번 테스트를 작성하며 멀티 스레드 환경에서의 트랜잭션 격리 수준에 대해 다시 한번 리마인드할 수 있었고, @SpringBootTest와 @DataJpaTest, 그리고 @Import의 정확한 사용법과 차이를 명확히 학습할 수 있었다.
과거 프로젝트에서 Kafka를 활용해 게시글 좋아요 API의 응답 속도와 데이터 무결성을 향상시킨 경험이 있다. 이번 쿠폰 도메인의 동시성 이슈는 비동기 처리보다는, 데이터베이스의 락을 활용하여 데이터의 정확성을 보장하는 방식으로 먼저 개선해볼 예정이다.
또한, 이번 과정을 통해 적절한 테스트 범위를 설정하는 것의 중요성을 느꼈는데, 앞으로도 TDD 기반의 견고한 애플리케이션을 구축하는 과정을 꾸준히 기록해나가려 한다.

SpringBootTest가 아닌 DataJpaTest를 사용하여 슬라이스 테스트를 한다는게 인상깊네요!
QuerydslConfig처럼 JpaRepository를 상속받지 않는 설정 파일 등을 테스트할 때 이전에 동우님께서 포스팅하셨던 커스텀 어노테이션을 활용해서 필요한 클래스들을 import하는 것도 괜찮을 것 같다는 생각이 드네요.
항상 공부할 영감을 주셔서 감사합니다! 새해 복 많이 받으세요 ^^