python에서는 copy-on-write가 예상과 다르게 동작할 수 있다?
copy-on-write는 어떤 의미가 있나?
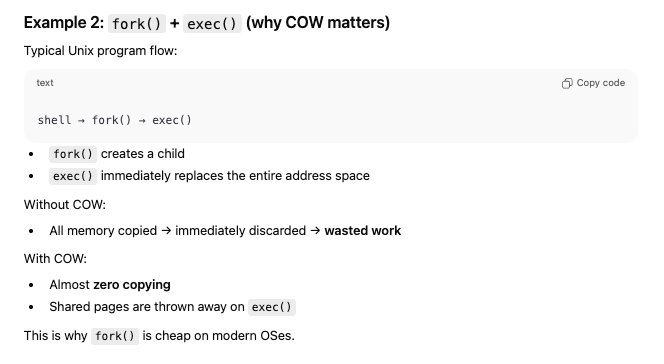
아무런 의미 없이 부모 프로세스의 가상 메모리 전체를 복제하는 오버헤드를 피할 수 있습니다.
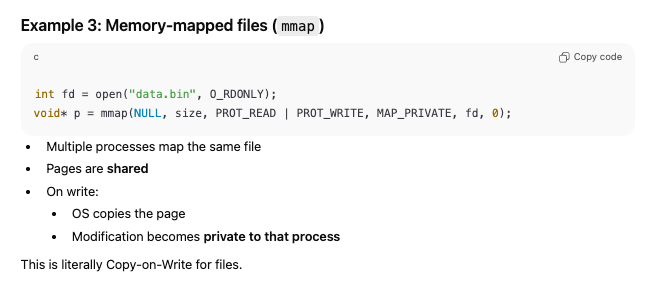
다수의 프로세스들이 같은 파일을 공유할 때 프로세스마다 곧바로 독립적인 파일을 자신의 가상 메모리에 갖는 것이 아니라 일단은 동일한 페이지를 공유하기 때문에 메모리 낭비를 줄일 수 있습니다.
ref count??
python에 대해서 공부하다가 ref count라는 정책을 발견했다.
이 정책은 python의 모든 객체에 ref count라는 값을 두고 이 값을 조절하면서 ref count가 0이 되었을 때 해당 객체를 deallocate하는 정책이다.
CPython에서 ref count라는 값은 실제 객체의 값과 물리/가상 메모리 레벨에서 붙어있다고 한다. (즉 한번에 같이 malloc된다고 보면 될 것 같다.)
이는 C++처럼 기계 레벌에 가까운 언어와는 다르게 명시적으로 메모리를 관리하는 방법이 없고, 언어 차원에서 메모리 관리를 담당해야하기 때문에 생겨난 정책으로 보인다.
그래서 이게 copy-on-write이랑 무슨 상관이야?
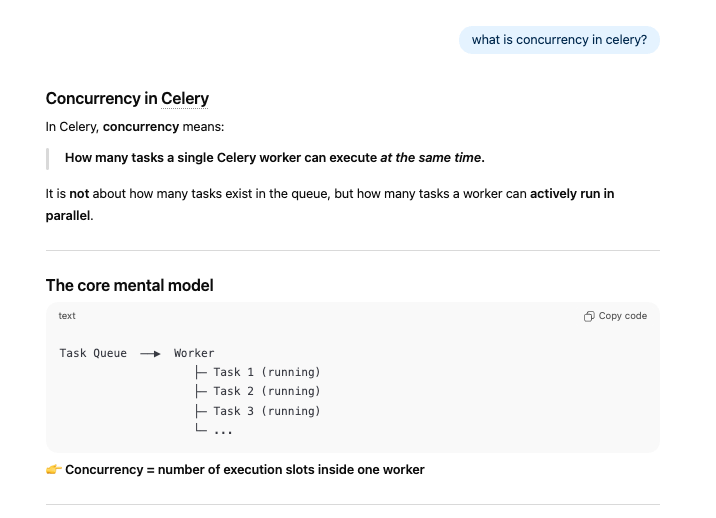
celery에 대해서 공부를 하다보니 concurrency라는 개념을 알게 되었는데, 이는 하나의 celery worker가 처리할 수 있는 task의 수를 말한다.
하나의 worker가 여러 task를 처리하려면 당연히 execution unit이 여러개 필요할 텐데, 이 unit의 타입을 지정할 수 있다.
default 값으로는 prefork(multiprocess)가 있고 이외에도 threads, gevents, ...가 있는데, 이 중에 prefork 방식에 대해서 생각해보자.
이름에서 유추할 수 있듯이 fork를 통해서 자식 프로세스를 미리 생성해두는 방식인데, 흔히 생각하기로는 당연히 copy-on-write 정책을 통해서 메모리 최적화가 어느 정도는 이루어질 것이라고 예상할 수 있는데..
사실은 그렇지 않다.
단순히 특정 객체를 read하는 작업만으로도 ref count가 바뀌기 때문에 사실은 내부적으로 write가 발생하게 되고 바로 그 객체가 속한 페이지 테이블을 복사하게 되는 것. (heap)
따라서 우리가 생각하는 것과는 다르게 cow가 진행되므로 python 기반의 multiprocess 방식은 생각보다 메모리를 많이 잡아먹을 수 있다. (이런 점에 미루어 볼 때 python은 CPU bound의 작업에 좋지 않은 언어인 것 같다...)
일단 다른 언어와 프레임워크에서는 모르겠지만 python 기반의 프레임 워크에서는 이런 메모리 내부 동작을 의식하는 것이 필요할 것 같다.