스마트팩토리부트갬프 2기 애플 스마트 데이터 랩
머신러닝 개요
인공지능->머신러닝->딥러닝
인공지능:인간의 지적 능력이 필요한 작업을 수행하는 기계 또는 프로그램이다.(인간이 할 수 있는걸 기계 도 할 수 있도록 한것)
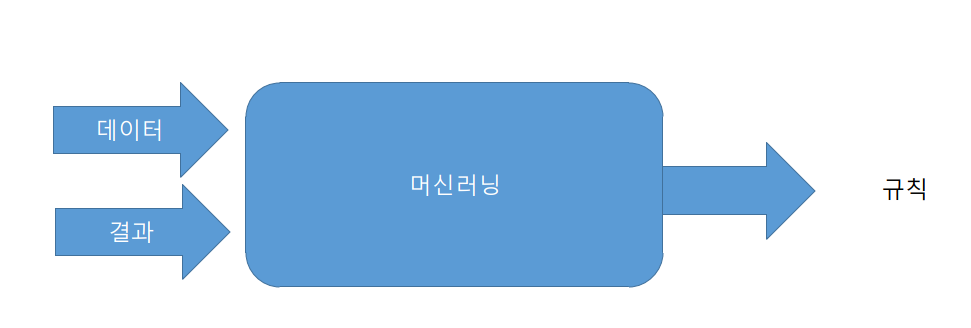
머신러닝:상황에 대한 동작을 일일이 지정하는 대신 스스로 학습하여 대응하도록 하는 방법론이다.(과거의 경험을 토대로 현재의 결과가 발전)
딥러닝:다양한 머신러닝 알고리즘 중 인공 신경망 기반 시스템(폭발적인 발전과 함께 실생활에서도 다양한 적용)
머신러닝의 갈래
머신러닝(기계 학습)에는 3가지 학습법이 있다. 종류로는 비지도학습, 지도 학습, 강화학습이 있다.
지도학습
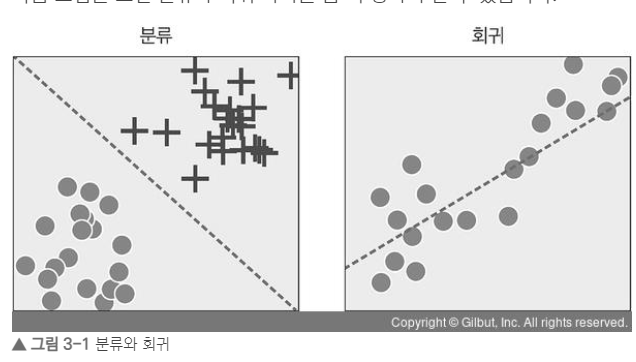
데이터에서 반복적으로 학습하는 알고리즘을 사용하여 컴퓨터가 어디를 찾아봐야 하는 지를 명시적으로 프로그래밍하지 않고도 숨겨진 통찰력을 찾을 수 있도록 하는 데이터 분석 방법이다. 지도 학습에는 두 가지 주요 유형, 즉, 분류 및 회귀가 있다.
-분류:출력 데잍터가 이산적인 값일 때 새로운 입력 데이터가 어떤 클래스에 속하는지 결정하기 위한 분류 알고리즘 개발이다.ex)이미지 분류,고객유지, 신원도용검출,진단
-회귀:출력 데이터가 연속적인 값 새로운 입력 데이터에 대한 출력 데이터의 값 예측 변수들 간의 관계를 추정한다. ex)광고인기 예측, 일기 예보,시장 예측, 기대수명 예측,인구 증가 예측
비지도 학습
학습 알고리즘에 결과물이라고 할 수 있는 출력을 미리 제공하지 않고 인공지능(AI)이 입력 세트에서 패턴과 상관관계를 찾아내야 하는 머신러닝 알고리즘이다.
-레이블이 지정되지 않은 데이터를 처리한다.
-사용자가 보다 복잡한 처리 작업을 수행할 수 있도록 한다.
-더 예측이 어렵다.
-데이터의 근본 구조를 발견하는 데 사용할 수 있다.
-실시간으로 발생한다.
차원축소:고차원 데이터를 저차원 공간에 투영해 중복 정보를 제거하면서 가능한 핵심정보를 유지하는 방법이다. 데이터를 낮은 차원으로 축소시키면 노이즈가 많이 줄어들어 머신러닝 알고리즘이 패턴을 효과적이고 효율적으로 식별 할 수 있다.ex)유의미한 압축,구조검색,특징추출,빅데이터 시각화 등등
군집(클러스터링):레이블이 없는 학습 데이터들의 특징을분석하여 서로 동일하거나 유사한 특징을 가진 데이터끼리 그룹화 함으로써 레이블이 없는 학습 데이터를 군집으로 분류한다. 그리고 새로운 데이터가 입력되면 지도 학습의 분류 모델처럼 학습한 군집을 가지고 해당 데이터가 어느 군집에 속하는지를 분석한다. ex)추천 시스템, 표적마케팅, 고객세분화
강화학습
컴퓨터 에이전트가 역동적인 환경에서 반복적인 시행착오 상호작용을 통해 작업 수행 방법을 학습하는 머신러닝 기법의 한 유형이다.
ex)실시간결정,게임AI,로봇탐색,학습작업,기술획득,학습 작업등등
머신러닝 핵심 요소
데이터(Data)
머신러닝의 입력:머신러닝을 통해 답을 찾고자하는 대상 다양한 형태의 데이터를 입력으로 사용가능하다.(이미지,영상,소리,그래프,텍스트)
레이블(Label)
각 데이터에 대한 정답 같은 데이터에 대해서도 목적에 따라 다양한 종류의 레이블이 가능
모델(Model)
머신러닝이 데이터의 레이블을 예측할 때 사용하는 시스템이다. 목적에 적합한 모델을 선택하는 것이 중요하다. 다양한 지표(오차, 정확도 등)을 통해 모델의 성능을 평가한다.
인공 신경망 구조(Artificial Neural Network)
-현재 머신러닝의 모델로 가장 많이 사용되는 구조
-입력과 출력 사이에 은닉층을 두고 각 층 사이의 연결을 통해 규칙을 학습
-딥러닝:은닉층의 수를 늘러 깊게 만든 인공 신경망 구조
머신러닝 전체 흐름
데이터 준비->데이터 분리->학습->검증->평가->성능 개선->데이터 증강
데이터 준비
데이터수집:학습과 평가에 사용할 데이터를 수집하는 과정
-결과 예측에 사용할 데이터와 같은 환경에서 수집하는 것을 권장한다.
-데이터의 양이 많을수록 좋지만 데이터의 질 역시 중요하다.
필터링:목적에 적합하지 않거나 구분이 쉽지 않은 데이터를 걸러내는 과정
전처리:머신러닝이 데이터를 분석하기 쉽도록 수집한 데이터를 가공하는 과정
레이블링:수집한 데이터에 레이블을 붙이는 과정
데이터분리
수집한 데이터를 훈련/검증/평가 세 종류의 세트로 분리 하나의 데이터는 한 세트에만 포함되어야 정확한 검증과 평가 가능하다.
순서에 대한 연관성을 최대한 배제할 수 있도록 무작위 배치 데이터의 양에 따라 적절한 비율의 분리 필요.
학습(Training)
훈련세트의 데이터를 활용하여 모델 학습, 필요할 경우 같은 데이터에 대해 여러 번 반복
검증(Validation)
학습이 잘 진행되고 있는지 확인하는 과정 학습 과정 중 검증 세트의 데이터로 성능 측정 (성능이 이전 검증에 비해 증가-학습 지속,성능이 여러 검증 동안 증가하지 않거나 오히려 감소-학습 종료)
과적합(Overfitting):훈련 세트에 대해 지나치게 학습이 되어 훈련 세트에 있지 않은 일반적인 데이터에 대해서는 성능이 오히려 허락하는 현상
평가(Evaluation/Test)
학습시킨 모델을 평가 세트로 테스트하는 과정 기대했던 성능을 얻었다면 해당 모델을 사용 만족스럽지 못한 경우 다른 방법을 시도하여 모델 재학습한다.
성능 개선
●데이터
-학습을 위한 데이터 추가 수집
-수집 환경 조정 혹은 전처리 방법 변경
-데이터 불균형 해결
●모델
-모델(알고리즘) 변경
-크기 조절(인공 신경망의 경우 층 수,뉴런의 수 등)
-학습 변수 조정
데이터 예측 단계에서 처리 시간이 적절한지 확인 필요
성능과 처리 시간 사이의 균형
데이터 증강(Data Augmentation)
기존 데이터를 변형하여 학습 데이터의 양을 늘리는 과정(이미지의 경우 회전, 반전, 대비 조정, 자르기 등의 방법 존재) 데이터 불균형 문제 해결에 도움