
데이터베이스는 왜 등장하게 되었을까?
프로젝트를 하면서 데이터베이스는 너무나 당연한 존재였습니다.
회원 정보를 저장할 때도 게시글을 조회할 때도 별다른 고민 없이 MySQL과 JPA를 사용했습니다.
그러다 문득 이런 생각이 들었습니다.
데이터베이스가 없던 시절에는 데이터를 어떻게 관리했을까?
그리고 왜 지금은 대부분의 시스템이 데이터베이스를 사용하는 걸까?
생각보다 이 질문에 명확하게 답하기는 어려웠습니다.
그래서 관련 내용을 찾아보던 중 데이터베이스가 등장하기 전에는 파일 처리 시스템(File Processing System) 이라는 방식으로 데이터를 관리했다는 사실을 알게 되었습니다.
돌이켜보면 저는 데이터베이스를 사용하는 방법만 알고 있었을 뿐 데이터베이스가 등장하게 된 배경에 대해서는 깊게 생각해본 적이 없었습니다.
그래서 이번 기회에 파일 처리 시스템부터 다시 살펴보게 되었습니다.
이번 글에서는 파일 처리 시스템이 어떤 방식으로 동작했는지, 어떤 한계가 있었는지, 그리고 그 한계를 해결하기 위해 DBMS가 어떻게 등장하게 되었는지 알아보려고 합니다.
파일 처리 시스템은 왜 데이터베이스로 대체되었을까?
처음에는 파일 처리 시스템과 데이터베이스의 차이가 크게 느껴지지 않았습니다.
어차피 데이터베이스도 결국 디스크에 데이터를 저장하는데 왜 파일 처리 시스템은 사라지고 DBMS가 등장하게 된 것일까요?
이 궁금증을 해결하기 위해 파일 처리 시스템에 대해 조금 더 찾아보았습니다.
알아보니 두 방식의 가장 큰 차이는 데이터를 관리하는 주체에 있었습니다.
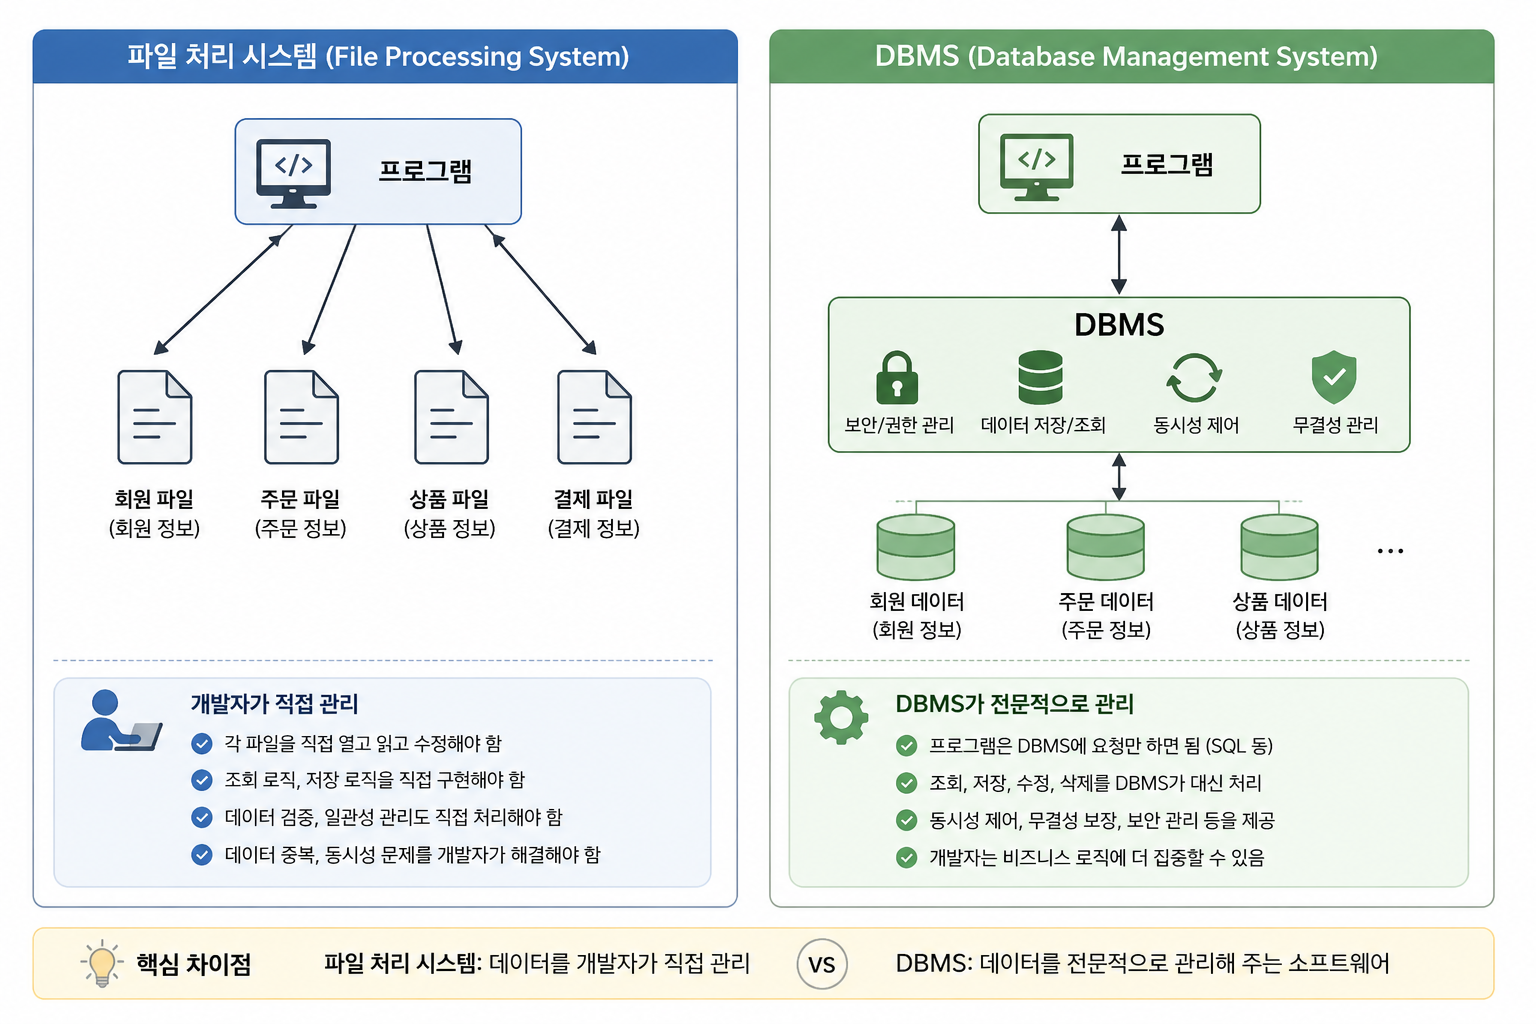
이해를 돕기 위해 ChatGPT를 활용해 간단한 다이어그램을 생성해 보았습니다.
파일 처리 시스템에서는 데이터를 저장하고 조회하는 기능을 개발자가 직접 구현해야 했습니다.
원하는 데이터를 찾기 위해 파일을 읽고, 수정하기 위해 파일을 다시 작성하며, 데이터의 일관성까지 직접 관리해야 했습니다.
반면 DBMS는 이러한 작업을 대신 수행해 줍니다.
우리가 SQL 한 줄로 데이터를 조회할 수 있는 것도, 트랜잭션을 통해 데이터의 무결성을 보장받을 수 있는 것도 모두 DBMS 덕분입니다.
즉, 파일 처리 시스템은 데이터를 개발자가 직접 관리하는 방식이고, DBMS는 데이터를 전문적으로 관리해 주는 소프트웨어라고 볼 수 있습니다.
그렇다면 파일 처리 시스템은 실제로 어떤 방식으로 동작했을까요?
파일 처리 시스템은 어떻게 데이터를 관리했을까?
파일 처리 시스템(File Processing System)은 데이터를 파일에 직접 저장하고 관리하는 방식입니다.
오늘날에는 데이터베이스에 데이터를 저장한 뒤 SQL을 통해 조회하고 수정합니다.
하지만 파일 처리 시스템에서는 개발자가 직접 파일을 읽고 데이터를 관리해야 했습니다.
예를 들어 회원 정보를 관리한다고 가정해 보겠습니다.
1,김철수,20
2,이영희,21
3,박민수,22
회원 정보는 위와 같이 파일에 저장됩니다.
만약 ID가 2인 회원을 조회해야 한다면 어떻게 될까요?
파일 처리 시스템에서는 파일을 열고 데이터를 한 줄씩 읽어가며 원하는 데이터를 직접 찾아야 합니다.
1,김철수,20
2,이영희,21 ← 찾았다!
3,박민수,22
회원을 추가하거나 수정하는 작업도 마찬가지입니다.
파일을 직접 읽고, 수정하고, 다시 저장하는 과정까지 모두 개발자가 구현해야 합니다.
즉, 파일 처리 시스템에서는 데이터 저장뿐만 아니라 조회·수정·삭제 로직까지 개발자가 직접 관리해야 했습니다.
작은 규모의 프로그램에서는 큰 문제가 없었습니다.
데이터 양이 적고 사용자 수도 많지 않았기 때문입니다.
하지만 프로그램 규모가 커지고 데이터가 증가하면서 파일 처리 시스템은 점점 한계를 드러내기 시작했습니다.
이러한 한계는 결국 데이터베이스와 DBMS가 등장하게 된 배경이 되었습니다.
DBMS는 어떻게 문제를 해결했을까?
파일 처리 시스템의 가장 큰 문제는 데이터를 개발자가 직접 관리해야 한다는 점이었습니다.
프로그램 규모가 작을 때는 큰 문제가 없었지만, 데이터와 사용자가 늘어나면서 다양한 한계가 드러나기 시작했습니다.
DBMS(Database Management System)는 바로 이러한 문제를 해결하기 위해 등장했습니다.
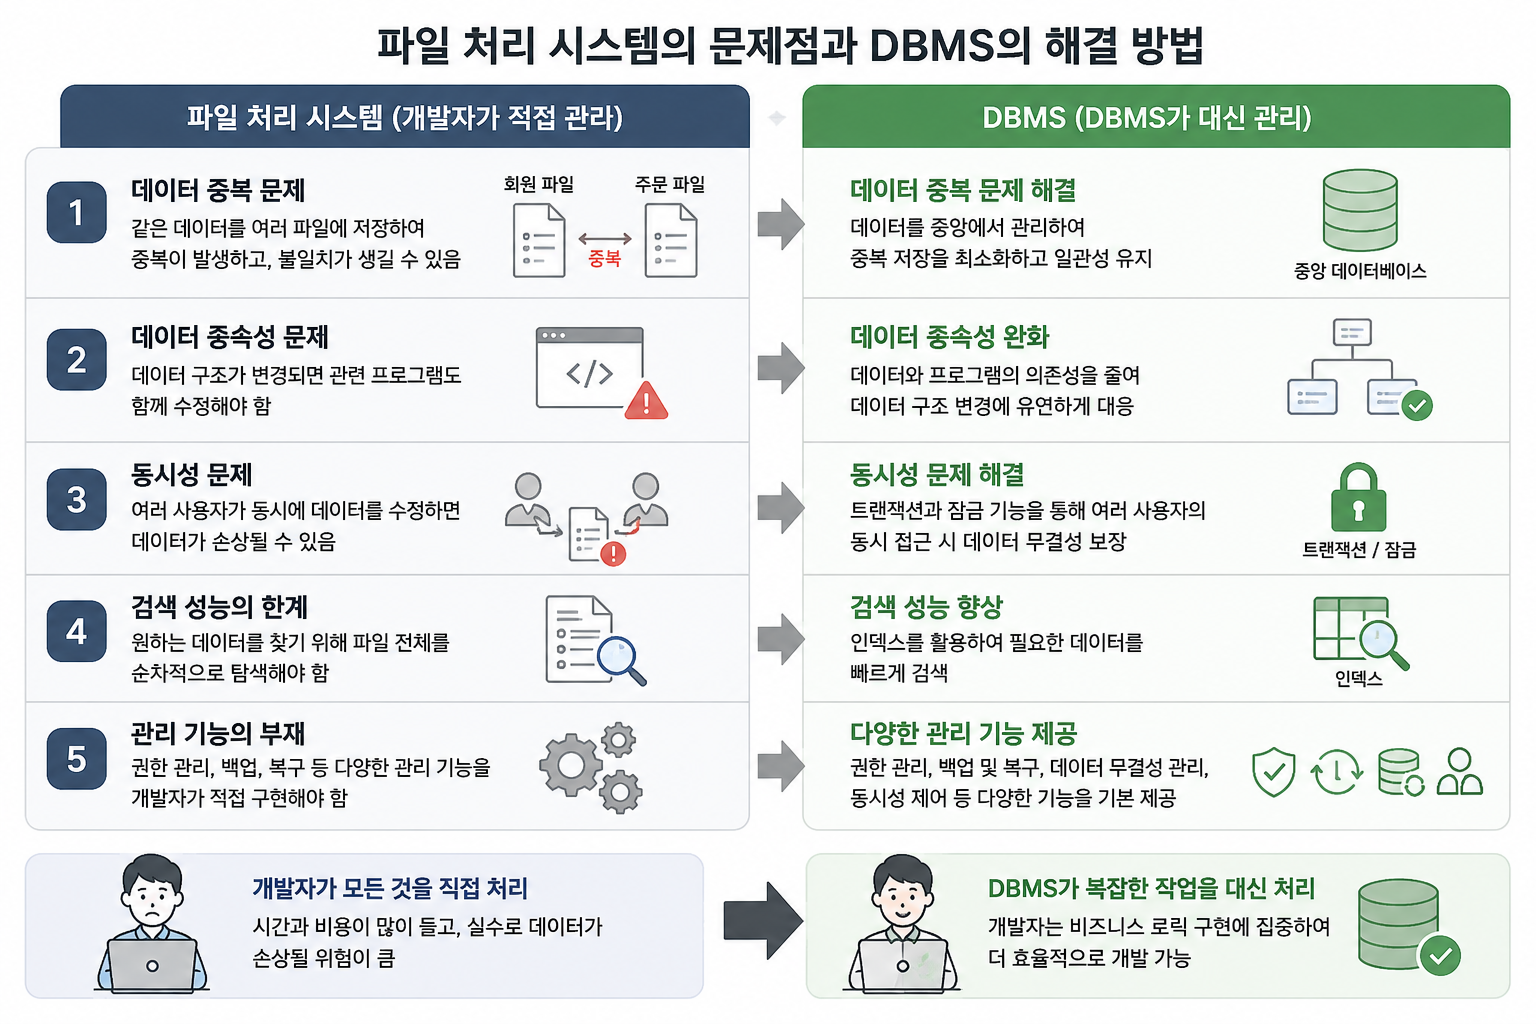
이해를 돕기 위해 ChatGPT를 활용해 간단한 다이어그램을 생성해 보았습니다.
1. 데이터 중복 문제 해결
파일 처리 시스템에서는 같은 정보를 여러 파일에 저장하는 경우가 많았습니다.
하지만 DBMS는 데이터를 중앙에서 관리하여 중복 저장을 최소화하고, 데이터의 일관성을 유지할 수 있도록 도와줍니다.
2. 데이터 종속성 완화
파일 처리 시스템에서는 데이터 구조가 변경되면 관련 프로그램도 함께 수정해야 했습니다.
반면 DBMS는 데이터와 프로그램 사이의 의존성을 줄여 데이터 구조 변경에 유연하게 대응할 수 있도록 지원합니다.
3. 동시성 문제 해결
여러 사용자가 동시에 같은 데이터를 수정하면 데이터가 손상될 수 있습니다.
DBMS는 트랜잭션(Transaction) 과 잠금(Lock) 기능을 제공하여 여러 사용자가 동시에 접근하더라도 데이터의 무결성(Integrity) 을 보장합니다.
4. 검색 성능 향상
파일 처리 시스템에서는 원하는 데이터를 찾기 위해 파일 전체를 순차적으로 탐색해야 하는 경우가 많았습니다.
하지만 DBMS는 인덱스(Index) 를 활용하여 필요한 데이터를 빠르게 조회할 수 있습니다.
데이터가 많아질수록 이러한 성능 차이는 더욱 커집니다.
5. 다양한 관리 기능 제공
DBMS는 단순히 데이터를 저장하는 역할만 하지 않습니다.
- 권한 관리(Security)
- 백업 및 복구(Recovery)
- 데이터 무결성 관리
- 동시성 제어(Concurrency Control)
와 같은 기능을 제공하여 데이터를 더욱 안전하고 효율적으로 관리할 수 있도록 도와줍니다.
DBMS의 등장으로 인해 개발자는 파일 자체를 관리하는 데 시간을 쓰기보다 비즈니스 로직 구현에 집중할 수 있게 되었습니다.
마무리하며
이번 글을 작성하면서 가장 크게 느낀 점은 저는 데이터베이스를 사용만 하고 있었다는 점이었습니다.
평소에는 MySQL과 JPA를 너무 당연하게 사용했지만 그 뒤에는 파일 처리 시스템의 한계를 해결하기 위한 수많은 고민이 숨어 있었습니다.
앞으로는 새로운 기술을 공부할 때 단순히 사용 방법만 익히기보다 어떤 문제를 해결하기 위해 등장했는지 먼저 생각해 보려고 합니다.
