다루는 내용
- 멀티 스레드 프로그래밍이 어떻게 변화했는지
- 기존 멀티스레드 프로그래밍의 한계를 어떻게 극복했는지
- JVM의 프로세스와 스레드에 대한 이해
1. JVM 프로세스와 스레드
일반적인 코틀린 어플리케이션 → main 함수를 통해 생성
- 어플리케이션 실행 시 JVM은 프로세스를 시작하고 메인 스레드를 생성해 main 함수 내부의 코드 실행
fun main() {
	println("Hello World!")
}

// 메인 스레드가 main 함수 내부의 println("Hello World!")를 실행 후 더 실행할 코드가 없으므로 종료
메인 스레드 → 프로세스의 시작과 끝은 함께 하는 매우 중요한 역할을 함
- 예외가 발생해 메인 스레드가 종료되면 프로세스도 함께 종료
fun main() {
	println("메인 스레드 시작")
	throw Exception("Dummy Exception")
	println("메인 스레드 종료")
}

// "메인 스레드 시작"은 출력되지만 메인 스레드에서 발생한 예외로 인해 프로세스가 종료돼
// "메인 스레드 종료"는 출력되지 않음- JVM의 프로세스 → 기본적으로 메인 스레드를 단일 스레드로 해서 실행되어 메인 스레드가 종료되면 함께 종료되는 특징을 가짐
다만 메인 스레드가 항상 프로세스와 끝을 함께 하는 것은 아님
JVM의 프로세스는 사용자 스레드가 모두 종료될 때 종료되며, 메인 스레드는 사용자 스레드 중 하나임
만약 멀티 스레드 환경에서 사용자 스레드가 여러 개인 경우 메인 스레드에서 예외가 발생해 전파되더라도 프로세스는 강제 종료되지 않음
(추후 사용자 스레드와 데몬에서 자세히 다룰 예정)
2. 단일 스레드의 한계와 멀티 스레드 프로그래밍
스레드 하나만 사용하는 어플리케이션 → 단일 스레드 어플리케이션
- main 함수를 통해 애플리케이션을 실행하면 메인 스레드를 단일 스레드로 실행
단일 스레드에서 실행되는 어플리케이션은 치명적인 문제가 있음
2-1. 단일 스레드 어플리케이션의 한계
스레드 → 하나의 작업을 실행중일 때 다른 작업을 동시에 수행하지 못함
- 메인 스레드도 마찬가지
- 실행하는 작업이 오래 걸리면 해당 작업이 처리되는 동안 다른 작업을 수행하지 못함 → 응답성 문제 발생 가능
단일 스레드의 응답성 문제
1. 안드로이드 휴대폰에서 동작하는 어플
-
안드로이드 어플의 경우 UI를 그리는 작업과 사용자 상호작용 이벤트 처리를 메인 스레드에서 수행함
-
네트워크 요청 후 응답을 기다리는 작업, 복잡한 연산 작업 등 오래 걸리는 작업을 메인 스레드에서 처리하면 그 동안 UI를 그리는 작업을 할 수 없어 휴대폰이 멈추거나 버벅이는 원인이 됨
- 실제론 일정 시간동안 응답이 없다면 ANR(Android Not Response)이 발생하나, 이는 다루지 않겠음
2. 서버 사이드 작업
- 클라이언트로 부터 오래 걸리는 작업 요청이 들어왔을 때 단일 스레드만 사용한다면 요청을 처리하는 속도가 늦어져 응답 속도가 늦어짐
단일 스레드만 사용해 작업할 경우 → 해야 할 작업이 다른 작업에 의해 방해받거나 작업 속도가 느려질 수 있음
2-2. 멀티 스레드 프로그래밍을 통한 단일 스레드의 한계 극복
멀티 스레드 프로그래밍 → 스래드를 여러개 사용해 작업을 처리하는 프로그래밍 기법
- 프로세스 → 멀티 스레드 프로그래밍을 통해 여러개의 스레드로 작업을 실행
- 각각의 스레드가 한 번에 하나의 작업을 처리할 수 있으므로 여러 작업을 동시에 처리하는 것이 가능해짐
멀티 스레드를 통한 단일 스레드의 반응성 문제 해결
1. 안드로이드 휴대폰에서 동작하는 어플
- 메인 스레드 대신 별도의 스레드가 처리할 수 있도록 만들어 반응성 문제를 해결
- 오래 걸리는 작업을 백그라운드 스레드에서 처리하도록 만들면 메인 스레드는 오래 걸리는 작업을 처리하지 않아도 되기 때문에 UI가 멈추거나 사용자 입력을 받지 못하는 현상을 방지할 수 있음
2. 서버 사이드 작업
- 오래 걸리는 작업이 요총됐을 때 작업을 스레드 간에 독립적인 작은 작업으로 나눈 후 각 작업이 서로 다른 스레드에서 수행되도록 만들면 응답 속도를 높일 수 있음
- DB 3개를 조회하는 경우 각 스레드가 하나씩 조회한 후 결과를 병합하면 단일 스레드에 비해 빠르게 처리할 수 있음 (병렬 처리)
3. 코루틴이 등장하기 이전의 멀티 스레드 프로그래밍 (스레드, 스레드풀)
말티 스레드 프로그래밍 → 계속 변화해옴 (이전 방식의 한계 극복을 위해)
코루틴 → 멀티 스레드 프로그래밍의 한계를 극복하기 위해 등장
따라서 멀티 스레드 프로그래밍의 변천사를 추적하는 것이 좋음
3-1. Thread 클래스를 사용하는 방법과 한계
1. Thread 클래스를 사용해 스레드 다루기
class ExampleThread : Thread() {
	override fun run() {
		println("${Thread.currentThread().name} 새로운 스레드 시작")
		Thread.sleep(2000L)
		println("${Thread.currentThread().name} 새로운 스레드 종료")
	}
}
// [현재 작업중인 스레드 이름] 새로운 스레드 시작
// (2초 대기)
// [현재 작업중인 스레드 이름] 새로운 스레드 종료

fun main() {
	println("${Thread.currentThread().name} 메인 스레드 시작")
	ExampleThread().start()
	Thread.sleep(1000L)
	println("${Thread.currentThread().name} 메인 스레드 종료")
}

// 결과:
// [main] 메인 스레드 시작
// [Thread-0] 새로운 스레드 시작
// [main] 메인 스레드 종료
// [Thread-1] 새로운 스레드 종료 - 메인 스레드와 새로운 스레드의 로그가 섞여 있음
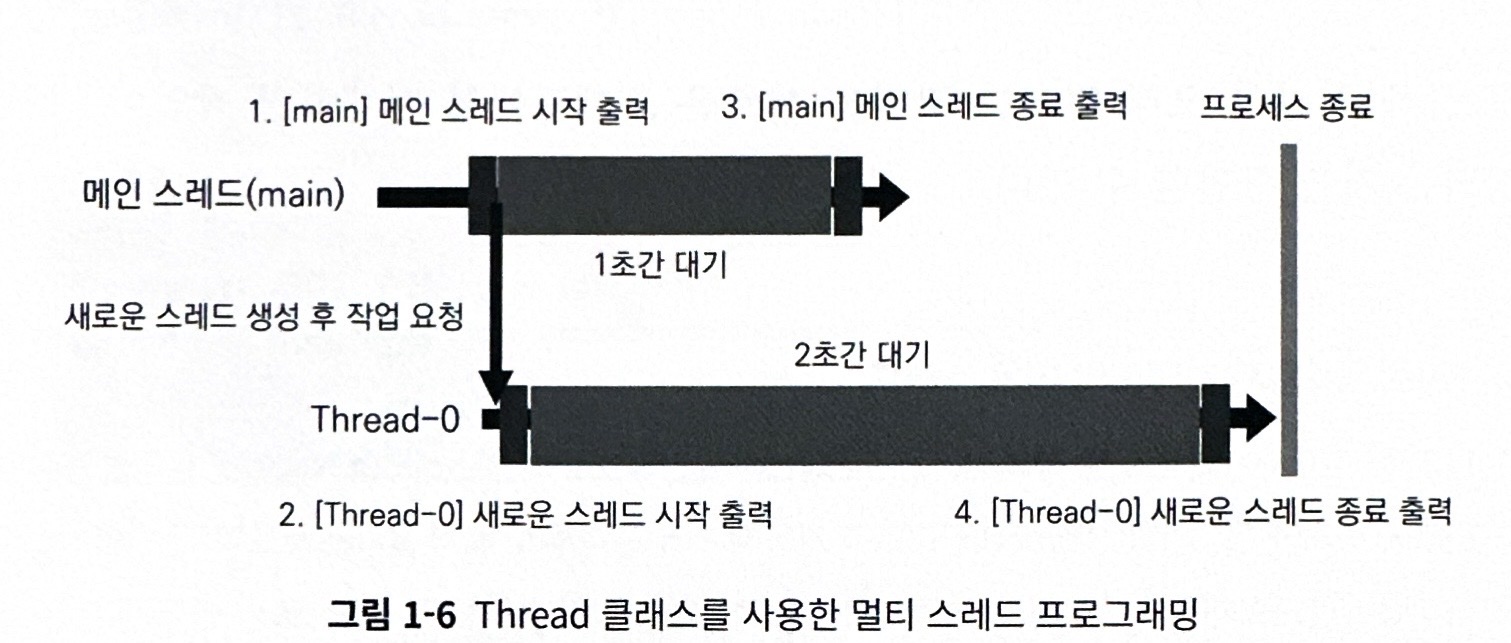
1. “[main] 메인 스레드 시작” 문구 출력
2. 새로운 스레드가 생성되고 “[Thread-0] 새로운 스레드 시작” 문구 출력
3. 1초 뒤 “[main] 메인 스레드 종료” 문구 출력
4. 다시 1초 뒤 “[Thread-0] 새로운 스레드 종료” 문구 출력
사용자 스레드와 데몬 스레드
아까 위에서 “JVM 프로세스는 일반적으로 메인 스레드와 함께 종료된다”라고 했었다. 하지만 Thread 클래스의 예시를 보면 메인 스레드가 먼저 종료되었음에도 Thread-0이 여전히 살아남아 작업을 이어갔다.
이는 메인 스레드와 Thread-0 둘 다 사용자 스레드이기 때문이다.JVM은 스레드를 사용자 스레드와 데몬 스레드로 구분한다.
사용자 스레드 → 우선도가 높은 스레드
데몬 스레드 → 우선도가 낮은 스레드
JVM 프로세스가 종료되는 시점은 우선도가 높은 사용자 스레드가 모두 종료될 때이다.
단일 스레드 프로그래밍의 경우 메인 스레드만 사용자 스레드이기 때문에 메인 스레드가 종료될 때 JVM 프로세스도 종료되었다.
하지만 멀티 스레드를 사용하는 프로세스에서는 스레드 중 사용자 스레드가 모두 종료되는 시점에 프로세스가 종료된다.
Thread 클래스를 상속한 클래스로 생성한 스레드는 기본적으로 사용자 스레드로 생성된다. 따라서 위의 예시에서 생성된 Thread-0은 사용자 스레드로 생성된다.
사용자 스레드로 생성되었기 때문에 메인 스레드가 종료되었음에도 살아남아서 작업을 이어갔던 것이다.
만약 Thread 클래스를 통해 데몬 스레드를 생성하고 싶다면 isDeamon = true 속성을 적용해주면 된다.
ExampleThread().apply {
	isDeamon = true,
}.start()
위에서 작성했던 예시를 데몬 스레드로 생성하면 다음의 코드와 같이 작성할 수 있다.
fun main() {
	println("${Thread.currentThread().name} 메인 스레드 시작")

	ExampleThread().apply{
		isDeamon = true,
	}.start()

	Thread.sleep(1000L)
	println("${Thread.currentThread().name} 메인 스레드 종료")
}
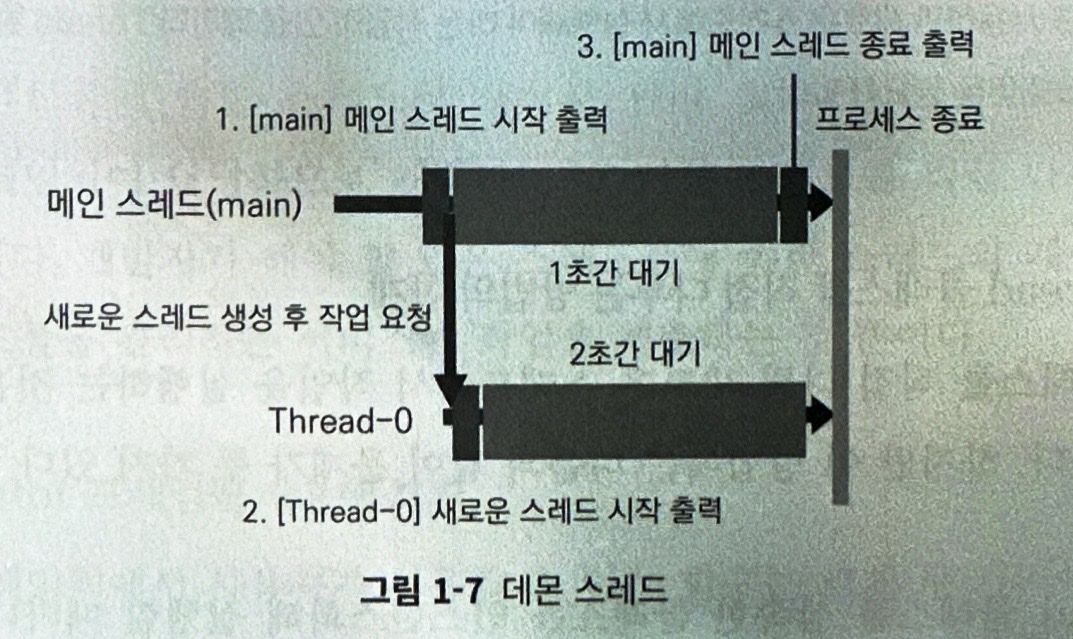
Thread-0이 데몬 스레드로 생성되었기 때문에 메인 스레드가 종료되면 프로세스도 종료되어 Thread-0이 실행중에 강제로 종료된다.
데몬 스레드는 중요한 스레드가 아니기 때문에 강제 종료되더라도 프로세스가 정상 종료된다.
2. Thread 클래스를 직접 다루는 방법의 한계
1. Thread 클래스를 상속한 클래스를 인스턴스화 해 실행할 때마다 매번 새로운 스레드가 생성됨
- 스레드 → 생성비용이 비쌈
- 매번 새로운 스레드를 생성하는 것은 성능적으로 좋지 않음
2. 스레드 생성과 관리에 대한 책임이 개발자에게 있음
- 프로그램의 복잡성이 증가함
- 실수로 인해 오류나 메모리 누수를 발생시킬 가능성이 증가함
이런 문제들을 해결하려면 한 번 생성한 스레드를 간편하게 재사용할 수 있어야 하고, 스레드의 관리를 구축한 시스템에서 책임질 수 있도록 헤야함
이런 역할을 위해 Executor 프레임워크가 만들어졌음
3-2. Executor 프레임워크를 통해 스레드풀 사용하기
Executor 프레임워크 → 개발자의 스레드 관리 부담 문제 해결과 생성된 스레드 재사용성을 높이기 위해 등장
- 스레드 생성/관리를 위해 스레드풀 개념 도입
- 스레드풀 → 스레드의 집합
스레드풀을 관리하고 사용자로부터 요청받은 작업을 각 스레드에 할당하는 시스템을 더한 것이 Executor 프레임워크임
- 작업 처리를 위해 스레드풀을 미리 생성해 놓고 작업을 요청 받으면 쉬고 있는 스레드에 작업을 분배
- 각 스레드는 작업을 끝내더라도 스레드를 종료하지 않고 다음 작업이 들어오면 재사용됨
스레드풀에 속한 스레드의 생성과 관리 및 분배에 대한 책임을 Executor 프레임워크가 담당
- 개발자는 스레드 관리를 직접 하지 않고 아래의 작업만 수행하면 됨
- 스레드풀에 속할 스레드의 개수 설정
- 스레드풀을 관리하는 시스템에 작업을 제출
3-2-1. Executor 프레임워크 사용해 보기
Executor 프레임워크에서 사용자가 사용할 수 있는 함수는 크게 2가지임
1. 스레드풀을 생성하고 생성된 스레드풀을 관리하는 객체를 반환받는 함수
2. 스레드풀을 관리하는 객체에 작업을 제출하는 함수
fun main() {
	val startTime = System.currentTimeMillis()
	val executorService: ExecutorService = Executors.newFixedThreadPool(2)

	// 작업1 제출
	executorService.submit {
		println("[${Thread.currentThread().name()}][${getElapsedTime(startTime)}] 작업 1 시작")
		Thread.sleep(1000L)
		println("[${Thread.currentThread().name()}][${getElapsedTime(startTime)}] 작업 1 완료")
	}

	// 작업2 제출
	executorService.submit {
		println("[${Thread.currentThread().name()}][${getElapsedTime(startTime)}] 작업 2 시작")
		Thread.sleep(1000L)
		println("[${Thread.currentThread().name()}][${getElapsedTime(startTime)}] 작업 2 완료")
	}

	executorService.shutdown() // 제출된 작업이 모두 끝난 뒤에는 ExecutorService가 종료될 수 있도록 shutdown 함수를 호출
}

fun getElapsedTime(startTime: Long): String =
	"지난 시간: ${System.currentTimeMiilis() - startTime}ms"

/*
[pool-1-thread-1][지난 시간: 4ms] 작업1 시작
[pool-2-thread-1][지난 시간: 4ms] 작업2 시작
[pool-1-thread-1][지난 시간: 1009ms] 작업1 완료
[pool-2-thread-1][지난 시간: 1009ms] 작업2 완료
*/

// 서로 다른 스레드에서 실행되기 때문에 출력 순서, 사용 스레드는 다를 수 있음- 작업1과 작업2는 각각 서로 다른 스레드에서 실행됐음을 알 수 있음
- 종료 시간을 통해 두 작업이 병렬로 실행됐음을 알 수 있음
fun main() {
	val startTime = System.currentTimeMillis()
	val executorService: ExecutorService = Executors.newFixedThreadPool(2)

	// 작업1 제출
	executorService.submit {
		println("[${Thread.currentThread().name()}][${getElapsedTime(startTime)}] 작업1 시작")
		Thread.sleep(1000L)
		println("[${Thread.currentThread().name()}][${getElapsedTime(startTime)}] 작업1 완료")
	}

	// 작업2 제출
	executorService.submit {
		println("[${Thread.currentThread().name()}][${getElapsedTime(startTime)}] 작업2 시작")
		Thread.sleep(1000L)
		println("[${Thread.currentThread().name()}][${getElapsedTime(startTime)}] 작업2 완료")
	}

	// 작업3 제출
	executorService.submit {
		println("[${Thread.currentThread().name()}][${getElapsedTime(startTime)}] 작업3 시작")
		Thread.sleep(1000L)
		println("[${Thread.currentThread().name()}][${getElapsedTime(startTime)}] 작업3 완료")
	}

	executorService.shutdown() // 제출된 작업이 모두 끝난 뒤에는 ExecutorService가 종료될 수 있도록 shutdown 함수를 호출
}

fun getElapsedTime(startTime: Long): String =
	"지난 시간: ${System.currentTimeMiilis() - startTime}ms"

/*
[pool-1-thread-1][지난 시간: 4ms] 작업1 시작
[pool-2-thread-1][지난 시간: 4ms] 작업2 시작
[pool-1-thread-1][지난 시간: 1009ms] 작업1 완료
[pool-2-thread-1][지난 시간: 1011ms] 작업2 완료
[pool-1-thread-1][지난 시간: 1012ms] 작업3 완료
[pool-1-thread-1][지난 시간: 2016ms] 작업3 완료
*/- 작업3이 추가될 경우 작업1과 작업2는 동시에 실행되지만 작업 3은 1이 완료된 후에 실행되는 것을 알 수 있음
- 작업3이 실행 요청됐을 때 스레드풀에 있느 ㄴ스레드 2개가 이미 작업1과 작업2를 처리하는 중이었기 때문임
3-2-2. ExecutorService 내부 구조와 동작
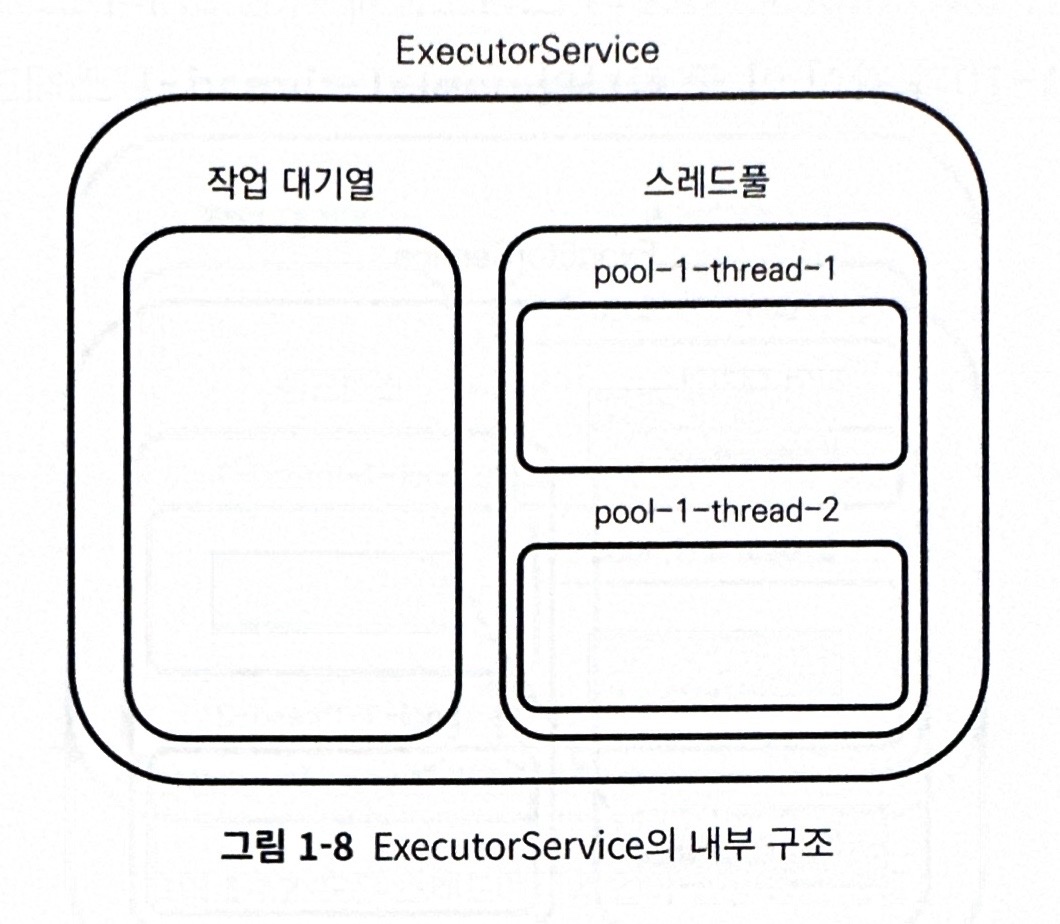
- 작업이 제출되면 작업 대기열에 적재됨
- 작업 대기열에 들어간 작업은 스레드로 할당되기를 기다림
- 스레드풀에 쉬고있는 스레드가 있다면 작업을 할당함
- 모든 스레드에 작업이 할당되어 있을 때 새로운 작업이 작업 대기열에 들어오면 스레드의 작업이 끝날 때까지 작업 대기열에서 대기함
위의 일련의 동작을 개발자는 전혀 신경쓰지 않아도 됨
스레드를 분배하는 일은 ExecutorService 객체가 알아서 함
3-2-3. Executor 프레임워크의 의의와 한계
Executor 프레임워크는 개발자의 스레드 관리 부담을 해결하고 스레드 재사용을 편하게 할 수 있도록 만들었다는 점에서 혁신적임
하지만 스레드 블로킹이라는 문제가 존재함
스레드 블로킹
스레드가 아무것도 하지 못하고 사용될 수 없는 상태에 있는 것을 의미함
- 스레드는 비싼 자원이기 때문에 사용될 수 없는 상태에 놓이는 것이 반복되면 애플리케이션 성능 하락의 원인이 될 수 있음
스레드 블로킹을 발생시키는 원인
- 여러 스레드가 동기화 블록에 동시에 접근하는 경우 (Race-condition)
- Mutex 또는 Semaphore로 인해 공유되는 자워에 접근할 수 있는 스레드가 제한되는 경우
Executor 프레임워크에서 스레드 블로킹이 종종 발생함
- 작업의 결과를 전달받을 때는 Future객체를 통해 언제 올지 모르는 값을 기다려야 함
- Future 객체의 get 함수를 호출한 스레드는 결과값을 반환받을 때까지 블로킹됨
3. 이후의 멀티 스레드 프로그래밍과 한계
Executor 프레임워크 이후에도 멀티 스레드 프로그래밍의 문제를 보완하기 위한 다양한 방법이 만들어졌음
- 기존 Future 객체의 스레드 블로킹을 줄이고 작업 체이닝 기능을 제공하는 CompletableFuture
- 결괏값을 데이터 스트림으로 처리해 스레드 블로킹을 방지하고 스레드풀을 손쉽게 전환할 수 있도록 한 RxJava
이 외에도 다양한 멀티 스레드 프로그래밍 방법이 등장했었음
다루지 않는 이유는 지금까지 다룬 내용들이 코루틴과 관련해서 알아야 할 중요하고 근본적인 한 가지 문제점을 갖는 녀석들이기 때문
아래에서는 이 “근본적인 문제점”을 다룸
4. 기존 멀티 스레드 프로그래밍의 한계와 코루틴
4-1. 기존 멀티 스레드 프로그래밍의 한계
멀티 스레드 프로그래밍은 단점을 보완하며 발전해 왔음
하지만 기존 멀티 스레드 프로그래밍은 스레드 기반으로 작업한다는 한계가 있음
“멀티 스레드 프로그래밍이 단일 스레드 프로그래밍의 문제를 해결하기 위해 생겼다면서 스레드 기반 작업이 왜 한계인가?”
스레드는 생성과 전환 비용이 비쌈
- 스레드가 아무 작업도 하지 않고 대기하고 있다면 컴퓨터의 자원이 낭비됨
- 한 스레드가 다른 스레드의 작업의 결과를 받기 위해 대기하고 있다면 스레드 블로킹이 발생한 것
- 스레드 블로킹은 스레드라는 비싼 자원을 사용할 수 없게 만든 다는 점에서 성능에 매우 치명적인 영향을 줌
스레드 블로킹은 스레드 기반 작업을 하는 멀티 스레드 프로그래밍에서 피할 수 없는 문제임
- 간단한 작업에서는 콜백, 체이닝 등을 통해 이를 회피할 수는 있지만,
- 작업이 많아지고 작업 간의 종속성이 복잡해질수록 스레드 블로킹을 피하기 어렵고, 스레드의 성능을 제대로 발휘할 수 없을 수도 있음
- 실제 애플리케이션에선 작업간의 종속성이 복잡하고 네트워크 작업도 수없이 많기 때문에 스레드 블록킹의 발생은 필연적이라 할 수 있음
체이닝 함수
한 함수의 수행 결과를 다른 함수로 연결해 호출하는데 사용
- 함수가 실행 완료됐을 때 실행할 콜백 함수를 등록하는 느낌
fun main() {
	val startTime = System.currentTimeMillis()
	val excutor = Excutor.newFixedThreadPool(2)

	val completableFuture = CompletableFuture.supplyAsync({
		Thread.sleep(1000L)
		return@supplyAsync "결과"
	}, executor)

	completableFuture.thenAccept { result ->
		println("[${getElapsedTime(startTime)}] $result 처리")
	}

	println("[${getElapsedTime(startTime)}] $result 처리")

	executor.shutdown()
}

/*
[지난 시간: 11ms] 다른 작업 실행
[지난 시간: 1008ms]
*/
2. 코루틴은 스레드 블로킹 문제를 어떻게 극복하는가?
작업 단위 코루틴을 통해 스레드 블로킹 문제를 해결
- 작업 단위 코루틴 → 스레드에서 작업 실행 도중 일시 중단할 수 있는 작업 단위
- 코루틴은 작업이 일시 중단되면 스레드 사용 권한을 양보
- 양보된 스레드는 다른 작업을 실행하는 데 사용할 수 있음
- 일시 중단된 코루틴 → 작업 재개 시점에 다시 스레드에 할당돼 실행
코루틴은 경량 스레드라고 불린다.
- 코루틴을 코루틴 스케쥴러에 넘기면 사용할 수 있는 스레드나 스레드풀에 해당 코루틴을 분배해 작업을 수행
- 코루틴은 실행 도중 중단될 수 있기 때문에 해당 코루틴이 사용중이던 스레드를 다른 코루틴에 양보하는 것이 가능하기 때문에 스레드 블로킹이 발생하지 않음
코루틴과 멀티 스레드 프로그래밍 비교
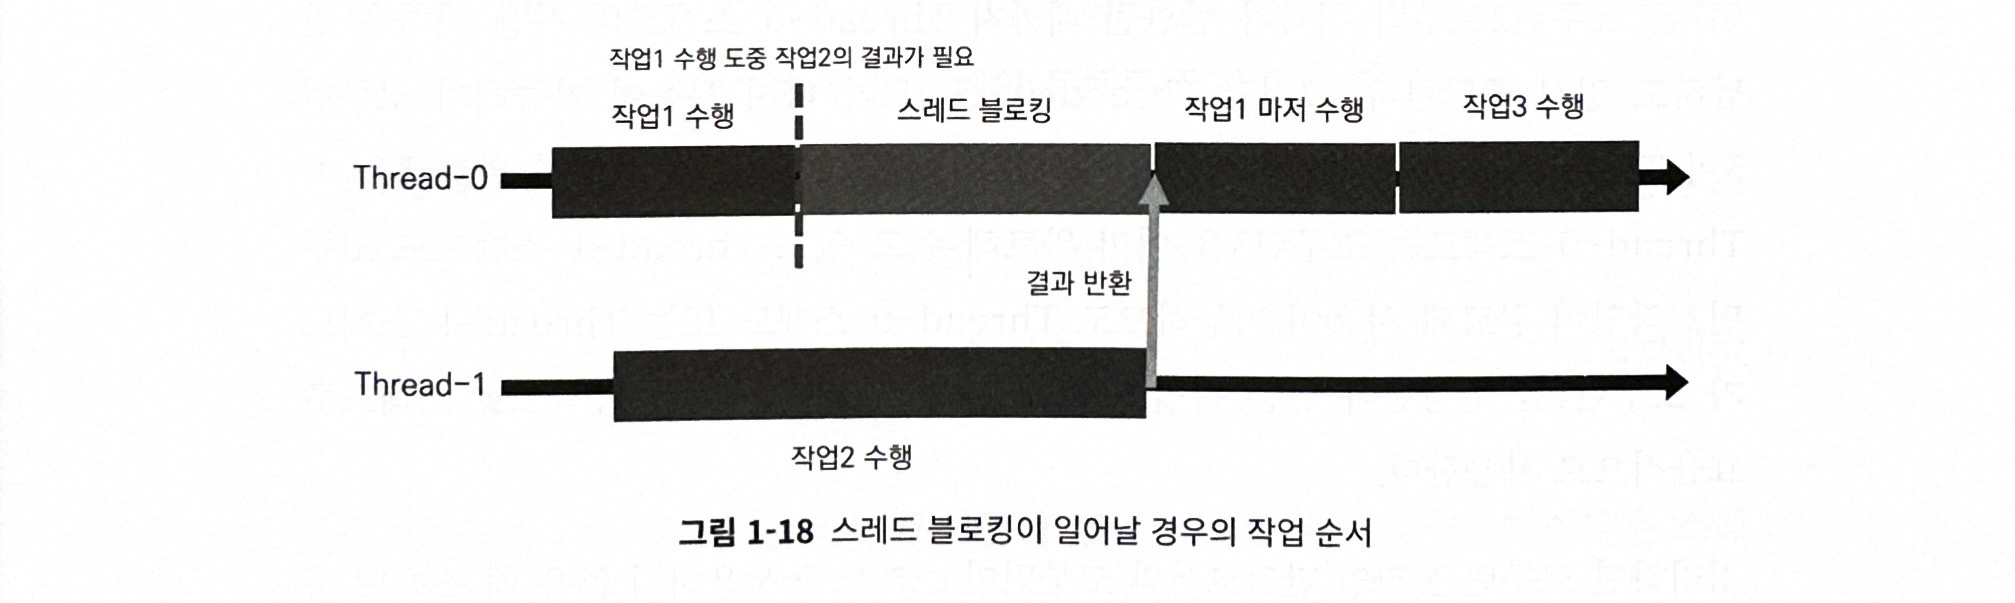
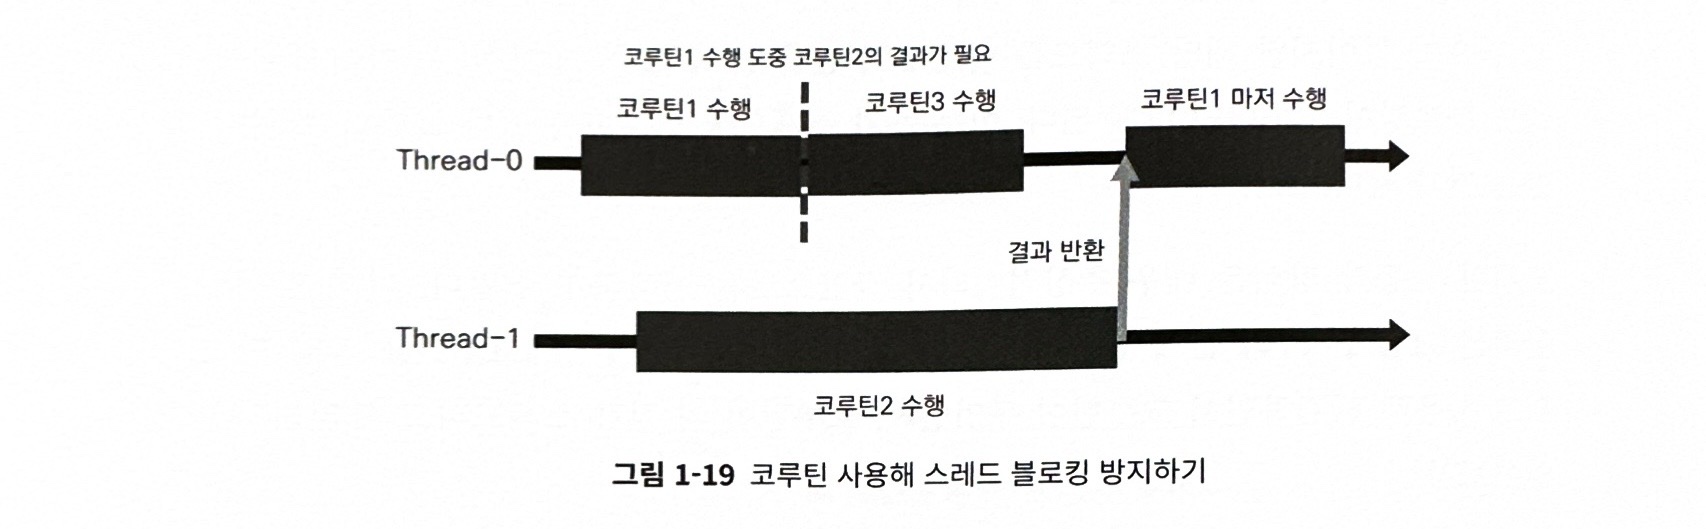
코루틴이 경량 스레드라고 불리는 이유 정리
- 코루틴은 스레드를 사용하고 있지 않을 때 스레드 사용 권한을 양보함
- 스레드 사용 최적화
- 스레드 블로킹 방지
- 코루틴은 스레드에 비해 생성과 전환 비용이 적게 들고, 스레드에 붙였다 땠다 할 수 있어 작업을 생성하고 전환하는 데 필요한 리소스와 시간이 매우 줄어듬
5. 1장 요약
- JVM 상에서 실행되는 코틀린 애플리케이션 → 메인 스레드에서 실행
- 단일 스레드는 한번에 하나의 작업만 수행할 수 있음 → 복잡한 작업이나 시간이 오래 걸리는 작업을 수행하면 응답성이 떨어질 수 있음
- 멀티 스레드를 통해 2번의 문제를 해결할 수 있음
- Thread 클래스를 상속해 스레드를 생성하고 관리할 수 있으나 생성된 스레드의 재사용이 어려워 리소스 낭비를 일으킴
- Executor 프레임워크는 스레드풀을 통해 스레드의 생성과 관리를 최적화하고 스레드의 재사용성을 높임
- 하지만 기존 멀티 스레드 프로그래밍 방식들은 스레드 블로킹이라는 문제를 근본적으로 해결하지 못했음
- 스레드 블로킹 → 스레드가 작업을 기다리면서 리소스를 낭비하지만 아무 일도 하지 않는 상태
- 코루틴은 스레드 블로킹 문재를 해결하기 위해 등장함
- 코루틴은 스레드 사용 권한을 양보하고 작업을 일시 중단해 다른 작업이 스레드를 사용할 수 있도록 함
- 일시 중단 후 재개된 코루틴은 재개 시점에 사용할 수 있는 스레드에 할당됨
- 코루틴은 스레드에 비해 생성과 전환 비용이 적게 들고 스레드에 자유룝게 땠다 붙였다 할 수 있어 경량 스레드라고 불림
- 코루틴을 통해 스레드 블로킹을 방지할 수 있어 애플리케이션의 응답성을 높일 수 있음