묵시적 가용 리스트 할당기 보다 명시적 가용 리스트 할당기의 구현이 빨리 끝났다.
도커환경이 계속해서 64비트환경으로 컴파일 되고 있었는데, 나는 그것도 모르고 6시간 동안 허공에다 삽질을 했다... 대체 어디서 부터 잘못된건지...
항상 코딩을 하면 대부분의 오류는 개발 환경에서 오는 것 같다.
"제 컴퓨터에선 되는데요?" 라는 겁나 무서운 말도 있듯이... 코드를 돌아봤는데도 전혀 모르겠으면, 개발 환경부터 의심해봐야겠다...
아무튼 명시적 가용 리스트 할당기 레츠고....
MACRO
#define PREV(bp) (*(void**)(bp))
#define NEXT(bp) (*(void**)(bp + WSIZE))
일단 매크로가 두개나 생겼다.
명시적 가용 리스트에서 payload안에 포인터를 넣어서 가용리스트들을 관리하려고 해당 매크로를 넣었다.
PREV Mecro
bp는 블록 안의payload를 가리키는 포인터이다.- 즉, 해당
mecro는 이전 블록의 포인터를 읽어오는 것이다. bp위치에 있는8바이트(32비트 시스템 기준)를void *타입으로 읽어 온다.- 즉,
bp위치에 저장된 이전 가용 블록의 주소를 가져온다.
NEXT Mecro
bp + WSIZE는bp에서 한 워드 (WSIZE=4바이트) 만큼 더한 위치이다.- 즉, 현재 블록의 다음 블록 포인터를 읽어오는 것이다.
bp+WSZIE위치에 있는 값을void *로 해석해서 가져온다.- 즉,
bp+WSIZE위치에 저장된 다음 블록의 가용주소를 가져온다.
두번 캐스팅 하는건 타입을 맞춘후에 주소의 값을 읽기 위해서이다.
mm_init
static void *free_listp = NULL;

int mm_init(void)
{
	heap_listp = mem_sbrk(3*DSIZE);
    if (heap_listp == (void*)-1){
        return -1;
    }
    PUT(heap_listp, 0); //Unused padding
    PUT(heap_listp + WSIZE, PACK(2*DSIZE,1));
    PUT(heap_listp + 2*WSIZE,NULL);
    PUT(heap_listp + 3*WSIZE,NULL);
    PUT(heap_listp + 4*WSIZE,PACK(2*DSIZE,1));
    PUT(heap_listp + 5*WSIZE,PACK(0,1));

    free_listp = heap_listp + DSIZE;
    // Extend the empty heap with a free block of CHUNKSIZE bytes
    if (extend_heap(CHUNKSIZE/WSIZE) == NULL)
        return -1;
    return 0;
}
mem_sbrk(24)로 힙을 24바이트 늘린다.- 24바이트 안에
padding+프롤로그 블록(16B)+에필로그 헤더(8B)를 만든다.free_listp는 가용 리스트의 헤더이다.- 그리고 바로
extend_heap을 호출해서 useable 한 freeblock을 확장한다.
묵시적 가용 리스트를 구현 할 때와 다르진 않지만, 가용 리스트의 헤더 부분을 생성해주는 부분이 추가되고, 가용 리스트의 마지막 이란 것을 알려주기 위해 프롤로그 payload를 생성하였다.
가용리스트 생성, 제거
void putFreeBlock(void *bp){
    NEXT(bp) = free_listp;
    PREV(bp) = NULL;
    PREV(free_listp) = bp;
    free_listp = bp;
}

void removeBlock(void *bp){

    if(bp == free_listp){
        PREV(NEXT(bp)) = NULL;
        free_listp = NEXT(bp);
    }else{
        NEXT(PREV(bp)) = NEXT(bp);
        PREV(NEXT(bp)) = PREV(bp);
    }
}
이전 포스트에서 함수화를 하면 간단할 꺼 같다고 생각한 부분을 함수화 하였다.
putFreeBlock
Linked list와 비슷하게 기존 헤더를 교체하고 거기에 다시 이어주는 역할이다.
알고리즘 주차에서 자료구조를 많이 다루다보니까... 해당 함수를 구현하는데 많은 도움이 되었다... 하하하!
removeBlock
해당 방식은 이전 포스트 CASE 부분을 설명할 때 분기를 끊어주는 느낌의 부분이 있었다.
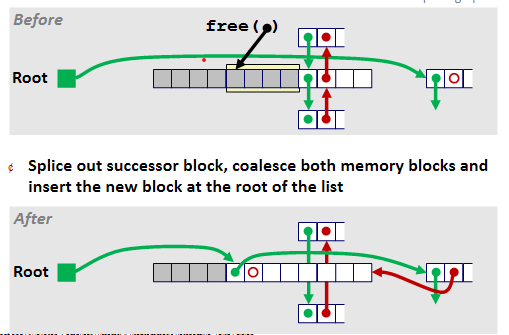 바로 이 부분인데, 해당 방식에서
이전 가용 리스트들과의 분기를 끊어주고, 이전 이후 리스트는 서로 이어주는 방식의 구현이다.
여기서 중요한 부분은 두 함수 모두 bp 가 head일 때 와 bp 앞, 뒤가 다 있을 때만 생각해 주면 된다. 이전에 프롤로그 payload를 만들어 주었기 때문에 모든 블럭이 끝에 있는 경우는 전자로 통일이 된다. 그래서 두 조건만 생각하고, 코딩이 가능했다... 멜론 갓...
coalesce
나는 이 함수를 매일 코온슬로라고 읽는다..
static void *coalesce(void *bp)
{
    size_t prev_alloc = GET_ALLOC(FTRP(PREV_BLKP(bp)));
    size_t next_alloc = GET_ALLOC(HDRP(NEXT_BLKP(bp)));
    size_t size = GET_SIZE(HDRP(bp)); //현재 블록 사이즈

    // case 1
    // case 2
    if(prev_alloc && !next_alloc){
        removeBlock(NEXT_BLKP(bp));
        size += GET_SIZE(HDRP(NEXT_BLKP(bp)));
        PUT(HDRP(bp), PACK(size,0));
        PUT(FTRP(bp), PACK(size,0));/
    }
    // case 3
    else if(!prev_alloc && next_alloc){
        removeBlock(PREV_BLKP(bp));
        size += GET_SIZE(HDRP(PREV_BLKP(bp)));
        bp = PREV_BLKP(bp);
        PUT(HDRP(bp), PACK(size,0));
        PUT(FTRP(bp), PACK(size,0));
    }
    // case 4
    else if(!prev_alloc && !next_alloc){
        removeBlock(PREV_BLKP(bp));
        removeBlock(NEXT_BLKP(bp));
        size += GET_SIZE(HDRP(PREV_BLKP(bp))) +
                GET_SIZE(FTRP(NEXT_BLKP(bp)));
        PUT(HDRP(PREV_BLKP(bp)), PACK(size,0));
        PUT(FTRP(NEXT_BLKP(bp)), PACK(size,0));
        bp = PREV_BLKP(bp);
    }
    putFreeBlock(bp);
    return bp;
}
일단 case 1에서 해줄일이 없어서 함수가 빠져버렸다. 이전 묵시적을 구현 했을때도
case 1을 줄일 수 있었을 꺼 같다.
case 1
putFreeBlock(bp);
    return bp;
case 1은 합쳐질 블록이 없으므로 그냥 해당 bp를 가용 리스트에 추가한 후 리턴한다.
합치는 과정을 모든 case들이 마지막에 해도 되므로, 이게 마지막에 빠지다 보니 case 1의 경우 할 일이 없어졌다. 일자리가 없어짐...
case 2
if(prev_alloc && !next_alloc){
        removeBlock(NEXT_BLKP(bp));
        size += GET_SIZE(HDRP(NEXT_BLKP(bp)));
        PUT(HDRP(bp), PACK(size,0));
        PUT(FTRP(bp), PACK(size,0));/
    }

  putFreeBlock(bp);
  return bp;
case 2는 다음 블록과 연결을 삭제한 후에 합쳐주고, 기존 블록에 payload에 저장할 것이기 때문에 bp의 포인터를 그대로 냅둔다. 그리고 이후 병합한 후 가용 리스트에 추가 !
case 3
    else if(!prev_alloc && next_alloc){
        removeBlock(PREV_BLKP(bp));
        size += GET_SIZE(HDRP(PREV_BLKP(bp)));
        bp = PREV_BLKP(bp);
        PUT(HDRP(bp), PACK(size,0));
        PUT(FTRP(bp), PACK(size,0));
    }
  putFreeBlock(bp);
  return bp;
case 3는 case 2와 비슷하지만, payload를 추가할 포인터는 이전 블록 부분 이므로 포인터를 바꿔준 후 가용리스트에 추가한다 !
case 4
    else if(!prev_alloc && !next_alloc){
        removeBlock(PREV_BLKP(bp));
        removeBlock(NEXT_BLKP(bp));
        size += GET_SIZE(HDRP(PREV_BLKP(bp))) +
                GET_SIZE(FTRP(NEXT_BLKP(bp)));
        PUT(HDRP(PREV_BLKP(bp)), PACK(size,0));
        PUT(FTRP(NEXT_BLKP(bp)), PACK(size,0));
        bp = PREV_BLKP(bp);
    }
    putFreeBlock(bp);
    return bp;
case 4또한 비슷하다 앞,뒤 블록의 기존 가용리스트 연결을 해제한 후에 payload를 추가할 포인터는 이전 블록이므로, 포인터를 바꿔준 후 가용리스트 추가 함수를 호출한다.
place
static void place(void *bp, size_t asize){
    size_t csize = GET_SIZE(HDRP(bp));

    removeBlock(bp);
    if ((csize - asize) >= (2*DSIZE)){
        PUT(HDRP(bp), PACK(asize,1));
        PUT(FTRP(bp), PACK(asize,1));
        bp = NEXT_BLKP(bp);
        PUT(HDRP(bp), PACK(csize-asize,0));
        PUT(FTRP(bp), PACK(csize-asize,0));
        putFreeBlock(bp);
    }
    else{
        PUT(HDRP(bp), PACK(csize,1));
        PUT(FTRP(bp), PACK(csize,1));
    }
}
이 후 바뀐부분은 place함수이다.
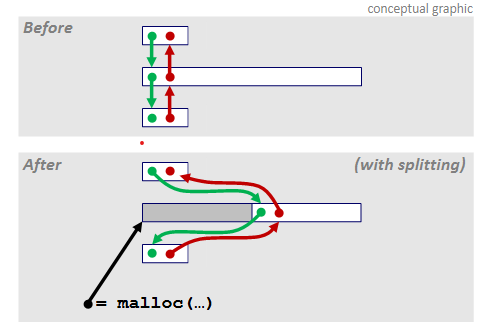 멜론 교수님이 말했던, 이 부분... 딱
place함수에다 쓰라고 자료를 주신 것 같다.
해당 자료를 토대로 이전 place함수에서 몇개를 수정하던 중...
이전 사용하던 remove함수가 여기선 적용이 안되는 것이다... 함수를 하나 더 만들어서 분기를 잇는 그런 걸 해야하는데....
그냥 끊고 새로 추가하면 안되나... 라는 꼼수가 여기서 맞았다.
그래서
- 이전 함수와 분기를 모두 끊는다.
- 나눠진 블록을 새로운 가용리스트로 추가 시킨다 !
이런 식으로 구현을 했다.
Find fit
static void *find_fit(size_t asize){
    void *bp;

    for(bp = free_listp; GET_ALLOC(HDRP(bp)) != 1; bp = NEXT(bp)){
        if(GET_SIZE(HDRP(bp)) >= asize){
            return bp;
        }
    }
    return NULL;
}
이번엔 find_fit으로 구현하였다. 명시적 가용 리스트 특성상 find_fit이 제일 빠르지 않을까 하는 생각이였다.
이전에 끝으로 정의한 프롤로그 payload는 할당 상태로 넣어놨기 때문에
할당 상태인 블록이 나오기 전까지만 반복문을 통해 탐색을 한다.
그래서 점수는 ?
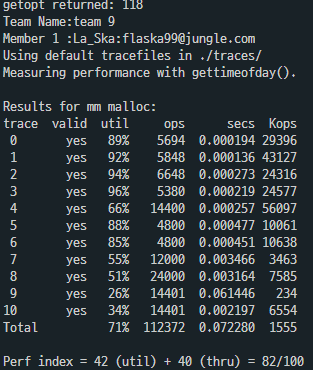
난 90점 정도 나올 줄 알았는데....
묵시적 가용 리스트의 next_fit을 이길 강적은 없었다...
그럼 명시적 가용 리스트에서의 next_fit은 어떨까 ?
NEXT FIT
static void *find_fit(size_t asize){ // next_fit 추가
    void *bp = last_bp;
    if (bp == NULL) bp = free_listp;

    // 먼저 last_bp 이후부터 free list 끝까지 검색
    for (; GET_ALLOC(HDRP(bp)) != 1; bp = NEXT(bp)) {
        if (GET_SIZE(HDRP(bp)) >= asize) {
            last_bp = bp;
            return bp;
        }
    }

    for (bp = free_listp; bp != last_bp; bp = NEXT(bp)) {
        if (GET_SIZE(HDRP(bp)) >= asize) {
            last_bp = bp; // 찾았으면 last_bp 업데이트
            return bp;
        }
    }

    return NULL; // 못 찾으면 NULL
}last_bp를 추가한 후 remove함수가 쓰일 때 무조건 last_bp가 해당 함수의 다음을 참조하도록 만들었다... 별로 바뀌진 않을꺼 같은데 일단...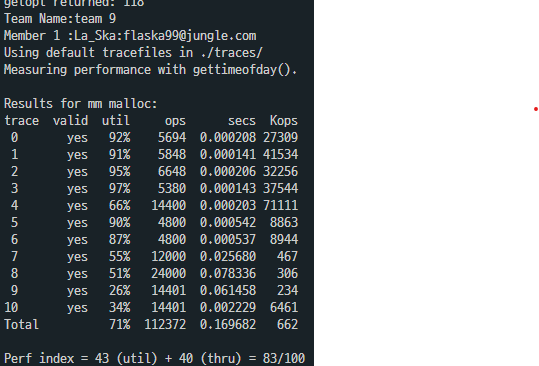
그래도 1점 올랐으니까 ...!!
명시적 가용 리스트 특성상 next fit이 좋을 수가 없는 것 같다...
뭔가 first_fit은 계속 처음부터 조각 내고 다니는데,
얘는 진짜 끝까지 다 조각내고 다니는 느낌 ? 아마, 이런 알고리즘으로 오랜 동작을 하는 프로그램을 만든다면, 외부 단편화가 엄청 커질 꺼 같긴하다...
best fit
static void *find_fit(size_t asize) {
    void *bp;
    void *best_bp = NULL;
    size_t best_size = (size_t)-1;

    for (bp = free_listp; GET_ALLOC(HDRP(bp)) != 1; bp = NEXT(bp)) {
        size_t bsize = GET_SIZE(HDRP(bp));
        if (bsize >= asize) {
            if (bsize < best_size) {
                best_size = bsize;
                best_bp = bp;

            }
        }
    }

    return best_bp;
}
그래도 혹시나 하는 마음에... 보다는 공부해야하니까
best_fit도 적용을 시켜봤다.
생각해보니 묵시적 가용리스트에서 만들었던 알고리즘과 별차이가 없을 것 같다
거기서 조금만 수정해서 적용해봤다...
과연 결과는 ?
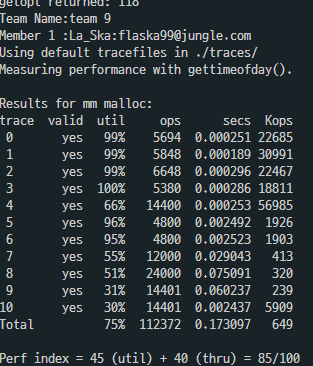
아니 베태식이...? 돌아왔구나 ?
처음으로 보는 점수에 기분이 너무 좋아져서 소리질렀다...ㅋㅋ
아니 왜 ?
아마도 명시적에서 best-fit이 제일 좋은 결과를 보여준 이유는
제일 잘 맞는 친구를 선택하니까, 블럭의 조각화를 최소화 했을 것이다.
즉, 큰 블록들이 쪼개지지 않고, 작은 빈 공간이 줄었을 것이다.
명시적 가용 리스트 특성상 이것도 선형 탐색이다 보니,
탐색 할 리스트의 수를 줄이는 것이 점수를 높게 받을 수 있는 전략이 였던 것 같다.
즉, 정리를 잘 해 놓으면, 찾는 것도 빠르다 ! 라고 생각했다..
역시, 코딩은 삶과 닮아 있는 것 같다. 지금 내 책상도 더러워서 뭐하나 찾는게 너무 어렵다...
쨋든 명시적 가용리스트도 끝났으니 다음엔 세르게이(?)리스트 레츠고...
macro