카네기 멜론 대학에 엄청난 교수님이 적으신 CS:APP를 통해 묵시적 가용 리스트를 사용한 명시적 할당기에 대해 공부를 해봤다. 한번 하나씩 꼭꼭 씹어보자...
명시적 할당기 요구사항과 목표
항상 무언가 구현할 때 마다 참고해야 할 사항인 요구사항이다.
내가 구현 할 명시적 할당기 에서도 요구사항이 있다.
해당 요구사항에 다소 엄격한 제한사항 내에서 동작해야 한다고 한다.
- 임의의 요청 순서 처리하기 : 각각의 가용 블록이 이전의 할당 요청에 의해 현재 할당된 블록에 대응되어야 하고, 임의의 순서로 할당과 반환 요청을 할 수 있다.
- 요청에 즉시 응답하기 : 할당기는 블록들을 어떤 종류의 데이터 객체라도 저장할 수 있도록 하는 방식으로 정렬해야 한다.
- 힙만 사용하기 : 확장성을 갖기 위해서 할당기가 사용하는 비확장성 자료 구조들은 힙 자체에 저장되어야한다. (다른 자료구조를 사용하면 안됨 !)
- 블록 정렬하기(정렬 요건) : 할당기는 블록들을 이들이 어떤 종류의 데이터 객체라도 저장할 수 있도록 하는 방식으로 정렬해야 한다.
- 할당된 블록 수정하지 않기 : 할당기는 가용 블록을 조작하거나 변경할 수 있지만, 블록이 할당되었다면, 이들을 수정하거나 이동하지 않는다.
겁나 엄.격.하.다.
이걸로 끝나는게 아니고, 내가 구현하는 malloc_lab은 엄격한 채점 기준을 통해 점수가 나오는데, 해당 점수를 매기는 기준은 코딩테스트와 비슷하게, 시간 복잡도와 공간 복잡도를 통해 채점을 한다.
시간에 대한 채점기준
할당기가 500개의 할당 요청과 500개의 반환 요청을 1초 동안에 완료한다면, 이 경우 처리량은 초단 1000연산이 된다. 일반적으로, 할당과 반환 요청들을 만족시키기 위한 평균 시간을 최소화해서 처리량을 최대화한다.
메모리에 대한 채점 기준
할당기가 힙을 얼마나 효율적으로 사용하는지 알 수 있는 가장 유용한 단위는 최고 이용도이다.
카네기 멜런 교수님이 만든 채점표를 이용하여, 높은 점수를 받아보자..!
그래서 점수 어떻게 높게 받음?
할당기를 구현 할 때 고려 해야 될 것은 단편화이다.
나쁜 힙 이용도의 주요 이유는 이 단편화라는 현상인데, 두 종류의 단편화가 있다.
바로 외부 단편화 와 내부 단편화이다.
내부 단편화
할당된 블록이 데이터 자체보다 더 클 때 일어난다.
해당 단편화를 정량화하기는 간단한데, 이것은 단순히 할당된 블록의 크기와 데이터 사이의 차이 합이다.
쉽게 말하면, 정렬을 맞추려고 데이터를 계속해서 끌어오게 되는데 이것이 계속 되다 보니, 실제로 안쓰는 데이터 공간이 많아 지는 현상이다. 즉, 패딩이 많아짐..
(데이터 낭비...)
외부 단편화
외부 단편화는 내부 단편화보다 측정하기가 힘들다.
단순하게 할당기 구현에만 의존하는 것이 아니라 미래의 요청에도 의존하기 떄문이다.
할당 되었던 블록들이 가용 상태로 돌아간다면, 블록들은 제 각각의 크기를 가진 채로 나누어져 있을 것이다. 만약 모든 가용 블럭이 작은 상태였을 때 큰 블럭에 대한 요청이 온다면, 가용블럭이 많은데도 요청을 하게 되는 상황이 생긴다.
이것이 외부 단편화이다.
이것을 해결하기 위해 많은 수의 작은 가용 블럭들을 합쳐서, 적은 수의 큰 가용 블럭으로 관리하는 방법들이 있다.
단편화의 설명들을 보면서 느꼈던 건 머지 게임(Merge Game) 장르가 생각났다...
머지 게임을 하게되면 계속해서 합쳐야한다. 하지만, 바로바로 합쳐서 정렬을 안해놓으면, 게임을 할 때 산만해지기 때문에 합쳐서 정렬을 해놓고... 이런 방식으로 게임을 진행한다.
할당기를 구현할 떄 구현 이슈
가용 블록 구성 : 어떻게 가용 블럭을 추적할 껀데 ?
배치 : 새롭게 할당된 블록을 배치하기 위해 가용 블록을 어떻게 선택 할 껀데 ?
분할 : 새롭게 할당된 블록을 가용 블록에 배치한 후 가용 블럭의 나머지 부분들로 뭐 할껀데 ?
연결 : 방금 반환된 블록으로 뭘 할껀데 ?
위 이슈를 해결 해야한다...
연결을 제외한 이슈들을 충족하기위해, 32비트 기준 8의 배수로 사이즈를 고정하고, header 와 footer를 사용한다.
이런 똑똑한 아저씨들이 만들어 놓은 아이디어를 통해 점수를 줄일 수 있지만, 나중에 명시적 가용 리스트를 사용한 가용 리스트 관리에서는 아이디어를 생각해 볼 예정이다...
헤더, 푸터 ?
헤더와 푸터를 보자마자, 예전에 잠깐 공부했던 리액트에서 ui구성이 떠올랐다... 여기서도 비슷한 의미인 것 같은데, 여기가 시초일 수 도...?
그래서 이게 뭐냐면
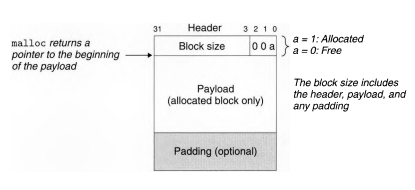
위 그림을 봐보자, 진짜 똑똑한 발상이다..
헤더라는 것을 만들고, 거기에 블록에 대한 정보를 담는다. 그리고 우리는 8의 배수로 정렬을 해주었기 때문에, 하위 3비트 중 첫번째 비트에 할당 정보를 넣을 수 있다.
+)여기서 padding은 외부 단편화를 극복하기 위한 할당기 전략의 일부분이다 !
그리고 푸터에는 헤더 값과 똑같은 값을 넣어준다.
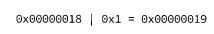
이런 식으로 말이다 !
이러면 뭔가 일자로 쭉 이어져있는 가용 리스트와 할당 리스트 중에 어떤 것이 가용 인지 알 수 있게 된다. 또, 이것을 머지 게임처럼 합쳐 줄 수도 있는 것이다 !
이거 보고, 헤더와 푸터를 이용하여 묵시적 가용 리스트를 구현에 가까워져서 행복해졌음...
이러한 전략을 경계 태그라고 부른다 !
경계 태그로 연결하기 ?
자... 이제 글의 초반부에서 계속 말해왔던 머지 게임을 할 차례이다.
그러면 가용 리스트를 합치려면 어떤 경우가 있을지 생각해봐야한다.
(이건 Knuth라는 똑똑한 아저씨가 만든 기법임)
- 이전과 다음 블록이 모두 할당되어 있다.
- 이전 블록은 할당 상태, 다음 블록은 가용 상태이다.
- 이전 블록은 가용 상태, 다음 블록은 할당 상태이다.
- 이전 블록과 다음 블록 모두 가용 상태이다.
이렇게 4가지 case가 있는데...
이거 어디서 많이 봤는데...
그가 떠오른다...
항상 똑똑한 아저씨들은 자신이 생각한 알고리즘에 대해 모든 변수들을 놓고, 정확히 일치하는 case들을 딱 나누는 것 같다. 똑똑해 지기위해 나도 저렇게 해야지...
본론으로 돌아가면, 해당 네 가지 경우로 모두를 연결하는 방법이다. 그림으로 알아보자
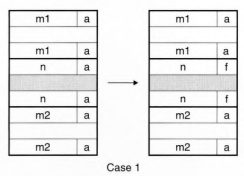
CASE 1
이전과 다음 블록이 모두 할당 되어 있어서 할당을 해제 해도 아무 일도 일어나지 않는다.
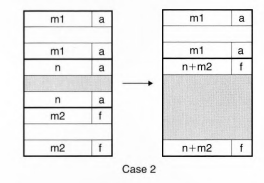
CASE 2
이건 뭔일이 생긴다. 자신의 다음 블록이 가용 상태일 경우 현재 리스트가 해제 될때 합쳐 버린다 ! 뭔가가 합쳐질때 항상 마음이 편해지는 거 같다.
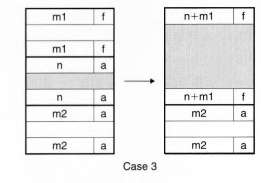
CASE 3
이전 리스트가 가용 상태일 경우이며 CASE 2와 비슷하다.
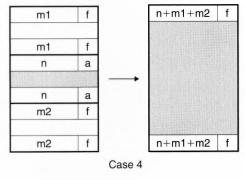
CASE 4
이전 리스트와 다음 리스트 모두 가용 상태일 경우이다. 다 합쳐 버린다... 굉장히 마음이 편해진다..
위 case들로 가용 리스트를 관리해주면 가장 골치 아프다는 외부 단편화를 극복해 줄 수 있다. 묵시적 가용리스트를 사용한 명시적 할당기를 구현할 이론에 대해 준비가 끝났다... 다음 주제로는 해당 이론들을 코드로 옮겨봐야겠다.