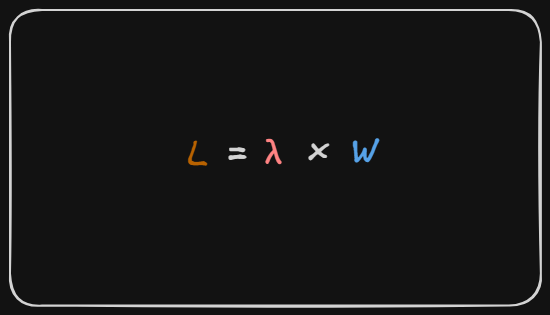
서론
얼마전 유투브를 보다 인상 깊은 콘텐츠를 봐서 글을 쓰게 되었다. 시스템 디자인 시 개발자가 고려해야 하는 점들에 대해 알려주는 일종의 시스템 디자인 강의였다.
너무 좋은 내용이라 혼자 알고 있기는 아까워 원작자의 허락과 함께 강의를 번역하고 정리해서 소개하기로 했다.
강의 링크다. 한국인들에게는 거의 알려져 있지 않은 듯 하다.
시스템 디자인 시 중요한 것
시스템 디자인을 시작할 때 많은 사람들이 아키텍처 다이어그램부터 그린다. 로드 밸런서를 그리고, 서버를 여러 대 배치하고, 데이터베이스와 캐시를 연결한다.하지만 이런 것들은 표면적인 설계에 불과하다. 진짜 중요한 것은 그보다 더 근본적인 요소들이다.
강의자도 마찬가지로 같은 실수를 한 경험이 있다고 한다. 대규모 트래픽을 처리하는 시스템을 개발했었는데, 잘 동작하던 시스템이 어느 순간 죽어버렸다고 한다. 원인은 부하를 줄이기 위한 분산 캐시였다. 부하를 줄이기 위해 캐시를 도입하였지만, "캐시 = 빠른 조회"라는 생각에 매몰되어 네트워크 RTT를 고려하지 못했던 것이다. 이로인해 사용자 요청마다 작은 네트워크 요청이 50번 넘게 발생하면서, 시스템 전체 성능 문제로 이어진 것이다.
시스템 디자인에서 중요한 것은 어떠한 표면적인 개념이 아닌 low-level에서 근본적인 개념을 볼 필요가 있다는 것이다.
Data has disatance.
말 그대로다. 데이터는 '거리' 개념을 가진다. CPU 캐시가 빠른 이유? 메인 메모리보다 데이터를 사용하는 CPU 코어에 더 가깝기 때문이다. 데이터가 물리적으로 먼 곳에 위치하면, 그만큼 더 시간이 소요된다.
많은 시스템 디자인이 다음과 같은 방식으로 이루어진다.
Client -> Load Balancer -> Application Server -> Cache -> Database하지만 이런 것만으로는 성능을 설명할 수는 없다.
- 데이터는 어디에 있는가?
- 데이터는 얼마나 멀리 있는가?
- 데이터를 가져오기 위해 몇 번의 RTT가 발생하는가?
핵심은 데이터의 위치와 이동 비용을 이해하는 것이다.
Understanding Disk I/O
데이터는 하드디스크의 플래터에 저장된다. 데이터를 읽어오려면 디스크를 회전시캬 헤드에 위치시켜야 한다.
만약 원하는 데이터가 순차적으로 있다면? -> 플래터가 한 번 회전하는 동안 연속적으로 데이터를 읽을 수 있다.
만약 다 따로 흩어져서 저장되어 있다면? -> 매번 헤드를 이동시키고 플래터가 다시 회전해야 한다.
이런 물리적 특성때문에 순차 I/O가 랜덤 I/O보다 빠르다.
그럼 기계식이 아닌 SSD는? SSD도 마찬가지로 순차 I/O가 훨씬 빠르다.
SSD는 데이터를 페이지 단위로 관리한다.
- Page (읽기/쓰기 단위) => 블록에 포함
- Block (삭제 단위)
삭제 시 Block 단위로 진행하기 때문에, Block 내 특정 Page만 지우기가 불가능하다. SSD는 그래서 데이터 수정 시 다음과 같이 진행한다.
1. 새 Page에 write
2. 기존 Page invalid
3. GC 발생
GC가 발생하면 다음과 같은 일이 일어난다.
1. Block 내 유효한 Page만 새로운 Block으로 복사
2. 기존 Block erase
3. 해당 Block을 다시 사용 가능한 상태로 변경
이 과정을 쓰기 작업이 증폭된다고 해서 Write Amplification이라고 한다.
순차 I/O는 그냥 비어 있는 Page에 계속 데이터를 넣기만 하면 되기에 효율적이다.
얘기가 길었는데, 핵심은 많은 데이터베이스들이 이러한 스토리지 특성을 고려하여 설계된다는 것이다. 그렇기에 데이터베이스 선정 시 이런 특성을 알고 고려할 필요가 있다.
Bandwidth vs Latency
시스템 디자인에서는 '대역폭'과 '지연' 이 두 개념을 정확히 이해하는 것이 중요하다.
수도관에 비유하자면 지연은 수도관의 한쪽 끝에서 다른 한쪽 끝으로 물 한방울이 이동하는 데 걸리는 시간이고, 대역폭은 수도관에 한 번에 옮길 수 있는 물의 양이다.
그래서 지연 문제를 해결하려고, 대역폭을 늘린다? -> 옳지 않은 개념이다. 여전히 지연은 똑같이 걸릴 것이기 때문이다.
이 두 개념을 정확히 구분하는 것이 중요하다.
Little's Law
L = λ × W시스템의 처리량과 대기 시간을 이해하는 데 자주 사용되는 법칙이 Little's Law다.
- L : 시스템에 존재하는 요청의 개수
- λ : 단위 시간당 시스템에 들어오는 요청 수
- W : 요청 하나를 처리하는 데 소요되는 평균 시간
예시를 들자면 요청 하나 처리에 1초가 걸리고, 초당 100개의 요청이 온다고 하면 항상 시스템에 100개의 요청이 있다고 생각하면 된다.
여기서 중요한 점은 서버는 물리적 한계를 가지고 있고, L은 바로 그 한계를 넘으면 안된다.
개발자로서 λ를 제어할 수는 없다. 하드웨어를 업그레이드 해 L을 감당할 수 있게 하거나, 코드를 최적화 해 W를 줄이거나 할 수 있다.
Cost Problem
과거와 달리 대부분의 서비스는 클라우드 서비스(ex: AWS)를 사용하여 운용된다. 그리고 비용은 시간과 사용한 자원에 따라 청구된다. RAM은 SSD보다 100배 비싸고, SSD는 cold storage보다 10배 비싸다. 그리고 비싼만큼 지연은 줄어든다.
그래서 많은 시스템은 데이터를 접근 빈도에 따라 온도를 나누어 관리한다. (Storage Tiering)
- Hot, Warm, Cold
모든 데이터가 Hot일 필요는 없다. 접근 빈도가 낮은 데이터를 위해 Redis를 사용한다? 아마도 돈이 굉장히 많으면 그럴 수는 있을 것이다.
세상에 공짜는 없다. 비싼만큼 빠르다.
출처
