해당 포스트는 강의를 수강 후 개인적으로 이해한 부분을 글로 기록하고 해석하기 위한 목적으로 이해한 부분이 틀릴수도 있습니다. 틀린 부분에 대해서는 편하게 지적해 주시면 수정하겠습니다.
1. 자료구조의 개념
1. 자료구조를 배워야하는 이유
컴퓨터를 이용해서
자료(데이터)를 사용할 때효율적으로자료를 처리하기 위함
2. 자료구조란
자료의 잘 정리된 효율적인
구조 형태의 추상화를 통해 자료의논리적 관계를 구조화한 것
자료(데이터)의 추상화는 다양한 객체를 컴퓨터에서 표현하고 활용하기 위해 필요한 자료(데이터)의 구조(관계)에 대해서 공통의 특정만을 뽑아 정의한 것
자료구조의 형태는 프로그래밍 언어에서 제공하는 미리 정의된 자료구조와 개발자가 정의하여 사용하는 사용자 정의 자료구조로 구분된다.
-
미리 정의된 자료구조:프로그래밍 설계나 컴파일러 구현 단계에서 정의되어 개발자에게 제공하는 자료구조- 기본 자료구조
정수,실수,문자등
- 파생 자료구조
배열,구조체,포인터등
- 기본 자료구조
-
사용자 정의 자료구조:소프트웨어 개발 중 개발자에 의해만들어지는 자료구조리스트,스택,큐,트리,그래프
3. 배열, Array
-
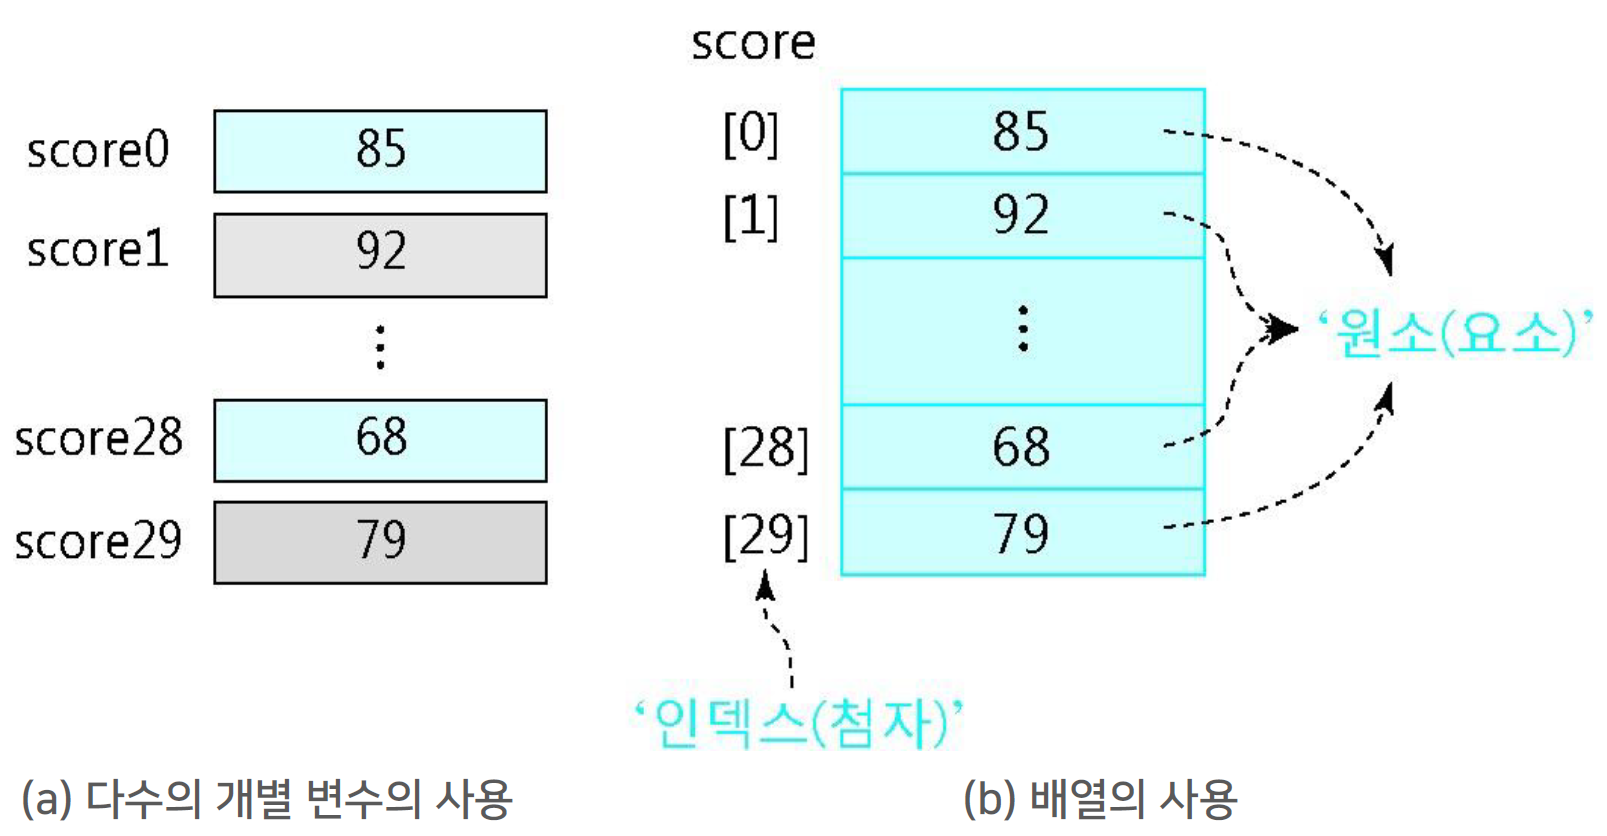
배열이란
동일한 자료형을 갖는 여러 개의 데이터를동일한 변수에일렬로 저장하는 자료 집합체- 배열 안에 있는 데이터는
데이터의 값(원소 또는 요소)과 각각인덱스(첨자)를 가지고 해당 인덱스를 사용하여 데이터에 접근한다. - 배열의 데이터는 컴퓨터 메모리에
연속적으로 할당되고 연속적으로저장 - 배열 외 모든 자료구조는
논리 주소와물리 주소가 일치하지 않는다.
-
1차원 배열
- 배열의 가장 간단한 형태
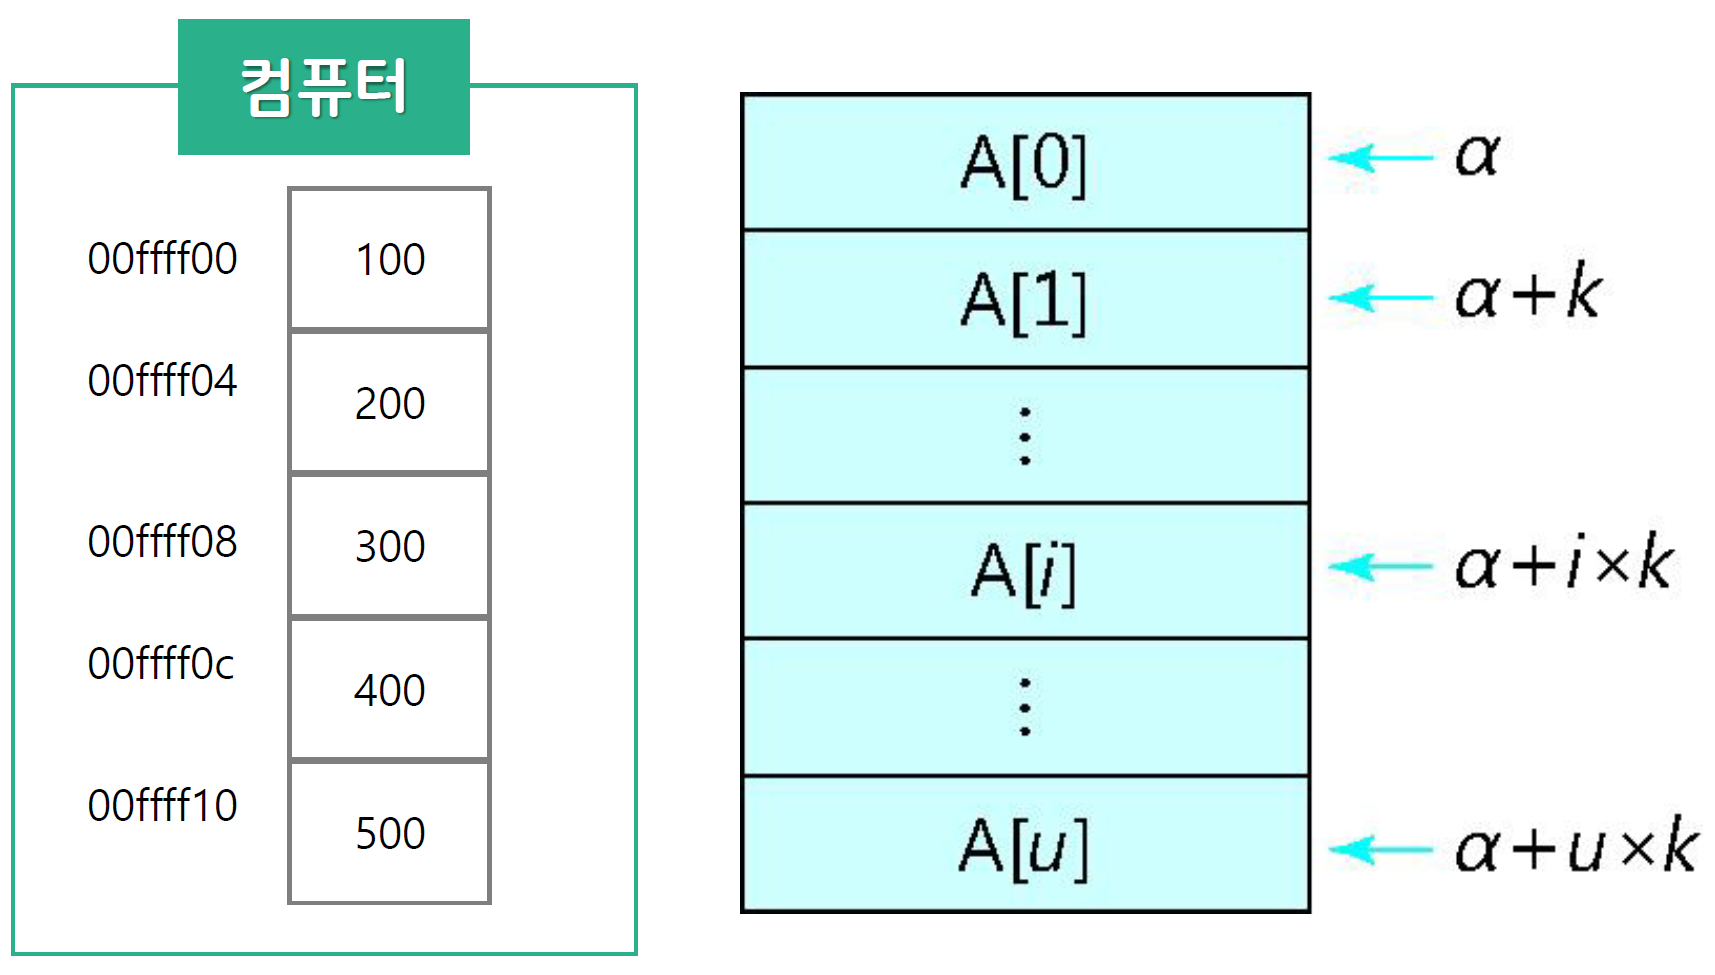
한 개의 인덱스를 사용해서 원소에 직접 접근- 1차원 배열에서의 주소 계산
크기가 k고시작 인덱스가 a인배열 A[i]의 저장 주소는a + i * k
-
다차원 배열
동일한 크기의 1차원 배열을여러 개 모아놓은 형태의 배열-
2차원 배열
행 인덱스 (i)와열 인덱스(j)를 가지고 있다.- 테이블 형태를 생각하면 된다.
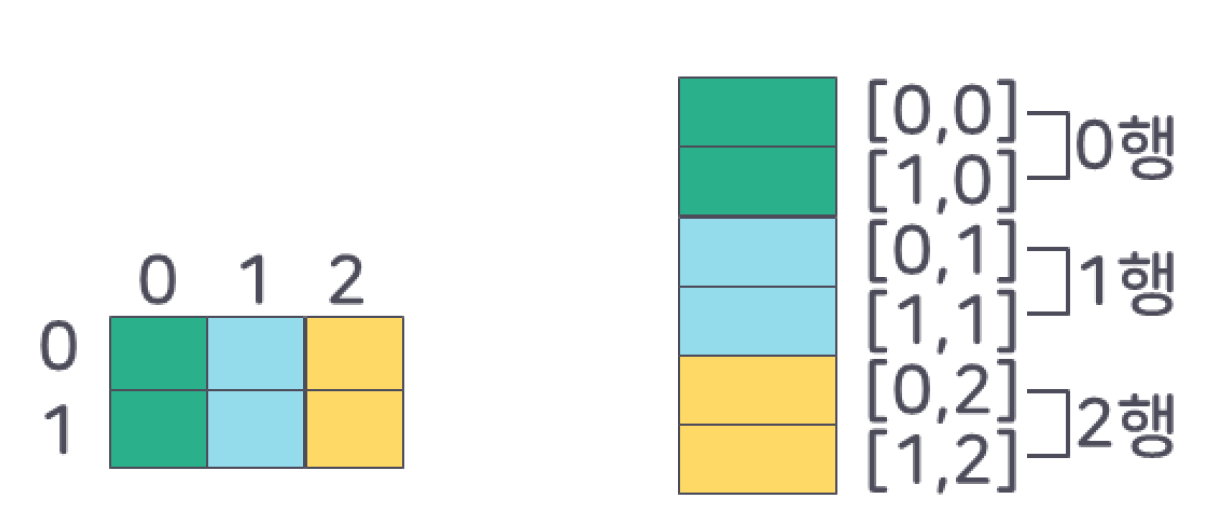
-
2차원 배열의 저장 순서
열(column) 우선 순서 저장- 첫 열에 있는 각 행의 원소를 순서대로 저장하고 다음 열로 이동하여 각 행에 있는 원소를 순서대로 저장
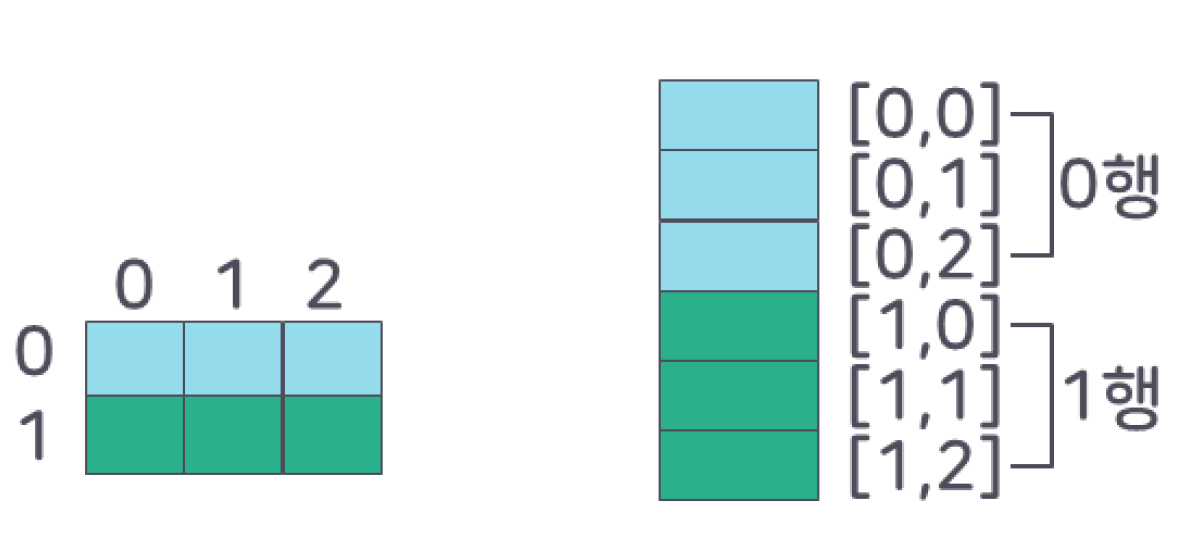
- 첫 열에 있는 각 행의 원소를 순서대로 저장하고 다음 열로 이동하여 각 행에 있는 원소를 순서대로 저장
행(row) 우선 순서 저장- 첫 행에 있는 각 열의 원소를 순서대로 저장하고 다음 행으로 이동하여 각 열에 있는 원소를 순서대로 저장
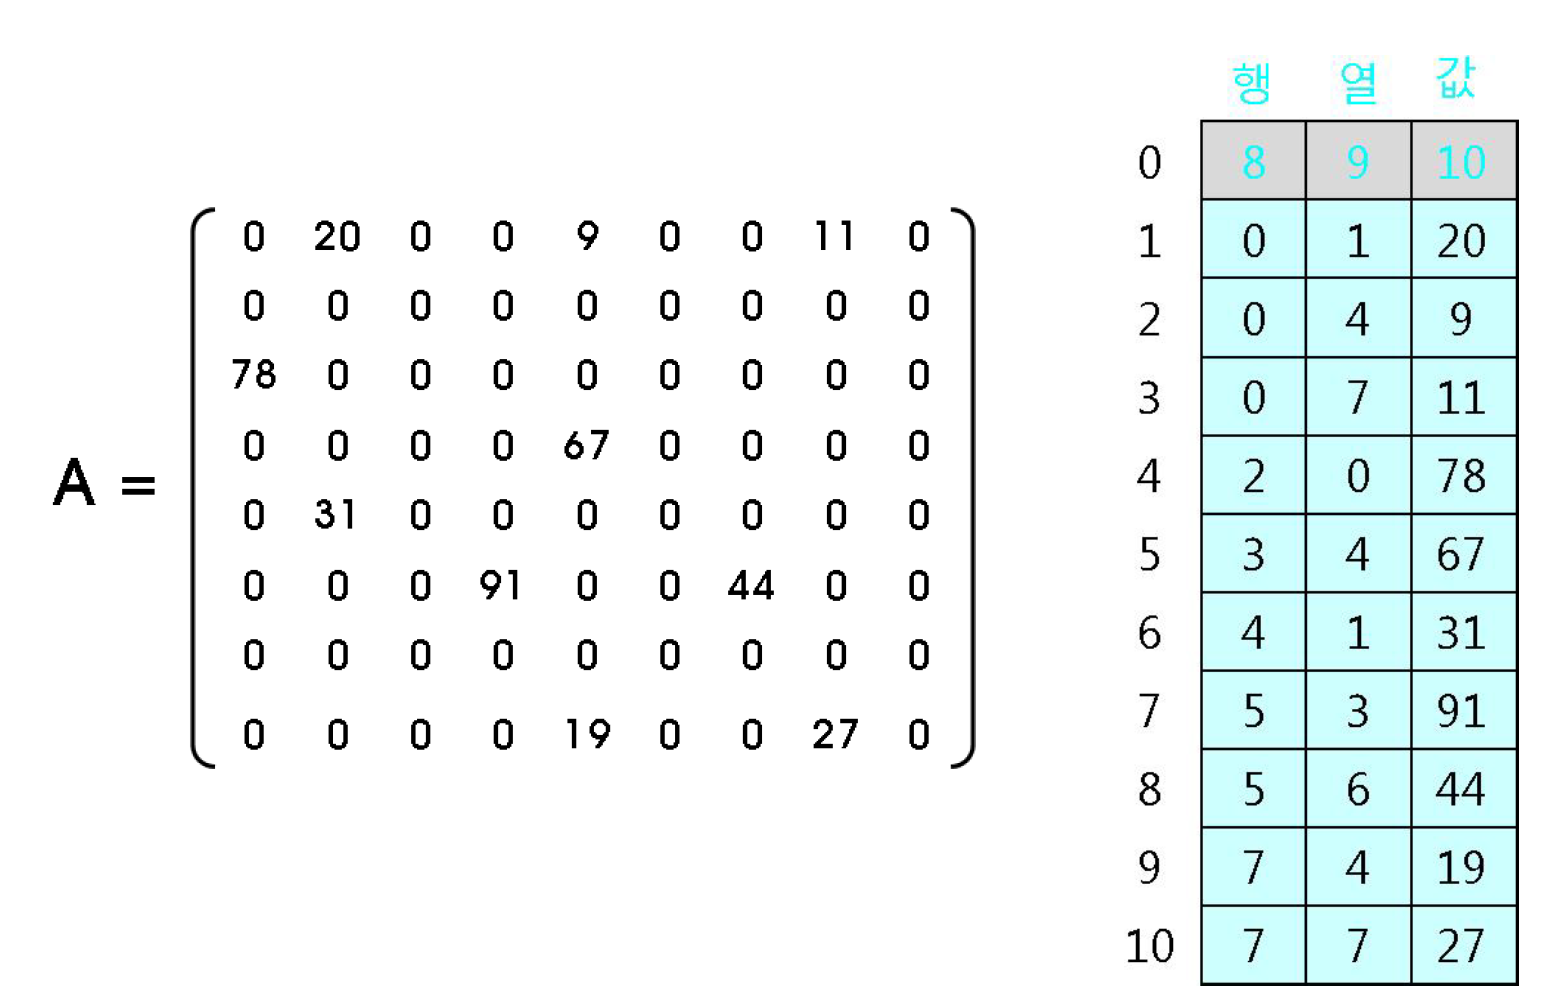
- 첫 행에 있는 각 열의 원소를 순서대로 저장하고 다음 행으로 이동하여 각 열에 있는 원소를 순서대로 저장
-
-
희소행렬, Spare matrix
값이 0인 원소가0이 아닌 원소보다상대적으로 많은행렬- 0 값을 저장하기 위해
컴퓨터 메모리 낭비를 막고,처리의 효율성을 높이기 위해사용 - 0인 원소는 저장하지 않고,
0이 아닌 값만 따로 모아서 저장하는 방법 - 0이 아닌 각 원소를
행 번호,열 번호,원소 값의 형태로 나타내면 2차원 배열로 표현 가능
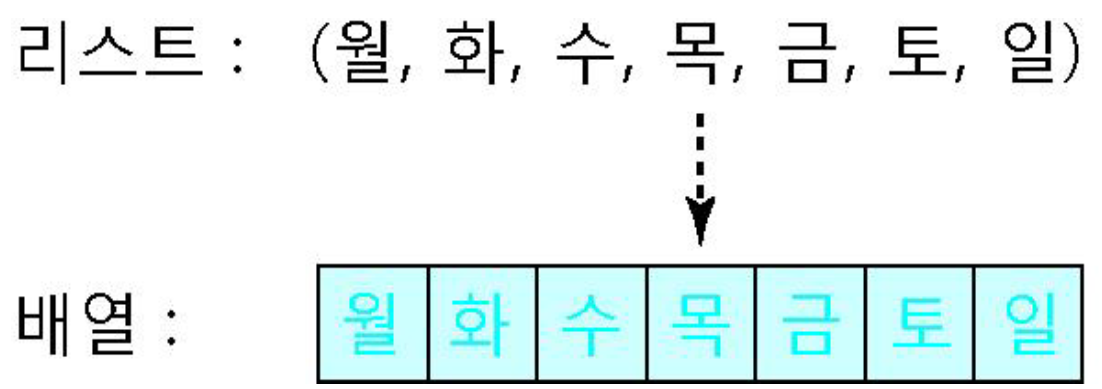
희소행렬의
0번째 값은행과 열의 크기와0이 아닌 값이 개수있는지 저장한다.
4. 리스트, List
-
선형 리스트, Linear list
순서 리스트(Ordered list)라고도 한다.- 1개 이상의 원소들이
순서를 가지고 구성된다. - 𝐴 = 와 같이 표시, i는 원소의 인덱스, n은 리스트의 크기
- 리스트에 저장되는 값은
순서가 보장되어야 한다.
-
선형 리스트의 구현(배열)
선형 리스트와1차원 배열은순차적인 구조를 가지고 있으므로1차원 배열로 간단하게 표현할 수 있다.
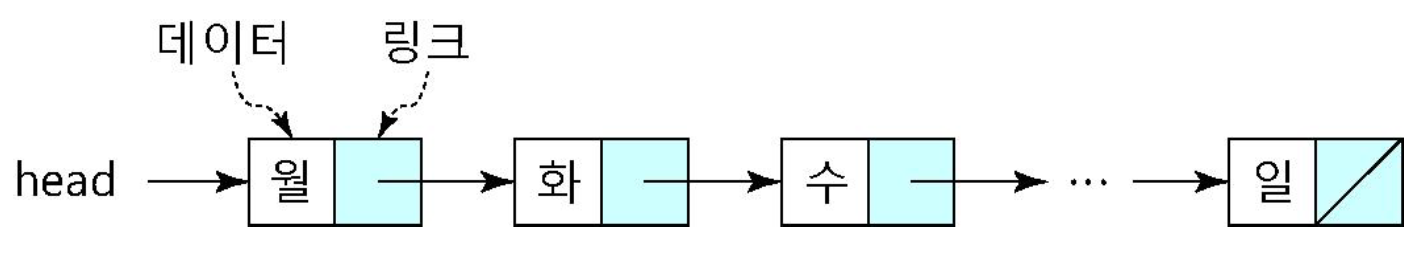
-
삽입
- 원소가 삽입될 위치 이후 원소들의
순서를 그대로 유지해야하기 때문에삽입할 원소 다음의 원소들을 뒤로 이동시켜야 한다. - 위 그림 예시에서
목이 빠져 다시 삽입하는 경우(월, 화, 수, 금, 토, 일),금의 위치에목을 삽입한 후금이후 원소들의 인덱스를i+1만큼 이동 시켜야 한다.
- 원소가 삽입될 위치 이후 원소들의
-
삭제
- 삽입과 반대로 삭제한 원소 뒤에 모든 원소를
i-1만큼 이동
- 삽입과 반대로 삭제한 원소 뒤에 모든 원소를
-
연결 리스트, Linked list
- 노드 간의 포인터 연결을 통해서 구현
- 각 노드는 적어도
두 종류의 필드, 원소 값을 저장하는데이터 필드와 노드 연결을 위한링크 필드를 가진다. - 선형 리스트의 논리적 순서만을 지원
-
단일 연결 리스트 (Singly linked list)
- 특정 노드의 링크 필드를 사용해서 후행 노드를 가리킨다.
- 특정 노드의 후행 노드는 쉽게 접근할 수 있지만, 선행 노드에 대한 접근은 헤드 노드부터 새로 시작해야 한다.
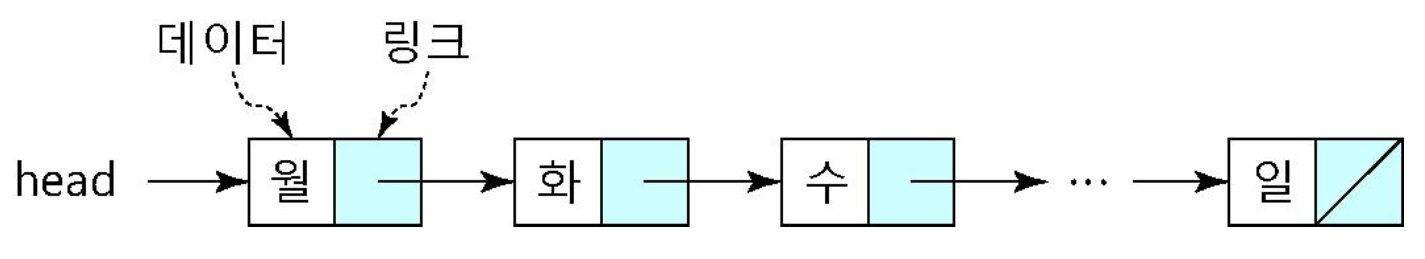
-
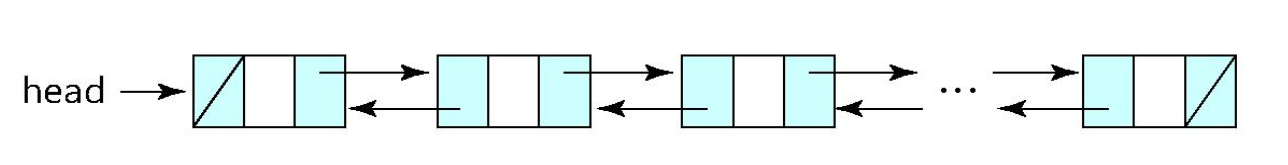
이중 연결 리스트 (Doubly linked list)
- 특정 노드의 첫번째 링크는 후행 노드를 가리키고 두번째 링크는 선행 노드를 가리킨다.
- 특정 노드에서 선행 노드에도 접근을 쉽게 제공
5. 스택, Stack
-
개념
-
데이터의
삽입과 삭제가 한쪽 끝에서만이루어지는 자료구조 -
가장 먼저 입력된 데이터가 가장 나중에 제거되는
섭입후출(FILO, First-In-Last-Out)특징을 가진다. -
오버플로우, overflow
- 스택을 위해 할당된저장 공간을 초과하여 더 이상 데이터를 삽입할 수 없는 현상 -
언더플로우, underflow
- 스택에데이터가 존재하지 않아삭제가 일어나지 않는 현상
-
-
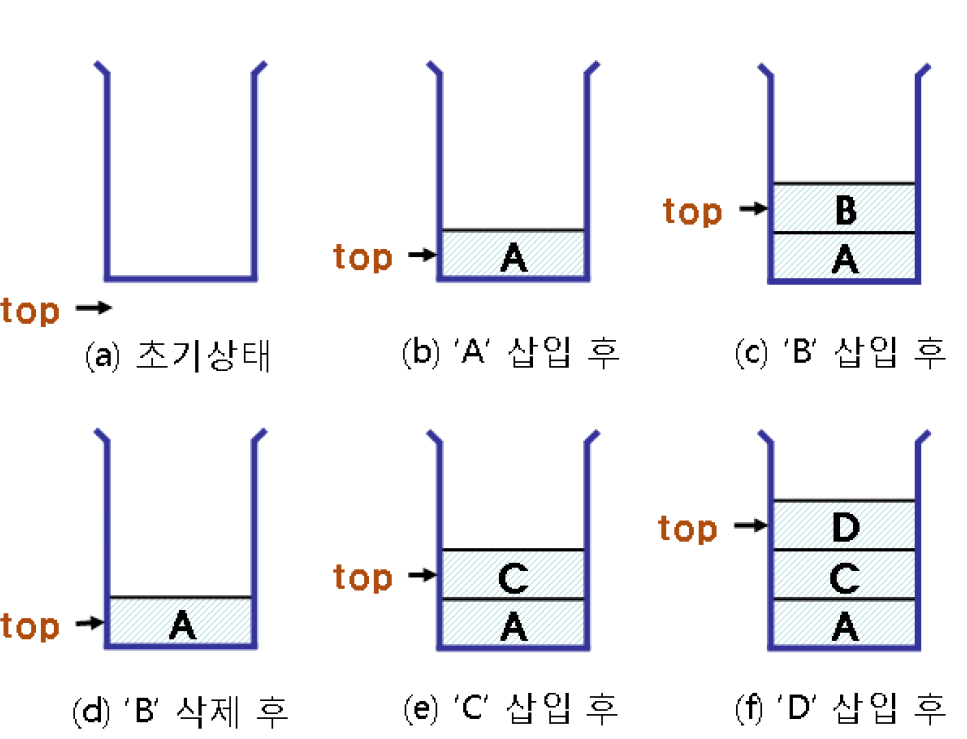
스택의 동작
-
코드 예시
const stack = [];
stack.push('A')
stack.push('B')
stack.pop()
stack.push('C')
stack.push('D')

console.log(stack) // ['A', 'C', 'D']
동작을 이해하기 위해 자바스크립트 예제로 가상의 stack을 만들어 데이터 삽입과 삭제를 구현. 스택에 쌓여있는 'A'에 접근하기 위해서는 'D'부터 'C'까지 먼저 제거된 후에 'A'에 접근할 수 있다.
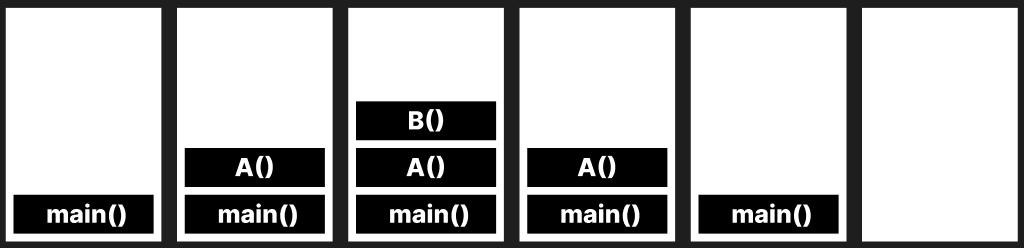
갑자기 떠오른 예시는 자바스크립트 동작 과정이다. 자바스크립트는
싱글 스레드 기반 언어로 가장 첫 줄부터 구문 분석을 진행하면서 함수가 호출되면 함수를 스택에 쌓아두고 실행한다.const B = () => { console.log('마지막 스택'); } const A = () => { B(); } const main = () => { A(); } main();위 코드를 예시로 들면 가장 먼저 호출되는 main을 실행한 후 main함수를 스택에 쌓아둔다. main함수가 실행되고 main함수 내부에 A함수가 호출되면 main함수 실행을 멈춘 후 A함수를 실행하고 스택에 쌓여있는 main함수 위로 A함수를 쌓아둔다. 마찬가지로 A함수가 실행되면서 호출된 B함수도 A함수의 실행을 중단하고 B함수를 실행하면서 A함수 위로 B함수를 쌓아둔다. 이 후 B함수의 실행이 끝나면 스택에서 제거하고 실행이 중단되었던 함수를 다시 실행한다.
-
6. 큐, Queue
-
개념
-
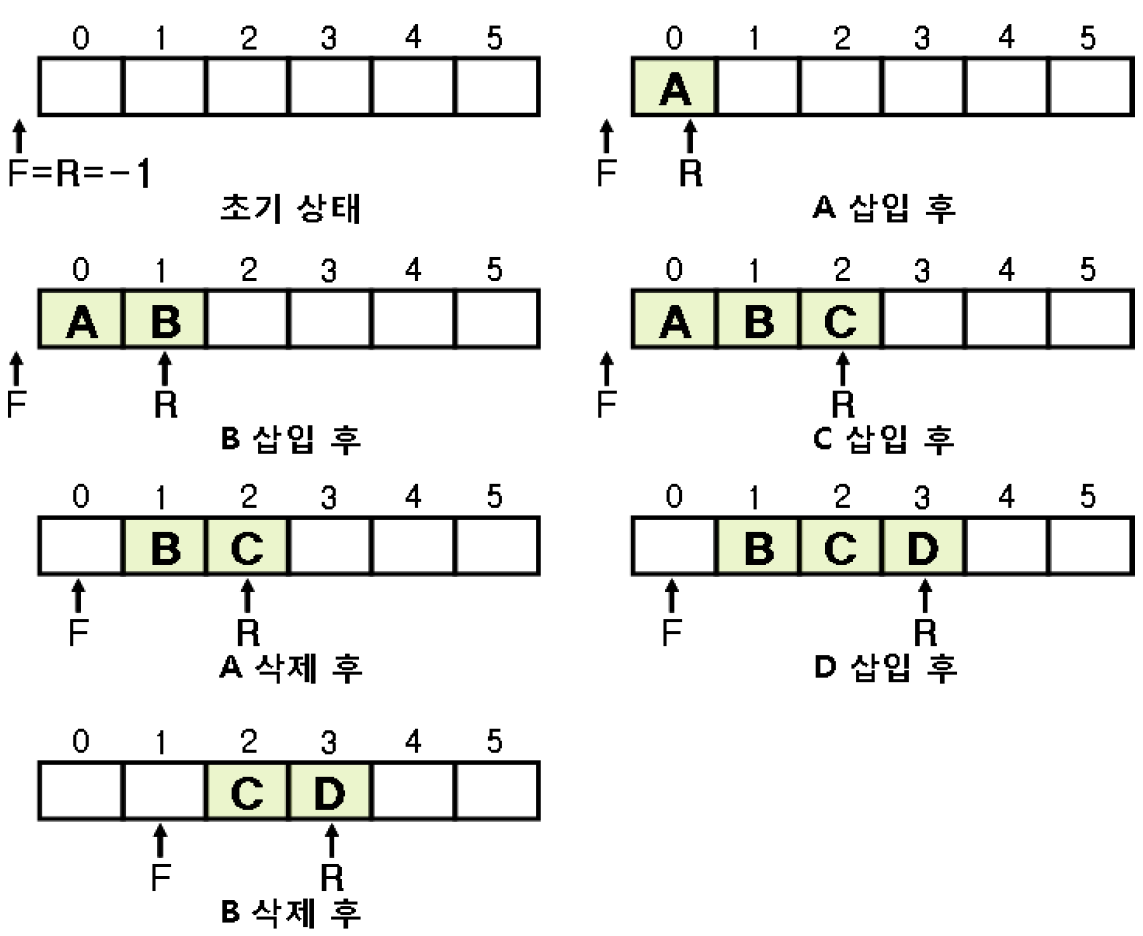
선형 리스트의 한쪽 끝에서는 데이터의 삭제만 이루어지고, 다른 한쪽 끝에서는 데이터 삽입만 이루어지는 자료구조
-
가장 먼저 입력된 데이터가 가장 먼저 제거되는
선입선출(FIFO, First-In-First-Out)
-
코드 예시
const stack = [];
stack.push('A')
stack.push('B')
stack.shift()
stack.push('C')
stack.push('D')

console.log(stack) // ['B', 'C', 'D']
위 코드에서는 스택과 반대로 'D'에 접근하기 위해선 'B'부터 'C'까지 먼저 제거된 후에 접근할 수 있다.
-
오버플로우, oveflow
- 큐를 위해 할당된 저장 공간을 초과해서 더 이상 데이터를 삽입할 수 없는 현상
-
언더플로우, underflow
- 큐에 데이터가 존재하지 않으면 삭제가 일어나지 않는 현상
-
-
연산 후 큐의 상태
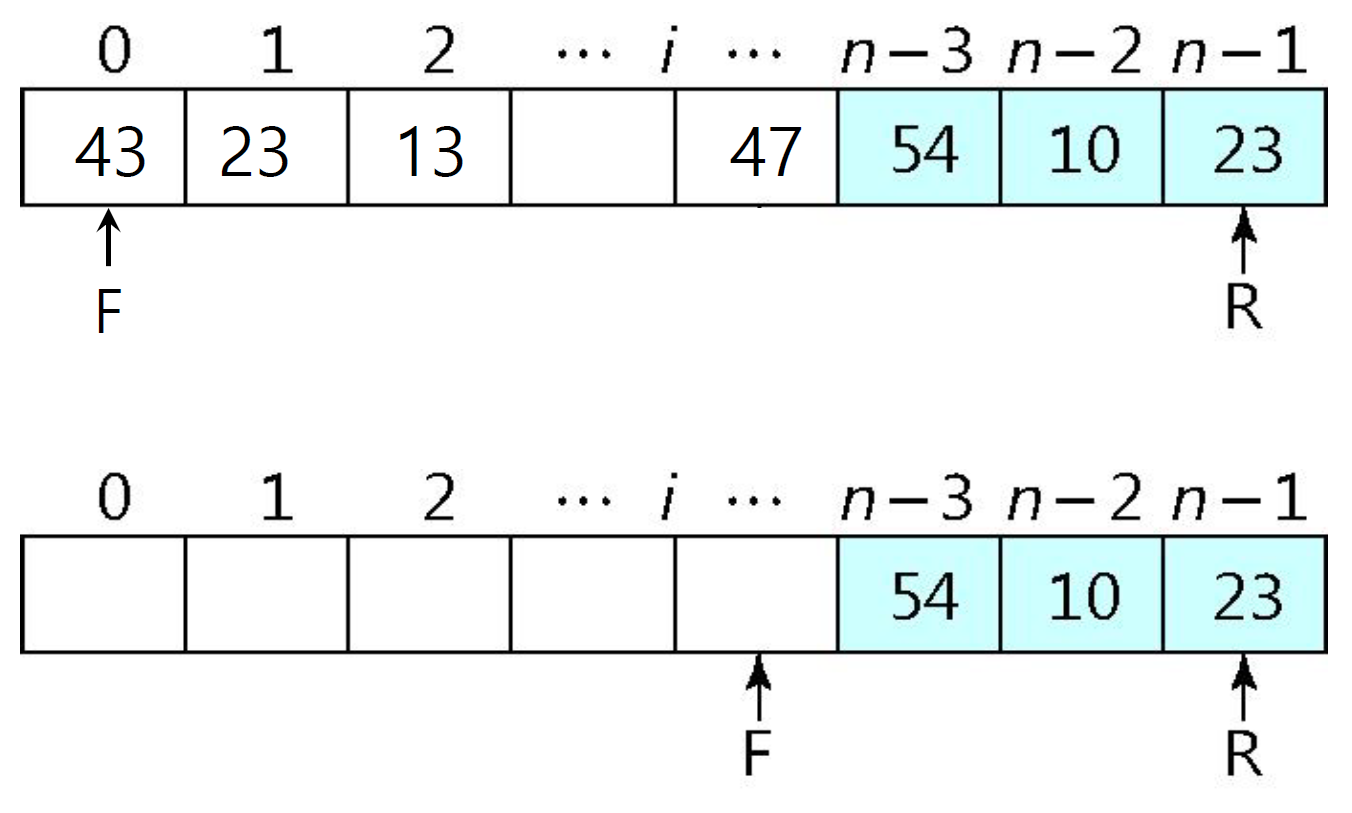
- 만원 상태
- 데이터가 큐에 삽입됨에 따라 rear 변수 값이 증가하다가 n-1이 되면 더 이상 데이터가 삽입될 수 없는 상태가 된다.
- 만원 상태가 반드시 큐에 모든 항목이 차 있다는 것을 의미하는 건 아니다.
- 큐의 만원 상태를 결정하기 위한 다른 방법이 필요하다.
- 만원 상태