socket Programming
소켓이 뭔지에 대해서 알아보자.
client process와 server process 간의 통신 -> socket
OS 내부의 구현을 건드리는게 아니라 os에서 제공하는 서비스만 사용하는것 뿐이다. 그럼 이 서비스를 사용하려면 OS에서 제공하는 특수한 인터페이스를 사용해야 한다. OS 안에는 application 그 하위 계층들이 구현되어 있기때문에 transport layer에서 제공하는 부분을 사용할 수 있다. 따라서 application은 1) tcp socket이나 2) udp socket 둘 중 하나를 사용해야만 한다.
소켓의 두가지 타입
- TCP
- sock_stream - UDP
- sock_DGRAM (데이터 그램)
외울 필요가 없다. 왜냐하면 코드를 보면 어떤 소켓인지 알 수 있기 때문이다.
소켓 기능 - TCP
'function' + 'api'이므로 TCP라는 것을 알 수 있다.
parameter 값은 코드를 보면 알 수 있다.
1) 웹서버가 소켓 생성
2) 방금 생성한 소켓을 특정 포트에 bind() 함
3) 서버니까 listen
4) client로부터 요청을 받을 준비를함
5) client로부터 connection이 들어올때까지 기다림. (block 상태)
6) 어떤 client의 웹브라우저에서 socket을 열고 conenct 당함
7) 서버가 accept하면서 action을 취함
이런 식의 과정이후 client-server사이의 단단한 TCP 연결고리가 생성된다. 이후에 아무리 많은 client socket이 와도 바로 연결된다. 따라서 이후의 요청이 또 오면 read-write만 바로바로 진행하면 된다.
소켓의 생성과 설정
1) 소캣 create()
필요한 파라미터는 총 3개 (domain, type, protocol)
두번째 파라미터 type가 제일 중요함 -> 무슨 소켓인지 알려주는 부분 (UDP ? TCP ?)
2) 소캣 bind()
3) 소켓의 listen()
해당 소켓을 listen용도를 사용함
4) accept()
모든 준비가 끝났으니 요청을 기다린다.
실행됨녀 block 됐다가 클라이언트로부터 요청이 들어오면 return됨.
(sockfd, sodkaddr, addrlen)
두번째 파라미터 -> reference point를 보고 상태가 변경됨
TCP 소켓의 연결설정
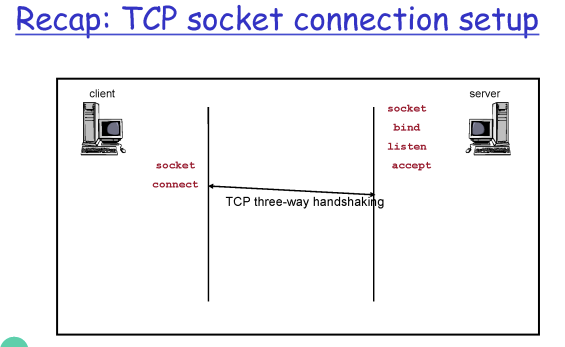
connect() 에는 1) 서버의 주소 2) 서버의 포트번호 를 파라미터로 가짐
Q. 클라이언트는 왜 bind()를 쓰지 않을까?
A. bind()는 특정 포트에 bind 한다는 뜻인데 client는 아무 포트나 사용해도 된다. 만약 client도 포트넘버를 지정하고 싶으면 bind()를 써도 된다.
서버의 실제코드 예시
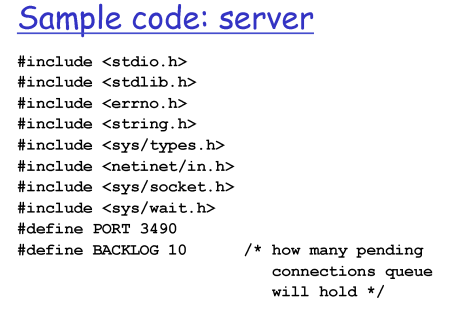
// 포트번호는 3490이고 10개의 이미지를 받는다.
create()
main() {
	int sockfd, new_fd;
    struct sockaddr_in my_addr;
    struct sockaddr_in their_adr;
    int sin_size;

    // 제일 처음 등장하는 API가 socket
    // input parameter는 총 3개
    // SOCK_STREAM => TCP 소켓을 열었고 -> 성공적으로 생성이 됐다면 (즉 -1 이 아니라면) 음수값이 안나왔음
    if ((sockfd = socket(PF_INET, SOCK_STREAM, 0)) == -1) {
    	perror("socket");
        exit(1);
    }
}
bind()
my_addr.sin_family = AF_INET;
my_addr.sin_port = htons(MYPORT); // 방금 생성한 소켓을 내 port와 연결 시킴 -> 원하는 포트번호로 소켓이 연결됨

my_addr.sin_addr.s_addr = htonl(INADDR_ANY);

// 총 10개의 이미지를 받을 수 있고 기다리게 됨
if(bind(sockfd, (struct sockaddr *) &my_addr,
	sizeof(struct sockaddr) == -1) {
	perror("bind");
    exit(1);
}
lister()
if(listen(sockfd, BACKLOG) == -1) {
	perror("listen");
    exit(1);
}
// 서버는 클라이언트를 기다리기 시작함
while(1) {
	sin_size = sizeof (struct sockaddr_in);
    if(new_fd = accept(sockfd, (struct sockaddr*) & their_addr, &sin_size)) == -1 ) {
    	perror("accept");
        continue;
    }
    printf("server : got connection from %s\n", inet_ntoa(their_addr.sin_addr));
}
client 입장에서
if (sockfd = socket (PF_INET, SOCK_STREAM, 0 ) == -1) {
	perror("socket");
    exit(1);
} // 소켓 생성함
their_addr.sin_family = AF_INET;
their_addr.sin_port = htons (Server_Portnumber);
their_addr.sin_addr = htonl(Server_IP_address); // 서버의 주소와 연결함

// read () 와 write()를 구축함
if(connect (sockfd, (struct sockaddr*) & their_addr, sizeof (struct sockaddr) == -1) {
	perror("connect");
    exit(1);
}
write()
int write (int sockfd, char* buf, size_tnbytes);수행이 되면 계속 쓰기만 한다.
UDP 소켓의 연결설정
소켓 생성 후 connection 없이 그냥 데이터 전송만 일어나므로 단순하다.
int close (int sockfd);소켓을 다 사용한 후에는 끝내야 한다.
웹서버 vs 클라이언트 (브라우저)
multiplexing / demultiplexing
TCP 와 UDP는 모두 기본적인 transport layer를 제공하는데 이때 기본적으로 multi/demulti 기능을 제공한다.
application -> transport : 여기서 내려오는 부분들을 segment 로 나눠서 내보냄
transport -> application : 리시버 측으로 segment를 다시 올려보내는 demultiplexing
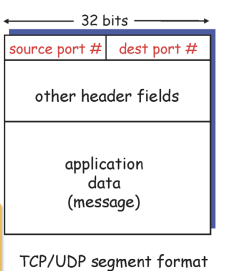
segment는 data와 header로 나뉜다.
header에는 부가적인 정보가 있기때문에 field로 나뉨.
1) 각 datagram은 source IP 주소와 destination IP 주소를 가진다.
2) 각 datagram은 1개의 transport layer segment를 가진다.
3) 각 segment는 source를 가지고 destination은 port 번호를 가진다.
호스트는 IP주소와 port 번호로 segment를 적절한 소켓으로 보내준다.
connectionless demux - UDP
모두 같은 소켓으로 간다.
UDP 를 사용하는 경우 demux 가 dest IP와 dest PORT 만을 사용하여 어떤 소켓으로 올릴지 demultiplexing 이 이루어진다.
이때 dest IP와 dest Port가 어떤 segment이던지 동일하다.
dest port 만 같으면 어느 client이던지 올 수 있다.
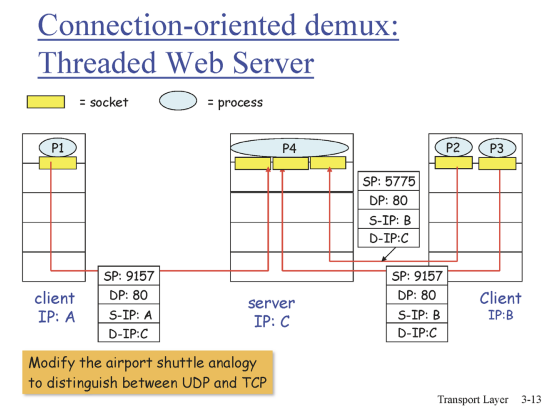
connection-oriente demux - TCP
source IP, source PORT, dest IP, dest PORT 를 사용하여 demux
DP: 80 -> 웹서버가 있다는 것을 확인할 수 있음
3개의 segment dest IP, dest PORT가 동일하지만 demux 하니까 모두 다른 socket을 가짐 -> 왜냐하면 source IP나 source PORT가 하나라도 틀리면 다른 곳으로 demux 되기 때문이다.
웹서버가 하나 있고 각 사용자별로 연결될 소켓이 존재한다.
ex) naver server는 client 각각 만을 위한 socket을 생성하고 관리한다. (-> 단점으로는 자원을 낭비하게 된다.)
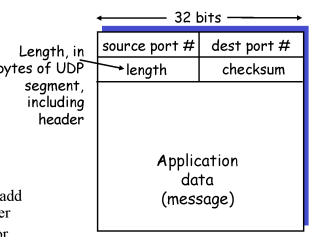
UDP - header
UDP, TCP, IP 의 3가지 정보의 field들의 header가 굉장히 중요하다. 왜냐하면 각 protocol들의 동작에 근거하기 떄문이다.
즉, protocol을 이해하려면 header를 이해해야 한다.
UDP의 header 는 field가 4개밖에 안된다.
(즉 굉장히 단순하다는 것을 알 수 있다.)
헤더에서 알 수 있는 정보)
포트번호의 크기는 0 ~ 2^16 개 존재한다 (16bit이므로)
checksum으로 전송도중에 에러가 발생했는지 여부를 알아낸다.
checksum이 발생되면 올리지 않고 바로 drop시킨다.
multi/demulti/erro-checking 총 3가지를 진행한다.
복습
- APP
- transport
UDP TCP - networt
- link
- physical
App -> App으로 갈때 기본적으로 필요한 1) multiplexing 과 2) error checking 을 transport layer 가 진행한다.
하위 layer가 상위 layer의 전달을 도와준다.
TCP가 제공하는 reliable한 data transfer에 대해 알아보자.
application -> application으로 전달되는 이미지가 하나도 유실되지 않고 전달되는 현상.
transport는 아래 계층을 통해 데이터가 나가게됨.
TCP - header
TCP는 할일이 많기 때문에 header에도 여러가지 field가 들어있을 것이다.
reliable한 data transfer의 원칙
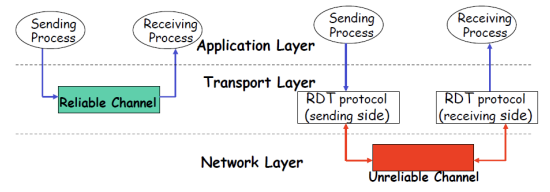
Q. reliable하지 않은 채널이 어떻게 하면 일어나나?
1) packet 유실
2) packet error
reliable한 데이터를 제공하기 위해서 어떤 작업이 필요할지?
reliable한 data transfer protocol 디자인
각 state가 있고 어떤 event가 발생하면 화살표가 이동된다.
1) RDT 1.0
underline 채널이 완벽하다고 가정해보면 reliable한 데이터 전송이 가능하다.
2) RDT 2.0
패킷 error 가 발생가능한 채널이면 어떤 메커니즘이 필요한가?
상대방이 error없이 받으려면 보내는 packet에 checksum이라는 부가정보를 넣어서 전송해야한다.
Q. 에러가 발생했다면?
A. 리시버가 잘 받았는지 feedback을 보내야한다.
- ACKs : 긍정적인 피드백
- NAKs : 부정적인 피드백
즉 (+)/(-) 이던 계속 피드백을 주고 받아야 한다.
sender가 NAK을 받게 되면 client에게 재전송한다.
에러가 발생한 경우 해결할 방법 3가지
(detection, feedback, retransfer)
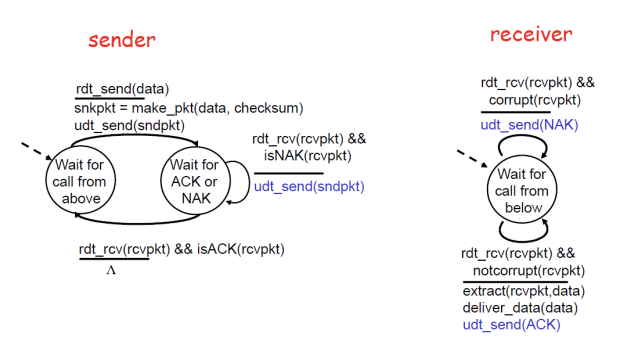
과연 이 메커니즘만으로도 reliable할 데이터 전송일까?
아니다. 만약 피드백에 에러가 있는 경우에는 어떻게 하나?
(피드백 자체에도 에러가 발생한 경우!!)
해결) 가는 곳, 오는 곳 모두에서 detection 이 필요할 것 같다!
가장 직관적인 방법으로는 재전송하는 것이지만 receivcer 입장에서는 구분을 할 수가 없음.
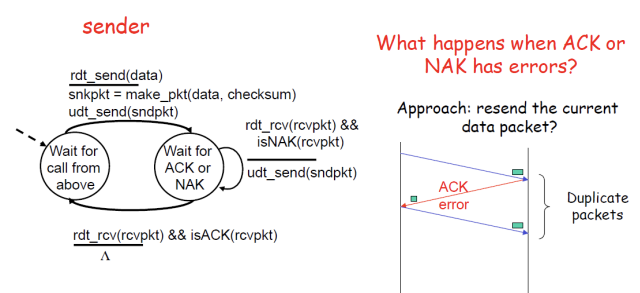
=> 그렇다면 패킷자체에 번호를 부여하게 되면 구분을 할 수 있지 않을까?
중복된 패킷을 해결하는 방법)
1) sender는 각 패킷에 sequence number을 부여하고 전송한다.
2) sender는 ACK/ANK를 보이면 재전송한다.
3) receiver는 중복된 패킷을 보면 버린다.
문제점) 만약 모든 packet에 sequence number을 보내게 되면 (extra part) overhead가 발생하게 된다. 즉 각 header 에 최소한의 field를 사용해야 한다.
그렇다면 seq #로 몇개로 충분할까?
해결책) 2개 (prev, next)
example
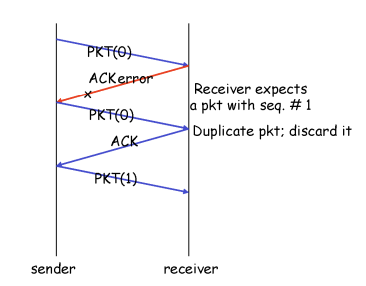
receiver는 무조건 제대로 받으면 'ACK'를 전송해야 한다.
만약 sender에서 보내다가 유실된 경우 receiver는 sender 가 보낸 packet의 seq #를 모르므로 가장 최근에 받은 packet의 seq #를 작성하게 된다.
<sender> <receiver>
  ------------> packet(0)
  <------------ ACK(0)
 -------------x  packet(1) : 중간에 유실됨
 <-------------- Ack(0) : 못받았지만 가장 최근에 받은 packet의 seq #로 ACK를 전송
즉 sender 입장에서 동일한 ACK(0)을 받으므로 중복되므로 유실시킴
3) RDT 3.0 : channel with loss & packet 에러
sender는 packet을 보내고 유실되면 아무 대답도 들리지 않기 때문에 자체 타이머를 설정하게 된다.
1) timer가 짧은 경우
장점) 유실이 잃어난 경우에 대한 reaction이 빠름
단점) packet이 멀리 가서 오래걸린 경우에 대해선 또다시 잘못됨
2) timer가 긴 경우
위의 장단점이 반대로 바뀐다.
sender는 ACK를 보내기위 해 timer를 맞추고 기다리낟.
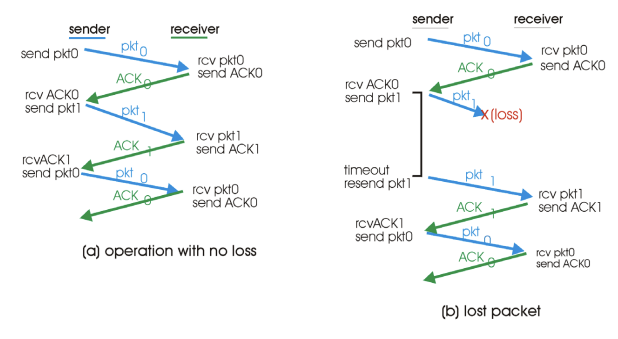
1번 그림에서 위에 pck0과 아래 pck0은 서로 다름
sender의 재전송 유실
2번 그림에서 유실되면 timer 터짐 -> 1번 기다리고 있었다.
ACK 유실
3번 그림에서 receiver를 받다가 timer 가 뻥터져서 한번더 재전송을 하게됨
feed back이 늦게오는 상황에서 timer 터짐
4번 그림에서 pk1 이 대신 나가면서 전송을 받으려하지만 피드백이 느려지고 timer가 터지게 된다.
요약
1) unreliable 채널인 경우는 어떻게 발생하나?
- packet error
- packet loss
2) packet error를 위한 메커니즘 3가지 - error detection
- feedback
- retransmission
- seq #
3) packet loss를 위한 메커니즘 - timeout
이런 정보들이 결국 packet의 header부분의 field에 담기게 됨
RDT는 물론 신뢰성이 있으나 단순하게 하나의 packet만을 가지고 계속 검증하므로 굉장히 비효율적이라고 볼 수 있다. 실제 네트워킹을 보면 여러 데이터를 마구잡이로 보내고 피드백을 받는다.