커널을 다시 빌드하지 않고 바꾸는 방법: eBPF가 해결한 문제
애플리케이션은 파일을 열고, 네트워크 패킷을 보내고, 프로세스를 만들 때마다 커널을 지난다.
그래서 kernel boundary는 관측과 제어에 매력적인 지점이다.
운영 중인 서버에서 커널 기능을 바꾸려면 상당한 비용을 치러야 한다. 다시 빌드하고 재부팅하면 서비스가 끊기고, 커널에 기능을 끼워 넣는 일종의 플러그인인 커널 모듈을 올리면 버그 하나가 host 전체를 끌고 내려갈 수 있다.
이 지연은 수치로도 확인된다. Learning eBPF가 인용한 2013년 연구에 따르면 제출된 커널 패치 중 3분의 1 정도만 받아들여지고, 승인까지 대부분 3~6개월이 걸린다. 이 지연은 단순한 관료적 병목만은 아니다 — 커널은 시스템 전체의 기반이므로, 오래 실전에서 검증돼 안정성이 높아진(hardened) 커널을 더 신뢰하려는 선택이기도 하다.
코드베이스 규모도 이 부담을 더한다. Linux kernel 자체가 약 3천만 줄에 이르는 코드베이스라서, 외부 개발자가 기존 코드에 익숙해지는 것부터 쉽지 않다.
eBPF는 이 문제를 다른 방식으로 푼다. 한 문장으로 정의하면, eBPF는 kernel boundary에서 발생하는 이벤트에 검증된 작은 프로그램을 동적으로 붙여 실행하는 Linux 커널 실행 모델이다.
굳이 비유하면, 정적인 웹 페이지에 JavaScript가 붙어 동적인 동작을 더하듯 eBPF는 실행 중인 Linux kernel의 정해진 지점에 검증된 작은 program을 붙인다. 다만 JavaScript와 달리 eBPF program은 verifier(program을 kernel에 올리기 전에 안전 조건을 검사하는 kernel 구성요소)가 종료 조건과 안전성을 먼저 검사하고, 아무 kernel function이나 호출하거나 아무 memory나 읽을 수 없다.
1주차에서 답할 질문은 하나다.
운영 중인 커널을 다시 빌드하거나 애플리케이션을 고치지 않고도,
어떤 제약 아래 커널 이벤트를 관측하고 제어할 수 있는가?
이 질문에 대한 답이 eBPF가 관측성, 네트워킹, 보안 도구의 기반이 되는 이유다. 답을 찾아가는 과정에서 user space와 kernel space, syscall, BPF의 출발점, verifier, maps, helper, hook을 차례로 만나게 된다.
짧게 요약하면 이 글의 모델은 네 문장이다.
- 애플리케이션은 파일, 네트워크, 프로세스 작업을 할 때 kernel boundary를 지난다.
- eBPF는 이 지점의 event에 작은 program을 붙여 실행한다.
- kernel은 program을 load하기 전에 verifier로 최소 안전 조건을 검사한다.
- 결과는 map이나 buffer를 통해 user space tool이 읽는다.
이 글을 읽는 데 필요한 전제 지식은 하나뿐이다. 프로그램이 파일을 읽거나 네트워크로 데이터를 보낼 때 OS에 요청을 한다는 정도만 알면 되고, kernel 내부 구조나 C 프로그래밍 경험은 필요 없다.
애플리케이션은 직접 하드웨어를 만지지 않는다
Linux는 실행 중인 코드를 두 영역으로 나눈다 — 하드웨어와 자원을 직접 다루는 kernel space와, 이를 직접 다루지 못하는 user space다. 앞서 나온 kernel boundary는 바로 이 두 영역이 만나는 경계를 가리키는 말이다.
Linux에서 일반 애플리케이션은 user space에서 실행된다.
user space code는 디스크, 네트워크 카드, 프로세스 스케줄링, 메모리 관리 같은 일을 직접 처리하지 않는다.
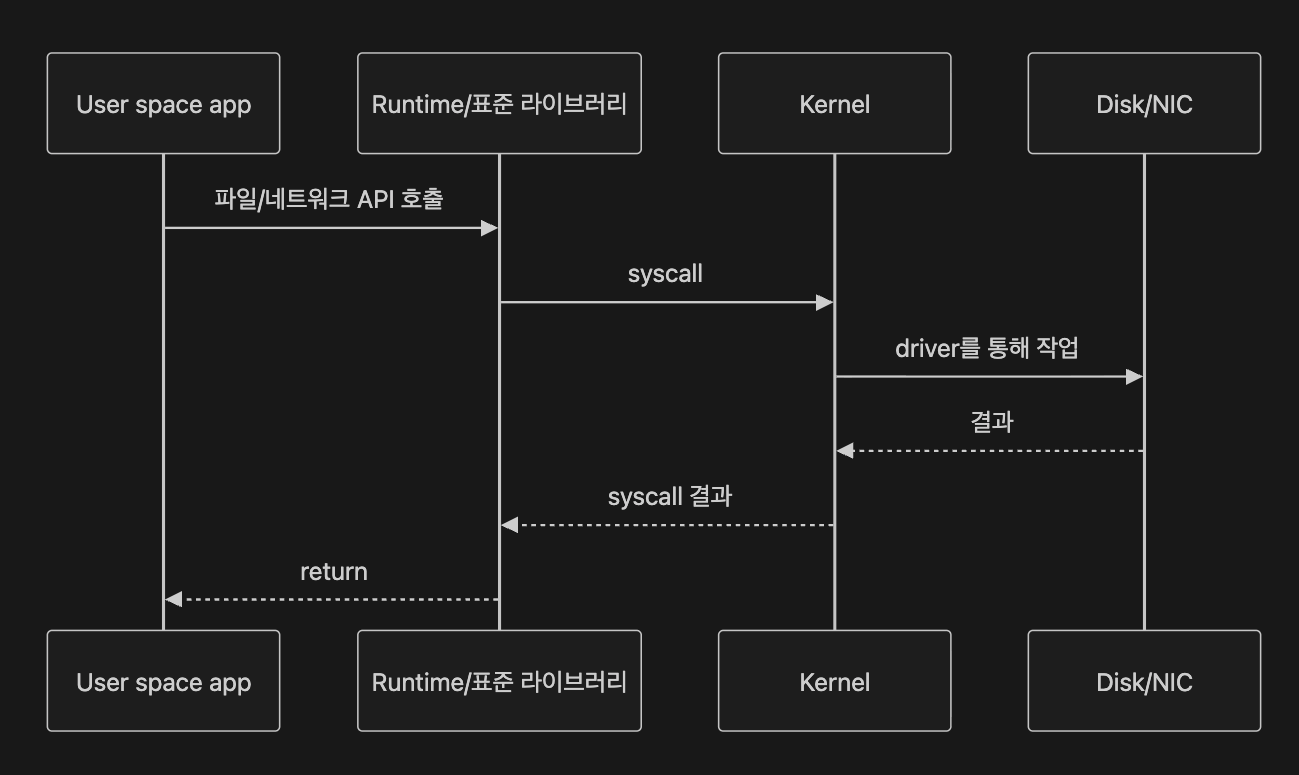
파일을 읽거나 네트워크로 데이터를 보내려면 system call을 통해 kernel에 요청한다.
예를 들어 cat /etc/hosts 같은 작은 명령도 파일을 열고, 읽고, 닫기 위해 여러 syscall을 호출한다.
애플리케이션 개발자는 보통 openat(2), read(2), close(2)를 직접 호출하지 않는다.
언어 런타임과 표준 라이브러리가 이 과정을 감싸기 때문이다.
하지만 실행 중인 프로그램의 실제 I/O는 결국 kernel boundary를 지난다.
이 그림은 일반 애플리케이션의 I/O가 어떤 경계를 지나는지 보여준다.
화살표는 호출과 응답이 오가는 흐름이다.
이 관점이 eBPF의 출발점이다.
애플리케이션 내부에 로그를 심지 않아도, kernel boundary에서 파일 접근, 프로세스 실행, 네트워크 패킷, block I/O 같은 이벤트를 볼 수 있다.
단, 이 말은 애플리케이션의 모든 의미를 안다는 뜻이 아니다.
eBPF가 강한 지점은 kernel이 이미 알고 있는 이벤트다.
BPF의 시작에서 eBPF가 프로덕션 표준이 되기까지
eBPF의 뿌리는 BSD Packet Filter다.
여기서 packet은 네트워크로 오가는 작은 데이터 조각이고, filtering은 그중 필요한 것만 골라내는 작업이다. packet capture 도구가 모든 packet을 user space로 복사한 뒤 필요 없는 packet을 버리는 대신, kernel 안에서 먼저 걸러내면 비용을 줄일 수 있다는 게 원래 문제의식이었다.
Steven McCanne와 Van Jacobson이 쓴 1992년 12월 작업 논문으로 먼저 배포됐고, 1993년 USENIX 학회에서 발표됐다.
이 논문은 kernel 안에서 packet byte를 읽고 조건을 검사해, capture 대상 애플리케이션에 얼마나 복사할지 결정하는 작은 filtering program을 제안했다(packet을 실제로 막는 것과는 다르다).
tcpdump가 이 모델의 대표적인 사용처였다.
중요한 지점은 packet filtering 자체보다 구조다: 사용자가 작성한 filtering logic을 kernel이 packet이 지나가는 지점에서 실행한다.
이 구조가 나중에 packet filtering을 넘어 syscall, tracing, networking, security hook으로 확장된다.
Learning eBPF는 BPF가 1997년 Linux kernel 2.1.75에 들어갔고, 2012년 kernel 3.5에서 seccomp-bpf(허용된 syscall만 실행하도록 제한하는 커널 보안 기능)를 거치며 system call filtering에도 쓰이기 시작했다고 설명한다. 즉 seccomp-bpf는 BPF가 packet filtering 밖에서도 통한다는 것을 보여준 중요한 사례다 — packet을 고르는 작은 program 구조가 허용할 syscall을 고르는 작은 program 구조로 확장된 것이다.
2014년 Linux kernel 3.18부터는 instruction set, maps, bpf() syscall, helper function, verifier를 갖춘 extended BPF(eBPF)로 개편된다.
이 골격이 갖춰진 뒤에도 확장은 멈추지 않았다.
kprobe는 커널 코드의 거의 모든 지점에 동적으로 걸 수 있는 트랩(trap, 실행 중인 코드를 특정 지점에서 가로채 다른 코드로 넘기는 장치)으로, 2005년부터 커널에 있었다(단 blacklist·inline 함수, 일부 architecture는 예외).
2015년에는 eBPF program을 이 kprobe에 붙이는 기능이 추가되면서, 코드를 고치거나 모듈을 새로 짜지 않고도 관측 program을 동적으로 걸 수 있게 됐다 — tracing이 eBPF의 첫 번째 주요 활용처로 자리잡은 계기다.
2016년은 eBPF가 관측성과 네트워킹 양쪽에서 프로덕션 무대에 오른 해다. Brendan Gregg의 Netflix 트레이싱 작업이 널리 알려지며, 그는 eBPF가 “Linux에 슈퍼파워를 준다”고 표현했다.
같은 해 발표된 Cilium은 컨테이너 네트워킹의 datapath(packet이 실제로 처리되는 경로)를 eBPF로 구현한 대표적인 초기 사례다(Learning eBPF는 “최초의 네트워킹 프로젝트”라고 서술한다).
네트워킹 쪽 다음 이정표는 Katran이다. Meta(당시 Facebook)는 XDP(eXpress Data Path, NIC 드라이버 초입에서 실행되는 네트워킹 hook)와 eBPF로 L4 로드밸런서 forwarding plane(packet을 어느 backend로 보낼지 판단하고 전달하는 실행 경로)을 다시 짠 Katran을 2018년 오픈소스로 공개했다.
eBPF는 Katran보다 앞서 2017년 말부터 커널 안에서 독립된 subsystem으로 다뤄지기 시작했고, Daniel Borkmann과 Alexei Starovoitov가 maintainer를 맡았다(이후 Andrii Nakryiko 합류).
BTF(BPF Type Format)는 2018년 도입돼 program 이식성을 높이는 토대가 됐고, 이 무렵 커널 기여자층도 빠르게 넓어졌다. eBPF program 하나에 담을 수 있는 instruction(명령어) 수 제한이 4,096개에서 100만 개로 늘어난 것은 그보다 늦은 2019년 Linux 5.2에서다.
2020년 도입된 LSM(Linux Security Module) BPF로 tracing(2015)·networking(2016)에 이어 보안이 eBPF의 세 번째 주요 용도로 자리 잡았다.
BPF는 어떤 계기마다 활용 범위를 넓혀 왔을까?
연도별로 정리하면 다음과 같다.
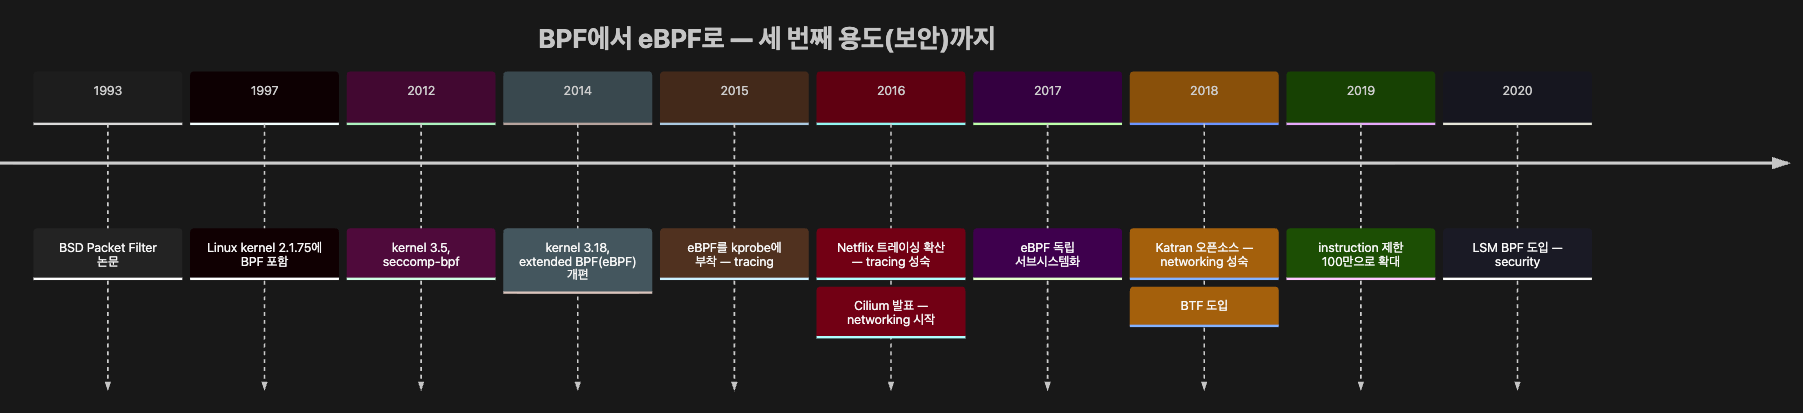
이 타임라인에서 눈여겨볼 것은 성격이 다른 사건들이 비슷한 시기에 몰려 있다는 점이다.
서브시스템화(2017년 말)는 프로젝트 거버넌스 변화이고, Katran 오픈소스(2018)는 networking 사례의 성숙이다. 연도가 가깝다고 두 사건이 같은 종류의 이정표는 아니다. 각각 “왜 중요한가”를 서로 다른 잣대로 따로 물어야 한다.
이런 역사 때문에 표기도 문맥마다 갈린다: kernel 문서와 bpf() syscall, BPF_PROG_LOAD 같은 API 이름은 지금도 BPF를 쓰지만, 커널 커뮤니티 밖(ebpf.io, eBPF Foundation)에서는 eBPF라는 이름이 굳어졌다.
이 글은 커널 API나 원문을 그대로 인용할 때는 BPF, 현대 Linux의 확장된 실행 모델 자체를 가리킬 때는 eBPF로 구분해 쓴다.
커널은 지금 extended BPF 엔진 하나만 갖고 있어 오래된 classic BPF program도 자동 변환돼 실행되지만, 두 program의 작성 문법 자체는 여전히 다르다.
커널 기능을 확장하는 기존 방법은 각각 어디서 막히는가
eBPF의 실행 모델을 보기 전에, kernel boundary에서 무언가를 관측하거나 바꾸는 기존 방법을 먼저 봐야 한다.
각 방법은 운영 중인 시스템에서 서로 다른 비용을 요구한다.
| 방식 | 장점 | 운영 제약 |
|---|---|---|
| kernel patch | 커널에 기능을 직접 넣는다 | upstream 반영과 배포판 채택을 거쳐야 하며, 재부팅과 업그레이드 지연이 크다(커널을 재부팅 없이 patch하는 live patching은 예외) |
| kernel module | 커널을 다시 빌드하지 않아도 된다 | kernel privilege로 실행돼 결함의 파급 범위가 넓다(Verifier 절에서 자세히 다룬다). 네트워킹 용도로 쓸 때는 교체하려면 보통 전체를 unload한 뒤 다시 load해야 한다 |
| application instrumentation | 비즈니스 로직과 요청 맥락을 안다 | 앱마다 코드 수정과 재배포가 필요하다 |
| sidecar | 앱 코드를 건드리지 않고 Pod 단위로 계측한다 | Pod 단위로만 보이고 배포 비용이 있다(뒤 “Sidecar와 eBPF는 같은 노드에서 서로 다른 범위를 본다” 절에서 자세히 다룬다) |
| eBPF | 붙은 hook 범위 안에서 kernel boundary를 관측하고 제어한다. 네트워킹 hook은 대체로 무중단(atomic)으로 교체할 수 있다 | privileged agent 운영, verifier 제약, hook 범위, 성능 비용을 감안해야 한다 |
이 표는 우열이 아니라 각자의 자리를 보여준다.
애플리케이션 수정이나 커널 재빌드 없이 kernel boundary에서 관측하고 제어해야 할 때 eBPF가 선택지가 되고, 나머지 방식은 각자의 자리에 남는다.
sidecar와 eBPF의 구체적인 차이는 뒤에서 별도 절로 다룬다.
eBPF는 “작은 프로그램 + 이벤트 연결” 모델이다
eBPF program은 독립 실행형 process가 아니다.
흐름을 번호로 쓰면 이렇다.
- user space의 loader나 tool이 program을 준비한다.
bpf()syscall로 kernel에 load를 요청한다.- kernel은 program을 바로 실행하지 않고 verifier로 먼저 검사한다.
- 검사를 통과한 program은 특정 hook이나 event에 attach된다.
- 이후 그 event가 발생할 때마다 program이 실행된다.
이 attach는 대상 애플리케이션의 재시작과 무관하다. eBPF program을 나중에 붙여도, 이미 떠 있던 process가 그 이후 kernel boundary를 지나는 event는 관측할 수 있다.
이 그림은 eBPF의 기본 실행 모델을 보여준다.
화살표는 control flow와 data exchange를 함께 나타낸다.
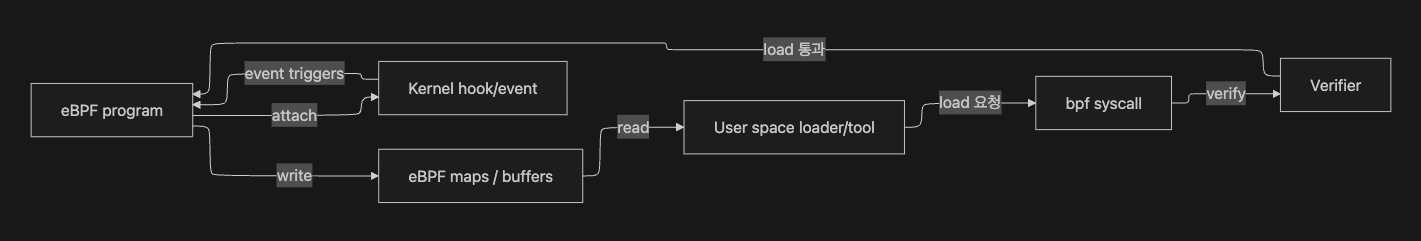
program, verifier, map, helper, hook — 이 다섯 요소를 잡으면 eBPF를 “커널에 뭔가 넣는다”는 막연한 설명에서 벗어나서 볼 수 있다.
위 그림은 이 중 program·verifier·map·hook이 어떻게 연결되는지 보여준다.
각 요소의 역할은 아래에서 하나씩 짚는다.
Verifier는 커널 안에서 실행하기 위한 문지기다
kernel module은 kernel privilege로 실행된다.
module에 버그가 있으면 host 전체가 영향을 받을 수 있다.
위험은 버그로 인한 crash에만 있지 않다.
module은 host의 모든 데이터에 접근할 수 있는 특권 코드라서, 저자를 신뢰할 수 없다면 악성 코드가 섞여 들어올 위험도 함께 떠안는다.
eBPF는 다른 방식을 택한다.
user space에서 올린 program을 kernel이 먼저 정적으로(program을 실제로 실행하지 않고 코드 자체만 보고) 분석한다.
이 역할을 하는 component가 verifier다.
Verifier가 보는 핵심은 program이 kernel을 망가뜨리지 않는지다.
예를 들어 다음을 검사한다.
- program이 정상적으로 종료되는가
- pointer를 dereference(주소를 따라가 실제 값을 읽는 것)하기 전에 안전성을 확인했는가
- context 밖 memory에 접근하지 않는가
- 허용된 helper만 호출하는가
이 그림은 verifier가 이 네 가지를 어떤 순서로 판정하는지 개념적으로 보여준다.
실제 커널 소스의 verifier 알고리즘 순서를 그대로 나타낸 것은 아니다.
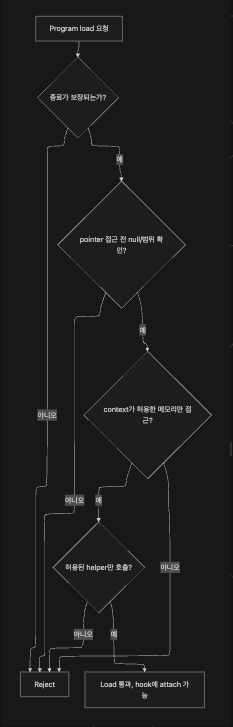
이 네 가지 중 하나라도 실패하면 kernel은 program을 아예 load하지 않는다.
What Is eBPF?가 드는 null pointer dereference(비어 있는 주소를 가리키는 pointer를 그대로 읽으려는 시도) 예시처럼, user space에서는 한 process만 죽지만 kernel에서 같은 실수가 나면 machine 전체가 영향받을 수 있다.
종료 검사(program이 정상적으로 종료되는가)가 중요한 이유도 비슷하다. user space process가 무한 루프에 빠지면 그 process만 강제 종료하면 되지만, 앞서 본 kernel module처럼 kernel context에서 끝나지 않는 코드가 돌면 CPU를 붙잡아 host 전체가 멈춘 것처럼 보일 수 있다.
다만 verifier를 보안 제품처럼 이해하면 안 된다. program의 의도를 판단하지 않기 때문이다.
비유하면 verifier는 공항 보안검색대에 가깝다: 가방 속 물건이 반입 규정을 어기는지는 확인하지만, 그 사람이 무슨 목적으로 여행하는지는 판단하지 않는다.
network packet을 읽는 program도 관측 목적으로 쓰일 수 있고, 민감한 데이터를 빼내는 데 악용될 수도 있다.
그래서 eBPF program을 load할 권한은 root 권한처럼 다뤄야 하며, 현대 Linux에서는 CAP_BPF 같은 capability와 배포판 정책이 이 영역에 관여한다.
정리하면 verifier는 “이 program을 kernel context에서 실행해도 최소한의 안전 조건을 만족하는가”를 검사한다.
“이 program이 운영 정책상 신뢰할 수 있는가”는 별도 문제다.
Maps는 kernel program과 user space를 잇는 공유 상태다
eBPF program은 event가 발생했을 때 짧게 실행되므로, 결과를 사람이 보거나 user space가 설정값을 전달하려면 kernel과 user space가 상태를 주고받아야 한다.
이때 쓰는 핵심 구조가 eBPF map이다.
Map은 흔히 kernel space에 있는 key-value style data structure로 이해하면 되지만, array·ring buffer처럼 key-value로 완전히 환원되지 않는 type도 있다.
user space program과 eBPF program이 같은 map을 통해 데이터를 읽고 쓴다.
예를 들어 eBPF program은 process별 syscall count를 map에 누적하고, user space tool은 그 map을 읽어 화면에 출력한다.
네트워킹에서는 정책이나 backend 정보를 map에 넣고, packet 처리 program이 그 map을 조회하기도 한다.
이 그림은 방금 든 syscall count 예시가 map을 통해 어떻게 오가는지 보여준다.
화살표는 데이터가 쓰이고 읽히는 흐름이다.
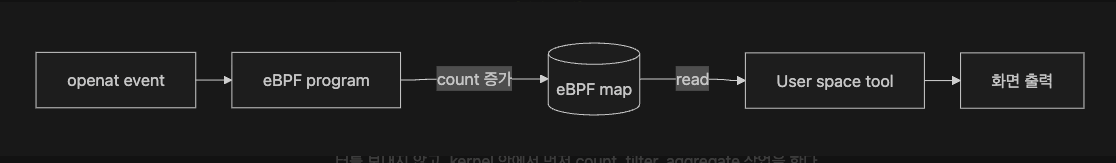
이 구조 덕분에 eBPF는 단순 event printer에 머물지 않는다. program은 event마다 user space로 모든 데이터를 보내지 않고, kernel 안에서 먼저 count, filter, aggregate 작업을 한다.
user space는 필요한 시점에 map을 읽고, ring buffer에서 event stream을 받는다.
bpf(2) manual도 map을 eBPF program 사이, 그리고 kernel program과 user space application 사이에서 데이터를 공유하는 generic data structure로 설명한다.
정리하면 map은 짧게 실행되고 사라지는 eBPF program이 상태를 유지하고, user space와 데이터를 주고받기 위한 공유 저장소다.
Helper는 eBPF가 부를 수 있는 제한된 커널 API다
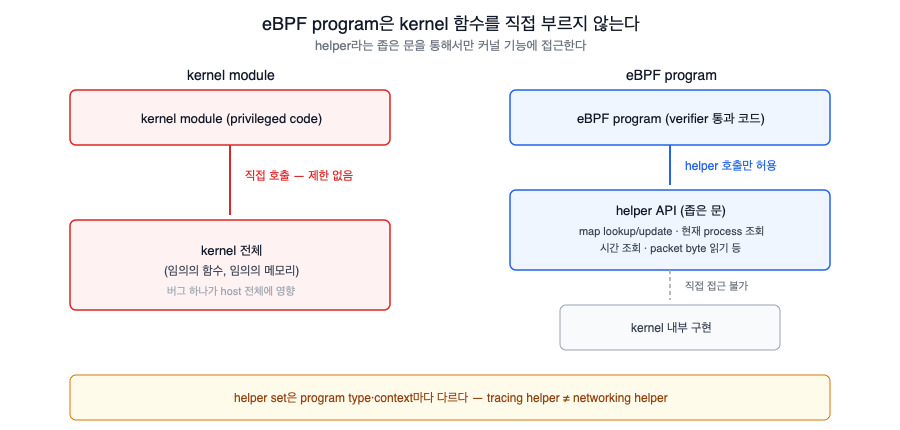
eBPF program은 kernel 안에서 실행되지만 임의의 kernel function을 호출하지 않는다.
kernel 내부 function은 버전, 설정, architecture에 따라 달라진다.
임의 호출을 허용하면 verifier가 안전성을 판단하기 어렵고, kernel 내부 구현 변경에도 취약해진다.
대신 eBPF는 helper function을 사용한다.
helper는 kernel이 eBPF program에 공개한 제한된 API다.
예를 들어 map lookup/update, 현재 process 정보 조회, 시간 조회, packet byte 읽기, packet redirect 같은 작업이 helper를 통해 제공된다.
helper는 program type과 context에 따라서도 달라진다.
여기서 context란 hook이 eBPF program을 실행할 때 함께 넘겨주는 입력 데이터다. network hook은 packet 정보를 context로 넘기고, tracing hook은 호출된 함수의 인자나 register 값을 context로 넘긴다.
network packet context에서 쓸 수 있는 helper와 tracing context에서 쓸 수 있는 helper가 같지 않다.
이 제약 덕분에 kernel은 “이 program이 지금 어떤 데이터에 접근해도 되는가”를 더 좁은 범위에서 판단한다.
그래서 eBPF program을 이해할 때는 “무슨 코드를 썼는가”만 보지 말고 “어떤 hook에 붙었고, 어떤 context를 받으며, 어떤 helper를 호출하는가”를 같이 봐야 한다.
이 그림은 kernel module과 eBPF program이 kernel 기능에 접근하는 범위가 어떻게 다른지 보여준다.
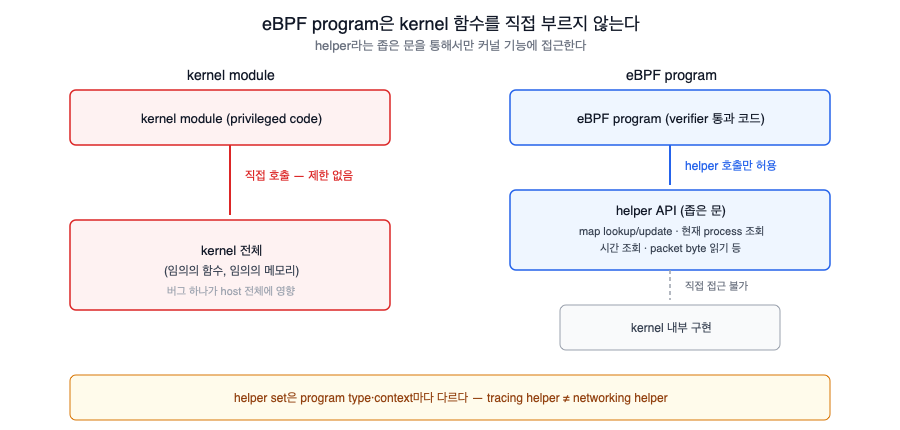
Hook은 eBPF program이 실행되는 위치다
eBPF program은 아무 때나 실행되지 않는다.
특정 hook이나 event에 attach됐을 때만 실행된다.
대표적인 hook은 다음과 같다.
| 영역 | 예시 | 설명 |
|---|---|---|
| Tracing | tracepoint, kprobe, kretprobe, fentry/fexit | kernel function이나 trace event에 붙어 관측한다 |
| Networking | XDP, TC ingress/egress, socket hook | packet이 network stack을 지나는 지점에서 처리한다 |
| Security | LSM hook | security decision point에서 정책을 평가한다 |
| cgroup | cgroup hook | process group 단위의 network/socket event를 다룬다 |
이 표의 이름을 지금 다 외울 필요는 없다.
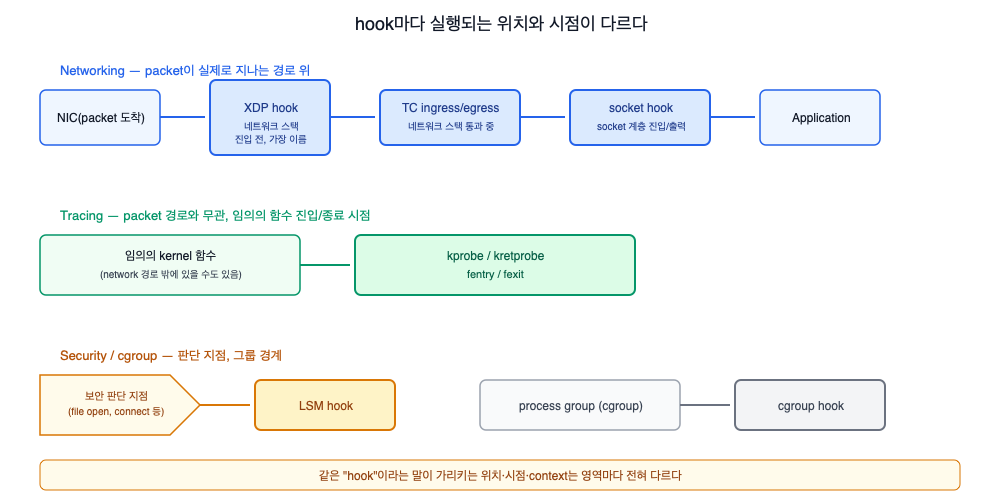
1주차에서 중요한 것은 hook마다 “실행되는 위치”와 “받는 context”가 다르다는 점이다.
kprobe는 특정 kernel 함수가 호출되는 시점에 개입하고, XDP는 packet이 network card에 도착한 직후, 커널 network stack에 들어가기도 전에 개입한다.
이 hook 개념 때문에 eBPF의 활용 영역이 넓어진다.
packet filtering에서 시작했지만, 현재는 tracing, networking, security에 걸쳐 쓰인다.
Brendan Gregg의 BPF Performance Tools는 BPF를 kernel and application events 위에서 mini program을 실행하는 방식이라고 설명한다.
이 표현이 eBPF의 현재 위치를 잘 잡아준다.
하지만 hook이 많다는 말은 “어디든 붙는다”는 뜻이 아니다.
program type마다 context, return value 의미, helper set, verifier rule이 다르다.
XDP program은 packet receive path의 매우 이른 지점에서 실행되고, tracepoint program은 kernel이 정의한 trace event에 붙는다.
이 차이는 성능과 안정성, 얻을 수 있는 정보의 종류를 모두 바꾼다.
이 그림은 hook마다 실행되는 위치와 시점이 얼마나 다른지 정리한 것이다 — networking hook은 packet이 실제로 지나는 경로 위에, tracing hook은 임의의 kernel 함수 진입/종료 시점에, security/cgroup hook은 판단 지점과 그룹 경계에 각각 자리한다.
JIT와 성능은 eBPF의 부산물이다
eBPF를 소개할 때 “고성능”이라는 단어가 자주 나온다.
이유는 있다.
검증을 통과한 eBPF bytecode(program을 kernel이 이해하는 명령어 형태로 옮긴 것)는 JIT(Just-In-Time, 실행 직전에 기계어로 변환하는 컴파일 방식) compiler를 통해 native machine instruction으로 바뀌어 실행되는 경로를 갖는다.
또 event를 user space로 모두 넘기지 않고 kernel 안에서 먼저 filtering이나 aggregation을 처리하므로 user/kernel boundary crossing 비용을 줄인다.
하지만 성능을 eBPF의 출발점으로 두면 글이 쉽게 과장된다.
eBPF program을 high-frequency event에 붙이거나 event마다 많은 데이터를 user space로 보내면 비용은 생긴다.
network path에서는 hook 위치, driver mode, packet size, workload에 따라 결과가 달라진다.
따라서 1주차에서 성능은 이렇게만 정리한다.
- eBPF는 kernel event 가까이에서 filtering과 aggregation을 처리한다.
- JIT를 통해 native instruction으로 실행되는 경로가 있다.
- 성능 이점은 hook 위치와 workload 조건을 함께 봐야 한다.
성능 숫자는 나중에 XDP, TC, tracing tool을 다룰 때 별도 실험으로 확인하는 편이 맞다.
Cloud native에서 eBPF가 자주 보이는 이유
Kubernetes에서 eBPF가 자주 등장하는 이유는 container 수 자체보다, namespace·cgroup으로 격리돼도 같은 node의 container들은 결국 같은 kernel을 공유한다는 점에 있다.
여기서 node는 Kubernetes에서 Pod가 실행되는 한 대의 machine이나 VM이고, Pod는 함께 배포·스케줄링되는 하나 이상의 container 묶음이다.
이 구조에서 eBPF 기반 node agent는 이미 떠 있던 process를 포함해 node 위의 모든 process와 이벤트를 하나의 공통 경계에서 본다.
그래서 cloud native 환경에서 eBPF는 observability, security, networking 도구의 기반이 되기 쉽다.
이 node 단위 시야가 Pod 안쪽만 보는 sidecar와 구체적으로 어떻게 다른지는 뒤에서 별도 절로 다룬다.
eBPF로도 못 보는 경계가 있다
예외도 있다.
Kata Containers, Firecracker, unikernel처럼 workload별 kernel 경계가 달라지는 모델에서는 “한 node의 container가 같은 kernel을 공유한다”는 설명이 그대로 적용되지 않는다.
서버리스나 managed container 환경도 내부적으로는 어떤 kernel 위에서 실행되지만, 이 말이 사용자가 그 kernel에 eBPF program을 load할 권한을 갖는다는 뜻은 아니다. eBPF 적용 가능성은 “Linux를 쓰는가”뿐 아니라 “누가 kernel-level 권한을 갖는가”에 달려 있다.
kernel boundary만으로는 보이지 않는 데이터도 있다: business transaction, application log, TLS로 암호화된 payload, 언어 런타임 내부의 symbol 정보가 그렇다.
이런 데이터를 보려면 별도의 복호화 지점이나 런타임 계측이 필요하다.
L7 request context는 Envoy 같은 proxy나 uprobe(user space program의 함수 호출 지점에 동적으로 거는, kprobe의 user space 버전)를 곁들이면 부분적으로 볼 수 있지만, eBPF만으로 kernel boundary에서 바로 얻는 정보는 아니다.
Cilium과 Katran은 이 모델을 보여주는 사례다. Cilium은 Linux networking stack의 BPF hook을 조합해 Kubernetes networking·policy·observability를 구현하고, Meta의 Katran은 XDP와 eBPF로 L4 load balancer forwarding plane을 재구성했다.
같은 Cilium 생태계의 Hubble은 eBPF datapath에서 나온 flow event에 Kubernetes metadata를 붙여 관측성을 제공하고, Tetragon은 process·syscall·file·network event를 이용해 runtime security 영역으로 확장한다.
이 사례는 “eBPF가 빠르다”보다 “kernel event와 hook 위치가 architecture를 바꾼다”는 근거로 읽어야 한다.
Sidecar와 eBPF는 같은 노드에서 서로 다른 범위를 본다
sidecar는 앱 코드를 건드리지 않고 Pod 단위로 로깅·트레이싱·보안·서비스 메시 기능을 넣는 방법이지만, 같은 노드 위에 있어도 자신이 주입된 Pod 안쪽만 본다.
eBPF 기반 node agent는 그 노드가 공유하는 kernel boundary에 hook을 걸어, 붙은 hook 범위 안에서 모든 Pod와 process의 이벤트를 관측한다.
이 그림은 sidecar와 node 단위 eBPF agent가 각각 어떤 범위를 보는지 비교한다.
실선 화살표는 App이나 공격자 프로세스가 만드는 syscall·네트워크 트래픽이 kernel로 향하는 흐름이고, 점선 화살표는 무엇이 무엇을 관측하는지를 나타낸다.
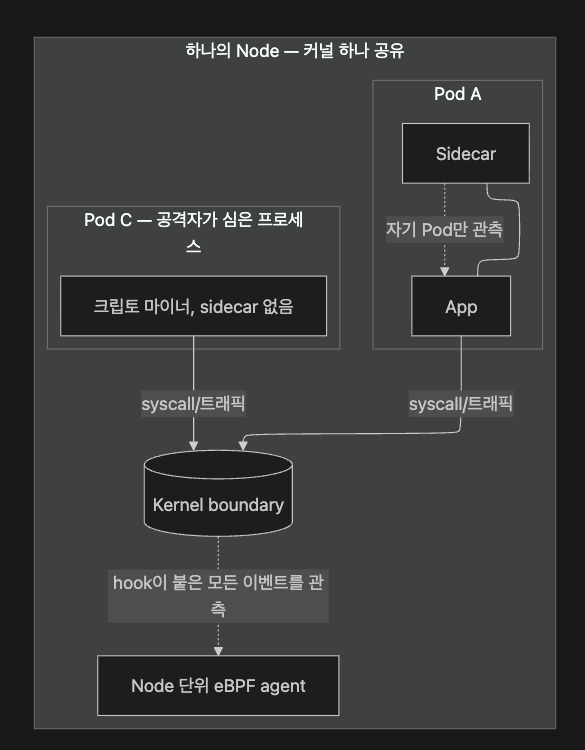
What Is eBPF?가 드는 예시를 빌리면, 공격자가 host에 몰래 심은 암호화폐 채굴 프로그램은 자기 자신에게 보안 sidecar를 붙여주지 않는다.
sidecar 기반 보안 도구는 계측되지 않은 process를 볼 수 없지만, eBPF 기반 node agent는 hook이 붙은 kernel boundary를 지나는 모든 process의 이벤트를 관측하므로 sidecar 우회로는 피하기 어렵다.
sidecar의 배포 비용도 구체적이다.
- Pod 재시작이 필요하다.
- admission controller(Pod가 생성되기 전에 설정을 검사하거나 자동으로 수정하는 Kubernetes 구성요소)가 Pod YAML을 자동 수정하는 방식이라, 라벨을 빠뜨리면 sidecar가 조용히 빠진 채 배포된다.
- 컨테이너별 준비 시점이 달라 시작 순서 race condition도 있었다. 예를 들어 메인 컨테이너가 sidecar보다 먼저 트래픽을 주고받기 시작하면, 그 구간은 sidecar가 아직 준비되지 않아 계측되지 않는 사각지대로 남는다.
Kubernetes 1.33(2025년 4월 GA)의 네이티브 sidecar(initContainers에 restartPolicy: Always)는 메인 컨테이너가 종료된 뒤에 사이드카를 정리하도록 순서를 보장한다. 이 덕분에 시작 순서 race condition뿐 아니라 사이드카가 실행 중이라는 이유만으로 Job 완료가 막히던 문제까지 해소됐다. 다만 Pod 재시작 요구·YAML 주입 실패 위험·service mesh sidecar의 proxy 경유 지연은 그대로 남는다.
다만 eBPF가 sidecar를 대체하는 것은 아니다.
node 단위로 넓게 관측·제어해야 하고 Pod마다 sidecar를 심는 비용이 부담일 때 eBPF가 선택지가 되고, 애플리케이션 맥락을 깊이 알아야 하는 문제는 여전히 sidecar나 application instrumentation의 영역이다.
1주차에서 남길 모델
앞서 본 것들을 판단 기준 하나로 묶으면 이렇다.
- eBPF가 후보가 되는 경우: 문제가 kernel boundary에서 관측하거나 제어할 수 있다. 애플리케이션 수정·재시작, kernel patch, sidecar 주입이 부담이고 privileged node agent를 운영할 여건이 된다.
- 예시는 "이 프로세스가 왜 느린가", "어떤 프로세스가 이 파일에 접근했는가", "예상 밖의 외부 연결이 있었는가" 같은 질문이다.
- eBPF만으로 부족한 경우: 비즈니스 로직, 요청 컨텍스트, 애플리케이션 의미론이 핵심이다. 이때는 application instrumentation이나 sidecar 쪽 정보가 더 필요하다.
이 판단 기준을 만드는 실행 모델 자체를 한 문장으로 줄이면 이렇게 정리된다.
eBPF는 user space에서 올린 제한된 program을 verifier로 검사한 뒤, kernel hook에 attach해 event가 발생할 때 실행하고, map이나 buffer로 user space와 데이터를 교환하는 Linux 커널 실행 모델이다.
- user space loader가 program을 올린다.
bpf()syscall이 kernel과의 진입점이다.- verifier가 load 전에 안전 조건을 검사한다.
- hook/event가 실행 시점을 결정한다.
- helper가 허용된 kernel API 역할을 한다.
- map과 buffer가 kernel program과 user space tool을 연결한다.
이 글에서는 eBPF program을 실제로 어떻게 작성하고 컴파일하는지는 다루지 않았다. verifier가 정확히 어떤 알고리즘으로 program을 거절하는지도 다루지 않았다 — 그 내부 로직이 궁금하면 커널 소스의 kernel/bpf/verifier.c와 Documentation/bpf/verifier.rst부터 읽는 것을 권한다.
다음 질문은 더 구체적이다.
- eBPF program은 어떤 구조로 작성되는가?
- map은 실제 코드에서 어떻게 정의하고 읽는가?
- loader와 userspace code는 어떤 역할을 나눠 갖는가?
- verifier는 어떤 program을 거절하는가?
직접 확인:
-
아래 명령으로 이 글 맨 앞에서 말한 "커널 경계를 지난다"는 말을 직접 눈으로 본다.
strace -e trace=openat,read,close cat /etc/hosts출력에
openat,read,close세 syscall이 보이는가? 이 세 줄이 kernel boundary를 지난 흔적이다. -
man 2 bpf를 열어CAP_BPF요구 조건을 찾아본다. 이 capability 없이 일반 사용자가bpf()를 호출하면 무엇이 반환되는가?
용어
- kernel boundary: 애플리케이션(user space)과 커널(kernel space)이 만나는 경계. syscall이 이 경계를 지나는 대표적인 통로다.
- user space: 하드웨어에 직접 접근할 수 없어 syscall로 kernel에 요청해야 하는 일반 프로그램 실행 영역.
- kernel space: 하드웨어와 시스템 자원을 직접 다루는, 커널이 실행되는 영역.
- syscall: user space program이 kernel 기능을 요청하는 진입점. 파일 열기, 네트워크 송신 같은 작업이 여기를 지난다.
- packet: 네트워크로 오가는 작은 데이터 조각.
- verifier: eBPF program을 load하기 전에 안전 조건을 정적으로 검사하는 kernel component.
- context: hook이 eBPF program을 실행할 때 함께 넘겨주는 입력 데이터. hook 종류에 따라 내용이 다르다(예: network hook은 packet 정보, tracing hook은 레지스터·인자 값).
- hook: kernel 안에서 특정 event가 발생하는 지점. eBPF program은 이 지점에 붙어 실행된다.
- XDP(eXpress Data Path): NIC 드라이버가 packet을 받는 즉시, 커널 network stack에 들어가기 전에 eBPF program을 실행하는 networking hook.
- map: kernel program과 user space가 데이터를 주고받는 공유 상태. 흔한 형태는 key-value 구조지만 array나 ring buffer처럼 다른 형태도 있다.
- helper: eBPF program이 호출할 수 있도록 kernel이 공개한 제한된 API.
- bytecode: program을 kernel이 이해하는 명령어 형태로 옮긴 것. verifier 검사를 거쳐 실행된다.
- JIT(Just-In-Time) compiler: 실행 직전에 bytecode를 native machine instruction으로 변환하는 컴파일 방식.
- capability: Linux에서 root 권한을 세분화한 단위.
CAP_BPF는 privileged BPF operation을 수행할 수 있는 권한이며, Linux 5.8부터CAP_SYS_ADMIN에서 분리됐다. - cgroup: process group의 resource 사용량과 일부 동작을 제한하거나 관찰하는 Linux 기능.
- namespace: process가 보는 filesystem, network, process ID 같은 범위를 분리하는 Linux 기능.
- node: Kubernetes에서 Pod가 실행되는 한 대의 machine이나 VM.
- Pod: Kubernetes에서 함께 배포·스케줄링되는 하나 이상의 container 묶음.
- sidecar: 애플리케이션 container 옆에 붙는 보조 container. 로깅, 프록시, 보안 기능을 대신 맡는 데 자주 쓰인다.
- admission controller: Kubernetes object가 생성되기 전에 설정을 검사하거나 자동으로 수정하는 구성요소.
- LSM(Linux Security Module): 보안 판단 지점에 정책을 끼울 수 있게 하는 kernel framework.
- kprobe: 커널 코드의 거의 모든 지점에 동적으로 걸 수 있는 트랩(trap, 실행 중인 코드를 특정 지점에서 가로채 다른 코드로 넘기는 장치). 단 blacklist·inline 함수, 일부 architecture는 제외. 2005년부터 커널에 있었고, 2015년부터 eBPF program을 붙일 수 있게 됐다.
- uprobe: user space program의 함수 호출 지점에 동적으로 붙는 probe. kprobe가 kernel 함수에 거는 방식을 user space 코드에 적용한 것이다.
- BTF(BPF Type Format): eBPF program과 map의 타입 정보를 담는 metadata 형식. CO-RE 같은 이후 도구들이 program 이식성을 높이는 데 쓰는 토대다.
- Kata Containers / Firecracker: container마다 별도의 경량 VM(과 커널)을 띄워 격리를 강화하는 런타임.
- unikernel: 애플리케이션 코드와 필요한 최소 커널 기능만 하나의 실행 이미지로 합쳐, 범용 커널 없이 그 자체로 부팅되는 모델.
참고 자료
이 글이 다루지 않고 멈춘 지점을 더 파고들고 싶을 때 아래를 목적별로 골라 본다.
공식 정의 — 이 글에서 쓴 용어와 API의 원문을 확인할 때:
- Liz Rice,
Learning eBPF, Chapter 1 - Liz Rice,
What Is eBPF?, O’Reilly, Chapter 1, 2, 3, 5, 6 - Linux kernel BPF docs: https://www.kernel.org/doc/html/latest/bpf/index.html
- Linux
bpf(2)manual: https://man7.org/linux/man-pages/man2/bpf.2.html
역사와 배경 — BPF가 packet filtering에서 지금 모습까지 넓어진 원출처를 확인할 때:
- BSD Packet Filter paper: https://www.tcpdump.org/papers/bpf-usenix93.pdf
- eBPF program을 kprobe에 붙이는 2015년 패치 시리즈(Alexei Starovoitov): https://fa.linux.kernel.narkive.com/AS9ro7f3/patch-v11-tip-0-9-tracing-attach-ebpf-programs-to-kprobes
- Brendan Gregg,
Linux BPF Superpowers: https://www.brendangregg.com/blog/2016-03-05/linux-bpf-superpowers.html - Cilium 프로젝트 발표(2016년 8월, LinuxCon) 관련 Google Open Source 블로그: https://opensource.googleblog.com/2016/11/cilium-networking-and-security.html
내부 동작 — verifier·BTF·capability가 실제로 어떻게 구현됐는지 확인할 때:
- Linux kprobes docs: https://www.kernel.org/doc/html/latest/trace/kprobes.html
- BPF Type Format(BTF) 커널 문서: https://docs.kernel.org/bpf/btf.html
- LSM BPF program 커널 문서: https://docs.kernel.org/bpf/prog_lsm.html
- Linux
capabilities(7)manual (CAP_BPF범위): https://man7.org/linux/man-pages/man7/capabilities.7.html
실제 사례와 운영 — 이 모델을 쓰는 프로젝트와 sidecar 비교를 더 볼 때:
- Brendan Gregg,
BPF Performance Tools, Chapter 1-2 - Cilium eBPF datapath docs: https://docs.cilium.io/en/stable/network/ebpf/intro/
- Cilium overview docs (Kubernetes networking/observability): https://docs.cilium.io/en/stable/overview/intro/
- Meta Katran post: https://engineering.fb.com/2018/05/22/open-source/open-sourcing-katran-a-scalable-network-load-balancer/
- Kubernetes Sidecar Containers 공식 문서 (v1.33 GA,
restartPolicy: Always): https://kubernetes.io/docs/concepts/workloads/pods/sidecar-containers/
안녕하세요~
오늘도 즐겁게 잘 읽었습니다~
다만 몇가지 사항에 대해서 코멘트 남기고 싶은게 있습니다.
쿠버네티스는 네이티브 사이드카 컨테이너(initContainers에 restartPolicy: Always) 기능이 GA 돼서, eBPF는 재시작이 필요 없고 사이드카는 필요하다는 대비는 여전히 유효하지만, 사이드카 쪽의 주입 이후 라이프사이클 문제(Job 완료 차단, 종료 순서 등)는 플랫폼 레벨에서 상당 부분 해소된 부분이 있지 않나 싶습니다.
결국 해당 책이 지필됐을시에 k8s가 성숙도가 낮은 상태에서의 비교였다고 느끼는 부분이 있습니다.
실제 Istio를 운영하시는 입장에서 이 구분이 어떻게 느껴지시는지 궁금합니다.