컴파일된 eBPF 오브젝트 파일(.o)에 미리 서명해 두면, 커널은 로드할 때 그 서명을 확인할 수 있을까.
2022년 말에 쓰인 책의 답은 "쉽지 않다"였다.
이유는 암호학이 아니었다. 사용자 공간 로더가 map 위치와 CO-RE 정보로 프로그램을 고친 뒤에 커널에 올리기 때문이다. 책은 이것이 서명 관점에서는 악의적 수정과 구분하기 어렵다고 썼다.
9주차 끝에서 "언어별 라이브러리는 커널 쪽 보장을 얼마나 드러내는가"를 물었다. 10장이 소개하는 라이브러리들을 열어 보면 공통으로 하는 일이 하나 있다. 바로 이 "고쳐 쓰기"다. 그리고 11장이 미해결로 남긴 서명 문제는 2025년 커널 6.18에서, 고쳐 쓰기를 커널 안으로 옮기는 방식으로 풀렸다.
이 글을 읽고 나면 다음을 설명할 수 있어야 한다.
- bpftrace는 책 설명과 달리 지금 무엇 위에서 도는가
- 로더는
BPF_PROG_LOAD직전에 바이트코드의 어느 필드에 무엇을 써 넣는가 - ebpf-go, Aya, libbpfgo, libbpf-rs는 그 고쳐 쓰기를 누가 구현하는가
- 책이 소개한 라이브러리와 예제 코드는 2026년에 어떤 상태인가
- 서명은 왜 어려웠고, 6.18은 그 문제를 어떤 구조로 풀었는가
- 책의 나머지 예측(kptr, 메모리 할당, Windows, 표준화)은 어떻게 됐는가
이 글에서 "2026년 현재"는 조사 시점에 고정한 Linux v7.2와 각 출처의
조사 결과를 뜻한다. v7.2 이후의 개발 중인 변경은 이 글의 현재 판정에
포함하지 않는다.
1절은 가장 높은 추상화인 bpftrace에서 출발한다. 2~3절은 로더가 하는 일을 실제 바이트 수준으로 본 뒤 라이브러리별 구현 위치를 비교하고, 4~5절은 책의 목록과 예제를 현재 기준으로 채점한다. 6~7절은 2절의 고쳐 쓰기가 서명을 어떻게 막았고 어떻게 풀렸는지를 실측과 함께 따라가며, 8~9절은 나머지 예측과 책 이후의 변화를 정리한다.
1. bpftrace는 무엇을 감추고, 지금은 무엇 위에서 도는가
책은 eBPF 프로그래밍을 두 부분으로 나눈다.
커널에서 도는 eBPF 프로그램, 그리고 그 프로그램을 관리하고 상호작용하는 사용자 공간 코드다.
bpftrace는 이 구분을 사용자에게서 감추는 가장 높은 추상화다(p.185). 책은 bpftrace 절 끝에서 bpftrace가 BCC 위에 만들어졌고, 스크립트가 BCC 프로그램으로 변환된 뒤 런타임에 LLVM/Clang으로 컴파일된다고 쓴다(p.188).
이 설명은 책이 출간되기 전에 이미 바뀌어 있었다.
bpftrace는 2022년 6월 PR #2265("Move from bcc to libbpf")로 BCC 대신 libbpf를 쓰기 시작했고, 이 변경은 2022년 8월 v0.16.0에 들어갔다. 전환은 한 번에 끝나지 않았다. 프로그램과 map을 libbpf의 bpf_object 단위로 올리는 변경은 2024년 7월 커밋("Load BPF programs and maps via libbpf bpf_object")으로 v0.22.0에 들어갔다. 2026년 9월에 나온 v0.27.0의 README는 "LLVM을 컴파일러 백엔드로, libbpf를 BPF 서브시스템과의 상호작용에" 쓴다고 설명한다.
그렇다고 BCC를 완전히 뗀 것도 아니다.
v0.27.0의 CMakeLists.txt는 여전히 find_package(LibBcc REQUIRED)를 요구한다. 그래서 정확한 서술은 "커널과 대화하는 부분은 libbpf가 맡고, 빌드에는 아직 libbcc가 필요하다"이다. BCC가 지금 정확히 어떤 기능에 쓰이는지는 이 글에서 코드로 확인하지 않았다.
bpftrace를 쓰는 사람은 이 변화를 알아차릴 필요가 없다. 그게 bpftrace가 감추는 것이다. 감춰진 아래층, 즉 사용자 공간 로더가 실제로 무슨 일을 하는지는 다음 절에서 바이트 수준으로 본다.
2. 로더는 BPF_PROG_LOAD 직전에 무엇을 써 넣는가
아래는 이 글의 실측에 쓴 최소 프로그램이다. map 하나를 조회하고, task_struct의 필드 하나를 CO-RE로 읽는다.
/* lab/hello.bpf.c 발췌 */
struct {
	__uint(type, BPF_MAP_TYPE_HASH);
	...
} counter SEC(".maps");

SEC("tracepoint/syscalls/sys_enter_execve")
int hello(void *ctx)
{
	struct task_struct *t = (void *)bpf_get_current_task();
	u32 tgid = BPF_CORE_READ(t, tgid);   /* CO-RE 재배치 대상 */
	...
	v = bpf_map_lookup_elem(&counter, &tgid); /* map fd 재배치 대상 */
이 파일을 clang으로 컴파일한 .o와, 로드한 뒤 커널이 보여 주는 프로그램을 같은 명령어 위치에서 비교하면 다음과 같다(커널 7.0, bpftool v7.7.0).
.o (llvm-objdump)       11: r1 = 0x0 ll        ; ELF 재배치 레코드: R_BPF_64_64 counter
로드 후 (bpftool xlated) 11: (18) r1 = map[id:51]
첫 줄의 r1 = 0x0 ll은 64비트 즉치값을 레지스터에 넣는 명령어다. 값이 0인 이유는 컴파일러가 counter map이 어디 있을지 모르기 때문이다. 대신 ELF에 "이 자리는 counter를 가리켜야 한다"는 재배치 레코드를 남긴다. 이 자리를 빈칸이라고 부르겠다.
둘째 줄은 같은 명령어가 커널 안에서 특정 map을 가리키게 바뀐 모습이다. 빈칸을 채우는 일은 두 단계로 나뉜다. 사용자 공간 로더가 빈칸에 map fd를 적고, 커널 verifier가 그 fd를 실제 map 포인터로 바꾼다. bpftool은 그 포인터를 map id로 보여 준다.
libbpf에서 첫 단계를 하는 함수는 bpf_object__relocate_data()다.
/* src/libbpf.c, libbpf v1.7.0, bpf_object__relocate_data() 6367-6379행 */
case RELO_LD64:
	map = &obj->maps[relo->map_idx];
	if (obj->gen_loader) {
		insn[0].src_reg = BPF_PSEUDO_MAP_IDX;
		insn[0].imm = relo->map_idx;
	} else if (map->autocreate) {
		insn[0].src_reg = BPF_PSEUDO_MAP_FD;
		insn[0].imm = map->fd;
	} else {
...일반적인 경우(else if 분기)에는 명령어의 src_reg 필드에 "이 즉치값은 map fd다"라는 표시(BPF_PSEUDO_MAP_FD)를 하고, imm 필드에 이 프로세스의 map fd 번호를 적는다. 첫 번째 if (obj->gen_loader) 분기는 7절의 light skeleton이 쓰는 경로다. 거기서는 fd 대신 map의 인덱스를 적는다. 이 차이가 서명 문제를 푸는 열쇠가 된다.
map 참조만 빈칸인 것은 아니다. 같은 함수와 CO-RE 처리 함수가 채우는 빈칸을 종류별로 모으면 다음과 같다.
| 재배치 종류 | 무엇을 가리키는가 | 명령어에 써 넣는 값 | 처리 위치(libbpf v1.7.0) |
|---|---|---|---|
RELO_LD64 | map | src_reg=BPF_PSEUDO_MAP_FD, imm=map fd | bpf_object__relocate_data() |
RELO_DATA | 전역 변수(.data/.bss 등) | src_reg=BPF_PSEUDO_MAP_VALUE, map fd + 오프셋 | 같은 함수 |
RELO_EXTERN_LD64(typed ksym) | 커널 변수 | src_reg=BPF_PSEUDO_BTF_ID, 커널 BTF ID + BTF obj fd | 같은 함수 |
RELO_EXTERN_CALL | kfunc | src_reg=BPF_PSEUDO_KFUNC_CALL, BTF ID + fd 배열 인덱스 | 같은 함수 |
| CO-RE | 구조체 필드 오프셋 등 | 대상 커널 BTF로 계산한 값 | bpf_object__relocate_core()의 resolve, patch 두 단계 |
표의 값에는 공통점이 있다. map fd, BTF obj fd, 대상 커널의 필드 오프셋은 모두 그 호스트에서 로드하는 순간에만 정해진다. 같은 .o를 두 번 로드해도 fd 번호가 다를 수 있고, 다른 커널에 올리면 CO-RE 오프셋이 달라질 수 있다. 위 실측에서 tgid 오프셋이 .o(0x774)와 로드 후(1908)에 같은 값인 것은, vmlinux.h를 같은 커널에서 뽑았기 때문이다.
순서에도 작은 장치가 있다. libbpf의 bpf_object_prepare()는 map을 만들기 전에 재배치부터 한다.
resolve_externs → relocate(빈칸에 fd 기록) → BTF 로드 → create_maps → prepare_progs
                         ↑                                  ↓
          placeholder memfd로 fd 번호를 먼저 확보   실제 map을 같은 번호에 덮어씀(reuse_fd)
map이 아직 없는데 fd를 적을 수 있는 이유는, map 객체를 만들 때 memfd로 fd 번호부터 맡아 두고 나중에 실제 map을 그 번호에 앉히기 때문이다.
BPF 메인테이너 Alexei Starovoitov는 LPC 2022 발표에서 이 역할을 한 줄로 "libbpf is a linker"라고 표현했다. 함수를 붙이고 참조를 확정한다는 점에서 링커가 맞다.
다만 이 비유는 한 지점에서 깨진다. 보통 링커는 오프라인에서 결과 파일을 만들고, 그 결과 파일에 서명할 수 있다. eBPF 로더가 확정하는 값은 대상 호스트에서 로드하는 순간에만 존재한다. 그래서 사용자 공간이 빈칸을 채워 넘기는 일반 경로에서는, 확정된 결과물에 미리 서명해 둘 방법이 없다. 6절에서 이 지점으로 돌아온다.
같은 발표는 CO-RE에 대해서도 선을 긋는다. CO-RE, kconfig, 타입 정보로 이식성을 얻지만 "It's not guaranteed"이고, 이식성을 유지하려면 프로그램을 고쳐야 할 수 있다고 했다. CO-RE는 필드 오프셋 차이를 로드 시점에 맞춰 줄 뿐, 대상 커널에 없는 helper나 kfunc, 프로그램 타입까지 만들어 주지는 않는다.
3. 같은 빈칸, 누가 채우는가: 위임과 재구현
책도 라이브러리를 두 갈래로 나눴다.
ebpf-go는 CO-RE 지원을 포함해 "purely in Go"로 구현됐고, Aya는 libbpf에 의존하지 않고 syscall 수준까지 Rust로 만들었다. 반대로 libbpfgo는 libbpf C 코드를 감싼 Go 래퍼이고, libbpf-rs는 libbpf의 Rust 래퍼다. 책은 libbpfgo에 대해 CGo 경계가 성능 등의 문제를 낳을 수 있다는 우려도 적었다(p.193-197).
이 분류는 2026년 소스에서도 그대로다. 2절의 빈칸을 누가 채우는지로 다시 정리하면 다음과 같다.
| 라이브러리 | 빈칸을 채우는 코드 | 근거(태그 기준 소스) |
|---|---|---|
| libbpf(C) | libbpf 자신 | bpf_object__relocate_data(), bpf_object__relocate_core() (v1.7.0) |
| libbpfgo(Go) | 링크된 C libbpf(시스템 공유 라이브러리 또는 정적 vendoring). Go는 CGo로 bpf_object__load()를 호출 | module.go의 C.bpf_object__load(m.obj), README의 dynamic/static 빌드 (v0.11.0-libbpf-1.8-dev-2bbc483) |
| libbpf-rs(Rust) | C libbpf(기본값은 vendored libbpf). Rust는 FFI로 같은 함수 호출 | object.rs의 libbpf_sys::bpf_object__load(...) (v0.27.2) |
| ebpf-go(Go) | Go로 재구현. CO-RE 코드는 "derived from libbpf"라고 명시 | btf/core.go, linker.go의 applyRelocations, fixupKfuncs → sys.ProgLoad (v0.22.0) |
| Aya(Rust) | Rust로 재구현. libbpf·bcc 비의존 | aya-obj/src/relocation.rs가 BPF_PSEUDO_MAP_FD와 fd를 기록 (aya-obj-v0.3.0) |
Aya의 map 재배치 코드는 libbpf와 같은 빈칸에 같은 종류의 값을 적는다.
/* aya-obj/src/relocation.rs, aya-obj-v0.3.0, 263-268행 발췌 */
instructions[ins_index].set_src_reg(BPF_PSEUDO_MAP_FD as u8);
...
instructions[ins_index].imm = *fd;
소스 - aya-obj/src/relocation.rs#L263-L268
이 구분은 취향 문제가 아니다. 래퍼(libbpfgo, libbpf-rs)의 재배치 기능과 버그는 실제로 링크된 libbpf 버전을 그대로 따라간다. libbpf-rs는 기본값이 vendored libbpf이고, libbpfgo는 시스템 libbpf에 동적으로 링크하거나 정적으로 넣는 방식을 고를 수 있다. 재구현(ebpf-go, Aya)은 알고리즘의 출처가 libbpf라도 코드가 별개라서, 새 재배치 종류나 커널 기능을 지원하는 시점이 libbpf와 다를 수 있다. 구체적인 시차 사례는 이 글에서 조사하지 않았다.
커널 쪽 코드를 무엇으로 컴파일하는지도 갈린다. C는 Clang이 주류이고, Aya는 rustc의 BPF 타깃으로 커널 쪽 코드까지 Rust로 쓴다. 여기서 Aya의 libbpf 비의존은 로더 구현에 대한 설명이다. 커널 쪽 프로그램의 빌드 도구 체인까지 LLVM과 무관하다는 뜻으로 확대하면 안 된다. 책은 GCC도 버전 10부터 eBPF를 지원하지만 LLVM 대비 공백이 있다고 했다(p.191). 2024년 9월 LWN 보도에 따르면 GCC BPF 백엔드는 커널 테스트 케이스를 모두 컴파일할 수 있지만 아직 전부 올바르게 돌지는 않았고, CO-RE selftest는 GCC 빌드로 통과했다. 2025년 LSF/MM/BPF의 BPF CI 발표도 GCC가 selftest를 .bpf.o로 빌드하는 데는 성공하지만 "About half of the tests fail, so we don't run them yet"이라고 했다. 남은 공백이 "컴파일할 수 있는가"에서 "만든 코드가 verifier를 통과하고 올바르게 도는가"로 옮겨 간 것이다. 실패 원인별 내역은 발표에 나오지 않는다. 이 수치는 2025년 발표 시점의 관찰이고, 2026년 현재 실패율은 확인하지 않았다.
4. 책의 라이브러리 목록을 2026년에 다시 보면
책은 몇 가지 판정을 남겼다. gobpf는 한동안 유지보수되지 않았고 deprecate 논의가 있다. ebpf.io 분류에서 Aya는 "emerging", redbpf는 major 프로젝트였지만, 흐름은 Aya 쪽으로 옮겨 가는 것 같다(p.193, p.197).
2026-10-02에 GitHub API로 각 저장소를 조회한 결과는 아래와 같다. 판정은 archived 여부, README 문구, 마지막 릴리스와 푸시 날짜로만 내렸다. 스타 수는 판정에 쓰지 않았다.
| 라이브러리 | 2026년 판정 | 근거 신호 |
|---|---|---|
| redbpf | 종료(공식 아카이브) | archived=true, 마지막 릴리스 v2.3.0(2022-01), 기본 브랜치 마지막 커밋 2022-12 |
| rust-bcc | 종료(공식 비유지보수 선언) | archived=false, README "Warning! Unmaintained!", 마지막 커밋 2023-10 |
| gobpf | 선언 없는 휴면 | archived=false, deprecation 문구 없음, GitHub 릴리스 없음(최신 태그 v0.2.0), 기본 브랜치 마지막 커밋 2022-10 |
| ebpf-go(cilium/ebpf) | 활동 중 | v0.22.0(2026-06) |
| libbpfgo | 활동 중 | v0.11.0-libbpf-1.8-dev-2bbc483(2026-07) |
| libbpf-rs | 활동 중 | v0.27.2(2026-09) |
| Aya | 활동 중 | aya-ebpf-v0.2.1(2026-06), aya-v0.14.0 |
| BCC(Python/Lua/C++ 바인딩), libbpf-tools | 활동 중 | v0.37.0(2026-07). 바인딩과 libbpf-tools는 별도 릴리스 없이 BCC 저장소 하나에 있어, 바인딩별 상태는 따로 판정하지 않았다 |
| libxdp(xdp-tools) | 활동 중 | v1.6.3(2026-03) |
보조 신호로 ebpf.io의 현재 인프라 목록도 봤다. Go 라이브러리로 ebpf-go와 libbpfgo, Rust 라이브러리로 Aya와 libbpf-rs가 올라 있고, gobpf, redbpf, rust-bcc는 없다. 미등재가 곧 폐기 선언은 아니어서 판정에는 위 신호와 함께만 썼다.
책의 예측은 맞았다. Rust 쪽은 redbpf가 아카이브되고 Aya가 남았다. 책이 인용한 ebpf.io의 "emerging" 분류도 지금은 의미가 없다. Aya는 ebpf-go 등과 나란히 언어별 라이브러리로 올라 있다. 다만 "죽었다"에도 종류가 셋이다. gobpf를 "deprecated"라고 쓰면 근거보다 강한 서술이 된다. gobpf에 남은 근거는 기본 브랜치에 2022년 10월 이후 커밋이 없다는 사실뿐이다.
예제 코드도 바뀌었다. 아래는 책 코드와 현재 문서·API가 다른 지점이다. 실제로 로드가 막히는 것은 legacy map을 libbpf 1.0 이상으로 올릴 때이고, Aya의 Bpf는 deprecated 경고를 낸다. 나머지는 권장 표기와 호출 방식이 바뀐 것이다.
| 상태 | 책 원문 서술 | 실제(2026-10 기준) | 근거 |
|---|---|---|---|
| 표기 변경 | // +build ignore(p.193, 책도 //go:build로 전환 중이라고 언급) | ebpf-go 문서는 //go:build ignore | ebpf-go Getting Started |
| 호출 방식 변경 | go run github.com/cilium/ebpf/cmd/bpf2go -cc $BPF_CLANG ...(p.193) | go get -tool .../bpf2go로 설치 후 go tool bpf2go ... | ebpf-go Getting Started |
| 지원 제거(libbpf) | struct bpf_map_def SEC("maps") kprobe_map(p.194) | libbpf 1.0부터 legacy SEC("maps") 제거, BTF 기반 SEC(".maps")만 지원. ebpf-go v0.22.0은 아직 maps 섹션을 파싱 | libbpf wiki "the road to v1.0", ebpf-go elf_reader.go |
| 이름 변경 | Aya Bpf::load(...)(p.198) | Aya 0.13.0(2024-10)에서 Bpf를 Ebpf로 이름 변경. Bpf는 deprecated 별칭으로 남음 | aya CHANGELOG.md, aya/src/bpf.rs |
| 매크로 변경 | Aya #[xdp(name="myapp")](p.198) | #[xdp]는 이름 인자 없이 섹션을 xdp로 정하고, 프로그램 이름은 함수 식별자에서 얻음 | aya-ebpf-macros xdp.rs |
세 번째 행은 로더마다 판정이 다르다는 점에서 2~3절과 이어진다. 같은 .o를 libbpf 1.0 이상은 거부하고 ebpf-go는 받아 준다. 재구현 라이브러리가 libbpf와 별개 코드라는 것이 실제 동작 차이로 드러나는 사례다.
5. BPF_PROG_RUN과 여러 프로그램: 테스트 명령이 로더가 되기까지
책은 프로그램을 테스트하는 수단으로 BPF_PROG_RUN을 소개하면서, 이 명령이 "주로 네트워킹 관련인 일부 프로그램 타입"에서만 동작한다고 썼다(p.199).
v7.2 커널에서 .test_run 콜백이 등록된 타입을 세면, skb 계열·XDP·flow_dissector·sk_lookup 같은 네트워킹 타입에 더해 raw_tracepoint(CONFIG_NET일 때), tracing(fentry/fexit 등), syscall, struct_ops(CONFIG_NET일 때), netfilter가 있다.
책을 쓰던 무렵의 커널(v6.1)과 비교하면 책의 서술은 당시에도 좁았다. tracing, raw_tracepoint, syscall, struct_ops는 v6.1에 이미 .test_run이 있었다. 책 이후 새로 생긴 것은 netfilter(v6.4) 하나이고, LWT_SEG6LOCAL은 v6.9에는 있었지만 v7.2에서는 빠졌다.
반대로 kprobe_prog_ops, tracepoint_prog_ops, perf_event_prog_ops는 v7.2에서도 비어 있다. 책의 hello world 같은 kprobe 프로그램은 지금도 BPF_PROG_RUN으로 돌려 볼 수 없다.
/* kernel/trace/bpf_trace.c, v7.2 */
const struct bpf_prog_ops kprobe_prog_ops = {
};
...
const struct bpf_prog_ops tracing_prog_ops = {
	.test_run = bpf_prog_test_run_tracing,
};
소스 - kernel/trace/bpf_trace.c#L1400-L1401, #L1839-L1841
여러 프로그램을 한 로더가 다루는 예로 책은 opensnoop을 든다. open과 openat의 진입·종료 tracepoint 4개에 프로그램을 붙이고, libbpf-tools 버전은 한 사용자 공간 프로그램이 네 개를 모두 올린다(p.200).
현재 libbpf-tools의 opensnoop(bcc v0.37.0)은 openat2 짝이 더해져 프로그램이 6개다. 그리고 6개를 항상 다 올리지 않는다. 로드 직전에 bpf_program__set_autoload(..., false)로 이 커널에 없는 짝을 끈다. 한 로더가 여러 프로그램을 들고 있다가 대상 커널에 맞는 것만 고르는 셈이다.
이 절을 따로 둔 이유는 BPF_PROG_RUN이 7절에 다시 나오기 때문이다. light skeleton은 커널 안에서 실행될 "loader 프로그램"을 SYSCALL 타입으로 올린 뒤, 바로 이 BPF_PROG_RUN으로 한 번 실행한다. 위 목록에 syscall 타입이 있는 것도 이와 맞물린다. 책에서 테스트 도구로 소개된 명령이 로더의 실행 장치로 쓰이는 것이다.
6. 서명은 왜 어려웠나: 서명한 바이트와 올라가는 바이트가 다르다
책의 서술을 다시 보자. 커널이 검증 단계에서 서명을 확인할 수 있을 것 같지만, 로더가 map 위치와 CO-RE 정보로 프로그램을 동적으로 고치기 때문에 쉽지 않다(p.206).
6.18 이후 커널이 서명으로 검증하는 대상을 보면 이 말이 정확히 무엇을 뜻하는지 드러난다.
/* kernel/bpf/syscall.c, v7.2, bpf_prog_verify_signature() 2935-2939행 */
bpf_dynptr_init(&insns_ptr, prog->insnsi, BPF_DYNPTR_TYPE_LOCAL, 0,
		prog->len * sizeof(struct bpf_insn));

err = bpf_verify_pkcs7_signature((struct bpf_dynptr *)&insns_ptr,
				 (struct bpf_dynptr *)&sig_ptr, key);
소스 - kernel/bpf/syscall.c#L2935-L2939
검증 대상은 사용자가 BPF_PROG_LOAD로 넘긴 명령어 버퍼 전체(prog->insnsi부터 prog->len개)다. 서명은 "이 바이트가 서명 당시와 한 비트도 다르지 않다"를 증명한다. 그런데 2절에서 본 것처럼 일반 로더가 넘기는 버퍼에는 이번 실행의 map fd와 이 커널의 CO-RE 오프셋이 이미 적혀 있다. 빌드할 때 서명한 .o의 바이트와, 로드할 때 커널이 받는 바이트가 다르다.
그래서 어려움의 원인은 서명 알고리즘이 아니다. 커널이 쓰는 것은 표준 PKCS7 서명 검증이다. 문제는 "무엇에 서명하는가"였다. 2절의 링커 비유가 깨지는 지점이 바로 여기다. 결과물이 로드하는 순간에만 확정되니, 확정된 결과물에는 미리 서명할 수 없다.
빌드 시점에 서명할 바이트가 아예 없는 경우도 있다. 서명 설계를 맡은 KP Singh은 LWN이 정리한 논쟁에서 이렇게 말했다. Cilium처럼 신뢰된 BPF 프로그램을 스스로 생성하는 사용 사례가 많으므로 "trusted loaders are an inevitability and a requirement for signing support"라는 것이다.
이 방향의 준비는 책보다 먼저 시작됐다. 2021년 12월 Alexei Starovoitov의 패치 세트가 BPF_PROG_LOAD에 CO-RE 재배치 레코드를 넘기는 인터페이스를 추가했고(v5.17부터 uapi에 core_relo_cnt가 있다), LWN은 이것을 "an explicit prerequisite to BPF signing"이라고 설명한다. CO-RE 계산을 커널이 대신할 수 있으면, 사용자 공간이 바이트를 고칠 이유가 하나 줄어든다.
7. 6.18의 해법: 빈칸을 채우는 loader에 서명한다
해법의 재료는 light skeleton이다. bpftool gen skeleton -L로 만드는 이 skeleton은 일반 skeleton과 로드 방식이 다르다.
/* src/skel_internal.h, libbpf v1.7.0, bpf_load_and_run() 발췌 (353-420행) */
err = map_fd = skel_map_create(BPF_MAP_TYPE_ARRAY, "__loader.map", 4, opts->data_sz, 1,
			       opts->excl_prog_hash, opts->excl_prog_hash_sz);
...
err = skel_map_freeze(map_fd);
...
attr.prog_type = BPF_PROG_TYPE_SYSCALL;
...
attr.signature = (long) opts->signature;
...
err = skel_sys_bpf(BPF_PROG_RUN, &attr, test_run_attr_sz);
소스 - src/skel_internal.h#L353-L420
사용자 공간이 하는 일은 세 가지뿐이다. 실제 프로그램과 map의 정의(메타데이터)를 __loader.map에 넣고, SYSCALL 타입의 loader 프로그램을 올리고, 그 loader를 BPF_PROG_RUN으로 한 번 실행한다. 실제 map 생성과 프로그램 로드는 loader가 커널 안에서 bpf_sys_bpf 헬퍼로 한다.
loader를 만들 때 libbpf는 2절의 빈칸을 다르게 다룬다. map 참조에는 fd 대신 map 인덱스(BPF_PSEUDO_MAP_IDX)를 적고, CO-RE는 계산하지 않고 재배치 레코드만 기록해 커널로 넘긴다. 커널이 다른 계산기를 쓰는 것은 아니다. 커널의 kernel/bpf/relo_core.c는 tools/lib/bpf/relo_core.c를 그대로 include해, libbpf와 같은 CO-RE 코드를 커널 안에서 실행한다.
그래서 loader 명령어와 메타데이터에는 이 호스트, 이번 실행에만 정해지는 값이 하나도 들어가지 않는다. map 자리에도 빈칸은 있지만, 거기 적히는 것은 호스트와 무관한 인덱스다. 빌드할 때 만든 바이트가 로드할 때도 그대로다. 서명할 수 있는 대상이 생긴 것이다. LWN은 머지된 방식을 "relocation이 필요 없는 loader를 먼저 올리고, 그래서 커널이 그 서명을 직접 확인할 수 있다"고 요약한다.
실측에서 이 차이는 strace로 바로 보인다. 같은 hello.bpf.o를 두 방식으로 올렸을 때 사용자 공간의 bpf() 호출은 다음과 같다.
[일반 skeleton]  ... 기능 탐지용 PROG_LOAD/BTF_LOAD 다수 ...
                 BPF_BTF_LOAD → BPF_MAP_CREATE(counter) → BPF_PROG_LOAD(hello, insn_cnt=28) → BPF_LINK_CREATE
[light skeleton] BPF_MAP_CREATE(__loader.map) → BPF_MAP_UPDATE_ELEM
                 → BPF_PROG_LOAD(SYSCALL, insn_cnt=134) → BPF_PROG_TEST_RUN
이 light skeleton은 VM의 시스템 헤더(서명 필드가 없는 이전 버전 skel_internal.h)로 빌드했다. 위에 발췌한 v1.7.0 헤더는 여기에 freeze와 해시 요청을 더 호출하는데, 그 모습은 아래 서명 실측에서 보인다.
light skeleton 쪽에는 counter map을 만드는 호출도, hello를 올리는 호출도 없다. 그런데 loader가 실행된 뒤 bpftool로 보면 hello 프로그램과 counter map이 커널에 있다. strace에 안 보이는 두 호출이, 빈칸 채우기가 커널 안으로 옮겨 갔다는 증거다.
BPF_PROG_TEST_RUN은 5절의 BPF_PROG_RUN과 같은 명령 번호다(uapi에 BPF_PROG_RUN = BPF_PROG_TEST_RUN으로 정의돼 있다). 이 비교는 로드 단계만 본 것이고 attach 단계는 비교하지 않았다. 기능 탐지 호출의 수 같은 세부값은 커널과 libbpf 버전마다 달라질 수 있다.
로드 성공과 자동 attach 성공은 별개다. bpftool v7.7.0이 생성하는 light skeleton의 자동 attach 코드는 RAW_TRACEPOINT, TRACING, LSM 계열만 처리하고, 그 밖의 프로그램 타입에는 auto-attach not supported를 생성한다. 실습의 tracepoint/syscalls/sys_enter_execve 프로그램은 light skeleton에서 로드 비교에는 쓸 수 있지만, 이 코드 생성기가 자동으로 attach해 주는 사례는 아니다. 따라서 이 실습의 strace 비교는 로드 단계 비교로 한정하고, attach 성공은 별도로 확인해야 한다.
loader를 조립 로봇에 비유하면 이렇다. 일반 skeleton은 사용자 공간이 부품을 조립해 커널에 납품한다. light skeleton은 조립 로봇을 커널에 들여보내고, 로봇이 커널 안에서 조립한다. 다만 로봇도 BPF 프로그램이라 verifier를 통과해야 하고, 로봇이 만든 프로그램들도 각자 verifier를 다시 통과한다. 커널 안에서 만든다고 검사가 면제되지는 않는다.
6.18은 이 구조 위에 서명을 얹었다. 서명 체계를 처음부터 끝까지 따라가면 아래 그림과 같다.
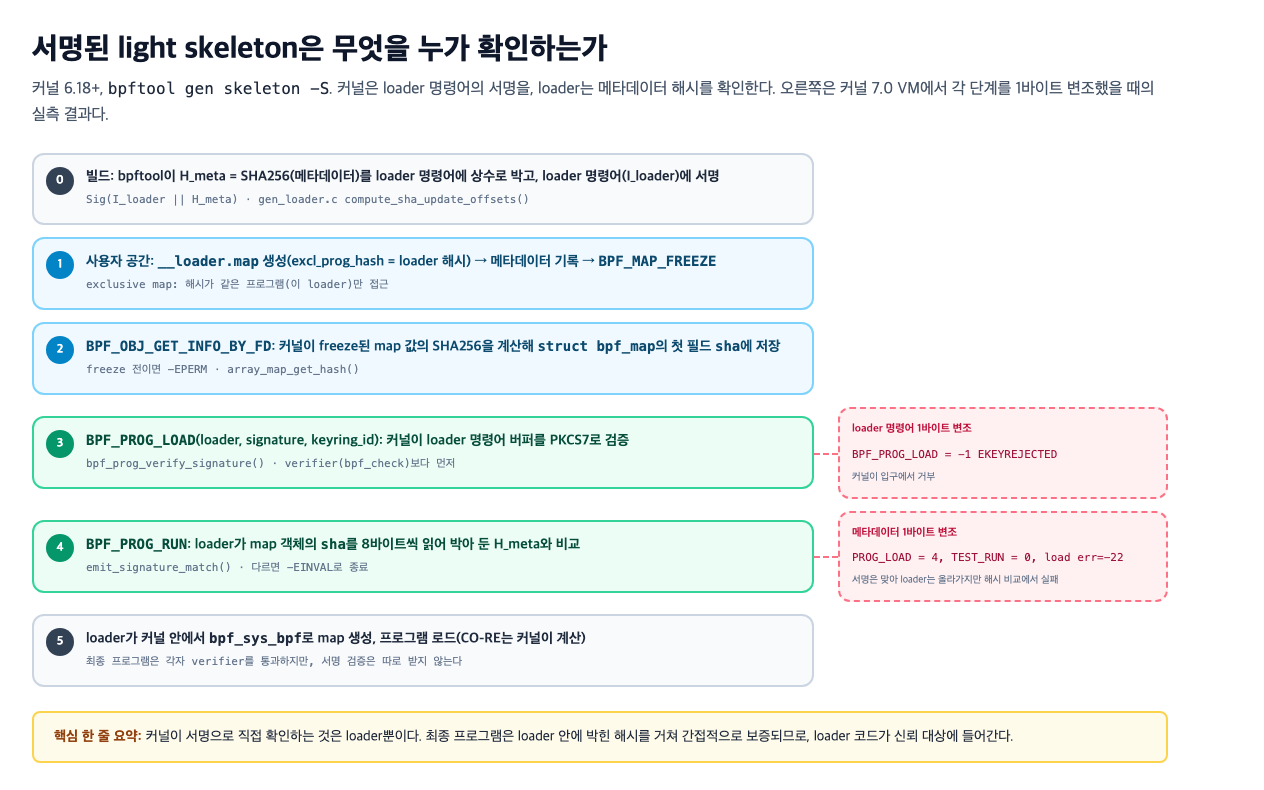
단계별로 근거를 붙이면 다음과 같다.
첫째, 커널이 확인하는 것은 loader 명령어다. 이 기능은 v6.18에 도입됐다. 아래 구현은 v7.2 소스에서 확인한 것으로, bpf_attr의 signature, signature_size, keyring_id를 사용하고 bpf_prog_verify_signature()가 loader의 명령어 버퍼를 검증한다. 이 검증은 사용자 버퍼를 복사한 직후, verifier(bpf_check())가 명령어를 고치기 전에 실행된다. 책은 해결 위치를 "perhaps as part of the verification step"이라고 짐작했지만, 실제로는 verifier 이전의 별도 단계다.
둘째, 메타데이터는 loader가 확인한다. 빌드할 때 bpftool이 호출하는 libbpf의 loader 생성 코드(gen_loader.c의 compute_sha_update_offsets())가 메타데이터의 SHA256을 계산해 loader 명령어 안에 상수로 박는다. libbpf 커밋은 이 계약을 Sig(I_loader || H_meta)로 표기한다. 서명은 loader 명령어(I_loader)를 덮고, 그 안에 메타데이터 해시(H_meta)가 들어 있으니 메타데이터도 간접적으로 덮인다.
로드할 때 비교할 해시는 커널이 계산한다. 사용자 공간은 __loader.map을 freeze한 뒤 BPF_OBJ_GET_INFO_BY_FD로 map의 해시를 요청한다. 커널은 freeze된 map에 대해서만 값 전체의 SHA256을 계산해 struct bpf_map의 첫 필드 sha에 저장하고, freeze되지 않았으면 -EPERM을 돌려준다. 그리고 6.18의 exclusive map 기능으로, map을 만들 때 지정한 해시(excl_prog_hash)와 같은 프로그램, 즉 이 loader만 그 map에 접근할 수 있게 한다.
/* src/gen_loader.c, libbpf v1.7.0, emit_signature_match() 발췌 (583-604행) */
emit2(gen, BPF_LD_IMM64_RAW_FULL(BPF_REG_1, BPF_PSEUDO_MAP_IDX, 0, 0, 0, 0));
emit(gen, BPF_LDX_MEM(BPF_DW, BPF_REG_2, BPF_REG_1, i * sizeof(__u64)));
...
emit(gen, BPF_MOV64_IMM(BPF_REG_7, -EINVAL));
emit(gen, BPF_JMP_REG(BPF_JNE, BPF_REG_2, BPF_REG_3, off));
소스 - src/gen_loader.c#L583-L604
loader는 이 sha 필드를 읽어 박아 둔 상수와 비교한다. 첫 줄의 BPF_PSEUDO_MAP_IDX는 map 값이 아니라 map 객체 자체를 가리키는 표시이고, sha가 struct bpf_map의 맨 앞(오프셋 0)에 있으므로 i * 8 오프셋을 읽으면 해시의 i번째 8바이트가 나온다. 이렇게 8바이트씩 네 번, 박아 둔 상수(R3)와 다르면(JNE) 오류 코드 -EINVAL을 들고 정리 코드로 점프한다.
실제로 그런지 커널 7.0 VM에서 확인했다. 테스트용 자체 서명 인증서를 session keyring에 넣고 bpftool gen skeleton -S로 서명된 light skeleton을 만들어 올리면, 로드가 성공한다. loader 명령어는 서명이 없을 때 134개에서 162개로 늘었다. 늘어난 28개는 위 해시 비교 코드의 명령어 수(반복당 7개 × 4)와 일치한다. 그다음 생성된 헤더에서 loader 명령어 blob과 메타데이터 blob의 첫 바이트를 각각 1비트씩 바꿔 빌드했다.
[서명 정상]      ... BPF_MAP_FREEZE = 0 → BPF_OBJ_GET_INFO_BY_FD = 0 → BPF_PROG_LOAD(SYSCALL, insn_cnt=162) = 4 → BPF_PROG_TEST_RUN = 0
[loader 변조]    BPF_PROG_LOAD = -1 EKEYREJECTED (Key was rejected by service)
[메타데이터 변조] BPF_PROG_LOAD = 4 → BPF_PROG_TEST_RUN = 0 → load err=-22
loader를 건드리면 커널이 입구에서 막는다. 서명 검증 단계라 EKEYREJECTED가 나온다. 메타데이터를 건드리면 서명은 맞으니 loader는 올라가지만, loader가 해시 비교에서 걸려 -22(-EINVAL)로 끝난다. BPF_PROG_TEST_RUN 자체는 0을 반환하고, 실패는 loader의 반환값으로 전달된다. 두 단계 검증이 각각 작동하는 것이다.
커널 selftest(prog_tests/signed_loader.c)도 metadata_sha_mismatch, metadata_not_exclusive, metadata_hash_not_computed, signature_authenticates_insns 같은 서브테스트로 같은 경계를 검사한다. 이 실험은 운영 환경의 키 관리나 서명 강제 정책은 다루지 않았다.
서명이 강제되는 것도 아니다. 6.18 커밋은 서명이 없으면 이전처럼 로드를 허용하고, 서명 없는 프로그램을 제한할지는 LSM 정책에 맡긴다고 명시한다.
커널 API 자체는 프로그램 종류를 가리지 않는다. BPF_PROG_LOAD에 signature가 있으면 그 명령어 버퍼를 검증할 뿐이다. 다만 재배치가 필요한 일반 .o를 bpftool로 서명해 배포하려면 넘기는 바이트가 빌드 때와 같아야 하므로, loader 방식이 사용된다.
bpftool은 -S(서명 키 -k, 인증서 -i와 함께)로 서명된 light skeleton을 만들고, 문서에 -S가 --use-loader를 암묵적으로 켠다고 쓴다. -L만으로는 서명되지 않는다. 커널 selftest는 fentry_test.c, fexit_test.c, atomics.c를 이 방식으로 빌드한다.
이 구조에는 비용이 있다. loader가 만든 최종 프로그램은 각각 서명 검증을 받지 않는다. 신뢰가 loader를 거쳐 전이될 뿐이다. 커널이 최종 프로그램을 직접 검증하자는 쪽(Blaise Boscaccy)은 바로 이 점을 들어 반대했다. LWN 정리에 따르면 그는 loader 방식이 이론적으로는 전체를 검증하는 것과 동등하게 안전하지만, loader 코드를 신뢰해야 하는 소프트웨어 집합에 넣는다고 지적했다. 6.18에 loader 방식이 머지된 뒤 그가 낸 후속 LSM 훅 패치는 Starovoitov의 강한 반대로 받아들여지지 않았다.
8. 나머지 예측 채점: kptr, 메모리 할당, Windows, 표준화
책은 서명 외에도 몇 가지를 미래형으로 썼다. 커널 객체 포인터는 한 번의 실행 동안만 유효해서 map에 저장할 수 없고 typed pointer가 이를 풀 것이라고, kmalloc()을 직접 부를 수 없으니 eBPF 전용 할당 제안이 있다고 했다(p.207). Windows에 대해서는 PREVAIL verifier와 uBPF를 쓰고 검증과 JIT가 보호된 사용자 공간 환경에서 일어난다고, 표준화는 Dave Thaler가 LPC에서 발표했다고 적었다(p.204-205).
| 예측(책) | 2026년 판정 | 방식과 버전 | 근거 |
|---|---|---|---|
| 서명된 프로그램(p.206) | 실현, 단 책이 짐작한 방식과 다름 | light skeleton loader에 서명 + 메타데이터 해시, v6.18 | 6~7절 |
| long-lived kernel pointer(p.207) | 책 집필 전에 이미 1차 실현 | referenced kptr를 map에 저장, bpf_kptr_xchg, v5.19(2022-07) | 커밋 c0a5a21c25f3, v5.18/v5.19 helpers.c 대조 |
| 메모리 할당(p.207) | 실현 | BPF 전용 할당기 v6.1, bpf_obj_new v6.2, BPF arena v6.9 | 커밋 7c8199e24fa0, 958cf2e273f0, 태그별 소스 대조 |
| eBPF for Windows(p.204-206) | 부분 실현 | PREVAIL·uBPF JIT 유지 + bpf2c native 경로, 최신 GitHub 릴리스 v1.6.0은 prerelease 표시 | ebpf-for-windows v1.6.0 README, releases |
| 표준화(p.204) | 실현(명령어 집합 한정) | RFC 9669 "BPF Instruction Set Architecture", 2024-10, Standards Track | rfc-editor.org |
표의 판정마다 단서가 붙는다.
kptr은 시점이 어긋난 경우다. map에 referenced kptr를 저장하는 커밋은 2022년 4월에 들어가 v5.19에 포함됐다. 책이 미래형으로 쓰던 때에 이미 1차 구현이 있었다. bpf_kptr_xchg는 맡겨 둔 포인터와 들고 있는 포인터를 원자적으로 맞바꾸는 헬퍼인데, 일반 swap과 달리 verifier가 꺼낸 포인터를 반드시 해제하거나 다시 넣도록 참조를 추적한다.
메모리 할당은 kmalloc()을 열어 준 것이 아니다. bpf_obj_new는 크기가 아니라 프로그램 자신의 BTF 안에서의 타입 번호(로컬 타입 ID)를 인자로 받아 그 타입 크기로 할당하는 BPF 전용 new이고, 해제는 bpf_obj_drop으로 한다. 로컬 타입 ID는 프로그램 BTF 안의 번호라서, map fd나 CO-RE 오프셋과 달리 대상 커널에 따라 달라지는 값은 아니다.
이름도 발표 때와 다르다. 책이 각주로 인용한 LPC 2022 발표에서 제안된 할당 함수 이름은 bpf_kptr_new()였지만 머지된 이름은 bpf_obj_new다. referenced kptr 태그도 2022년 처음 머지될 때는 kptr_ref였고, 지금 selftest는 __kptr를 쓴다. 발표 코드를 그대로 옮기면 틀린다.
Windows는 책이 설명한 구조가 유지되면서 경로가 하나 더 생겼다. 사용자 모드 서비스(eBPFSvc.exe)가 uBPF로 JIT 컴파일하는 경로는 지금도 있고, uBPF interpreter는 여전히 debug 빌드에만 들어 있다. 여기에 native 경로가 더해졌다.
native 모드에서는 bpf2c가 바이트코드를 PREVAIL로 검증한 뒤 C 코드로 바꾸고, 그것을 Windows 드라이버로 빌드한다. 이 방향은 책을 쓰던 2022년 10월 Microsoft 블로그에 이미 "새 실행 모드"로 공개됐다. 목표는 소스 코드 호환이고, v1.6.0 설치 문서는 공식 릴리스가 "언젠가" production 서명될 것이라고 써서 현재는 test-signing 같은 환경을 전제로 한다.
2022년 Microsoft가 Cilium L4 로드밸런서를 데모용으로 옮겼을 때, 선택 기능을 주석 처리하고 Linux 특화 어셈블리 문제를 처리한 뒤 Linux용 eBPF 코드의 약 96%가 돌았다. 책 스스로 "Linux용 프로그램이 전부 Windows에서 돌 거라 기대하면 비현실적"이라고 했던 것과 맞는 결과다. 바이트코드 형식과 도구 일부는 공유하지만, 붙는 지점과 helper는 OS마다 다르다. 프로덕션 사용 사례는 이 글에서 확인하지 않았다.
표준화는 범위를 정확히 읽어야 한다. RFC 9669가 표준으로 정한 것은 명령어 집합(바이트코드의 의미)이다. helper, 훅, map, ELF와 ABI는 이 RFC의 범위가 아니다. 그래서 ISA 표준이 생겼다고 프로그램이 OS 사이에서 이식되지는 않는다.
9. 책 이후에 생긴 것
책이 예측하지 않았거나 "진행 중"이라고만 언급한 것 가운데, eBPF의 적용 범위를 넓힌 기능이 있다. 메커니즘은 이 글의 범위 밖이라 버전만 정리한다.
| 기능 | 무엇을 하는가 | 들어간 버전 | 확인 방법 |
|---|---|---|---|
| HID-BPF | 입력 장치(HID) 드라이버 동작을 BPF로 조정. 책 p.207이 "work is also underway"로 언급 | v6.3 | drivers/hid/bpf/hid_bpf_dispatch.c가 v6.2에 없고 v6.3에 있음 |
| BPF token | 권한 있는 데몬이 BPF 기능 일부를 비특권 애플리케이션에 위임 | v6.9 | kernel/bpf/token.c가 v6.8에 없고 v6.9에 있음 |
| BPF arena | 프로그램과 사용자 공간이 공유하는 희소 메모리 영역 | v6.9 | kernel/bpf/arena.c가 v6.8에 없고 v6.9에 있음 |
| sched_ext | BPF로 태스크 스케줄러 작성 | v6.12 | kernel/sched/ext.c가 v6.11에 없고 v6.12에 있음 |
10. 정리: 빈칸 하나로 두 장을 다시 읽기
2절의 한 줄로 돌아가자.
.o (llvm-objdump)       11: r1 = 0x0 ll        ; ELF 재배치 레코드: R_BPF_64_64 counter
로드 후 (bpftool xlated) 11: (18) r1 = map[id:51]
10장은 이 빈칸을 누가 채우는지에 대한 장이었다. bpftrace는 빈칸이 있다는 사실 자체를 감춘다. libbpf는 빈칸을 직접 채우고, libbpfgo와 libbpf-rs는 그 일을 libbpf에 맡기며, ebpf-go와 Aya는 같은 일을 각 언어로 다시 구현했다. 라이브러리를 고른다는 것은 이 빈칸을 채우는 코드를 고르는 일이고, 그래서 SEC("maps") 같은 문법 지원이 로더마다 갈린다.
11장의 서명 문제는 이 빈칸이 로드하는 순간에야 채워진다는 데서 생겼다. 6.18의 해법은 빈칸을 채우는 일 자체를 서명된 loader에게 맡기는 것이었다. loader의 바이트에는 호스트마다 달라지는 빈칸이 없으니 서명할 수 있고, 진짜 빈칸은 loader가 커널 안에서 채운다. 그 대가로 loader 코드가 신뢰 대상이 된다.
실무에서는 두 가지를 기억하면 된다. bpftool로 서명된 프로그램을 만들려면 bpftool gen skeleton -S -k <키> -i <인증서>로 서명된 light skeleton을 만든다(-L만으로는 서명되지 않는다). 그리고 로더 라이브러리를 바꾸면 재배치 지원 범위와 시점이 바뀔 수 있다.
직접 확인(10~20분): 이 글의 실측은 lab/README.md의 명령을 그대로 실행한 것이다(커널 7.0, bpftool v7.7.0). skeleton 비교는 light skeleton을 지원하는 bpftool이면 되고, 서명 실험은 커널 6.18 이상과 -S 옵션이 있는 bpftool이 필요하다.
# 같은 .o를 두 방식으로 skeleton화
bpftool gen skeleton hello.bpf.o name hello > hello.skel.h
bpftool gen skeleton -L hello.bpf.o name hello_lskel > hello.lskel.h

# 각 로더의 bpf() 호출 비교 (10장 연습문제 3번의 변형)
sudo strace -f -e trace=bpf ./user_skel
sudo strace -f -e trace=bpf ./user_lskel

# 빈칸이 채워진 결과 확인 (로더가 프로그램을 쥐고 있는 동안 덤프해야 한다)
llvm-objdump -r hello.bpf.o | grep counter
llvm-objdump -d hello.bpf.o | grep ' ll$'
sudo env HOLD=5 ./user_skel & sleep 1
sudo bpftool prog dump xlated name hello | grep 'map\['
첫 strace에서는 BPF_MAP_CREATE(map_name="counter")와 BPF_PROG_LOAD(prog_name="hello")를 찾고, 둘째 strace에서 이 둘이 사라지고 prog_type=BPF_PROG_TYPE_SYSCALL과 BPF_PROG_TEST_RUN이 나오는지 보면 7절과 대조할 수 있다. 마지막 두 명령은 2절의 r1 = 0x0 ll과 r1 = map[id:N]을 보여 준다. 서명까지 해 보려면 lab/README.md의 3, 4단계를 따르면 된다. 시스템 libbpf 헤더가 서명 필드를 지원하지 않으면 libbpf v1.7.0의 skel_internal.h가 필요하다.
이 명령은 light skeleton의 attach 성공까지 검증하지 않는다. 실습의 hello는 tracepoint 프로그램이므로, 실제 tracepoint 연결을 확인하려면 일반 skeleton의 실행 결과와 light skeleton의 로드 결과를 분리해서 봐야 한다.
시리즈를 마치며: 1주차부터 이 시리즈는 같은 질문을 여러 층에서 반복했다. 프로그램은 어떻게 커널에 들어가고(4주차 bpf()), 어떻게 다른 커널에서도 맞게 동작하며(5주차 CO-RE), 무엇이 안전을 보장하고(6주차 verifier), 반환값은 어디서 소비되는가(7~9주차). 이번 글의 빈칸은 그 첫 질문으로 돌아간 것이다. 프로그램은 .o 그대로 커널에 들어가지 않는다. 로더가 이 호스트에 맞게 고친 뒤에 들어간다. 6.18의 서명은 그 고치는 단계까지 신뢰의 경계 안에 넣으려는 시도다.
이 시리즈 다음으로 볼 질문: 서명이 가능해졌으니, 서명 없는 프로그램의 로드를 실제로 막는 정책은 누가 어떻게 걸까. 6.18 커밋은 그 일을 LSM에 맡겼다. 9주차의 LSM BPF와 이번 글의 서명이 만나는 지점이 다음 주제가 된다.
더 볼 자료
- 메커니즘 원문: libbpf v1.7.0
src/gen_loader.c: light skeleton loader가 어떤 명령어로 조립되는지 직접 볼 수 있다. - 설계 논쟁: LWN "Possible paths for signing BPF programs", LWN "BPF signing LSM hook change rejected": loader 방식과 커널 직접 검증 방식의 장단점을 양쪽 주장으로 정리했다.
- 링커로서의 libbpf: Alexei Starovoitov, LPC 2022 슬라이드: 책 11장이 각주로 인용한 발표. kptr과 메모리 할당 예측의 원형이 들어 있다.
- skeleton 입문: Andrii Nakryiko, "Building BPF applications with libbpf-bootstrap": 책 10장이 추천한 글. 일반 skeleton이 무엇을 담는지 설명한다.
- 표준: RFC 9669: BPF 명령어 집합 표준 원문.
- 원본 텍스트: Learning eBPF 10~11장(원서 p.185-209,
15-ch10-ebpf-programming-pp205-222.pdf,16-ch11-the-future-evolution-of-ebpf-pp223-230.pdf): 이 글이 채점한 1차 자료.