XDP가 return하면, 그 값은 누가 읽고 무엇을 하는가
XDP 프로그램은 return XDP_DROP; 한 줄로 끝난다.
이 한 줄이 패킷을 실제로 지우는 코드일까, 아니면 그저 누군가에게 남기는 지시일까?
7주차에서 확인했듯 verifier는 이 값의 의미를 강제하지 않는다. check_return_code()의 switch 문에는 BPF_PROG_TYPE_XDP 케이스 자체가 없다.
검증기가 신경 쓰지 않는 이 값을, 그렇다면 누가 읽고 실제 패킷 처리로 옮기는가?
이 글을 읽고 나면 다음을 설명할 수 있어야 한다.
- XDP 반환값(R0)을 커널의 어느 함수가 최종적으로 읽어 분기시키는가
- 이 인터페이스가 native로 도는지 generic으로 도는지는 누가, 언제 정하는가
- native와 generic은 그 반환값을 소비하는 방식이 정확히 어떻게 다른가
- XDP_ABORTED와 XDP_DROP은 "둘 다 버려진다"는 결과 뒤에서 코드가 정말 다르게 처리하는가
- 정의되지 않은 반환값을 리턴하면 커널은 무엇을 하는가
- XDP_REDIRECT라는 반환값 하나에는 담기지 않는 "어디로"는 어디에 있는가
1. 반환값을 읽는 공용 진입점
XDP 프로그램의 반환값(R0)은 어디서 처음 읽힐까.
정답은 native 경로와 generic 경로가 공용으로 호출하는 단 하나의 인라인 함수, bpf_prog_run_xdp()다.
/* include/net/xdp.h, v6.9, bpf_prog_run_xdp() 507-522행 */
static __always_inline u32 bpf_prog_run_xdp(const struct bpf_prog *prog,
                                            struct xdp_buff *xdp)
{
    u32 act = __bpf_prog_run(prog, xdp, BPF_DISPATCHER_FUNC(xdp));

    if (static_branch_unlikely(&bpf_master_redirect_enabled_key)) {
        if (act == XDP_TX && netif_is_bond_slave(xdp->rxq->dev))
            act = xdp_master_redirect(xdp);
    }

    return act;
}
소스 - include/net/xdp.h#L507-L522
이 함수는 프로그램을 실행해서 도장(반환값)만 받아오는 창구일 뿐이다.
그 도장을 보고 실제로 패킷을 어디로 옮길지 정하는 건 이 함수를 부른 쪽이다.
아래 그림은 이 반환값이 실제 처리로 이어지기까지 거치는 다섯 지점과, 이 글의 절 구성이 그 지점들과 어떻게 대응하는지 보여준다.
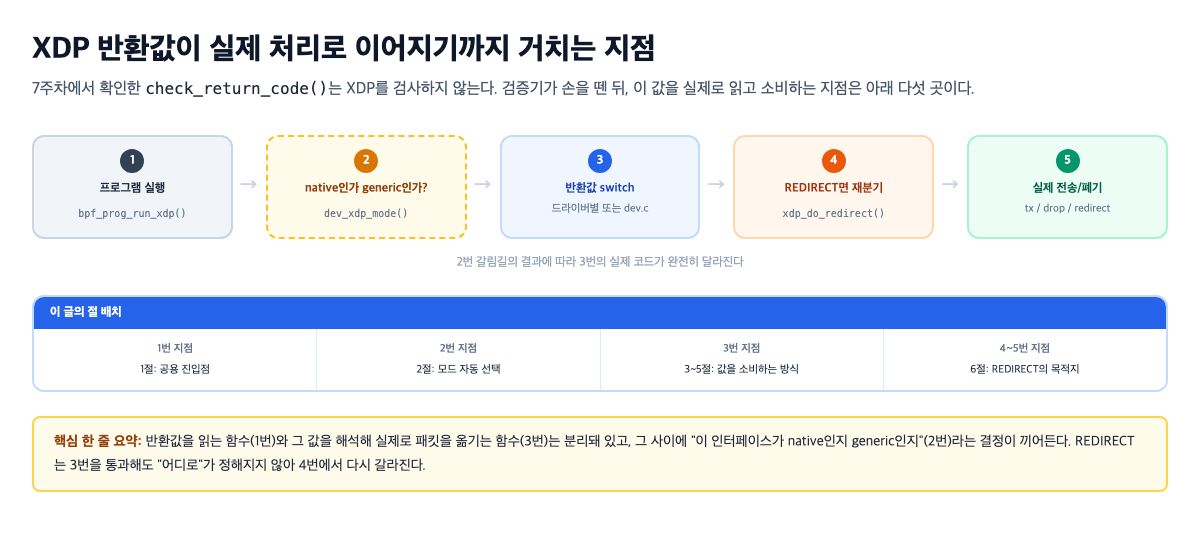
반환값을 읽는 함수와 그 값을 해석해 실제로 패킷을 옮기는 함수는 분리돼 있다.
이 창구 함수 안에서도 예외가 하나 있다. 본딩(bond) 슬레이브 인터페이스에서 XDP_TX가 나오면 xdp_master_redirect()가 그 값을 조작해버린다.
"반환값 하나가 곧 최종 행동"이라는 그림은 이 함수 안에서 이미 한 겹 깨진다.
2. 이 인터페이스는 native로 도는가, generic으로 도는가
bpf_prog_run_xdp()를 부르는 쪽이 native 드라이버냐 generic 래퍼냐에 따라 3절 이후의 실제 코드가 완전히 달라진다.
이걸 결정하는 함수는 net/core/dev.c의 dev_xdp_mode()다. attach 시 모드를 명시하지 않으면, 드라이버가 ndo_bpf를 구현하는지만으로 자동 선택된다.
/* net/core/dev.c, v6.9, dev_xdp_mode() 9171-9180행 */
static enum bpf_xdp_mode dev_xdp_mode(struct net_device *dev, u32 flags)
{
    if (flags & XDP_FLAGS_HW_MODE)
        return XDP_MODE_HW;
    if (flags & XDP_FLAGS_DRV_MODE)
        return XDP_MODE_DRV;
    if (flags & XDP_FLAGS_SKB_MODE)
        return XDP_MODE_SKB;
    return dev->netdev_ops->ndo_bpf ? XDP_MODE_DRV : XDP_MODE_SKB;
}
소스 - net/core/dev.c#L9171-L9180
아래 그림은 이 결정 트리를 그대로 옮긴 것이다.
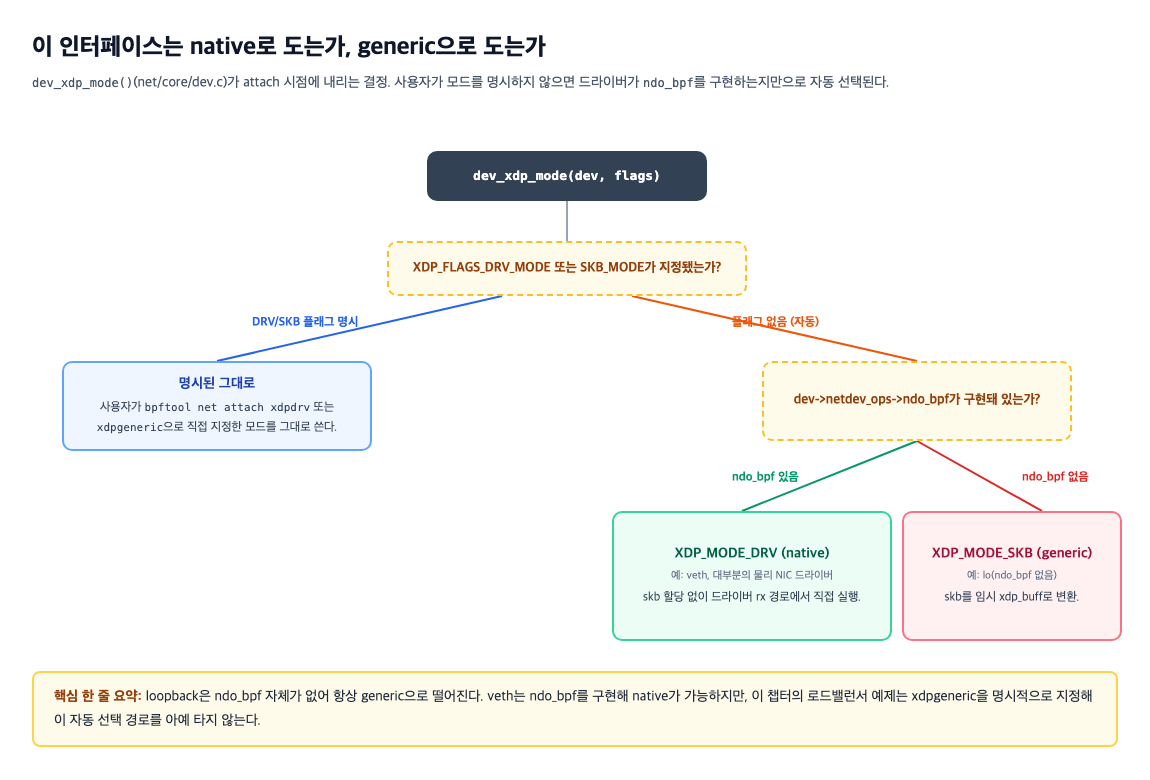
이 자동 선택 로직은 이 챕터의 실습 예제 자체로 직접 확인할 수 있다.
책의 chapter8 ping/packet-drop 예제(github.com/lizrice/learning-ebpf)가 쓰는 Makefile은 모드를 지정하지 않고 bpftool net attach xdp dev lo로 붙인다.
lo(loopback)의 net_device_ops인 loopback_ops(drivers/net/loopback.c, 157-162행)에는 필드가 딱 네 개뿐이고, 그 안에 .ndo_bpf는 없다.
그 결과 이 예제는 언제나 generic 경로로만 실행된다. 사용자가 무엇을 선택할 수 있는 문제가 아니라, lo라는 인터페이스가 구조적으로 native를 지원하지 않기 때문이다.
로드밸런서 예제는 다른 파일이다. 책은 이 예제의 Makefile을 본문에 직접 인용하며 "이전 예제와 비슷하게(Much like the previous example)"라고만 말한다. 같은 파일이라는 뜻이 아니다.
그 Makefile은 veth(eth0)에 대해 bpftool net attach xdpgeneric dev eth0로 명시적으로 generic 모드를 지정한다.
veth 드라이버는 .ndo_bpf = veth_xdp(drivers/net/veth.c, 1673행)를 구현해 native XDP가 가능한데도 그렇다.
이 정확한 커맨드는 Liz Rice가 eBPF Summit 2021에서 발표한 원본 데모 저장소 github.com/lizrice/lb-from-scratch의 Makefile에 그대로 있다. chapter8/Makefile(ping/packet-drop 예제가 쓰는 그 파일)에는 이 줄이 없다.
이 챕터의 커널 selftest에도 같은 전제가 깔려 있다. tools/testing/selftests/bpf/prog_tests/xdp_attach.c는 IFINDEX_LO에 모드를 지정하지 않고 attach/replace/detach하는 시나리오를 검증하는데, 이는 lo가 항상 generic으로 떨어진다는 전제 없이는 성립하지 않는 테스트다.
이 챕터의 두 실습 예제 모두 실제로는 generic(SKB 기반) 경로로 동작한다. 하나는 인터페이스 구조상 강제로, 다른 하나는 명시적 선택으로.
3. native와 generic은 반환값을 어떻게 다르게 소비하는가
generic 경로에서는 이미 존재하는 sk_buff를 잠깐 xdp_buff로 위장시켜 프로그램에 보여준다.
프로그램이 실행을 마치면 bpf_xdp_adjust_head/adjust_tail로 바뀐 크기만큼 skb의 헤더 포인터와 길이를 다시 맞춘다.
/* net/core/dev.c, v6.9, bpf_prog_run_generic_xdp() 4811-4911행 중 발췌 */
xdp_init_buff(xdp, frame_sz, &rxqueue->xdp_rxq);
xdp_prepare_buff(xdp, hard_start, skb_headroom(skb) - mac_len,
                 skb_headlen(skb) + mac_len, true);
...
act = bpf_prog_run_xdp(xdp_prog, xdp);

/* check if bpf_xdp_adjust_head was used */
off = xdp->data - orig_data;
if (off) { ... __skb_pull(skb, off) ... }
소스 - net/core/dev.c#L4811-L4911
포장을 풀었다가 다시 싸는 이 왕복 작업 자체가 추가 CPU 사이클을 쓴다.
native 모드는 애초에 skb를 할당하지 않은 상태에서 시작하므로 이 비용이 없다.
Cilium 공식 문서(책이 TC 절 각주로 직접 인용하는 바로 그 레퍼런스)는 이 차이를 정확히 이렇게 설명한다.
"At this point in the fast-path the driver just picked up the packet from its receive rings, without having done any expensive operations such as allocating an skb"
그런데 generic XDP는 단순히 "성능을 타협한 열화판"으로 설계된 게 아니다.
이 경로를 처음 병합한 넷워킹 서브시스템 메인테이너 David Miller는 두 가지 이유를 밝혔다. 드라이버별 native 구현이 없어도 더 많은 사람이 XDP를 써볼 수 있게 하려는 것과, 순수 generic 구현이 드라이버 개발자에게 "정답 예시" 역할을 하게 하려는 것이다.
"More people can play with XDP with less dependencies" / "If there is a pure generic core implementation, it serves as a semantic example for driver folks"
native 드라이버가 실제로 반환값을 어떻게 소비하는지는 veth의 veth_xdp_rcv_one()(Docker 컨테이너 네트워킹에 쓰이는 바로 그 드라이버)에서 볼 수 있다.
/* drivers/net/veth.c, v6.9, veth_xdp_rcv_one() 608-676행 중 발췌 */
act = bpf_prog_run_xdp(xdp_prog, xdp);
switch (act) {
case XDP_PASS: ...
case XDP_TX:
    ... veth_xdp_tx(rq, xdp, bq) ...
case XDP_REDIRECT:
    ... xdp_do_redirect(rq->dev, xdp, xdp_prog) ...
default:
    bpf_warn_invalid_xdp_action(rq->dev, xdp_prog, act);
    fallthrough;
case XDP_ABORTED:
    trace_xdp_exception(rq->dev, xdp_prog, act);
    fallthrough;
case XDP_DROP:
    stats->xdp_drops++;
    goto err_xdp;
}
소스 - drivers/net/veth.c#L608-L676
fallthrough;는 다음 case로 그대로 넘어가겠다는 의도를 명시하는 표시다. 이게 없으면 컴파일러가 "case를 빠뜨린 것 아니냐"는 경고를 낸다. 이 코드에서는 default(정의 밖 값)가 XDP_ABORTED 처리로, XDP_ABORTED가 다시 XDP_DROP 처리로 의도적으로 흘러 들어간다.
반환값을 받은 뒤의 처리 패턴(5개 값을 다 챙기는 switch문)은 커널 전역에서 반복되는 관용구다.
다만 이건 진짜 하나의 공유 함수가 아니라, 각 호출부(dev.c, veth.c, 그리고 나중에 볼 devmap.c, cpumap.c)마다 사람이 손으로 반복 작성한 코드다.
패턴은 같아도 실제 전송 경로는 다르다. generic 경로는 qdisc를 우회하는 공용 netdev_start_xmit()을 쓰지만, veth는 자신의 벌크 큐(veth_xdp_tx, 최대 16개)를 쓴다.
실전에서 이 차이가 얼마나 큰지는 Cloudflare 엔지니어 Marek Majkowski의 2018년 글이 구체적인 숫자로 보여준다.
"With XDP we can run eBPF code in the context of a network driver. Most importantly, this is before the skbuff memory allocation, allowing great speeds." / "With XDP we can drop 10 million packets per second on a single CPU."
이 수치는 native 모드 기준이다. 2절에서 확인했듯 이 챕터의 두 예제는 generic 경로로 동작하므로, 이 정도 성능은 이 실습만으로는 체감할 수 없다.
4. ABORTED와 DROP, 책이 구분한 두 폐기는 코드에서도 다른가
책은 XDP 반환값 5개를 이렇게 정의한다.
"XDP_TX sends the packet back out of the same interface it arrived on." / "XDP_REDIRECT is used to send it to a different network interface." / "XDP_ABORTED results in the packet being dropped, but its use implies an error case or something unexpected, rather than a 'normal' decision to discard a packet."
DROP과 ABORTED 모두 "패킷이 버려진다"는 결과는 같다.
책은 이 둘을 "의미(의도)" 차원에서 구분하는데, generic 경로의 코드는 그 의도를 실제로 관측 가능한 차이로 구현한다.
/* net/core/dev.c, v6.9, netif_receive_generic_xdp() 4936-4983행 중 switch 발췌 */
switch (act) {
case XDP_REDIRECT:
case XDP_TX:
case XDP_PASS:
    break;
default:
    bpf_warn_invalid_xdp_action((*pskb)->dev, xdp_prog, act);
    fallthrough;
case XDP_ABORTED:
    trace_xdp_exception((*pskb)->dev, xdp_prog, act);
    fallthrough;
case XDP_DROP:
do_drop:
    kfree_skb(*pskb);
    break;
}
소스 - net/core/dev.c#L4936-L4983
최종 폐기 동작(kfree_skb)은 DROP과 ABORTED가 같다.
하지만 ABORTED(그리고 정의되지 않은 값)가 지나갈 때만 xdp:xdp_exception이라는 트레이스포인트가 울린다. DROP은 조용히 버려진다.
이 switch문을 감싸는 do_xdp_generic()을 보면 반환값 이름 자체가 상위 계층에는 다르게 전달된다는 것도 드러난다. XDP_TX나 XDP_REDIRECT가 성공해도, 상위 계층에는 항상 XDP_DROP을 돌려준다. "이 skb는 여기서 소비됐다"는 뜻이지, 실제로 패킷이 버려졌다는 뜻이 아니다.
"버려지는 상자"라는 결과만 보면 둘이 같아 보이지만, 커널은 ABORTED가 지나갈 때만 관측 가능한 신호를 남기고, 반환값 이름이 상위 계층까지 그대로 전달되지도 않는다.
그런데 이 "5개 값을 다 챙기는 관용구"가 커널 전역에서 항상 지켜지는 건 아니다.
kernel/bpf/cpumap.c의 cpu_map_bpf_prog_run_xdp()(cpumap 엔트리에 붙는 2차 프로그램의 실행 경로)에는 XDP_ABORTED case가 빠져 있다.
/* kernel/bpf/cpumap.c, v6.9, cpu_map_bpf_prog_run_xdp() 178-235행 중 switch 발췌 */
switch (act) {
case XDP_PASS: ...
case XDP_REDIRECT: ...
default:
    bpf_warn_invalid_xdp_action(NULL, rcpu->prog, act);
    fallthrough;
case XDP_DROP:
    xdp_return_frame(xdpf);
    stats->drop++;
    break;
}
소스 - kernel/bpf/cpumap.c#L178-L235
XDP_ABORTED의 enum 값은 0이다. 나열되지 않은 값이므로 C switch 규칙상 그대로 default로 떨어진다.
그 결과 이 경로에서 ABORTED를 반환하면 "정의되지 않은 값"과 똑같이 취급되어 bpf_warn_invalid_xdp_action() 오경고를 맞는다. trace_xdp_exception()은 호출되지 않는다.
이게 설계 의도인지 실수인지는 코드만 봐서는 단정하기 어렵다. 하지만 2026년 커널 메일링리스트에 정확히 이 문제를 지적하는 패치가 올라와 있다.
"cpu_map_bpf_prog_run_xdp() handles XDP_PASS, XDP_REDIRECT, and XDP_DROP but is missing an XDP_ABORTED case. Without it, XDP_ABORTED falls into the default case which logs a misleading 'invalid XDP action' warning instead of tracing the abort via trace_xdp_exception()."
독립적으로 코드를 읽어 얻은 결론이 커널 커뮤니티 자체의 버그 인지와 정확히 일치한다.
이 글을 쓰는 시점(v6.9 기준)에는 이 패치가 아직 머지되지 않아 결함이 남아 있다.
커널 코드가 항상 최종 정답인 것은 아니다. "5개 값을 다 챙기는 관용구"는 사람이 각 호출부마다 손으로 반복 작성한 코드일 뿐이라, 실제로 한 곳에서 빠뜨릴 수 있다.
5. 정의되지 않은 반환값을 리턴하면 커널은 무엇을 하는가
4절에서 여러 번 등장한 bpf_warn_invalid_xdp_action()을 직접 보면, 이 경고가 얼마나 자주 뜨는지가 드러난다.
/* net/core/filter.c, v6.9, bpf_warn_invalid_xdp_action() 9018-9025행 */
void bpf_warn_invalid_xdp_action(struct net_device *dev, struct bpf_prog *prog, u32 act)
{
    const u32 act_max = XDP_REDIRECT;
    pr_warn_once("%s XDP return value %u on prog %s (id %d) dev %s, expect packet loss!\n",
                 act > act_max ? "Illegal" : "Driver unsupported",
                 act, prog->aux->name, prog->aux->id, dev ? dev->name : "N/A");
}
소스 - net/core/filter.c#L9018-L9025
이 함수는 1절에서 본 "검증기가 이 값을 강제하지 않는다"(7주차, check_return_code())는 사실의 런타임 짝이다.
로드 시점 검증이 없으니 런타임에 정의된 5개 값(0~4) 밖의 정수가 나올 수 있다. 그 경우 커널은 프로그램을 죽이지 않는다. 패킷 하나를 버리고, 로그에 딱 한 줄만 남긴 뒤 계속 실행한다.
act > XDP_REDIRECT(enum 범위 자체를 벗어남)이면 "Illegal", 범위 안이지만 그 경로가 지원하지 않는 값이면 "Driver unsupported"로 메시지만 구분된다.
pr_warn_once의 "once"는 프로그램별·디바이스별 1회가 아니라 커널 전체 기준으로 딱 1회다.
서로 다른 프로그램이 서로 다른 이상한 값을 반환해도 두 번째 이후는 로그에 남지 않는다. 운영 환경에서 "경고가 없다"는 것이 "문제가 없다"는 뜻은 아니다.
6. XDP_REDIRECT라는 반환값 하나에는 담기지 않는 것
XDP_REDIRECT를 반환한 뒤 실제로 프레임이 어디로 갈지는, 이 정수 값 자체에는 들어 있지 않다.
"어디로"는 그전에 헬퍼(bpf_redirect_map())가 percpu(CPU 코어마다 별도로 존재해 락 없이 접근 가능한) 구조체 bpf_redirect_info에 미리 적어둔 map_type에 있다.
/* net/core/filter.c, v6.9, __xdp_do_redirect_frame() 4376-4414행 중 switch 발췌 */
switch (map_type) {
case BPF_MAP_TYPE_DEVMAP: fallthrough;
case BPF_MAP_TYPE_DEVMAP_HASH:
    err = dev_map_enqueue(fwd, xdpf, dev); break;
case BPF_MAP_TYPE_CPUMAP:
    err = cpu_map_enqueue(fwd, xdpf, dev); break;
case BPF_MAP_TYPE_UNSPEC:
    if (map_id == INT_MAX) { err = dev_xdp_enqueue(fwd, xdpf, dev); break; }
    fallthrough;
default:
    err = -EBADRQC;
}
소스 - net/core/filter.c#L4376-L4414
아래 그림은 이 네 갈래를 그대로 옮긴 것이다.
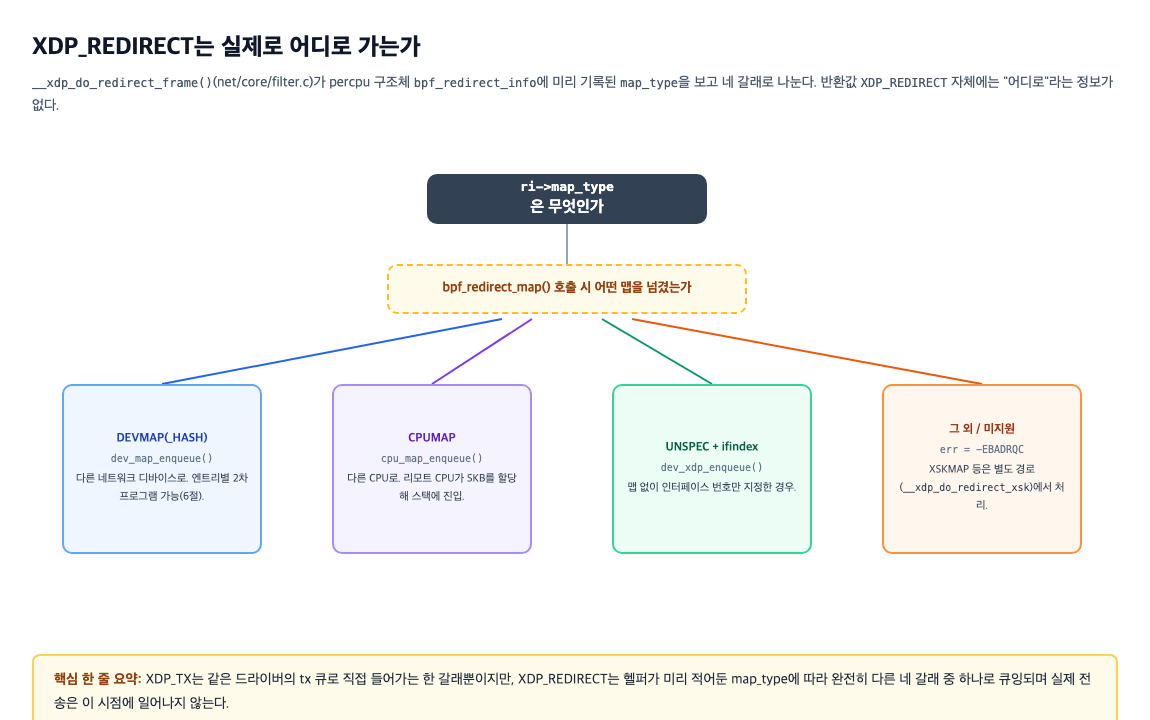
XDP_TX는 같은 드라이버의 tx 큐로 직접 들어가는 한 갈래뿐이다.
XDP_REDIRECT는 대상 유형에 따라 완전히 다른 네트워크 디바이스, 다른 CPU, 또는 맵 없이 지정된 인터페이스로 갈 수 있는 여러 갈래다.
커널 공식 문서는 이 과정을 "세 단계 프로세스"로 요약한다.
"Not all drivers support transmitting frames after a redirect, and for those that do, not all of them support non-linear frames."
이 네 갈래 중 devmap과 cpumap은 각각 "2차 프로그램"을 붙일 수 있다는 공통점이 있다.
devmap 엔트리에 프로그램이 붙어 있으면, dev_map_bpf_prog_run()이 리다이렉트된 프레임마다 그 프로그램을 한 번 더 실행하고, 통과한 프레임만 벌크 큐에 쌓았다가 ndo_xdp_xmit()으로 실제 전송한다.
이 2차 프로그램의 switch문에는 XDP_ABORTED case가 정상적으로 있다. 4절에서 본 cpumap 쪽 결함과 대조되는 지점이다. 같은 "2차 프로그램" 개념이라도 devmap과 cpumap은 완전히 다른 코드라서, 결함이 한쪽에만 있을 수 있다.
cpumap은 그 대상이 다른 네트워크 인터페이스가 아니라 다른 CPU라는 점이 다르다.
"The remote CPU will do SKB-allocation and call the normal network stack." / "Unlike devmap which redirects XDP frames out to another NIC device, this map type redirects raw XDP frames to another CPU."
devmap이 "다른 네트워크 카드로"라면, cpumap은 "같은 카드로 들어온 패킷을 다른 CPU 코어에 던져 처리를 분산"하는 것에 가깝다. 하드웨어 RSS가 없는 환경을 소프트웨어로 흉내내는 셈이다.
이 두 2차 프로그램 슬롯은 아무 XDP 프로그램이나 끼울 수 있는 게 아니다.
BPF_XDP_DEVMAP/BPF_XDP_CPUMAP이라는 전용 attach type이 있어야 하며, 일반 XDP 프로그램을 넣거나 반대로 이 전용 프로그램을 일반 디바이스에 직접 붙이려는 시도는 커널 selftest(xdp_devmap_attach.c, xdp_cpumap_attach.c)가 둘 다 거부됨을 검증한다.
XDP_REDIRECT는 반환값이 아니라 그 앞의 헬퍼 호출이 목적지를 정하는 구조다. 같은 반환값이라도 devmap으로 가면 다른 인터페이스로, cpumap으로 가면 다른 CPU로 완전히 다른 경로를 탄다.
7. TC는 왜 여러 프로그램을 순서대로 처리할 수 있는가
이 섹션은 선택 축이다. 시간 여유가 있을 때 참고할 배경으로 다룬다.
책은 TC를 소개하며 XDP와의 결정적 차이를 이렇게 짚는다.
"Unlike XDP, it's possible to attach multiple eBPF programs that will be processed in sequence." / "TC_ACT_UNSPEC behaves as if the eBPF program hadn't been run on this packet (so it would be passed to the next classifier in the sequence, if there is one)."
이 "다음 classifier로 넘어간다"는 서술은 실제로 net/sched/cls_bpf.c의 리스트 순회 코드로 구현돼 있다.
/* net/sched/cls_bpf.c, v6.9, cls_bpf_exec_opcode() 66-79행 / cls_bpf_classify() 90-138행 중 발췌 */
static int cls_bpf_exec_opcode(int code)
{
    switch (code) {
    case TC_ACT_OK: case TC_ACT_SHOT: case TC_ACT_STOLEN:
    case TC_ACT_TRAP: case TC_ACT_REDIRECT: case TC_ACT_UNSPEC:
        return code;
    default: return TC_ACT_UNSPEC;
    }
}
/* cls_bpf_classify, direct-action 모드 */
if (prog->exts_integrated) {
    ret = cls_bpf_exec_opcode(filter_res);
    if (ret == TC_ACT_UNSPEC) continue;
    break;
}
소스 - net/sched/cls_bpf.c#L66-L138
TC는 "심사위원이 여러 명 줄 서 있고, 한 명이 '나는 이 소포에 대해 할 말 없다'(UNSPEC)고 하면 자동으로 다음 심사위원에게 넘어가는" 구조를 리스트 순회로 구현한다.
XDP는 심사위원이 한 명뿐이라 이 개념 자체가 필요 없다.
이 direct-action 모드(반환값이 곧바로 TC 액션이 되는 방식)의 의미는, 책이 TC 절 각주에서 직접 인용하는 Quentin Monnet의 글이 정확히 설명한다.
"This flag, used at filter attach time, tells the system that the return value from the filter should be considered as the one of an action instead." / "an eBPF program attached as a TC classifier can now return TC_ACT_SHOT, TC_ACT_OK, or another one of the reserved values. And it is interpreted as such: no need to add another TC action object."
direct-action 모드에서는 프로그램의 반환값 자체가 최종 액션이 되지만, classic 모드에서는 반환값을 classid로만 해석하고 실제 처분은 별도의 tc action 객체(tcf_exts_exec())가 담당한다.
"eBPF 프로그램이 classifier이자 action이다"라는 그림은 direct-action 모드에만 해당한다. classic 모드에서는 분류와 처분이 분리돼 있다.
이 classic 체이닝(tp->next 리스트)과 별개로, 2023년 커밋(053c8e1f235d, "bpf: Add generic attach/detach/query API for multi-progs")으로 bpf_mprog라는 새 인프라가 들어왔다.
이 커밋 메시지는 기존 tc의 priority 기반 순서 지정이 "사용자에게 불필요한 마법"이라는 커뮤니티 피드백에서 나온 대체안임을 밝힌다. 책은 priority 기반 classic 체인만 서술하며, 이 신규 메커니즘은 다루지 않는다.
8. 정리: XDP 프로그램 하나가 반환하는 순간부터 실제 처리까지
이 챕터에서 다룬 것을 한 문장으로 되짚으면 이렇다.
XDP 프로그램이 반환하는 정수 하나는, 그 값을 읽는 함수(1절)와 실제로 패킷을 옮기는 함수(2~3절)가 분리돼 있고, REDIRECT의 경우 "어디로"라는 정보는 반환값이 아니라 별도의 헬퍼 호출에 있다(6절).
"prog_type 하나에 정책 하나"가 아니었던 7주차처럼, "반환값 하나에 행동 하나"도 아니다.
같은 XDP_DROP이라도 generic 경로(3절)와 native 경로(veth, 3절)는 서로 다른 코드로 처리하고, 같은 XDP_ABORTED라도 devmap 경로와 cpumap 경로는 처리 방식이 다르다(4절, 실제로는 한쪽에 결함이 있다).
이 챕터의 실습 예제 두 개 모두 이 다섯 갈래 중 generic 경로 하나만 밟는다는 것도 2절에서 직접 확인했다.
정상적으로 XDP_DROP을 반환하는 프로그램을 붙이면 아무 로그도 뜨지 않는다. 반면 return XDP_ABORTED; 또는 정의 밖의 값(return 999;)을 반환하는 프로그램을 붙이면 이 트레이스포인트가 찍힌다.
다음 장으로 이어지는 질문: 이 챕터에서 본 반환값 소비 지점(generic/native switch, devmap/cpumap 2차 프로그램)은 모두 패킷 레벨의 "허용/거부" 판단이었다. 9주차(eBPF for Security)가 다루는 LSM 훅이나 cgroup 기반 정책도 같은 "반환값을 커널의 특정 지점이 읽어 소비하는" 패턴을 따르는가, 아니면 완전히 다른 강제 메커니즘을 쓰는가?
더 볼 자료
- 공식 정의: XDP_REDIRECT 문서: devmap/cpumap/xskmap 네 갈래 리다이렉트 대상을 이 글보다 formal한 언어로 다룬다.
- 공식 정의: BPF and XDP Reference Guide: generic/native XDP 성능 차이와 프로그램 타입별 특성을 네트워킹 프로젝트 관점에서 재확인한다.
- 실무: Cloudflare, "How to drop 10 million packets per second": native XDP의 실전 성능 수치.
- 원본 텍스트: Learning eBPF 8장(원서 p.143-169,
13-ch8-ebpf-for-networking-pp163-190.pdf): 이 글이 근거로 쓴 1차 자료.