해시 테이블
파이썬의 딕셔너리는 내부적으로 해시 테이블로 구현되어 있다.
cpython의 dictobject.c코드를 뜯어 보면
/* PyDictKeysObject

This implements the dictionary's hashtable.
+---------------------+
| dk_refcnt           |
| dk_log2_size        |
| dk_log2_index_bytes |
| dk_kind             |
| dk_version          |
| dk_usable           |
| dk_nentries         |
+---------------------+
| dk_indices[]        |
|                     |
+---------------------+
| dk_entries[]        |
|                     |
+---------------------+
dk_indices is actual hashtable.  It holds index in entries, or DKIX_EMPTY(-1)
or DKIX_DUMMY(-2).
...
*/
정도의 주석으로 해시 테이블임을 알 수 있다. 공부하는 과정에서 알게 된 메모리 관련 내용은, CSAPP에 등장하는 메모리 내용과 엮어서 새로운 포스트를 작성 할 예정이다. 따라서 아래 내용에는 메모리 할당 등은 크게 다루지 않을 듯.
일단 해시 테이블이 무엇인지 알아보자.
파이썬의 딕셔너리는 Key와 Value의 쌍으로 이루어져 있다.
- 파이썬은 딕셔너리 객체를 생성할 때 메모리에 크기의 테이블을 생성한다.
- 파이썬의 딕셔너리는
Key와Value의 쌍으로 이루어져 있다. 이Key를 자체 hash함수로 변환하여 테이블의index를 계산한다. - 계산한
index에key : value를 저장한다.
해시 충돌
이 과정에서 발생할 수 있는 문제가 있다. 만약 서로 다른 key의 hash값이 같아서 같은 index에 저장되어야 한다면? 이를 해시 충돌(Collision)이라고 한다.
해시 충돌을 해결하기 위한 몇 가지 방법이 있다.
- 체이닝
- 개방 주소법(오픈 어드레싱)
2-1. 더블 해싱
1. 체이닝
만약 해시 충돌이 일어나면 테이블을 확장하여(Linked List 등으로) 저장하는 방식이다.
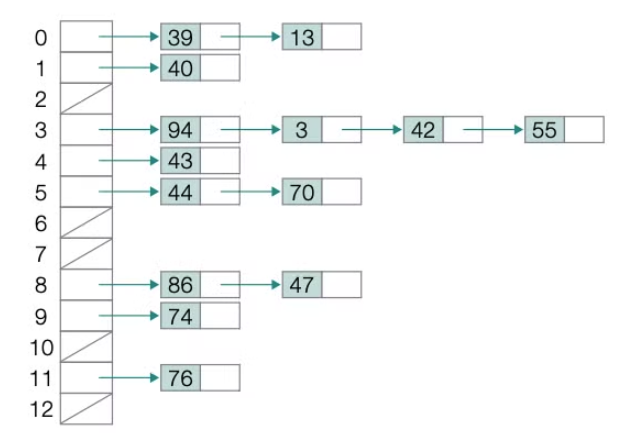
사진만 보면 데이터가 한개라 "어떤 데이터가 원하는 데이터지?"라는 의문이 처음에 들었는데, 알고보니 key : value 모두 저장해서 문제가 없다고 한다.
평균적으로는 한 인덱스에 데이터가 적게 몰려 있기 때문에 빠른 탐색이 가능한데 최악의 경우 모든 key가 같은 인덱스에 저장되면 이 될 수 있다.
2. 개방 주소법(오픈 어드레싱)
해시 충돌이 발생하면 다른 비어 있는 위치를 찾는다(Linear Probing의 경우 +1의 주소)
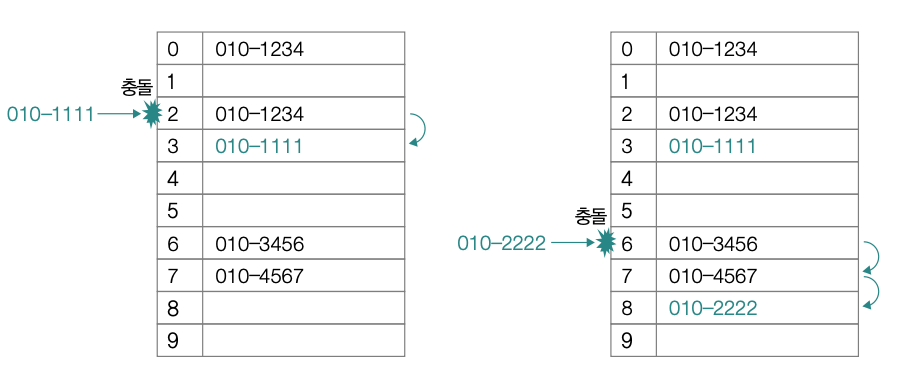
개방 주소법도 마찬가지로 충돌이 너무 많이 발생하면 다음에 저장 할 주소를 찾기 위해 의 탐색 시간복잡도를 가진다.
이때 사용되는 것이 ( n = 테이블의 크기, k = 데이터의 수 ). Load Factor는 해시 테이블이 어느 정도 사용되고 있는지 나타내는 수치로 일정 수치에 도달하면 테이블의 크기를 늘리고 데이터를 다시 배치하는 작업을 하도록 되어있다.
파이썬에서는 Load Factor을 미만으로 유지하도록 되어 있다. 좋은 탐사 방식과 Load Factor 관리로 충돌 문제를 해결하는 것이 좋다고 한다.
여기서 "좋은 탐사"라는 표현이 나오는데 이는 "데이터 군집화"와 관련이 있다.
Primary Clusting
데이터 군집화는 선형 탐사(Linear Probing)때문에 발생하는 문제다.
위의 그림은 입력이 빈 슬롯을 찾기 위해 index를 1씩 늘려 가며 탐색하고 있다. 하나의 충돌이 연속된 빈 칸을 채우면서 데이터 덩어리(Cluster)을 형성하는데 이후 다른 데이터가 이 덩어리를 만나면 빈 칸을 찾기 위해 끝까지 이동해야 하는 문제가 생긴다. 이 데이터가 Cluster에 합류하면서 덩어리가 계속 커지는 악순환이 반복되게 된다.
2-1. Double Hashing
그렇다면 인덱스를 1씩 증가시키지 말고 멀리 보내면 되는 것 아닌가? 하면 이차 탐사(Quadrotic probing)과 Secondary Clustering 문제가 생기는데... 이것도 해결한 것이 더블 해싱이다.
더블 해싱은 Key마다 다른 간격을 사용할 수 있다.
서로 다른 두 해시 함수를 , 라고 하면 탐사 위치를 다음과 같이 결정한다.
단, 테이블 크기와 탐사 간격이 서로소 관계가 되도록 해시 함수를 구성해야 한다. (모든 위치를 탐색할 수 있도록)
이중 해시 자세한 예시 링크
https://blog.naver.com/beaqon/221300416700
더블 해싱의 단점은?
-
, 두 번째 해시 함수 계산 비용이 추가된다. 직관적인 이유다
-
두 번째 해시 함수의 설계가 중요하다.
- 테이블 크기와 탐사 간격이 서로소 관계가 아니라면, 예를 들어
table_size = 12
 h2(k) = 4

 # 0 > 4 > 0 > 4 > 0 > 4 > 0 > 4....
같은 구조로 테이블의 일부 위치만 계속 확인하게 된다.
-
구현이 선형 탐사보다 복잡하다.
index = (hash(key) + i) % size # 선형 탐사

index = (h1(key) + i * h2(key)) % size # 더블 해싱
실제 구현에서는 가 0이 되지 않아야 하고, 모든 슬롯을 탐색할 수 있도록 하는 조건도 신경 써야 한다.