6주차 Malloc Lab 종료
지난 주차들에 비해 확실히 어려웠던 것 같다.
동적 메모리 할당기를 구현한다고 하는 주제였다. malloc없이 memory allocator를 구현하라니... 처음엔 그 작동 방식을 이해하지 못했다. 메모리를 늘리고 줄이는 동작을 하려면 결국 메모리를 할당받아야 하지 않는가? malloc함수 없이 운영체제에게 메모리를 요청하는 것이 가능한 것인가 하는 의문을 떨쳐 내기 어려웠다.
우리가 구현하는 환경은 Mini Heap이다.
malloc lab에서 구현해야 하는 메인 파일은 mm.c이다. 이외의 파일은 구현을 돕기 위한 헬퍼 코드들이나 함수 선언, 매크로들이 담겨 있다.
다른 파일들을 읽다 보니 이 중에서 memlib.c파일이 꽤나 중요한 역할을 한다는 것을 알게 되었다.
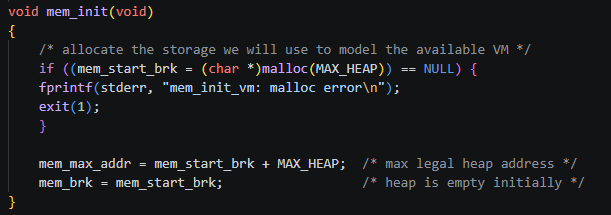
mem_init함수에서 malloc으로 힙 영역 메모리를 확보해두고 있다. MAX_HEAP은 20MB를 뜻한다.
쉽게 말하면 20MB라는 일련된 공간을 Heap처럼 작동하게 만들어라가 목표인 것이었다.
memlib.c파일을 더 읽어보면
mem_sbrk()mem_reset_brk()mem_heapsize()mem_start_brk
와 같은 함수와 변수들을 찾아볼 수 있는데, 이 함수들과 변수들의 이름은 실제glibc라이브러리에서 사용하고 있는 방식이다.
참고 링크 https://hyeonistic.tistory.com/134
우리가 구현하는 malloc lab의 동적 할당기도 같은 구조를 흉내내고 있다.
malloc의 반환 주소 (힙의 시작 주소)를 mem_start_brk에 담아 두고 mm.c에서 extend_heap함수로 힙을 확장할 때 mem_sbrk(int incr) 로 sbrk위치를 이동시킨다.
"진짜 메모리 할당기"의 동작을 이용해 Mini malloc을 구현했다고 할 수 있는 구조였다.
사실 지금 생각해보면 별 것 아니고 당연한 것 아닌가? 라는 생각이 들기는 한다. 그렇지만 6주간의 커리큘럼에서 코드의 작동 방식이 한눈에 직관적으로 이해되지 않았던 첫 케이스여서 조금 이해할 시간과 노력이 필요했던 느낌이다.
시스템 설계 시도?
왜 의문형이냐 하면... 다시 읽어 보니 너무 난해해서 설계라고 해도 될까 회의감이 들기 때문이다.
개인 문서로는 공유가 편리하고 디자인이 깔끔하다고 생각하는 노션을 사용중이다.
CS:APP에 제시된 코드는 Implicit Free List여서 나는 첫 목표를 작동은 하는 Explicit Free List를 구현하는 것으로 세웠다.
묵시적 리스트 구현 이후 테스트 점수에서 `throughput`이 만점이었던 건 별로 신경을 쓰지 않았는데
할당 요청시 마다 리스트의 모든 요소를 탐색하는 묵시적 가용 리스트보다는 명시적 가용 리스트가 블록이 많아지면 많아질수록 속도적 이점이 클 것이라 생각했었다.
`malloc lab`이 만들어진 `2002`년 당시 하드웨어를 기준으로 만들어진 측정 기준이라 지금의 하드웨어로는 웬만한 구현 방식에서 처리량 만점이 나올수밖에 없다는걸 너무 늦게 깨달았다.
최소 기능부터
명시적 가용 리스트를 구현하기 전 작성한 프로토타입 설계 아이디어.
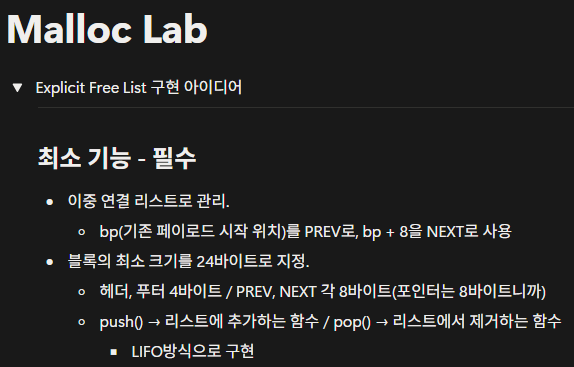
우선 테스트케이스를 모두 통과하기 위한 최소 기능을 계획했다.
명시적 가용 리스트가 그렇게 복잡한 구조는 아니었기 때문이다.
최소 블록의 크기를 계산하는 부분을 수정하고 리스트에서 추가 / 제거하는 코드만 만들면 그만이었다. 다만 매크로 사용에 있어서 bp를 엇나가게 사용했던 부분에서 오류를 조금 겪었을 뿐이었다.
다음은 부가 기능
그 뒤로는 우선순위는 낮지만 성능 개선에 필요한 기능들을 하나씩 추가하기 시작했다.
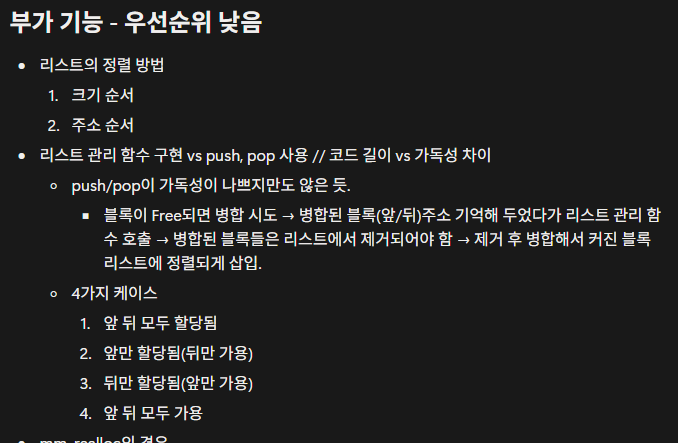
코드 작성 전이었기 때문에 최적화 관련 아이디어들은 많이 뽑아내지 못했던 것 같다.
되돌아보면 아쉬웠던 점인데, mm.c코드를 이해하고 나서 테스트케이스를 분석하기 시작했더라면 달랐을 것 같다. 몇몇 테스트케이스는 알고리즘이 어느 정도 TestCase - fit하게 작성되지 않으면 점수 얻어 내기 어려운 것들이었기 때문이다.
하지만 가장 큰 문제는 realloc함수를 설계할 때 생겼다.
기존에 제공된 realloc함수는 아무 추가 처리 없이 항상 새로운 가용 공간에 할당하는 식이었다.
막상 까 보면 고려해야 할 조건이 꽤나 많던데...
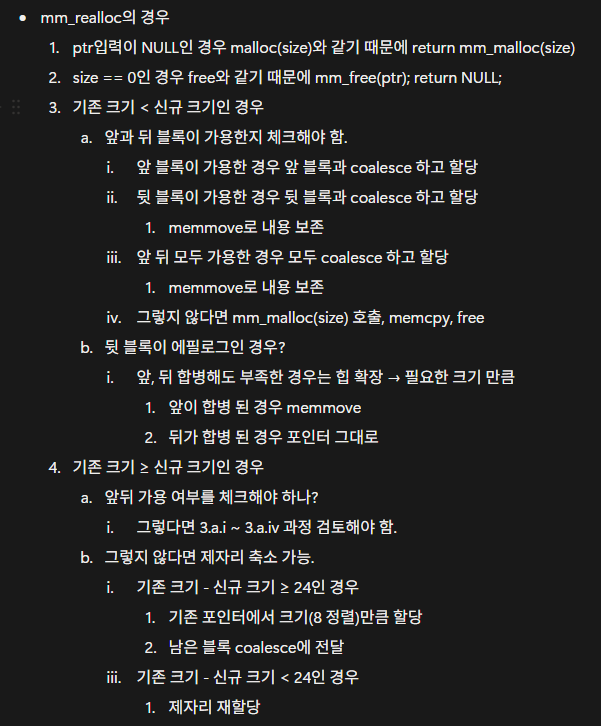
한 조건을 생각하고 나면 다른 곳에 추가할 조건이 떠오르고, 또 다른 곳에 추가하고... 이런 반복을 거치다 보니 문서도 와일드해진 느낌이 있다.
이런 상태에서 구현을 하려고 하니 당연하게도 구현이 어려울 수 밖에 없었던 것 같다.
구상한 조건을 하나씩 생각하면서 조건문을 작성해 나갔는데 조건문이 끝도 없이 많아지고 끝없이 중첩되어 가니까 어느 순간 손이 멈춰 버렸다.
주간 발표 시간에 사용한 그림을 가져와 보면
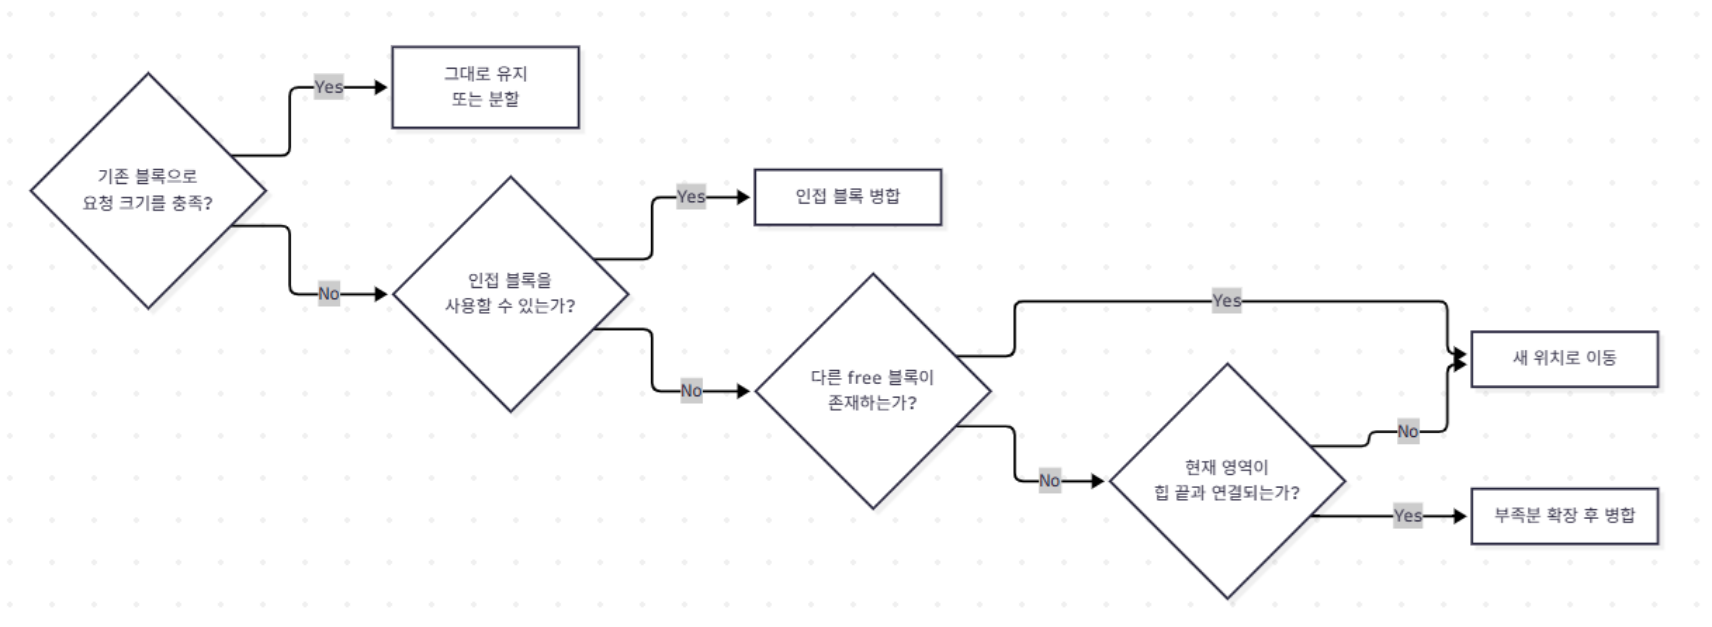
극히 일부의 조건을 가져온 것 뿐인데도 벌써 복잡하다. 그 때 어떻게 코드를 잡고 있었는지 기억나지도 않는다. 도저히 안 되겠다 싶어서 중간에 구조를 변경하기로 했다.
가장 복잡했던 확장 조건을 크게 줄였다,
사실 상 조건문 4개로 축소
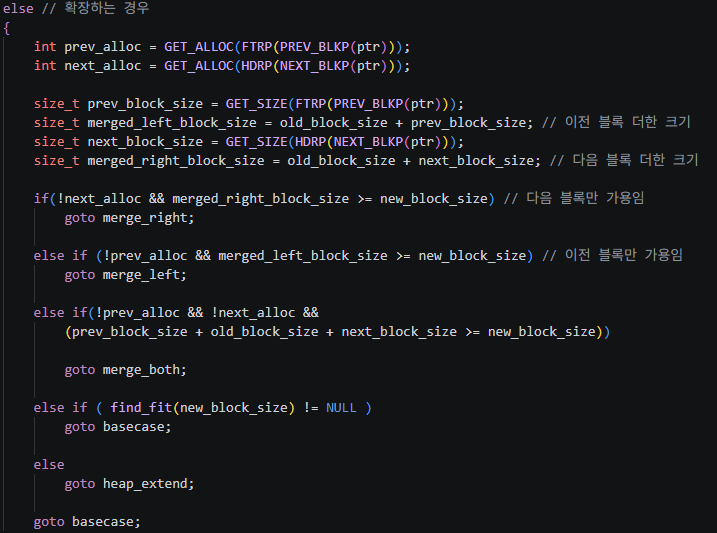
따져야 할 조건이 많은건 사실이었지만 결국 그 조건들이 그룹으로 묶여 처리될 수 있었다는 걸 알았다.
if - else문으로 묶인 조건문에서, else나 else if 문 안의 조건들은 보다 위의 if문의 조건을 만족하지 않는 케이스들이지 않은가?
너무 당연한 말이지만 막상 구현할 때 전혀 신경쓰지 못했다.
추가로, 조건들 안에서 new_block_size와 계산하도록 하여 중첩의 단계를 하나 줄였다.
결과적으론 조건문의 중첩도 줄었고 개수가 크게 줄어들 수 있었다.
결론
담고 싶은 내용은 더 있는데 시간 관계 상 이만 줄이고...
goto문을 사용하게 된 이유가 반복문 중첩 때문이었는데 조건문 최적화 이후에 중첩 단계가 크게 줄어들어 버려서 의미없는 코드인가 하는 생각도 들었는데, 분기 제어나 조건 / 실행 블록을 나누는 측면에서 이득을 챙겼던 것 같다.
이번 과제 진행하면서 설계의 중요성을 크게 체감했다. 조건문 최적화 과정에 생각했던 설계를 문서로 남겨 두지 않았던 게 조금 마음에 걸린다. 과제 시간 동안 시간을 가장 많이 썼던 부분이 설계였고 실제 코딩은 얼마 하지 않았던 것 같다. 설계가 되어야 코드로 나오는 거긴 하니까 너무 당연한가?
확실히 지금까지의 과제보단 난이도가 있어서 시간이 좀 더 걸렸는데 생각할 게 많아서 힘드면서도 재밌었던 것 같다. 구현한 코드가 점수로 나오기도 해서 더 체감된 듯?
이번 과제 중간쯤 든 생각이 "테스트케이스를 유저 습관이라고 생각하고 최적화해도 될까?"하는 의문이었다.
테스트케이스는 너무 지엽적이니까 매몰되는 게 좋지 않을 것이라는 생각도 들고, 혹은 보편적 시스템의 축소 버전이라고 생각해도 되니까 테스트케이스 맞춤도 괜찮지 않을까? 하는 고민도 생기고...
다음주 과제부터는 일단 테스트케이스를 분석해보는 방향으로 갈 것 같다. 테스트케이스 = 유저 데이터라고 고려할만 하다고 생각되기도 하고, 조금 더 큰 규모의 프로젝트, 조금 더 보편적인 테스트케이스가 주어질 것이니 앞으로의 방향성을 확실히 잡아보려고 한다.
Pintos 화이팅!
다들 화이팅입니다!