많은 요청과 데이터를 실시간으로 처리할 때, 병목 현상이 발생하면 시스템의 성능에 치명적이다.
시스템 성능 저하의 주된 원인 중 하나가 데이터베이스이므로,
이를 해결하기 위해서는 병목 지점을 파악하고 해결해야 한다.
병목(Bottleneck) 현상
특정 구간에서 처리량이 줄어들면서 전체 시스템의 성능이 떨어지는 현상
병목 현상의 원인
- 느린 쿼리
- 비효율적인 인덱스
- 과도한 I/O
- CPU 자원 고갈
- 락 충돌
성능의 병목은 단일 SQL 문장에서 시작될 수 있으며, 궁극적으로 시스템 전체의 반응성을 저하시킬 수 있다.
1. 병목 현상을 해결하는 방법
1.1 인덱스 최적화
인덱스 (Index)
데이터베이스에서 검색 속도를 향상시키기 위해 사용하는 자료구조
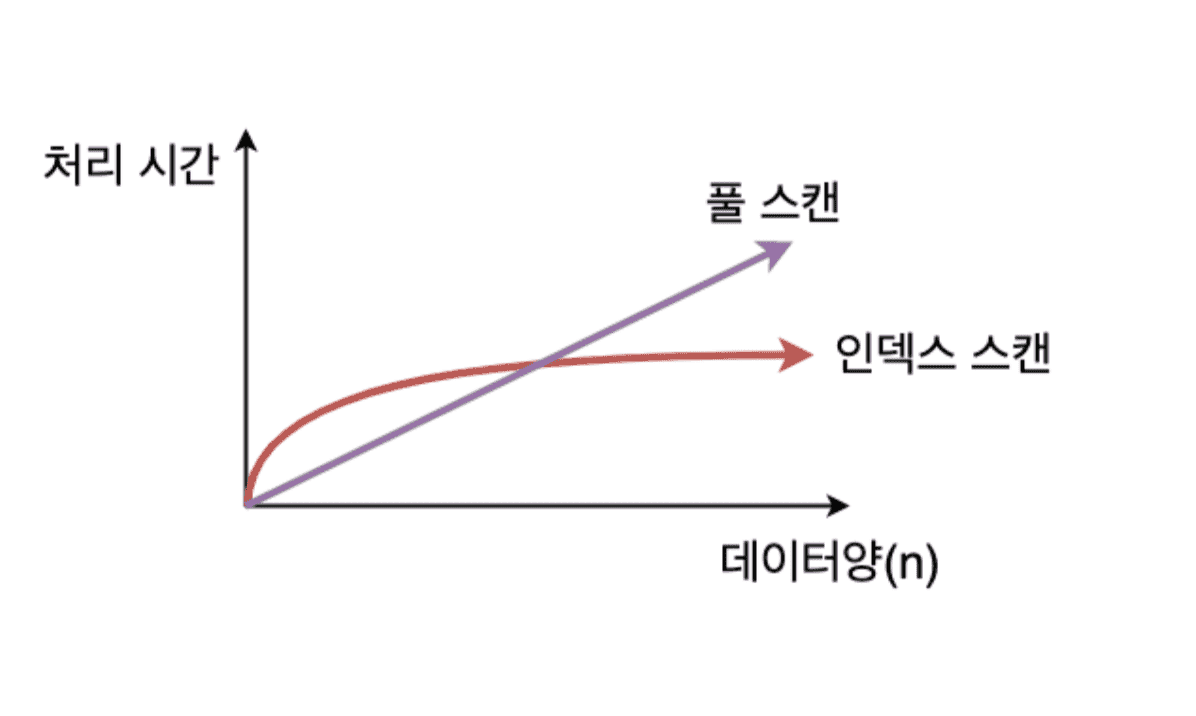
특정 컬럼에 인덱스를 걸어두면 검색 시 전체 테이블을 순회하지 않아도 된다. (Full scan 하지 않아도 된다.)
인덱스 튜닝 전략
자주 검색되는 컬럼에만 인덱스를 적용하되, 너무 많은 인덱스는 오히려 성능 저하를 유발할 수 있다.
- 복합 인덱스 사용 시에는 WHERE 절의 조건 순서에 주의해야 한다.
- 인덱스를 사용할 수 없는 쿼리 패턴 (ex. LIKE '%값', 함수 사용 등)을 피해야 한다.
✔️ 인덱스는 읽기 성능(R)을 향상시키지만, 삽입/수정/삭제(CUD) 시에는 오히려 오버헤드가 발생한다.
참고: 인덱스가 CUD 성능을 저하시키는 이유
1.2 실행 계획 분석
쿼리가 느리다면, 가장 먼저 실행 계획을 확인하는 것이 방법이다.
실행 계획(Execution Plan)
DB가 쿼리를 어떻게 실행할지 계획을 보여주는 도구
어떤 인덱스를 쓰는지, 전체 테이블을 순회하는지 등을 분석할 수 있다.
예시 실행 쿼리
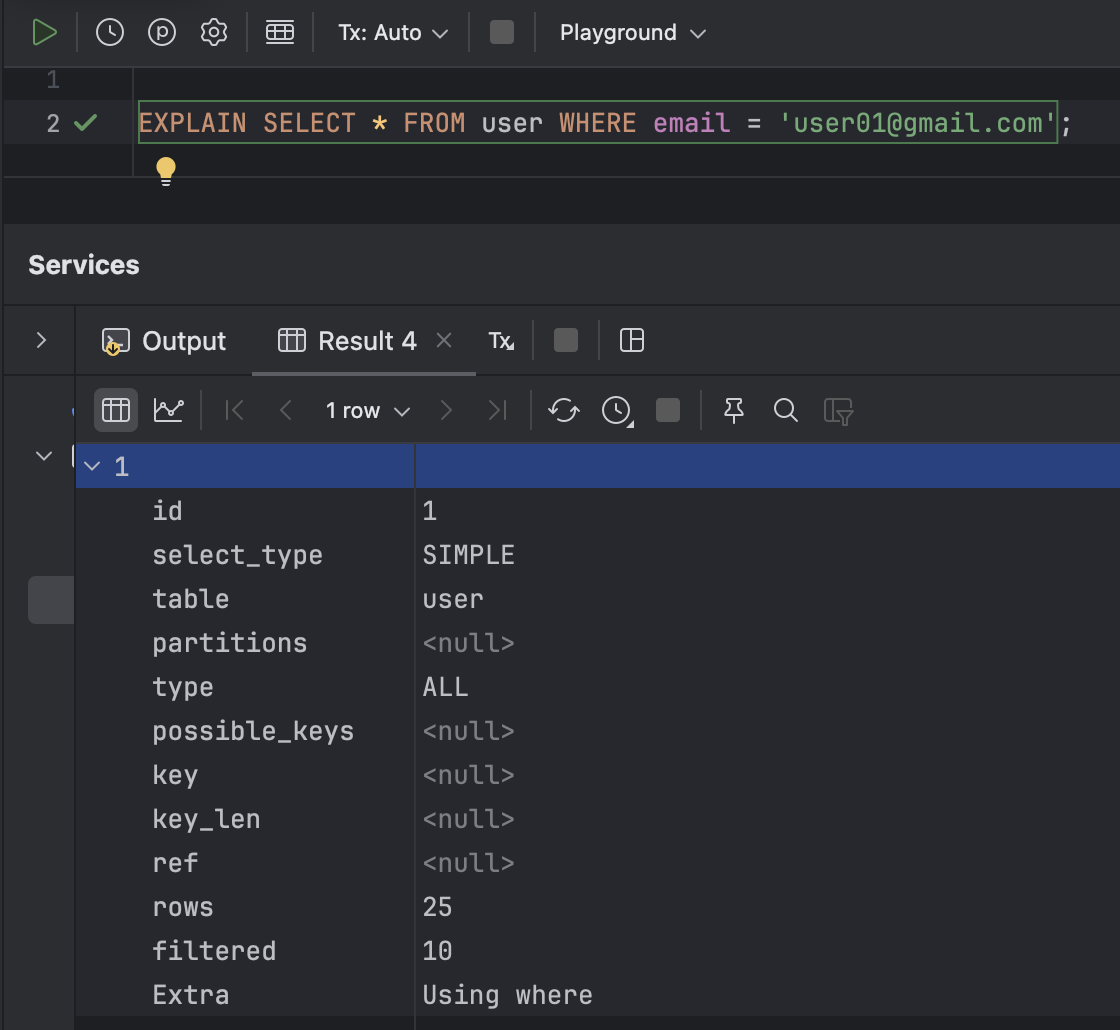
EXPLAIN SELECT * FROM user WHERE email = 'user01@gmail.com';결과
결과 해석
현재 쿼리는 user 테이블에 대해 인덱스를 사용하지 않고 전체 테이블을 순차적으로 검색(Full Table Scan)하고 있으며, WHERE 조건이 존재하지만 효율적인 인덱스가 없어 성능이 저하될 수 있는 상태
주요 컬럼 설명
- id: 쿼리의 고유 식별자. 서브쿼리가 있다면 id가 다르게 부여됨
- select_type: 쿼리 유형
- table: 접근 중인 테이블 이름
- partitions: 사용된 파티션 (파티셔닝 사용 시에만 의미 O)
- type: 조인 타입 또는 액세스 방법
- possible_keys: 사용 가능한 인덱스 목록
- key: 실제 사용된 인덱스
- key_len: 사용된 인덱스의 길이 (바이트 단위)
- ref: 어떤 컬럼을 기준으로 인덱스를 사용했는지
- rows: MySQL이 예측하는 읽을 레코드 수
- filtered: 조건을 만족하는 레코드 비율
- Extra: 추가 정보 (e.g., Using index, Using where)
EXPLAIN 실행 계획 결과를 해석 시의 주요 지표
1. Full Table Scan type: ALL
"테이블 전체를 처음부터 끝까지 다 읽는다"는 뜻으로,
조건절(WHERE)에 인덱스를 사용하지 못해서, 모든 레코드를 검사하게 되는 경우이다.
성능이 가장 낮은 방식이며, 테이블이 클수록 처리 시간이 급격히 증가하게 된다.
보통은 인덱스가 누락되어 있거나, 조건절이 인덱스를 타지 못할 때 발생한다.
SELECT * FROM user WHERE email = 'abc@example.com';
-- email 컬럼에 인덱스가 없다면 → Full Table Scan 발생
2. Index Range Scan type: range
인덱스를 사용하되, 범위 조건에 해당하는 값만 스캔하는 경우이다.
BETWEEN, <, >, LIKE 'abc%'등 범위 조건이 있을 때 발생한다.
효율적인 방식이며, 인덱스를 잘 타고 들어간다는 뜻이다.
type: range, key: index_name 등의 조합으로 확인이 가능하다.
SELECT * FROM orders WHERE created_at BETWEEN '2024-01-01' AND '2024-12-31';
-- created_at에 인덱스가 있으면 Index Range Scan 수행
3. Using Temporary / Using Filesort
정렬 또는 그룹핑 과정에서 성능 저하가 발생할 수 있다는 경고 신호이다.
-
Using Temporary
쿼리 결과를 처리하는 중간 과정에서 임시 테이블을 생성했음을 의미
이 임시 테이블은 메모리에 생성되지만, 일정 크기를 초과하면 디스크로 쓰이게 되며, 디스크 I/O가 발생하면 성능에 큰 영향을 줄 수 있습니다.GROUP BY, DISTINCT, UNION, ORDER BY 등 결과를 중간에 정리하거나 묶는 쿼리에서 자주 발생
SELECT category, COUNT(*) FROM products GROUP BY category;
-- category별로 데이터를 그룹화하고 집계하므로, MySQL은 중간 결과를 임시 테이블에 저장하면서 처리할 수 있다.
임시 테이블은 메모리에 생성되면 부담이 적지만, 크기가 클 경우 디스크로 넘어가고 성능 저하가 발생하므로,
특히 정렬, 그룹화가 많은 대용량 쿼리에서 주의가 필요하다.
-
Using Filesort
정렬을 위해 인덱스를 사용하지 못하고, 별도의 정렬 작업을 수행했음을 의미말 그대로 파일 정렬이라고 표현되지만, 실제로는 메모리 정렬이 기본이며, 경우에 따라 디스크에 데이터를 쓰기도 한다.
인덱스를 사용한 정렬이 아니기 때문에 성능이 떨어질 수 있다.
ORDER BY절이 있지만, 정렬에 적합한 인덱스가 없는 경우 발생한다.SELECT * FROM users ORDER BY created_at DESC; -- created_at 컬럼에 적절한 인덱스가 없다면, MySQL은 전 데이터를 읽은 후 별도로 정렬 작업을 수행하게 된다.인덱스를 활용한 정렬(index scan + order)이 아닌 경우, 이 작업은 추가적인 메모리/디스크 사용과 정렬 비용을 발생시킨다.
또한, 데이터 양이 많을수록 성능 저하가 커지게 된다.
1.3 파티셔닝(Partitioning)
대용량 테이블을 여러 개의 작은 물리적 단위로 분할하여 성능을 향상시키는 기법
필요한 파티션만 읽기 떄문에 속도가 빨라 쿼리의 성능을 향상시킬 수 있다.
또한, 오래된 데이터만 파티션 단위로 삭제가 가능하므로 데이터 관리에 용이하다.
종류
- Range Partitioning: 날짜나 숫자 범위 기반으로 분할
- Hash Partitioning: 해시값 기준으로 균등 분할
- List Partitioning: 명시된 값 리스트로 분할 (예: 지역 코드)
1.4 캐싱 전략
데이터베이스 성능 최적화에서 캐싱은 핵심적인 전략 중 하나이다.
자주 조회되지만 자주 변경되지 않는 데이터를 캐시해두면
DB 부하를 줄이고 응답 속도를 향상시킬 수 있다.
캐시는 일반적으로 다음 세 가지 수준에서 사용된다.
- 애플리케이션 레벨 캐시 (Application-Level Cache)
- 쿼리 결과 캐시 (ORM / SQL Mapper 캐시)
- DB 캐시 힌트 (Query-Level Hinting)
1. 애플리케이션 레벨 캐시 (Application-Level Cache)
- 대표 기술: Redis, Memcached
애플리케이션 외부에 별도의 인메모리 캐시 서버를 두고 데이터를 저장해두는 방식이다.
장점
- 네트워크로 연결되지만 매우 빠른 속도로 접근 가능 (수 ms 내외)
- DB와 무관하게 캐시 서버를 확장할 수 있어 확장성 우수
- 다양한 자료구조(Hash, List, Set 등)를 지원해 유연한 캐싱 가능
사용 예시
- 로그인 유저 세션 정보
- 인기 게시글 리스트
- 실시간 랭킹, 카운터 등
대부분의 웹 서비스는 Redis를 이용해 캐시뿐 아니라 세션, 메시지 큐, 분산락 등 다양한 용도로 활용한다.
2. 쿼리 결과 캐시 (ORM / SQL Mapper 캐시)
- 대표 기술: Hibernate 2차 캐시, MyBatis 캐시 등
ORM 프레임워크나 SQL 매퍼는 동일한 쿼리에 대해 반복적으로 동일한 결과를 반환할 경우, 이를 내부적으로 캐시해주는 기능을 제공한다.
1차 캐시
트랜잭션 범위에서 엔티티를 캐시 (예: JPA의 영속성 컨텍스트)
2차 캐시
애플리케이션 범위 또는 전역 범위에서 캐싱 (예: Hibernate + EhCache / Redis)
장점
- 캐싱 전략을 코드/설정 수준에서 손쉽게 제어할 수 있다.
- 영속성 컨텍스트를 통해 엔티티 간 관계를 효율적으로 관리 가능하다.
단점
- 엔티티 단위의 캐싱이기 때문에 구조적으로 제약이 생길 수 있다.
- 복잡한 쿼리에는 적합하지 않을 수 있다.
3. DB 캐시 힌트 (Query-Level Hinting)
- 예시: MySQL, Oracle 등의 SQL Hint 사용
데이터베이스 자체의 쿼리 실행 계획에 영향을 주는 힌트(Hint)를 사용해 캐시를 적극적으로 활용하도록 유도하는 방식이다.
이 방식은 SQL문 안에 힌트를 직접 넣는다.
예시 (Oracle)
SELECT /*+ RESULT_CACHE */ name FROM users WHERE id = 1;MySQL 5.7 이하에서는 Query Cache 기능이 있었지만, MySQL 8.0부터는 완전히 제거되었다.
그 이유는?
장점
- DBMS 차원에서 가장 가까운 위치에 캐시 적용이 가능하다.
- 복잡한 쿼리 최적화에 직접 개입할 수 있다.
단점
- DBMS 종속적이며 이식성이 떨어질 수 있다.
- 힌트를 남용하면 오히려 성능을 저하시킬 수 있다.
⚠️ 캐싱의 주의사항 - 데이터 일관성 vs 성능
캐시는 기본적으로 원본 데이터와 분리되어 관리되기 때문에, 최신 데이터와의 불일치(일관성 문제)가 발생할 수 있다.
예를 들어, 캐시에 저장된 데이터가 갱신되기 전에 DB의 값이 변경되면, 오래된 데이터를 보여주게 된다.따라서, 다음과 같은 정책 설계가 중요하게 여겨진다.
- TTL(Time-To-Live) 설정: 일정 시간 이후 자동 만료
- Cache Eviction 정책: 변경이 감지되면 수동 삭제 or 무효화
- Write-through / Write-behind / Cache-aside 패턴 등 전략 선택
- 동기화 고려: 다중 인스턴스 환경에서의 캐시 동기화 문제 해결
2. 대용량 데이터 처리 전략
- Batch 처리: 데이터를 한 번에 처리하지 않고 분할 처리 (페이징, Chunking 등)
- 비동기 처리: 조회 또는 저장 요청을 큐에 쌓아 병렬로 처리
- Read Replica: 읽기 요청 전용 복제 DB 구성으로 부하 분산
조회 성능 향상 TIP
- SELECT * 사용 지양: 필요한 컬럼만 지정
- JOIN 최소화: 필요한 경우에만, 인덱스 설계와 함께 사용
- LIMIT + OFFSET 주의: 페이지 번호가 커질수록 성능 저하 → 커서 기반 페이지네이션 고려