Grafana Pyroscope 기초부터 심화까지 그리고 AIOps 에이전트와 ML 활용
이 글에서 다룰 주제
- 프로파일링과 flame graph의 원리를 이해하고, 실제 CPU 프로파일을 읽는다.
- SDK·Alloy 수집 방식과 Pyroscope v2의 저장·조회 구조를 살펴본다.
- 프로파일을 AIOps 에이전트의 조사 근거와 ML의 학습 데이터로 활용한다.
- 성능 회귀, 비용 최적화, 용량 계획, ML 서비스 운영으로 활용 범위를 넓힌다.
주요 단어 · Continuous Profiling · CPU Profile · Flame Graph · Self와 Total · Grafana Alloy · AIOps · MCP · 특징 추출 · 이상 탐지
서비스의 CPU 사용률이 높아졌다는 알림을 받았다고 하자. 메트릭은 변화가 시작된 시점을 알려 준다. 트레이스는 느린 요청과 호출 구간을 보여 준다. 그런데 애플리케이션 내부의 어떤 함수가 CPU를 사용했는지는 여전히 모를 수 있다.
이 질문을 좁혀 가는 데 사용하는 관측 신호가 프로파일(profile)이다. Grafana Pyroscope는 프로파일을 지속적으로 수집·저장하고, 시간과 서비스 조건으로 조회하도록 돕는 오픈소스 시스템이다. 함수와 호출 경로에 귀속되는 자원 사용을 살펴볼 수 있다. Pyroscope 소개
먼저 활용 가능성부터 짚으면, Pyroscope는 AIOps 에이전트의 조회 도구로 사용할 수 있고, 프로파일을 가공하면 ML 모델의 입력 데이터로도 사용할 수 있다. 다만 프로파일 저장소, 생성형 AI의 설명, ML 모델의 학습은 서로 다른 계층이다. 이 구분을 바탕으로 기초부터 연결해 보자.
자료 범위 — 제품 설명은 2026-10-04 확인한 공식 문서 기준이다. 당시 Pyroscope
latest는 v2.3.x였다. 로컬 CPU 프로파일 실습, 설명용 계산, ML 합성 데이터 예제의 검증 범위는 각 절에서 구분한다. AIOps 파이프라인은 구현 방향을 제안하는 설계이며 운영 환경에서 검증한 제품 성능을 뜻하지 않는다.
1. 프로파일링의 역할
1.1 네 가지 관측 신호
가상의 demo-api에서 검색 요청이 느려졌다고 생각해 보자. 각 신호는 조사에 필요한 서로 다른 단서를 제공한다.
| 신호 | 확인할 질문 | 검색 API의 예 |
|---|---|---|
| 메트릭 | 언제, 얼마나 달라졌는가? | 요청량·CPU·p95 지연이 함께 증가했는가? |
| 로그 | 어떤 사건과 상태가 기록됐는가? | 타임아웃·재시도·큰 응답에 관한 기록이 있는가? |
| 트레이스 | 요청이 어떤 경로를 거쳤는가? | DB 호출, 외부 API, 내부 처리 중 어느 구간이 길었는가? |
| 프로파일 | 자원이 어떤 코드 경로에 사용됐는가? | 정렬·직렬화·압축·GC 중 어디에 CPU가 집중됐는가? |
예를 들어 트레이스에서 응답 생성 구간이 길고, 같은 서비스·시간의 CPU 프로파일에서 직렬화 함수의 비중이 커졌다면 조사 범위를 좁힐 수 있다. 그러나 응답 크기 자체가 증가했을 가능성도 남는다. 프로파일은 원인 가설의 근거이고, 함수 이름만으로 버그를 확정하는 장치는 아니다.
지속적 프로파일링(Continuous Profiling)은 프로파일을 평소에도 반복 수집하여 장애 이전과 이후의 코드 실행 특성을 비교하는 방식이다. 장애가 끝난 뒤 계측을 켜는 것과 달리, 이미 저장된 과거 구간을 조사할 수 있다는 장점이 있다. 지속적 프로파일링
1.2 CPU 시간과 응답 시간
요청 하나가 2초 걸렸다고 해서 CPU를 2초 사용했다고 볼 수는 없다. CPU 실행은 100ms였고 나머지는 DB 응답을 기다렸을 수도 있다. 반대로 여러 스레드가 병렬로 실행되면 CPU 시간의 합이 경과시간보다 커질 수도 있다.
따라서 CPU 프로파일의 넓은 구간은 선택한 데이터에서 CPU 소비가 큰 호출 경로를 뜻한다. 요청의 전체 지연, 네트워크 대기, GPU 커널 실행시간을 모두 설명하지는 않는다. 대기가 의심되면 트레이스와 지원되는 wall·off-CPU·lock 프로파일을 함께 확인한다. 프로파일 유형
2. 프로파일의 종류
샘플링 — 일정한 방식으로 실행 상태를 관찰하고 표본을 모으는 방법이다. 모든 함수 호출을 하나씩 기록하는 것과 다르므로, 짧은 실행은 표본에 잡히지 않을 수 있다.
CPU 샘플링은 실행 중인 호출 스택을 모아 어느 경로에 CPU 시간이 귀속되는지 추정한다. 구체적인 수집 방식과 단위는 프로파일러마다 다르다. 메모리 프로파일도 할당 사건을 표본화하는 방식과 살아 있는 객체를 보는 방식이 다르므로, 화면의 타입과 단위를 먼저 확인해야 한다.
| 프로파일 | 주로 확인하는 것 | 혼동하기 쉬운 해석 |
|---|---|---|
| CPU | 실행에 CPU를 많이 쓴 함수·스택 | 요청의 경과시간과 동일하다고 해석 |
| Allocation | 객체·바이트를 많이 할당한 코드 | 많이 할당하면 곧바로 메모리 누수라고 판단 |
| In-use / Live heap | 관측 시점에 살아 있는 객체·메모리 | 누적 할당량이나 프로세스 전체 RSS와 동일시 |
| Mutex / Lock / Block | 락 경합·블로킹에 관련된 시간·횟수 | 모든 언어와 수집기에서 동일한 의미라고 가정 |
| Wall / Off-CPU | 실행·대기를 포함하는 시간 또는 CPU 밖의 대기 | 서로 다른 프로파일러의 측정 대상을 동일시 |
| Goroutine 등 런타임별 유형 | 런타임 실행 단위의 상태·수 | CPU 프로파일과 같은 분모로 무조건 합산 |
지원 범위는 언어 + 런타임 + SDK/수집기 버전 + OS + 수집 방식으로 결정된다. Go SDK와 Java 프로파일러, Python SDK, eBPF가 같은 타입을 모두 제공하는 것은 아니다. 예를 들어 최신 Python SDK에는 별도로 켜는 메모리 프로파일링 옵션이 있으므로, 오래된 글의 “Python은 CPU만 지원한다”는 설명을 그대로 적용하면 안 된다. 지원 유형 표, Python SDK
위 표는 프로파일을 읽을 때의 판단 기준을 정리한 것이다. 메모리 스냅샷과 할당 프로파일의 차이는 Go runtime/pprof와 유형별 의미 안내에서도 확인할 수 있다.
메모리 누수가 의심된다면 allocation 증가와 함께 GC 이후에도 live heap이 계속 증가하는지, 트래픽과 캐시 크기는 어떻게 변했는지 확인한다. 프로파일은 객체를 어디서 할당했는지 찾는 데 도움이 되지만, 객체의 전체 참조 관계와 해제 불가능한 이유는 heap dump 같은 추가 자료가 필요할 수 있다.
3. 수집부터 조회까지
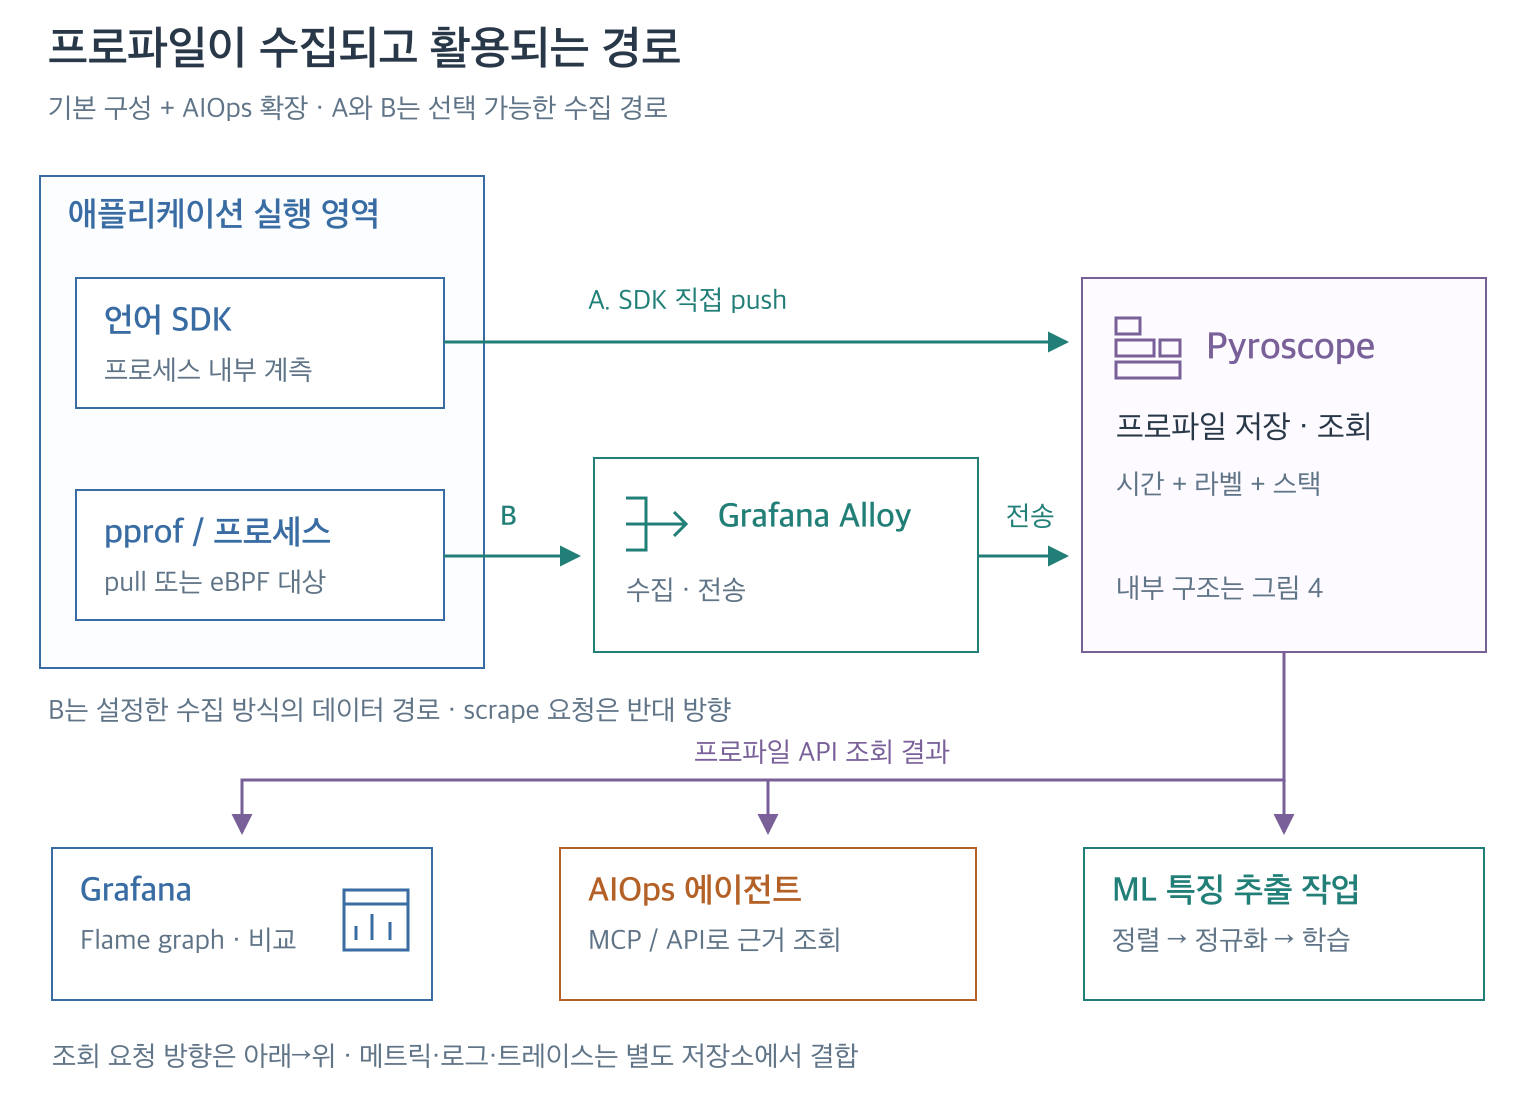
그림 1. 작성자 제작 개념도. 위쪽은 프로파일 데이터의 전송, 아래쪽은 API 조회 결과의 활용이다. 아래 조회자들이 보내는 요청은 화살표의 반대 방향이다. SDK → Alloy → Pyroscope 경로도 가능하며 도식에서는 생략했다. 기호는 제품 로고 대신 역할을 나타내는 자체 도형을 사용했다.
Pyroscope를 이해할 때는 프로파일러, 수집기, 백엔드, 화면을 구분하면 편하다. 언어 SDK나 시스템 프로파일러가 실행 상태를 관찰하고, Pyroscope가 그 결과를 저장·집계하며, Grafana 또는 Pyroscope UI가 보여 준다.
3.1 세 가지 수집 선택
| 경로 | 선택할 상황 | 확인할 조건 |
|---|---|---|
| 앱 SDK → Pyroscope | 한 서비스부터 빠르게 시작할 때 | 언어·플랫폼 지원, 인증·전송 설정 |
| 앱 SDK → Alloy → Pyroscope | 전송·인증·라벨 처리를 수집기로 모을 때 | pyroscope.receive_http와 전달 경로 |
| Alloy → 대상 계측 → Pyroscope | Go pprof pull, Java 프로파일링, eBPF 수집을 운영할 때 | 대상 발견, 접근 권한, 런타임·커널 지원 |
SDK는 애플리케이션이 아는 작업 종류를 라벨로 붙이기 좋다. Alloy는 대상 발견과 전송 설정을 한곳에서 관리하는 데 유용하다. 어느 경로든 실제 프로파일을 생성하는 계측이 있어야 한다. Grafana에 데이터 소스를 등록하는 작업만으로 애플리케이션 계측까지 완료되지는 않는다. 수집 방식 선택
Alloy의 pull 방식에서는 수집 요청이 Alloy → pprof 엔드포인트, 데이터 응답은 반대로 움직인다. 따라서 앱에서 백엔드로 직접 나가는 push와 네트워크 접근 조건이 다르다. 운영에서 연결 문제를 조사할 때 유용한 구분이다.
3.2 eBPF의 적용 범위
eBPF 기반 수집은 애플리케이션 코드를 수정하기 어려운 환경에서 검토할 수 있다. 다만 Linux 커널 기능에 의존하며, 호스트 프로세스를 관찰할 권한과 심볼 해석 조건이 필요하다. macOS 호스트에 설치한 수집기가 Linux eBPF 프로파일러와 똑같이 동작한다고 생각해서는 안 된다. 플랫폼 지원
현재 Alloy pyroscope.ebpf 문서에는 off-CPU 옵션과 OBI 호환 계측을 통한 trace/span 상관 정보도 설명되어 있다. 반면 일부 일반 Pyroscope 문서는 이전 지원 범위를 안내한다. 그러므로 “eBPF는 언제나 CPU만 가능하다” 또는 “eBPF만 켜면 모든 span 연결이 된다”는 식으로 일반화하지 말고, 사용하는 Alloy 버전의 컴포넌트 문서와 실제 수집 결과를 확인한다. Alloy eBPF 컴포넌트
4. Flame graph 읽기
Flame graph는 호출 스택과 자원 사용량을 함께 표시하는 그림이다. 블록은 함수·스택 프레임, 너비는 선택한 프로파일 값의 비중, 세로는 호출 계층이다. 일반적인 flame graph에서 가로 위치는 실행 순서가 아니다. 너비의 단위도 CPU 프로파일이면 시간, 메모리 프로파일이면 바이트나 객체 수 등으로 달라진다. Flame graph
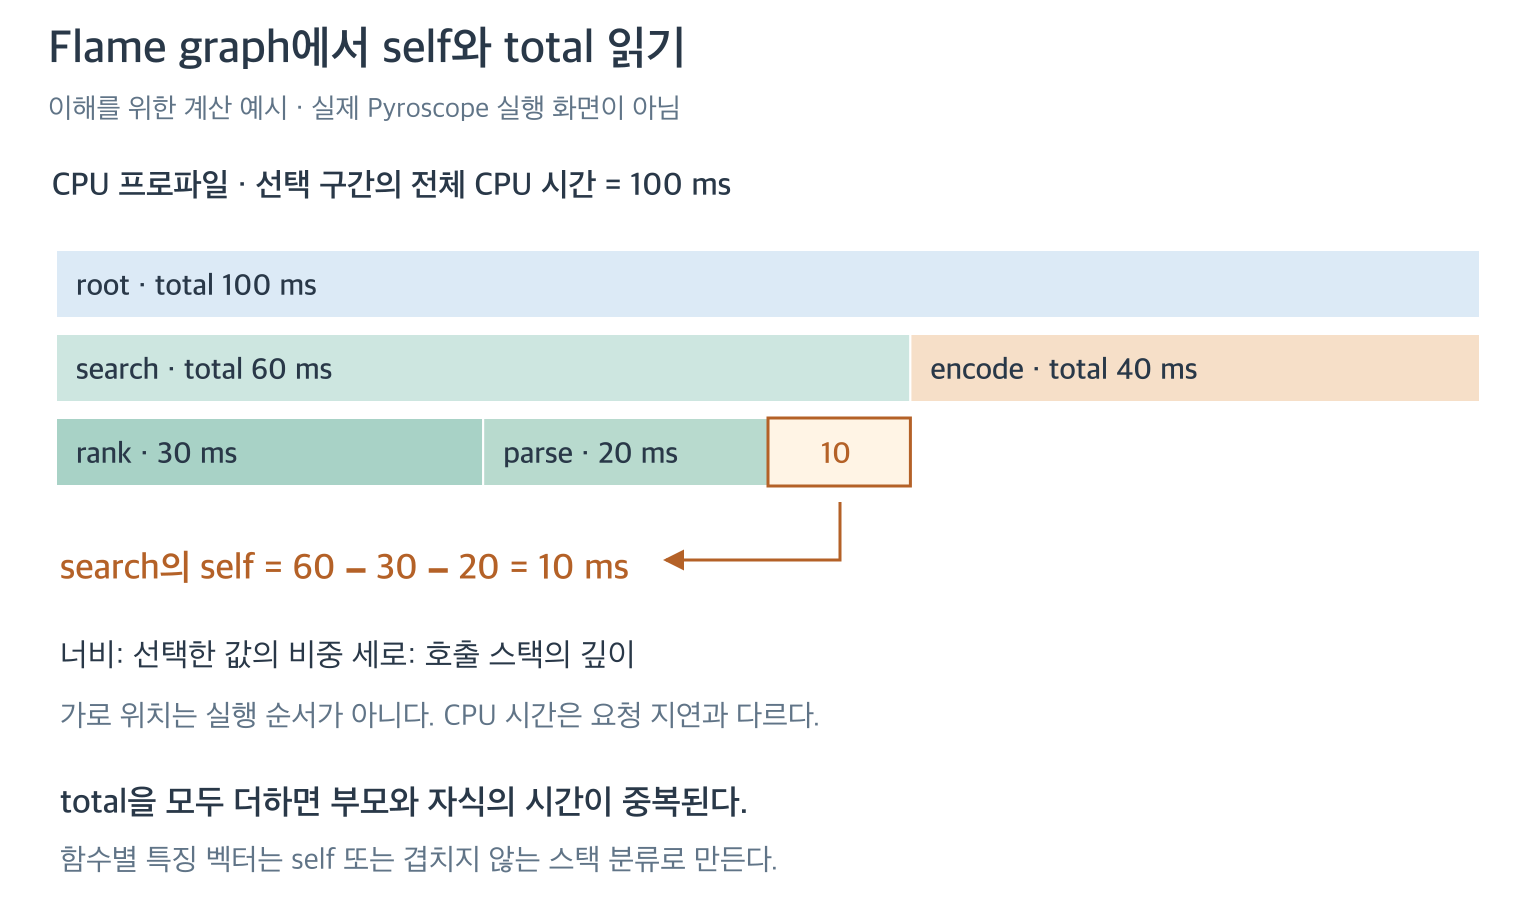
그림 2. 설명용 계산 예시. 위에서 아래로 호출 계층을 펼쳤다. 노란 10ms는 search 자체에 귀속된 CPU 시간이며 실제 UI 캡처가 아니다.
4.1 Self와 Total
search의 total이 60ms이고, 그 아래 rank가 30ms, parse가 20ms라고 하자.
search total = search self + rank total + parse total
60 ms = 10 ms + 30 ms + 20 ms- Self는 그 함수 자체에 귀속되는 값이다.
- Total은 하위 호출을 포함한 값이다.
이 예제에서 search는 비용이 큰 경로의 입구다. 하지만 실제 최적화 대상은 하위 함수 rank일 수 있다. 부모와 자식의 total을 전부 더하면 같은 CPU 시간이 중복 계산된다. 이 함정은 뒤에서 ML 특징을 만들 때도 중요하다. Self와 Total
4.2 비중과 절대값
함수 비중이 20%에서 40%가 되었다고 해서 그 함수가 두 배 느려졌다고 볼 수는 없다. 전체 CPU 시간이 100ms에서 50ms로 줄었다면 해당 함수의 CPU 시간은 두 구간 모두 20ms다.
비교할 때는 같은 profile type과 단위를 고른 뒤, 시간 길이·요청량·입력 크기·복제본 범위·프로파일 수집 범위를 맞춘다. UI의 차이 색상만 보고 결론을 내리기보다 절대 CPU 시간, 비중, 요청당 CPU를 함께 읽는 습관이 필요하다.
5. CPU 프로파일 실습
이 실습의 목적은 합성 CPU 작업을 실행하고 main.burnCPU라는 함수가 프로파일에서 보이는지 확인하는 것이다. HTTP 검색 API나 DB는 실행하지 않는다. 서비스 이름은 앞의 설명과 맞춰 demo-api로 정했다.
Pyroscope 2.3.1, Go 1.25.13, Go SDK 1.4.0을 Linux ARM64 컨테이너에서 실행했다. 실습에 필요한 설정과 전체 코드는 15절 재현 부록에 제공한다. 이미지 태그·digest와 SDK 버전을 고정했으며, 아래 결과는 이 환경에서 직접 수집한 것이다.
5.1 계측 코드
다음은 실습 프로그램에서 계측을 설정하는 핵심 부분이다. 전체 프로그램에는 종료 처리와 제한된 합성 부하 생성 코드가 포함된다.
profiler, err := pyroscope.Start(pyroscope.Config{
    ApplicationName: "demo-api",
    ServerAddress:   os.Getenv("PYROSCOPE_SERVER_ADDRESS"),
    Logger:          pyroscope.StandardLogger,
    Tags: map[string]string{
        "env": "lab",
        "version": "v1",
    },
    ProfileTypes: []pyroscope.ProfileType{pyroscope.ProfileCPU},
    UploadRate:   10 * time.Second,
})
if err != nil {
    log.Fatal(err)
}
defer profiler.Stop()ServerAddress는 프로파일을 보낼 주소다. Compose 내부 앱에는 http://pyroscope:4040을 사용한다. 컨테이너 안의 localhost는 해당 컨테이너 자신이므로 다른 컨테이너를 가리키는 주소로 쓰지 않는다. UploadRate는 전송 간격이며 CPU 샘플을 관찰하는 주파수와 같은 개념이 아니다. Go SDK
# 15절의 파일을 저장한 lab 폴더에서 실행한다.
docker compose -p pyroscope-study-20261004 -f compose.yaml config --quiet
docker compose -p pyroscope-study-20261004 -f compose.yaml up -d --build
브라우저에서는 http://127.0.0.1:14440을 연다. UI에서 demo-api와 CPU 프로파일을 고르고, 앱이 실행 중인 최근 구간을 조회한다. 프로파일은 바로 나타나지 않을 수 있으므로 전송·저장 시간을 포함한 구간을 선택한다.
5.2 조건과 결과 읽기
조회 조건은 다음처럼 읽는다. 아래 문자열은 라벨 선택자이며, CPU 타입과 시간 범위는 별도로 선택한다.
{service_name="demo-api", env="lab"}Pyroscope의 선택자가 Prometheus 라벨 선택자와 비슷하다고 해서 PromQL 전체를 지원하는 것은 아니다. rate() 같은 PromQL 함수를 이 문자열에 그대로 붙이지 않는다. 실제 프로파일 타입 이름은 수집기에 따라 다를 수 있으므로 UI나 ProfileTypes API에서 먼저 확인한다. 쿼리 편집기
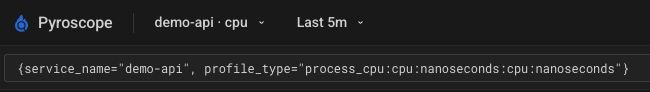
그림 3a. 직접 실행한 Pyroscope 자체 UI의 조회 조건이다. 이 UI는 선택한 CPU 타입을 profile_type과 함께 표시한다.
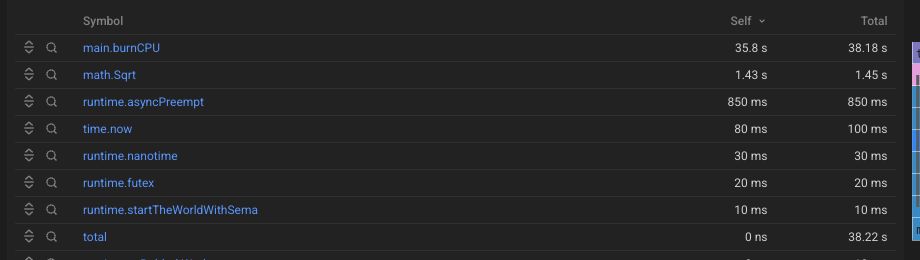
그림 3b. 실제 프로파일 표. 전체 CPU 시간은 38.22초이며 main.burnCPU는 Self 35.80초, Total 38.18초다.
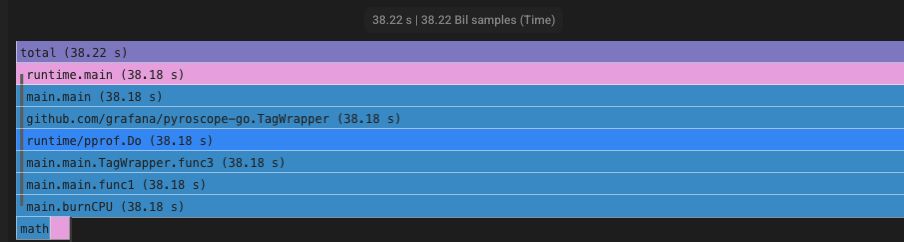
그림 3c. 같은 결과의 호출 스택 상세. runtime.main → main.main → TagWrapper → main.burnCPU로 이어지는 경로를 읽을 수 있다.
조회창은 2026-10-04 21:05:09–21:10:09 KST, 실제 수집 시작은 약 21:06:53이었다. 전체 5분을 빠짐없이 수집한 데이터가 아니다. 화면의 38.22초는 그 결과에 포함된 누적 CPU 시간이며 요청 지연이나 서버 CPU 사용률이 아니다.
이번 자체 UI에서는 추가 라벨 입력의 실제 전달이 확인되지 않아 위 화면은 기본 서비스·타입 조회로 검증했다. env=lab, operation=synthetic_cpu 필터는 15절의 query.py에 있는 SelectMergeStacktraces 요청으로 별도 확인했다. Grafana 쿼리 편집기와 자체 UI의 입력 형식·동작을 동일하다고 가정하지 않는다. 원본 화면의 CPU CORES 축 역시 이번 실습의 CPU 제한과 일치하지 않아 코어 사용률의 근거로 사용하지 않았다.
읽을 때는 먼저 서비스·환경·기간이 맞는지 확인하고, main.burnCPU가 어느 경로에서 호출되는지 본다. CPU를 쓰는 합성 함수를 의도적으로 넣었기 때문에 해당 경로가 크게 나타나는 것이 기대 동작이다. 이 실습 수치를 일반적인 서비스의 CPU 비용이나 Pyroscope 오버헤드 측정값으로 사용해서는 안 된다.
프로파일이 없다면 앱의 전송 로그, 서버 주소, 조회 기간, 라벨, 선택한 타입을 차례로 확인한다. No data는 CPU 사용량 0과 다르다. 전송 지연이나 잘못된 필터일 수 있다.
실습을 마친 뒤 해당 프로젝트를 정리한다. --volumes는 이 실습의 저장 데이터를 함께 지우므로 결과를 보존할 필요가 있으면 제외한다.
docker compose -p pyroscope-study-20261004 -f compose.yaml down --volumes6. 트레이스와 프로파일 연결
같은 서비스의 같은 시간대를 비교하는 것과, 특정 요청의 span에 해당하는 프로파일을 찾는 것은 다르다.
시간·서비스 기반 연결은 장애 시간의 프로파일을 넓게 찾는 방법이다. 이때 여러 요청과 백그라운드 작업이 섞일 수 있다. Span profile은 지원되는 계측 경로에서 span과 프로파일의 연결 정보를 남겨 더 좁게 조사하는 방법이다.
SDK 방식에서는 프로파일 SDK, OpenTelemetry 트레이싱, 언어별 연결 라이브러리, Grafana의 Tempo → Pyroscope 설정이 필요하다. 서비스·환경 라벨과 시간 조건도 맞아야 한다. 짧은 span은 CPU 샘플을 받지 못할 수 있고, 대부분의 시간을 I/O 대기에 쓰는 span은 CPU 프로파일이 희박할 수 있다. Traces to profiles 설정
가령 2초 걸린 DB span에 CPU 프로파일이 거의 없다는 이유로 계측 실패부터 의심할 필요는 없다. 애플리케이션이 DB를 기다렸다면 자연스러운 결과일 수 있다. 반면 해당 시간에 다른 요청은 충분히 수집됐는지 확인해야 “대기”와 “수집 실패”를 구분할 수 있다.
이 글의 로컬 실습에서는 CPU 수집만 검증했다. Tempo 연결과 span 계측까지 수행한 결과는 아니다.
7. Pyroscope v2 아키텍처
처음에는 단일 프로세스로 시작할 수 있지만, 서비스 수·프로파일 양·동시 조회가 늘면 저장과 질의의 운영 특성을 이해해야 한다.
Pyroscope 2.0에서 v2 저장 아키텍처가 기본화되었다. 기존 v1의 ingester, querier, store-gateway 중심 구성과 구분해야 한다. 2.0은 전환점이지 이 글에서 확인한 최신 버전 번호는 아니다. 2.0 릴리스 노트, 2.3 릴리스 노트
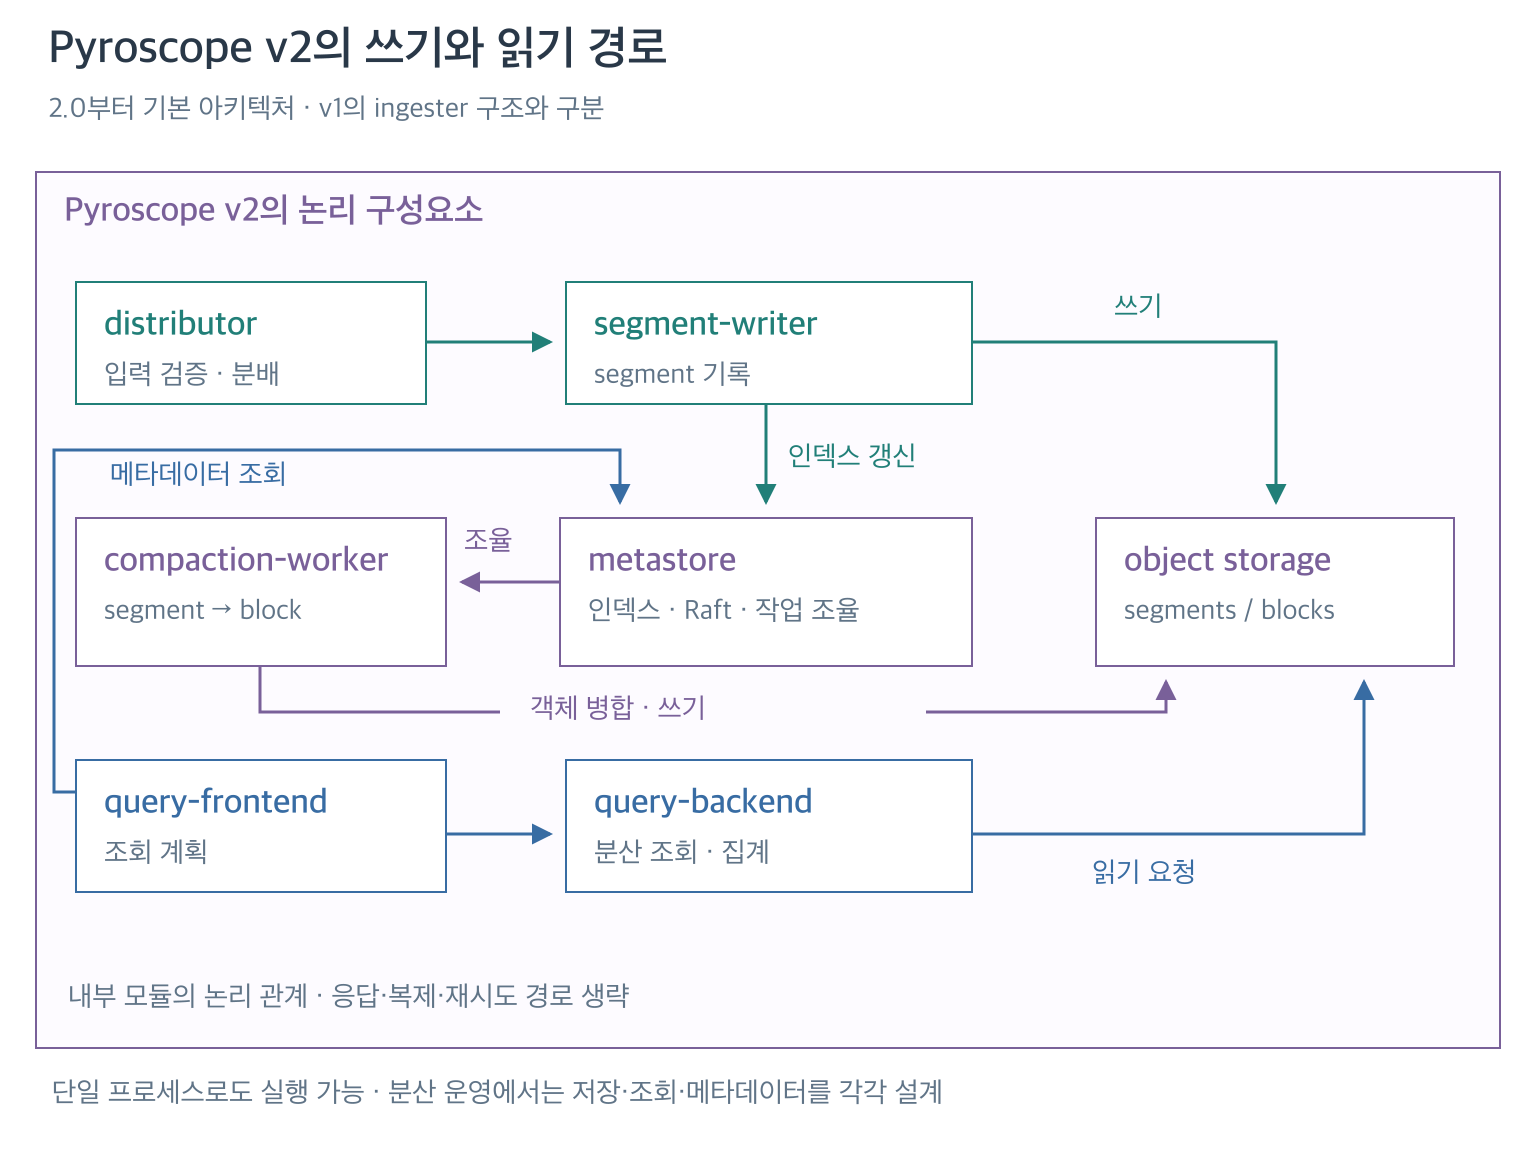
그림 4. 공식 v2 구조를 바탕으로 다시 그린 논리 구성도. 쓰기·조회 요청·작업 조율을 선의 라벨로 구분했다. 응답, 복제, 재시도와 compaction의 객체 읽기 세부 경로는 생략했다. 상자 하나가 반드시 별도 컨테이너 하나를 뜻하지는 않는다.
7.1 쓰기와 조회
쓰기 경로에서 distributor는 입력을 검증·분배하고, segment-writer는 작은 segment를 객체 저장소에 기록하면서 metastore에 메타데이터를 등록한다. 조회 경로에서는 query-frontend가 조회를 계획하고 메타데이터를 찾으며, query-backend가 객체 데이터를 읽고 집계한다. v2 구조
작은 객체가 계속 쌓이면 읽어야 할 객체와 메타데이터가 많아진다. compaction-worker는 작은 segment를 큰 block으로 합쳐 조회 부담을 줄인다. 이 작업은 metastore가 조율한다. v2 Compaction
metastore는 Raft를 사용하는 상태 저장 구성요소다. 따라서 “v2는 전부 stateless라 데이터 보호를 신경 쓰지 않아도 된다”는 설명은 틀리다. 객체 데이터와 메타데이터 각각의 보존·장애 복구 경로를 확인해야 한다. Metastore
7.2 운영에서의 의미
운영 설계에서는 쓰기 부하와 조회 부하를 따로 본다. 예를 들어 에이전트 수십 개가 하루치 프로파일을 동시에 병합 조회하면, 평소 사람 몇 명이 10분 구간을 보는 것과 전혀 다른 부하가 생긴다. 조회 기간·동시성·결과 크기를 제한하고, 반복되는 분석에는 가공한 특징값을 재사용하는 편이 합리적이다.
v1에서 v2로 이동할 때는 저장 형식과 구성요소 변경을 포함한 마이그레이션으로 취급한다. 이미지 태그만 바꾸면 모든 기존 데이터와 운영 설정이 자동 변환된다고 가정하지 않는다. 단일 노드의 로컬 파일 저장과 분산 환경의 객체 저장도 구분한다. 업그레이드 안내
8. 운영 품질과 비용
8.1 라벨과 카디널리티
라벨은 비교할 대상을 나누는 기준이다. service_name, env, region, version, 제한된 operation 값처럼 조사에 필요한 항목부터 정한다.
카디널리티(cardinality)는 고유한 값 또는 라벨 조합의 수를 가리킨다. 매 요청의 ID, 사용자 ID, 원문 URL, 검색어를 라벨로 넣으면 조합이 빠르게 늘 수 있다. /users/12345 대신 /users/:id 같은 제한된 작업 분류를 검토하고, 개별 요청 연결은 지원되는 span 연동 경로로 처리한다.
배포 버전도 무조건 버리는 것이 정답은 아니다. 회귀 비교에 유용하지만 오래된 버전이 계속 쌓이는 비용이 있으므로, 실제 비교 기간과 보존 정책을 함께 정한다. 높은 카디널리티를 피하는 것과 필요한 조사 맥락을 잃지 않는 것 사이에서 선택해야 한다.
8.2 오버헤드와 수집 품질
도입 전후를 같은 부하에서 비교하여 앱 CPU·RSS·p95 지연·전송량을 측정한다. 프로파일 주기, 스택 깊이, 메모리·락 수집 설정에 따라 비용이 달라지므로 모든 서비스에 일정한 오버헤드 수치를 약속할 수 없다.
수집 대상 프로세스 수, 전송 오류, 조회 가능한 최근 시각, 심볼이 해석되지 않는 비중도 본다. 전체 복제본 중 일부만 프로파일링했다면 그 CPU 합을 전체 서비스 요청 수로 나누면 안 된다. 대상 범위를 맞추거나, 수집 표본의 대표성을 검증한 별도 추정으로 표시해야 한다.
수집 범위가 50%라는 숫자를 알아도 CPU 값을 기계적으로 두 배로 보정할 수 있는 것은 아니다. 유실이 특정 노드·부하·함수에 치우쳤다면 관측되지 않은 절반의 분포가 다를 수 있다.
8.3 접근 경계
Pyroscope 서버 API의 멀티테넌트 식별자와 인증은 같은 기능이 아니다. 공식 API 문서는 외부 인증 계층 사용을 안내한다. 에이전트가 전달한 임의 X-Scope-OrgID를 그대로 신뢰하기보다, 인증된 주체의 tenant와 조회 범위를 서버 측에서 고정하는 구조가 필요하다. 서버 API와 인증
프로파일에는 함수명, 파일 경로, 라벨 같은 내부 정보가 포함될 수 있다. LLM에 전달할 때는 필요한 상위 함수·차이·단위·시간 범위부터 제공하고, 전체 원시 스택과 저장소 소스를 무조건 보내지 않는다.
9. AIOps 에이전트 활용
9.1 Agent라는 말의 구분
이 주제에서 agent는 세 가지 의미로 쓰일 수 있다.
| 구분 | 역할 | Pyroscope와의 관계 |
|---|---|---|
| 수집 에이전트 | 프로세스를 계측하고 데이터를 전송 | Alloy, 언어별 프로파일러 등 |
| LLM 에이전트 | 질문을 나누고 도구를 호출하여 조사 | Pyroscope를 근거 조회 도구로 사용 |
| ML 분석 서비스 | 특징값을 입력받아 점수·예측 생성 | 프로파일에서 만든 수치 데이터를 소비 |
Pyroscope를 AIOps에 붙인다는 말은 이 셋 중 무엇을 만드는지 명확해야 한다. 이 절에서는 두 번째인 장애 조사 에이전트를 다룬다.
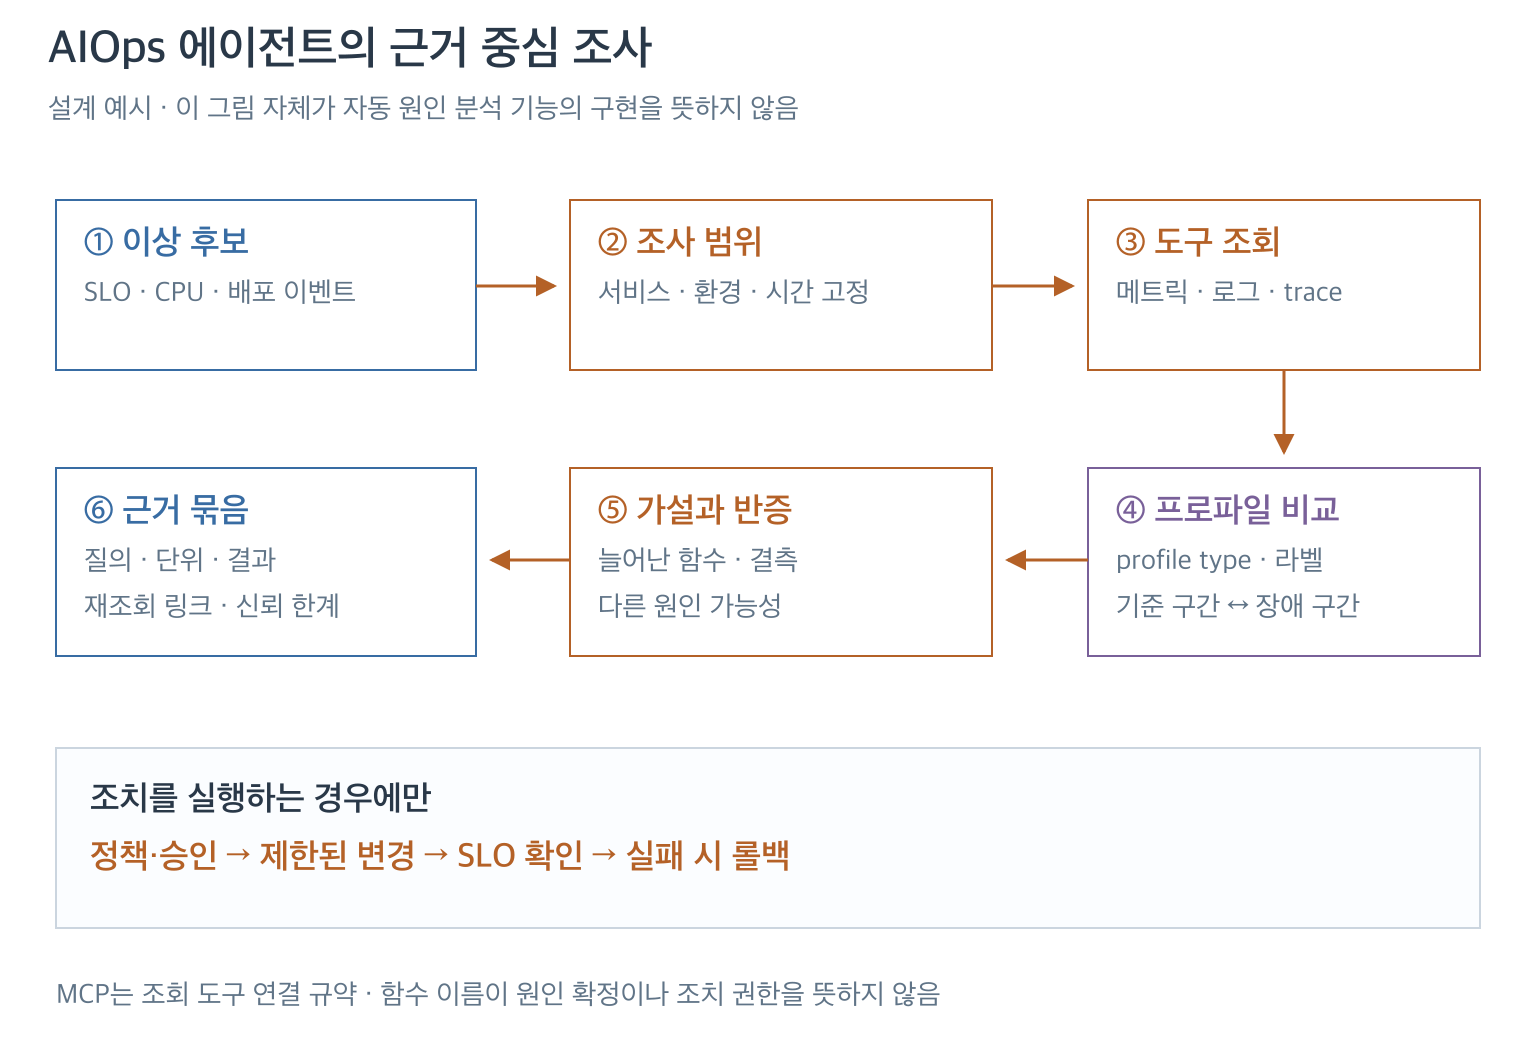
그림 5. 제안하는 조사 흐름. 프로파일은 다른 관측 신호와 함께 가설을 좁히는 근거로 사용한다. 자동 조치까지 구현한다면 읽기 도구와 별도의 실행 정책이 필요하다.
9.2 API와 MCP 도구
MCP는 에이전트가 외부 도구의 기능과 입력 형식을 발견하고 호출하는 데 쓰는 규약이다. Pyroscope가 MCP를 통해 별도의 AI 모델로 변하는 것은 아니다.
공식 grafana/mcp-grafana의 확인 당시 main 구현에는 다음 도구가 있다.
| 도구 | 용도 |
|---|---|
list_pyroscope_profile_types | 해당 시간에 실제 존재하는 프로파일 타입 확인 |
list_pyroscope_label_names | 조회할 라벨 이름 탐색 |
list_pyroscope_label_values | 서비스·환경·버전 등의 값 탐색 |
query_pyroscope | 프로파일, 파생 시계열 또는 둘을 조회 |
조회 도구를 활성화하는 설정에 따라 등록 여부가 달라진다. main 소스와 배포된 릴리스·Cloud MCP의 도구 목록도 다를 수 있다. 연결한 서버의 tools/list에서 실제 이름과 스키마를 먼저 확인한다. 과거 예제의 fetch_pyroscope_profile을 현재 환경에서도 존재하는 도구로 가정하지 않는다. 공식 Pyroscope MCP 구현
직접 어댑터를 만든다면 ProfileTypes, SelectSeries, SelectMergeStacktraces, Diff 같은 서버 API를 활용할 수 있다. 현재 문서는 SelectMergeProfile을 deprecated로 표시하고 pprof 출력에도 SelectMergeStacktraces 경로를 안내한다. 위 Querier API의 start와 end는 epoch milliseconds이므로 seconds와 혼동하지 않는다. 서버 API
9.3 근거를 남기는 조사
가상의 장애를 다음 순서로 조사할 수 있다.
- 메트릭에서 영향을 받은 서비스와 시간, 요청량·지연·오류 변화를 확인한다.
- 같은 서비스·환경에서 CPU 프로파일이 존재하는지 확인한다.
- 정상 구간과 장애 구간의 길이, 타입, 복제본 범위를 맞춰 조회한다.
- 함수별 self, 호출 경로의 total, 요청당 CPU 변화를 비교한다.
- 배포 변경, 트레이스, 입력 크기·캐시·재시도 정보를 조회해 대안 가설을 확인한다.
- 관찰한 사실, 남은 가설, 다음 검증 방법을 근거와 함께 반환한다.
다음은 실제 장애 결과가 아닌 에이전트 출력 설계 예시다.
demo-api의 배포 이후serialize경로에 귀속되는 요청당 CPU가 증가했다. 요청량은 유사하지만 응답 크기 분포는 확인되지 않았다. 직렬화 코드의 회귀와 payload 증가가 후보이며, 배포 diff와 응답 크기를 확인한 뒤 동일 부하의 canary로 검증한다.
출력에는 조회 selector, profile type, 시작·종료 시각과 시간대, 단위, 수집 대상, 기준 구간, 원본 링크를 남긴다. Top-N 결과라면 생략된 나머지 비중과 잘림 여부도 필요하다. 상위 함수 목록만 받고 전체 분포를 확인한 것처럼 설명하면 안 된다.
도구 어댑터에는 서비스 허용 목록, 최대 조회 구간, 최대 노드 수, 호출 횟수, 타임아웃을 둔다. 로그·함수명·소스 주석에 포함된 문자열은 조사 데이터이며 에이전트의 권한을 바꾸는 지시로 해석하지 않는다. 재시작이나 롤백까지 수행한다면 실행 도구, 승인 정책, 변경 후 SLO 검증, 중단 조건을 별도로 설계한다.
9.4 이미 제공되는 AI 기능
공식 Flame graph AI는 flame graph와 diff의 해석을 돕는다. Cloud에서는 Grafana Assistant 경로가 있고, OSS Grafana에도 버전·플러그인 조건을 갖춘 LLM 연동 경로가 문서화되어 있다. Pyroscope 백엔드만 설치하면 자동 활성화되는 기능으로 이해해서는 안 된다. 설치한 Grafana·Profiles Drilldown 버전의 전용 안내를 확인한다. Flame graph AI
자체 에이전트는 이 기능과 별개로 회사의 런북, 배포 이벤트, 장애 이력까지 조합할 때 의미가 있다. LLM이 설명을 만들었다는 사실과 설명이 관측 근거에 맞는지는 별도로 평가한다.
10. AIOps ML의 입력 데이터
활용 가능하다. 프로파일에는 함수·스택 단위의 자원 분포라는 수치 정보가 있기 때문이다. 다만 Pyroscope 자체를 범용 모델 학습 엔진으로 설명하는 것은 정확하지 않다. 다음 데이터 파이프라인을 추가하는 설계다.
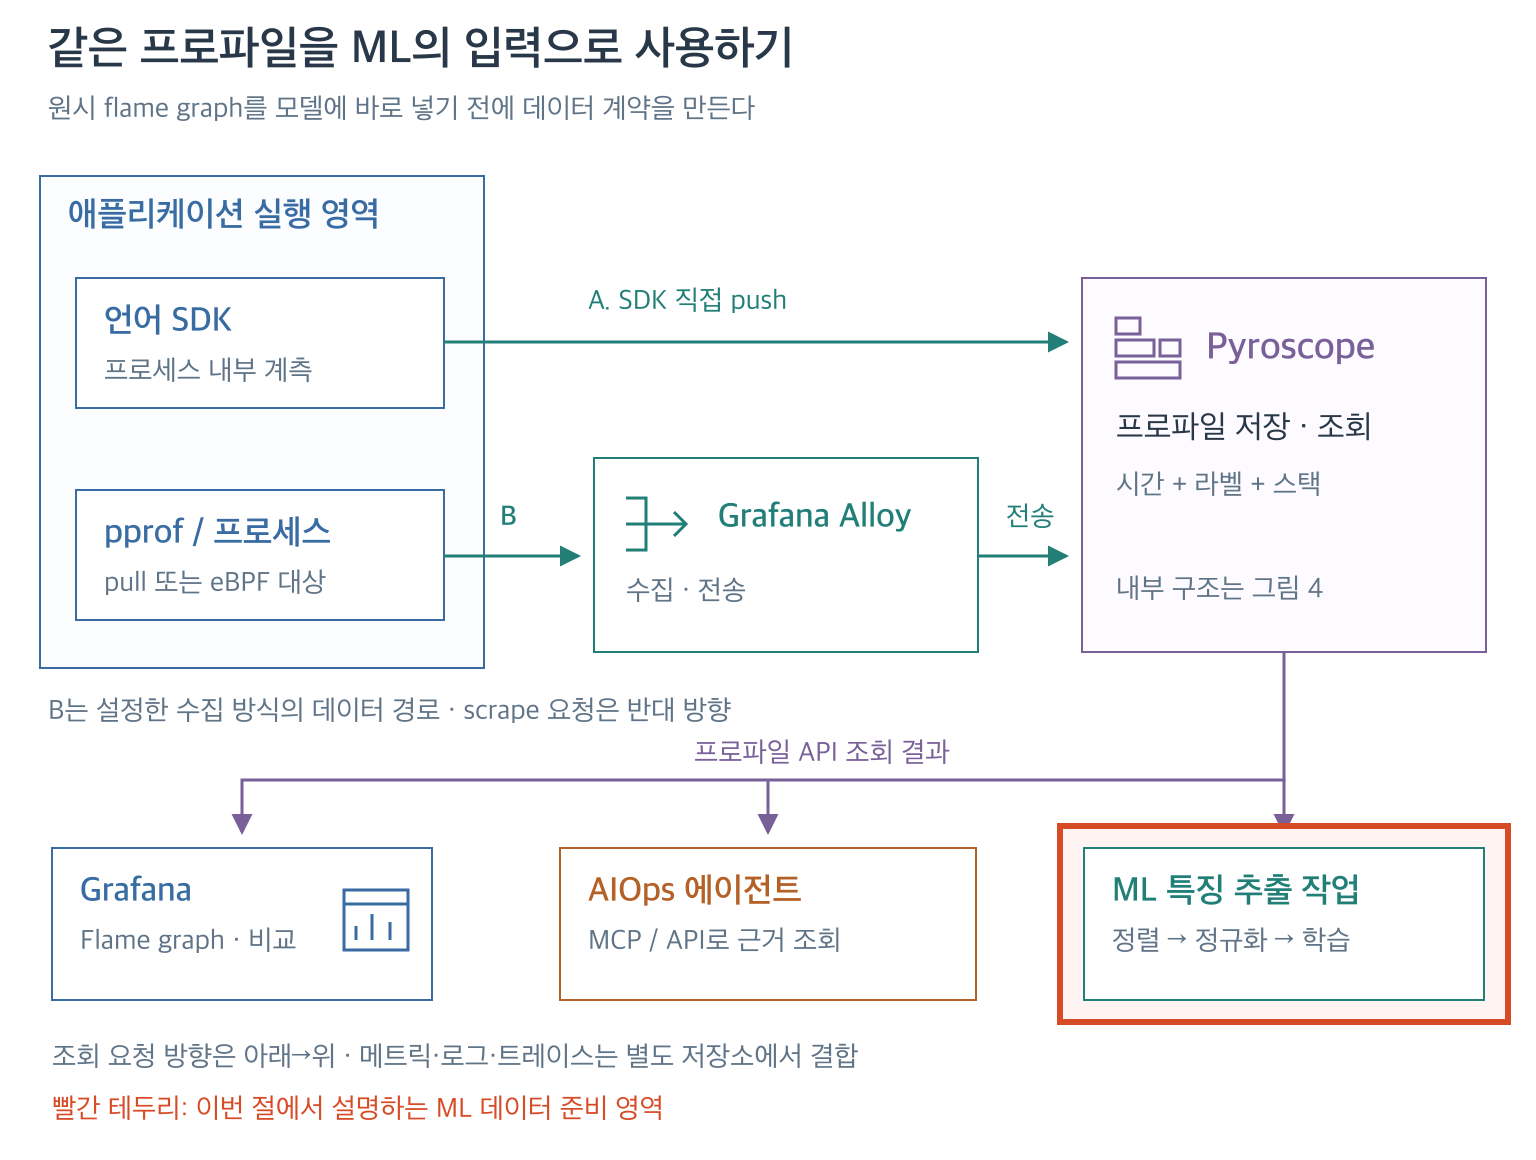
그림 6. 그림 1과 같은 배치에서 ML의 데이터 준비 영역을 강조했다. 아래의 학습·추론 단계는 별도 구현 영역이다.
Pyroscope API / 사용 가능한 recording rules
    → 타입·단위·수집 범위 확인
    → 5분 등 고정 창으로 시간 정렬
    → 요청량·배포·입력 크기·복제본 정보 결합
    → 특징 테이블
    → 시간 순 학습·검증
    → 이상 점수·예측·유사 장애 후보
    → 알림과 에이전트 조사에 전달
Grafana Cloud ML의 지원 데이터 소스 목록만으로 Pyroscope 원시 프로파일을 직접 학습할 수 있다고 판단해서는 안 된다. 실무적으로는 API로 특징 테이블을 만들거나, 프로파일에서 파생한 시계열을 지원되는 메트릭 데이터 소스로 보내는 경로를 검토한다. Grafana ML 지원 데이터 소스
10.1 한 행의 의미
한 행을 다음과 같이 정의할 수 있다. 이는 이 글에서 제안하는 데이터 계약이다.
(service, env, workload_class, version, window_start, window_end)workload_class는 작업 부류다. 예를 들어 작은 응답과 큰 응답, 검색과 일괄 내보내기를 섞으면 정상적인 작업 변화가 코드 회귀처럼 보일 수 있다. 경로와 입력 크기를 제한된 부류로 나누거나 모델의 설명 변수로 넣는다.
함께 기록할 품질 필드는 profile_type, 원본 단위, 프로파일러 버전, 관측한 복제본, 수집 커버리지, 실제 sample 수, 심볼 해석 실패율 등이다. 원본에서 얻지 못한 필드는 임의 추정값으로 채우지 말고 “미확인”으로 구분한다.
10.2 특징의 계산
동일한 대상과 시간 창에서 CPU 시간이 초 단위라면 다음처럼 정의할 수 있다.
요청당 CPU(ms/request) = CPU_seconds × 1000 / request_count
평균 사용 코어 상당량 = CPU_seconds / window_seconds
함수 self 비중 = function_self_CPU_seconds / total_CPU_seconds
300초 동안 CPU 시간이 600초라면 평균 사용 코어 상당량은 2다. 이것을 “CPU 200%라서 잘못된 데이터”라고 해석하지 않는다. 관측 대상의 할당 CPU 용량 대비 사용률을 원한다면 해당 대상의 CPU quota와 스로틀링 조건까지 추가로 봐야 한다. 호스트 물리 코어 수로 나눈 사용률과는 분모가 다르다.
| 특징 | 도움이 되는 질문 | 계산의 조건 |
|---|---|---|
| 요청당 전체 CPU | 같은 일을 처리하는 계산 비용이 늘었는가? | 요청 수와 CPU의 대상 범위가 같아야 함 |
| 함수별 self CPU/request | 비용 증가가 어느 함수에 집중됐는가? | 부모·자식 total의 중복을 피함 |
| 할당 바이트/request | 메모리 할당 압력이 커졌는가? | allocation과 live heap을 구분 |
| GC·lock 관련 값 | 자원 증가가 런타임·경합과 연결되는가? | 해당 타입의 단위와 지원 여부 확인 |
| 스택 분포의 거리 | 전체 실행 경로가 평소와 달라졌는가? | 심볼·버전·작업 구성이 비교 가능해야 함 |
| RPS·p95·오류율·배포 | 변화의 맥락과 사용자 영향은 무엇인가? | 다른 저장소와 시간·서비스 기준 정렬 |
서비스 전체 CPU에는 백그라운드 작업도 섞일 수 있다. 따라서 CPU/request는 서비스 수준의 효율 지표이지, 각 요청의 CPU 시간을 직접 측정한 값은 아니다. 요청 수가 0이면 나눗셈을 정의하지 않는다. 결측 프로파일을 0으로 채우는 것도 피한다.
함수 벡터를 만들 때는 self를 쓰거나 서로 겹치지 않는 스택 분류를 정의한다. Top-K 함수를 선택했다면 나머지를 other로 보존해야 비중의 분모가 유지된다. 다만 심볼이 해석되지 않은 값은 단순 other와 구분하여 품질 신호로 남기는 편이 좋다.
10.3 Recording rules의 조건
Grafana Cloud Profiles의 recording rules는 프로파일을 메트릭으로 내보내는 경로를 제공한다. 확인한 문서에서는 private preview이며 지원팀 활성화가 필요한 기능이었다. 이를 모든 OSS·Cloud 설치에서 기본 제공되는 기능으로 전제하면 안 된다. Cloud Profiles recording rules
Pyroscope 데이터 소스의 기본 Alerting 지원도 확인한 문서에서는 No다. 따라서 이 설계에서의 알림은 파생 메트릭이나 외부 모델이 반환한 점수를 지원 데이터 소스에 기록해 평가하는 경로다. Pyroscope 데이터 소스 기능
이 경로로 생성되는 값은 이름에 _total이 들어가더라도 gauge다. 공식 안내는 구간 합산에 sum_over_time을 사용한다. 이름만 보고 counter라고 판단해 rate()를 적용하면 잘못된 결과를 만들 수 있다. 또한 함수가 포함된 스택을 선택해 만든 값은 self와 다를 수 있다. 타입·집계 의미를 확인한 뒤 특징으로 사용해야 한다.
CPU 시간 구간값의 합산 방식도 live heap 스냅샷에 그대로 적용할 수 없다. 메모리 스냅샷을 시간에 따라 모두 더한 값은 할당량이 아니기 때문이다. 단위와 시간에 따른 값의 의미가 데이터 계약의 일부여야 한다.
11. 합성 데이터로 보는 정규화
CPU가 두 배가 되는 두 상황을 비교해 보자. 아래 수치는 설명을 위해 만든 합성 데이터이며 실제 demo-api 부하 실험에서 얻은 값이 아니다. 모든 복제본이 관측되고 백그라운드 작업이 없다고 가정한다.
| 5분 구간 | 요청률 | 요청 수 | CPU 시간 | 평균 코어 상당량 | 요청당 CPU |
|---|---|---|---|---|---|
| 정상 기준 | 100 req/s | 30,000 | 120s | 0.4 | 4ms |
| 트래픽 증가 | 200 req/s | 60,000 | 240s | 0.8 | 4ms |
| 비용 회귀 가정 | 100 req/s | 30,000 | 240s | 0.8 | 8ms |
CPU 시간만 보면 마지막 두 행은 같다. 요청당 CPU를 보면 트래픽 증가 구간은 효율이 유지되고, 비용 회귀로 가정한 구간은 요청당 계산 비용이 커졌다.
계산 자체는 다음처럼 확인할 수 있다.
def cpu_ms_per_request(cpu_seconds, request_count, coverage):
    if request_count <= 0 or coverage < 1.0:
        return None  # 이 예제는 완전 수집된 창만 비교한다.
    return cpu_seconds * 1000 / request_count

assert cpu_ms_per_request(120, 30_000, 1.0) == 4.0
assert cpu_ms_per_request(240, 60_000, 1.0) == 4.0
assert cpu_ms_per_request(240, 30_000, 1.0) == 8.0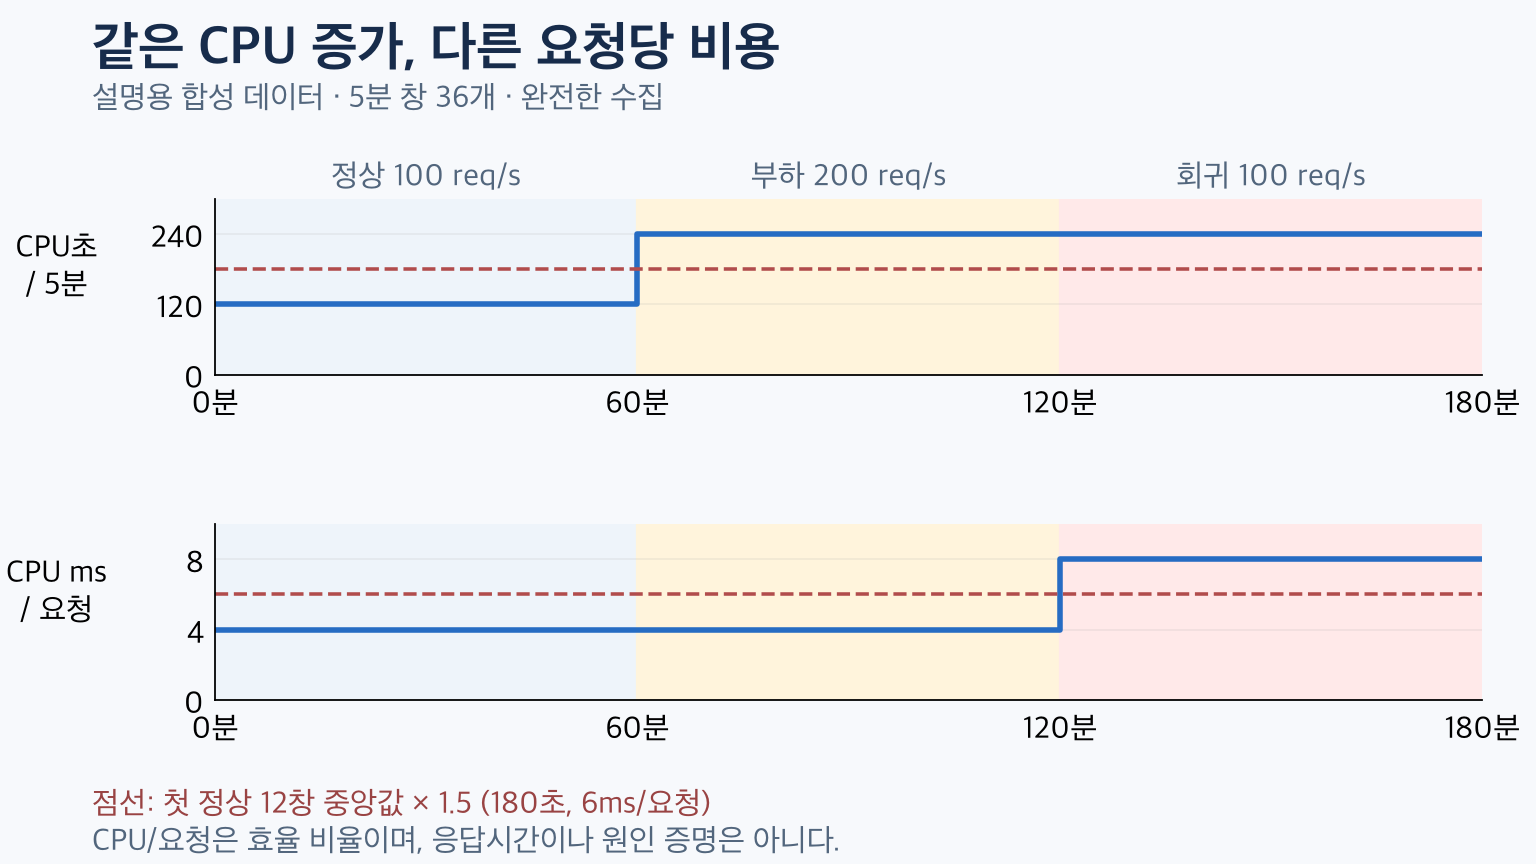
그림 7a. 실제로 계산한 합성 데이터 36개 창. 위는 CPU 시간, 아래는 요청당 CPU다. 0~60분은 정상, 60~120분은 트래픽 증가, 120~180분은 비용 회귀를 가정했다.
첫 정상 12개 창의 중앙값에 1.5를 곱해 설명용 임계값을 정했다. 절대 CPU 기준은 180초/5분, 정규화 기준은 6ms/요청이다. 두 배 트래픽과 비용 회귀 구간을 임계값 설정에 사용하지 않았다. 절대 CPU 기준은 뒤의 24개 창을 모두 표시하고, 요청당 CPU 기준은 마지막 12개 창을 표시한다. 이는 단순 기준선 비교이며 학습한 ML 모델의 성능 결과가 아니다.
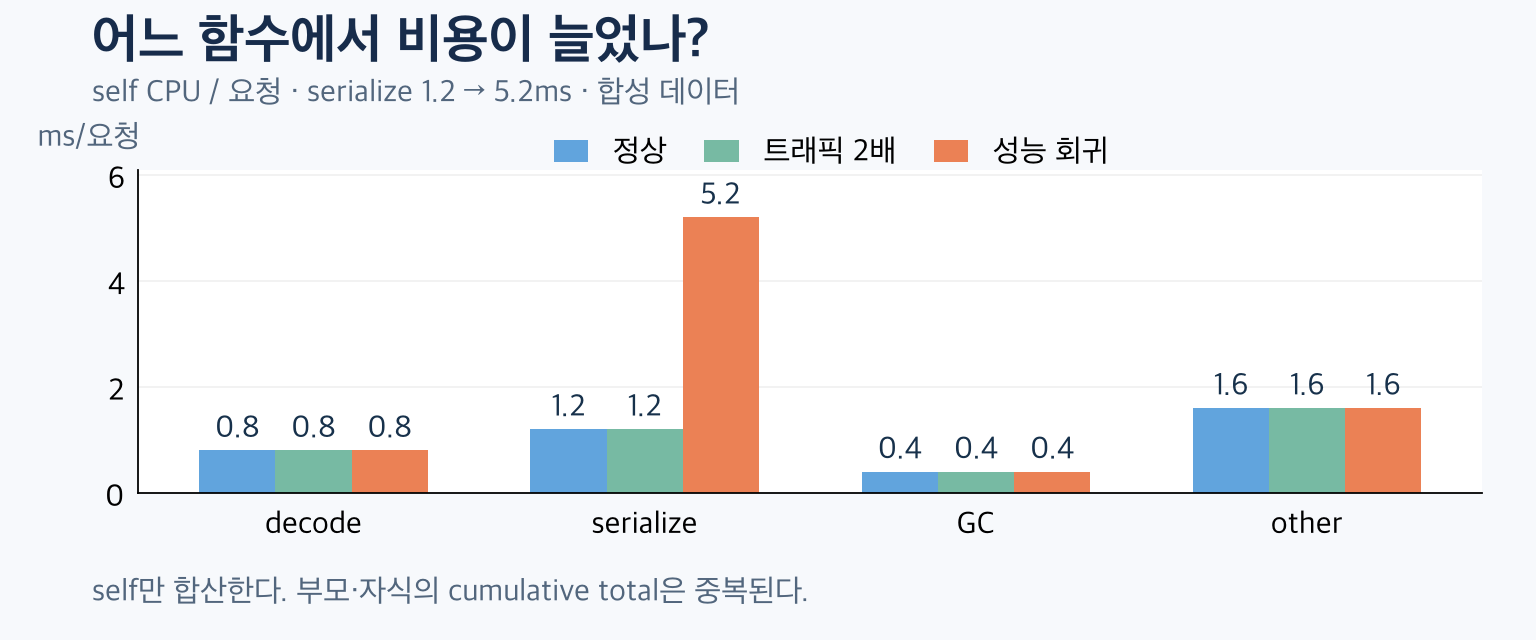
그림 7b. serialize의 self CPU만 1.2 → 5.2ms/요청으로 바꿔 전체가 4 → 8ms/요청이 되도록 구성했다. 정상과 트래픽 증가 구간의 함수별 요청당 비용은 같다.
16절 합성 계산 부록에는 36개 창의 CSV와 결과 JSON을 생성하는 계산 코드를 제공한다. 그래프의 배치·글꼴 설정을 제외한 데이터 생성·정규화·검증 계산을 그대로 재현할 수 있다. 요청 수 0과 커버리지 50%인 별도 예제는 판정을 보류한다. 이 예제의 정책은 완전 수집된 창만 비교하는 것이며, 커버리지를 통계적 신뢰구간으로 해석하지 않는다.
이 구분은 효율 회귀에 대한 단서이지 원인 증명은 아니다. 큰 payload 비중이 높아져도 요청당 CPU는 증가할 수 있다. 반대로 요청당 효율이 유지되어도 트래픽이 서버 용량을 넘으면 지연과 오류가 발생한다. 따라서 효율 이상과 용량 부족을 별도의 질문으로 평가해야 한다.
함수 수준으로는 “전체 CPU/request가 증가했고, 그 증가분 중 얼마가 serialize의 self에 귀속되는가?”를 묻는다. 이때부터 메트릭의 총량 변화와 코드 수준 변화가 연결된다.
12. ML 모델과 평가
12.1 모델을 고르는 순서
첫 모델부터 복잡한 신경망을 택할 필요는 없다. 먼저 같은 작업 조건의 정상 기준선을 만들고, 단순 규칙으로 설명되지 않는 문제가 무엇인지 확인한다. 다음은 모델 선택을 위한 설계 제안이다.
| 접근 | 적합한 질문 | 필요한 주의 |
|---|---|---|
| 중앙값·MAD, EWMA | 특정 효율 지표가 평소보다 커졌는가? | 계절성·작업 종류별 기준, MAD=0 처리 |
| 회귀 + 잔차 | RPS·입력 크기로 기대되는 CPU보다 더 쓰는가? | 설명 변수 누락, 새로운 부하 영역의 외삽 |
| Isolation Forest 등 | 여러 특징의 조합이 평소와 다른가? | 이상 점수는 장애 확률이나 원인 확정이 아님 |
| 군집·유사도 검색 | 이전에 비슷한 스택 변화가 있었는가? | 함수명 변경·라이브러리 버전의 영향 |
| 지도학습 분류 | 알려진 장애 유형 중 무엇과 유사한가? | 충분한 라벨, 희귀 장애, 미지 유형 처리 |
| 시계열 예측 | 정상 추세와 계절성에서 벗어나는가? | 배포·복제본·트래픽 정책 변화에 따른 드리프트 |
정상 데이터만 학습해 새로운 이상을 찾는 문제와, 이미 이상이 섞인 데이터에서 튀는 점을 찾는 문제는 다르다. 알고리즘의 contamination 같은 설정도 장애 확률로 해석하면 안 된다. scikit-learn 이상 탐지 안내
스택 분포를 벡터로 만들면 코사인 거리나 Jensen–Shannon divergence 같은 분포 차이 지표도 검토할 수 있다. 이 역시 제안하는 분석 방식이다. 함수명을 해시하기 전에 빌드·심볼·인라이닝·JIT 변화가 같은 작업을 다른 스택처럼 보이게 만드는지 확인한다. 주소값만으로 장기간 비교하면 바이너리 재배포나 주소 배치 변화가 가짜 이상을 만들 수 있다.
12.2 데이터 누수
5분 창을 1분마다 만들면 이웃한 행은 대부분 같은 실행 데이터를 공유한다. 이를 무작위로 학습·평가에 나누면 이미 본 장애 조각을 다시 맞히면서 높은 점수를 얻을 수 있다.
시간 순으로 학습·검증·테스트를 분리하고, 겹치는 창과 같은 장애가 경계를 넘지 않도록 간격과 그룹을 설계한다. 표준화의 평균·분산, 정상 기준선, Top-K 함수 목록도 학습 구간에서만 결정한다. 장애가 끝난 뒤 작성한 사후 분석 내용이나 이후의 최종 원인 라벨을 당시 입력 특징으로 넣지 않는다. 데이터 누수, 시계열 교차 검증
12.3 운영 단위의 평가
행 단위 accuracy보다 운영자가 받는 알림을 기준으로 평가하는 편이 유용하다.
- 서비스당 하루 오탐 알림 수와 실제 장애 탐지율
- 실제 장애 시작부터 최초 유효 알림까지의 지연
- 같은 장애를 반복 알리는 중복 비율
- 원인 후보 Top-K에 유효한 조사 대상이 포함되는 비율
- 프로파일 결측·도구 실패 때 판단을 보류하는 능력
- 에이전트의 근거 일치, 조회 비용, 실제 조사 시간 감소
배포와 런타임 변경은 정상 분포를 바꿀 수 있다. 이 변화를 드리프트(drift)라고 부른다. 새 버전에 맞춰 기준선을 갱신하되, 느리게 악화되는 회귀를 계속 정상으로 학습하지 않도록 정상 구간을 선별해야 한다. 모델 교체 전에는 실제 알림을 발생시키지 않는 shadow 평가로 기존 기준과 비교할 수 있다.
정규화 예제는 특징 설계의 필요성을 보여 주는 작은 계산이다. 이것만으로 운영 환경의 이상 탐지 정확도나 AIOps 도입 효과가 입증되지는 않는다.
13. 추가 활용 분석
13.1 비용과 용량
FinOps 관점에서는 자주 실행되고 비용이 큰 코드 경로를 찾아 최적화 우선순위를 정할 수 있다. CPU를 크게 쓰는 압축·직렬화·정렬 함수를 개선하면 계산량을 줄일 가능성이 있다. 그러나 CPU 비중 30%가 청구 비용 30%라는 뜻은 아니다. 유휴 자원, 인스턴스 요금, 예약 용량, 네트워크·스토리지 비용까지 함께 봐야 한다.
용량 계획에서는 요청량이 늘어날 때 CPU·할당량·락 경합이 선형으로 늘어나는지 확인한다. 락으로 직렬화된 구간이 병목이면 CPU 수나 복제본 조정만으로 문제가 해결되지 않을 수 있다. 부하테스트와 프로파일을 연결하면 자원 한계와 코드 병목을 구분하는 데 도움이 된다. 이는 프로파일을 이용한 설계 판단이며, Pyroscope가 자동으로 적정 replica 수를 산정한다는 뜻은 아니다.
13.2 배포와 성능 회귀
동일한 입력·트래픽으로 이전 버전과 새 버전을 실행하고 프로파일을 비교하면, 전체 p95만으로 드러나지 않는 CPU·할당 비용 변화를 찾을 수 있다. 하드웨어, 워밍업, 캐시, JIT, GC 조건을 맞추고 반복 측정해야 한다.
Grafana Cloud k6와 Profiles의 공식 통합도 테스트와 프로파일의 연결을 제공한다. 다만 해당 Cloud 통합의 조건과, 직접 OSS 환경에서 부하테스트 결과를 비교하는 설계는 구분한다. k6와 Profiles 통합
PGO(Profile-guided Optimization)도 후보가 된다. Go 컴파일러는 대표적인 CPU pprof를 입력으로 받아 최적화에 활용한다. Pyroscope에서 얻은 데이터가 요구 형식·심볼 조건에 맞는지 확인한 뒤 사용할 수 있다. 대표성이 없는 작은 벤치마크 하나를 전체 운영 부하처럼 사용하는 것은 피한다. PGO의 실행 주체는 컴파일러이며 Pyroscope가 자동으로 코드를 최적화하는 것은 아니다. Go PGO
13.3 AI와 ML 서비스 자체
“AIOps의 ML에 프로파일을 입력한다”와 “ML 서비스를 프로파일링한다”는 서로 다른 활용이다. 후자의 예시는 다음과 같다.
| 대상 | 프로파일로 조사할 수 있는 후보 | 함께 필요한 관측 |
|---|---|---|
| 모델 서빙 API | JSON 직렬화, 전처리, tokenization, 후처리 | 요청·토큰 수, 큐 대기, GPU 메트릭 |
| RAG 서비스 | 문서 파싱, chunk 생성, 검색 결과 가공 | 검색·DB·외부 모델 호출 트레이스 |
| 데이터 파이프라인 | 압축 해제, 변환, CPU 데이터 로딩 | 처리량, 큐, 디스크·네트워크 지표 |
| 학습 작업의 호스트 코드 | 지원되는 런타임의 CPU·메모리 hot path | 프레임워크·CUDA 전용 profiler |
일반적인 호스트 CPU 프로파일로 GPU 커널별 시간을 직접 분해할 수 있다고 기대해서는 안 된다. 모델 정확도, hallucination, 데이터 분포 변화, 토큰 과금도 별도 측정 대상이다. CPU 측 코드는 Pyroscope로 보고, 연산자·CUDA 활동은 PyTorch Profiler 같은 도구로 보완하는 식의 조합을 검토할 수 있다. PyTorch Profiler
13.4 변경 검증과 조사 보조
라이브러리·런타임 교체 전후에 hot path와 할당량이 어떻게 달라졌는지 확인하는 데도 유용하다. 예상하지 못한 고비용 연산이 등장했을 때 보안 조사에 단서를 제공할 수도 있다.
다만 암호화 함수의 CPU 비중이 높다는 이유만으로 침해라고 판단할 수는 없다. 정상 TLS나 업무 로직일 수 있다. 보안 활용은 EDR·감사 로그·네트워크 이벤트와 함께 검증하는 보조 역할로 한정하는 편이 정확하다.
14. 도입 순서와 판단 기준
다음 순서는 이 글의 설계 제안이다. 단계마다 이전 데이터가 실제 조사에 쓸 수 있는지 확인하고 범위를 넓힌다.
- 한 서비스의 CPU 수집: 함수명·단위·시간·라벨을 확인하고 앱 영향도도 측정한다.
- 동일 조건의 전후 비교: 배포·트래픽·입력 크기를 함께 보며 self와 total을 구분한다.
- 관측 신호 연결: 메트릭·트레이스·프로파일의 서비스와 시간 범위를 맞춘다.
- 읽기 전용 에이전트: 제한된 API 도구로 조사하고 재현 가능한 근거를 반환한다.
- ML 특징과 기준선: CPU/request와 함수별 self부터 만들고 결측·누수를 점검한다.
- 운영 평가와 확장: 오탐·탐지 지연·조사 비용을 측정한 뒤 모델과 자동 조치 범위를 넓힌다.
특히 다음 질문에 답할 수 있으면 Pyroscope를 “불꽃 그림을 보는 도구”에서 실제 운영 분석 도구로 활용하기 시작한 것이다.
- 이 CPU 증가는 요청량 증가인가, 요청당 비용 증가인가?
- 넓은 함수는 직접 CPU를 쓴 것인가, 비싼 하위 호출을 포함한 것인가?
- 프로파일과 요청 수의 시간·복제본·작업 범위가 같은가?
- 에이전트의 설명은 원본 질의로 다시 확인할 수 있는가?
- ML의 이상 점수는 어떤 기준선과 데이터 품질 위에서 계산됐는가?
Pyroscope의 강점은 자원 사용을 코드 경로까지 좁혀 주는 데 있다. AIOps 에이전트는 이 근거를 다른 관측 신호와 연결해 조사하고, ML은 정렬·정규화한 특징으로 변화와 반복 패턴을 찾을 수 있다. 두 활용 모두 먼저 프로파일의 단위와 수집 범위를 정확히 이해하는 데서 출발한다.
함께 읽을 자료: 관측 신호의 기본 개념은 Observability 공부 노트, 제품별 최신 지원 조건은 본문에 연결한 공식 문서를 참고한다. 이 글의 구조도는 직접 제작했으며, 합성 수치와 로컬 실행 결과는 별도로 표시했다.
15. CPU 실습 재현 부록
이 부록은 5절에서 실행한 최소 구성을 그대로 제공한다. Docker Engine 또는 Docker Desktop, Docker Compose, Python 3가 필요하다. 작성 시 실제 실행한 플랫폼은 Linux ARM64 컨테이너다. 아래 파일을 각각 표시한 경로에 저장한다.
lab/
├── compose.yaml
├── pyroscope.yaml
├── query.py
└── app/
    ├── main.go
    ├── go.mod
    ├── go.sum
    └── Dockerfile
호스트에는 127.0.0.1:14440만 공개한다. Pyroscope의 1 CPU/1 GiB와 앱의 0.5 CPU/128 MiB는 이번 합성 실습의 제한이며 공식 최소 사양이 아니다. target: all과 architecture_storage: v2로 실행하는 단일 프로세스 입문 구성이다.
15.1 서버와 앱 구성
lab/compose.yaml
services:
  pyroscope:
    image: grafana/pyroscope:2.3.1@sha256:86a9ee7448487409ead8ada78789de7b78b739711b92b5d7224a1a54abf3eeb2
    command: ["-config.file=/etc/pyroscope/lab.yaml"]
    ports: ["127.0.0.1:14440:4040"]
    volumes:
      - ./pyroscope.yaml:/etc/pyroscope/lab.yaml:ro
      - pyroscope-data:/data
      - pyroscope-compactor:/data-compactor
      - pyroscope-metastore:/data-metastore
    cpus: 1
    mem_limit: 1g
  demo-api:
    image: pyroscope-study/demo-api:go1.25.13-sdk1.4.0
    build: ./app
    environment:
      PYROSCOPE_SERVER_ADDRESS: http://pyroscope:4040
    depends_on: [pyroscope]
    cpus: 0.5
    mem_limit: 128m
    stop_grace_period: 15s
volumes:
  pyroscope-data:
  pyroscope-compactor:
  pyroscope-metastore:
lab/pyroscope.yaml
target: all
architecture_storage: v2
server:
  http_listen_port: 4040
analytics:
  reporting_enabled: false
self_profiling:
  disable_push: true
lab/app/main.go
package main

import (
	"context"
	"log"
	"math"
	"os"
	"os/signal"
	"syscall"
	"time"

	"github.com/grafana/pyroscope-go"
)

var result float64

//go:noinline
func burnCPU(duration time.Duration) {
	deadline := time.Now().Add(duration)
	var sum float64
	for time.Now().Before(deadline) {
		for i := 1; i < 100000; i++ {
			sum += math.Sqrt(float64(i))
		}
	}
	result = sum // Keep the synthetic work observable to the compiler.
}

func main() {
	profiler, err := pyroscope.Start(pyroscope.Config{
		ApplicationName: "demo-api",
		ServerAddress:   os.Getenv("PYROSCOPE_SERVER_ADDRESS"),
		Logger:          pyroscope.StandardLogger,
		Tags:            map[string]string{"env": "lab", "version": "v1"},
		ProfileTypes:    []pyroscope.ProfileType{pyroscope.ProfileCPU},
		UploadRate:      10 * time.Second,
	})
	if err != nil {
		log.Fatal(err)
	}
	defer profiler.Stop()

	ctx, cancel := signal.NotifyContext(context.Background(), os.Interrupt, syscall.SIGTERM)
	defer cancel()
	timer := time.NewTimer(8 * time.Minute)
	defer timer.Stop()
	ticker := time.NewTicker(500 * time.Millisecond)
	defer ticker.Stop()
	log.Print("synthetic CPU load: burnCPU(150ms) every 500ms; bounded to 8 minutes")
	for {
		select {
		case <-ctx.Done():
			return
		case <-timer.C:
			return
		case <-ticker.C:
			pyroscope.TagWrapper(ctx, pyroscope.Labels("operation", "synthetic_cpu"), func(context.Context) {
				burnCPU(150 * time.Millisecond)
			})
		}
	}
}
앱은 burnCPU(150ms)를 500ms마다 실행하고 최대 8분 후 종료한다. operation=synthetic_cpu는 해당 작업에 붙인 CPU 프로파일 라벨이다. 실제 HTTP 요청을 받는 서버나 부하테스트 결과로 해석하지 않는다.
15.2 의존성과 빌드
go.mod와 go.sum은 함께 저장한다. Docker 빌드는 go mod download로 고정한 모듈을 받고, go build -mod=readonly로 의존성 파일을 수정하지 않고 컴파일한다. 아래 go.sum을 생략하면 원래 Dockerfile의 COPY go.mod go.sum ./ 단계부터 실패한다.
lab/app/go.mod
module example.com/pyroscope-study

go 1.25.0

require github.com/grafana/pyroscope-go v1.4.0

require (
	github.com/grafana/pyroscope-go/godeltaprof v0.1.11 // indirect
	github.com/klauspost/compress v1.18.6 // indirect
)
lab/app/go.sum
github.com/davecgh/go-spew v1.1.1 h1:vj9j/u1bqnvCEfJOwUhtlOARqs3+rkHYY13jYWTU97c=
github.com/davecgh/go-spew v1.1.1/go.mod h1:J7Y8YcW2NihsgmVo/mv3lAwl/skON4iLHjSsI+c5H38=
github.com/grafana/pyroscope-go v1.4.0 h1:WD0vVpwdmj206XaHyt0dO+N82Ae3PXVGF/I8Kvux5Lo=
github.com/grafana/pyroscope-go v1.4.0/go.mod h1:YiILNniTN5GG9QcJRskdAyZPUN8DGWtGLI5aq29Re7E=
github.com/grafana/pyroscope-go/godeltaprof v0.1.11 h1:el5LYpXissAiCKZ5/6yjlr6mhYVV6Cp5lahTocxraXM=
github.com/grafana/pyroscope-go/godeltaprof v0.1.11/go.mod h1:jl1V8M4cWsXciROCPIDDG7CtjSjT/ECbp6eLVuMxYRI=
github.com/klauspost/compress v1.18.6 h1:2jupLlAwFm95+YDR+NwD2MEfFO9d4z4Prjl1XXDjuao=
github.com/klauspost/compress v1.18.6/go.mod h1:cwPg85FWrGar70rWktvGQj8/hthj3wpl0PGDogxkrSQ=
github.com/pmezard/go-difflib v1.0.0 h1:4DBwDE0NGyQoBHbLQYPwSUPoCMWR5BEzIk/f1lZbAQM=
github.com/pmezard/go-difflib v1.0.0/go.mod h1:iKH77koFhYxTK1pcRnkKkqfTogsbg7gZNVY4sRDYZ/4=
github.com/stretchr/objx v0.5.3 h1:jmXUvGomnU1o3W/V5h2VEradbpJDwGrzugQQvL0POH4=
github.com/stretchr/objx v0.5.3/go.mod h1:rDQraq+vQZU7Fde9LOZLr8Tax6zZvy4kuNKF+QYS+U0=
github.com/stretchr/testify v1.11.1 h1:7s2iGBzp5EwR7/aIZr8ao5+dra3wiQyKjjFuvgVKu7U=
github.com/stretchr/testify v1.11.1/go.mod h1:wZwfW3scLgRK+23gO65QZefKpKQRnfz6sD981Nm4B6U=
gopkg.in/yaml.v3 v3.0.1 h1:fxVm/GzAzEWqLHuvctI91KS9hhNmmWOoWu0XTYJS7CA=
gopkg.in/yaml.v3 v3.0.1/go.mod h1:K4uyk7z7BCEPqu6E+C64Yfv1cQ7kz7rIZviUmN+EgEM=
lab/app/Dockerfile
FROM golang:1.25.13-alpine@sha256:1e0126852075c9c60731c8ba49088448b91f63e2aed97ca9d1a9791622a05946 AS build
WORKDIR /src
COPY go.mod go.sum ./
RUN go mod download
COPY main.go ./
RUN CGO_ENABLED=0 go build -mod=readonly -o /demo-api .

FROM scratch
COPY --from=build /demo-api /demo-api
USER 65532:65532
ENTRYPOINT ["/demo-api"]
15.3 실행과 API 조회
아래 명령은 lab 디렉터리에서 실행한다. 처음 빌드할 때는 고정한 이미지와 Go 모듈을 내려받을 네트워크 연결이 필요하다.
docker compose -p pyroscope-study-20261004 -f compose.yaml config --quiet
docker compose -p pyroscope-study-20261004 -f compose.yaml up -d --build
curl -fsS http://127.0.0.1:14440/ready/ready는 시작 직후 metastore·segment writer가 준비되는 동안 503을 반환할 수 있다. 약 10초 간격으로 다시 확인하고 200 ready가 된 뒤 조회한다. 작성 시 실행에서는 약 3분 안에 준비됐다. 계속 실패하면 다음 로그를 확인한다.
docker compose -p pyroscope-study-20261004 -f compose.yaml logs --tail 50 pyroscope
docker compose -p pyroscope-study-20261004 -f compose.yaml logs --tail 20 demo-api
브라우저에서 http://127.0.0.1:14440을 열고 demo-api · cpu, Last 5m을 선택한다. 기본 조건을 확인해 Run → Both → Expand all groups 순서로 호출 스택을 펼치면 5절과 같은 함수 경로를 조사할 수 있다. 시간과 누적 CPU 값은 실행 시점·환경에 따라 달라진다.
추가 라벨은 다음 API 예제로 조회한다. 별도 Python 패키지는 필요 없다. 현재 시각 기준 최근 5분을 Unix epoch 밀리초로 보내며, 원본 입력·응답과 UTC 조회 시각을 남긴다.
lab/query.py
#!/usr/bin/env python3
"""Read the local lab through the supported SelectMergeStacktraces API."""
import datetime
import json
from pathlib import Path
import time
import urllib.request

evidence = Path(__file__).parent / "evidence"
evidence.mkdir(exist_ok=True)
end_ms = int(time.time() * 1000)
body = {
    "start": end_ms - 300_000,
    "end": end_ms,
    "labelSelector": '{service_name="demo-api",env="lab",operation="synthetic_cpu"}',
    "profileTypeID": "process_cpu:cpu:nanoseconds:cpu:nanoseconds",
    "format": "PROFILE_FORMAT_FLAMEGRAPH",
    "maxNodes": 1000,
}
endpoint = "http://127.0.0.1:14440/querier.v1.QuerierService/SelectMergeStacktraces"
request = urllib.request.Request(endpoint, json.dumps(body).encode(),
                                 {"Content-Type": "application/json"})
with urllib.request.urlopen(request, timeout=30) as response:
    result = json.load(response)
    status = response.status
(evidence / "query-request.json").write_text(json.dumps(body, indent=2) + "\n")
(evidence / "query-response.json").write_text(json.dumps(result, indent=2) + "\n")
print(json.dumps({"http_status": status,
                 "query_start_utc": datetime.datetime.fromtimestamp(body["start"]/1000, datetime.timezone.utc).isoformat(),
                 "query_end_utc": datetime.datetime.fromtimestamp(body["end"]/1000, datetime.timezone.utc).isoformat(),
                 "response_keys": list(result)}, indent=2))
python3 query.py결과는 lab/evidence/query-request.json과 lab/evidence/query-response.json에 저장된다. CPU 타입의 단위는 nanoseconds다. JSON의 함수 total들을 전부 더하면 부모·자식 호출이 중복되므로 전체 CPU 합으로 사용하지 않는다. 프로파일이 없는 응답을 CPU 0으로 처리해서도 안 된다.
작성 시 API 조회 구간은 2026-10-04 21:04:40.491–21:09:40.491 KST였으며, 총 CPU 시간은 30.09초, main.burnCPU의 Self는 28.16초, Total은 30.09초였다. 5절 UI와 시간·필터가 달라 두 값이 같을 필요는 없다. 이 API 호출에서 env·operation 필터가 실제로 전달된 것은 서버 로그로도 확인했다. SelectMergeStacktraces API
앱이 8분 뒤 종료되어 새 데이터가 필요하면 해당 서비스만 다시 시작한다.
docker compose -p pyroscope-study-20261004 -f compose.yaml restart demo-api실습이 끝나면 프로젝트를 정리한다. --volumes는 이 실습의 저장 데이터도 삭제하므로 보존할 결과를 먼저 저장한다. 작성 실습에서는 증거를 저장한 뒤 다음 명령으로 전용 컨테이너·네트워크·볼륨을 정리했다.
docker compose -p pyroscope-study-20261004 -f compose.yaml down --volumes
docker compose -p pyroscope-study-20261004 -f compose.yaml ps -a
16. 합성 계산 재현 부록
아래 코드를 빈 작업 폴더에 normalization_core.py로 저장하고 python3 normalization_core.py로 실행한다. Python 표준 라이브러리만 사용하며, 그래프를 만드는 원본에서 데이터 생성·특징 계산·검증 부분을 분리했다. 원본의 NumPy 중앙값 계산은 같은 값을 반환하는 statistics.median으로 바꿨다.
windows.csv의 한 행은 겹치지 않는 5분 창 하나다. 첫 12개 정상 창으로만 임계값을 정하고 이후 창을 비교한다. 네 self CPU 값은 전체를 중복 없이 분할하도록 만든 합성 입력이며, Pyroscope에서 자동 추출한 데이터가 아니다.
from pathlib import Path
from statistics import median
import csv
import json

OUT = Path(__file__).resolve().parent
WINDOW_SECONDS = 300
MIN_COVERAGE = 1.0
BASELINE_WINDOWS = 12
SELF_FIELDS = ("decode_self_cpu_s", "serialize_self_cpu_s", "gc_self_cpu_s", "other_self_cpu_s")


def derive(row):
    """Never interpret a missing profile window or zero requests as healthy zero."""
    cpu = sum(row[f] for f in SELF_FIELDS)
    row["total_cpu_s"] = cpu
    row["observed_average_cores"] = cpu / WINDOW_SECONDS
    row["cpu_ms_per_request"] = None
    if row["collection_coverage"] < MIN_COVERAGE:
        row["normalization_status"] = "abstain_incomplete_collection"
    elif row["requests"] <= 0:
        row["normalization_status"] = "abstain_zero_requests"
    else:
        row["cpu_ms_per_request"] = cpu * 1000 / row["requests"]
        row["normalization_status"] = "valid"
    return row


rows = []
regimes = [
    ("baseline", 100, (0.8, 1.2, 0.4, 1.6)),
    ("traffic_only", 200, (0.8, 1.2, 0.4, 1.6)),
    ("regression", 100, (0.8, 5.2, 0.4, 1.6)),
]
for regime, rps, self_ms_per_request in regimes:
    for _ in range(12):
        i = len(rows)
        requests = rps * WINDOW_SECONDS
        row = dict(window=i, start_min=i * 5, end_min=(i + 1) * 5,
                   regime=regime, requests=requests, rps=rps,
                   collection_coverage=1.0)
        row.update({k: v * requests / 1000 for k, v in zip(SELF_FIELDS, self_ms_per_request)})
        rows.append(derive(row))

# Train-only reference: the first 12 windows. No future periods affect thresholds.
cpu_baseline = float(median([r["total_cpu_s"] for r in rows[:BASELINE_WINDOWS]]))
normalized_baseline = float(median([r["cpu_ms_per_request"] for r in rows[:BASELINE_WINDOWS]]))
cpu_threshold = cpu_baseline * 1.5
normalized_threshold = normalized_baseline * 1.5
for row in rows:
    row["raw_cpu_flag"] = row["total_cpu_s"] > cpu_threshold
    row["normalized_flag"] = row["cpu_ms_per_request"] > normalized_threshold

edges = []
for label, requests, coverage, self_s in [
    ("zero_requests", 0, 1.0, (1.0, 1.0, 1.0, 3.0)),
    ("half_collection_missing", 30000, 0.5, (12.0, 18.0, 6.0, 24.0)),
]:
    row = dict(case=label, requests=requests, collection_coverage=coverage)
    row.update(dict(zip(SELF_FIELDS, self_s)))
    edges.append(derive(row))

for filename, data in [("windows.csv", rows), ("edge_cases.csv", edges)]:
    with (OUT / filename).open("w", newline="") as handle:
        writer = csv.DictWriter(handle, fieldnames=list(data[0]))
        writer.writeheader()
        writer.writerows(data)

summary = {
    "data_kind": "synthetic; deterministic explanatory example, not a performance benchmark",
    "window_seconds": WINDOW_SECONDS,
    "baseline_windows": BASELINE_WINDOWS,
    "raw_cpu_threshold_seconds": cpu_threshold,
    "normalized_threshold_ms_per_request": normalized_threshold,
    "minimum_collection_coverage": MIN_COVERAGE,
    "collection_coverage_definition": "received collection intervals / expected collection intervals; not statistical sample confidence",
    "normalization_scope": "all application CPU divided by all requests in the same service/window; includes background CPU",
    "regimes": [],
    "limitations": [
        "One fixed request mix, payload size, hardware and replica count are assumed.",
        "Zero requests and incomplete collection cause abstention; missing is never imputed as healthy zero.",
        "Self CPU values partition the synthetic total. Cumulative function values would overlap and must not be summed.",
        "CPU per request is an attribution ratio, not measured request latency.",
        "This simple threshold is a teaching baseline, not a trained ML detector or causal diagnosis.",
    ],
}
for regime, _, _ in regimes:
    selected = [r for r in rows if r["regime"] == regime]
    first = selected[0]
    summary["regimes"].append(dict(
        regime=regime, windows=len(selected), rps=first["rps"],
        requests=first["requests"], total_cpu_s=first["total_cpu_s"],
        cpu_ms_per_request=first["cpu_ms_per_request"],
        average_cores=first["observed_average_cores"],
        raw_cpu_flagged_windows=sum(r["raw_cpu_flag"] for r in selected),
        normalized_flagged_windows=sum(r["normalized_flag"] for r in selected),
    ))
(OUT / "summary.json").write_text(json.dumps(summary, ensure_ascii=False, indent=2) + "\n")

assert [r["cpu_ms_per_request"] for r in (rows[0], rows[12], rows[24])] == [4.0, 4.0, 8.0]
assert [r["total_cpu_s"] for r in (rows[0], rows[12], rows[24])] == [120.0, 240.0, 240.0]
assert all(e["cpu_ms_per_request"] is None for e in edges)
assert sum(r["raw_cpu_flag"] for r in rows) == 24
assert sum(r["normalized_flag"] for r in rows) == 12

print(json.dumps(summary, ensure_ascii=False, indent=2))
이 계산은 windows.csv, edge_cases.csv, summary.json을 생성한다. 계산 결과의 핵심은 다음과 같으며, 11절 그래프에 사용한 수치와 같다.
| 구간 | 창 수 | CPU초/창 | CPU ms/요청 | 절대 CPU 기준 표시 | 정규화 기준 표시 |
|---|---|---|---|---|---|
| baseline | 12 | 120 | 4 | 0개 | 0개 |
| traffic_only | 12 | 240 | 4 | 12개 | 0개 |
| regression | 12 | 240 | 8 | 12개 | 12개 |
절대 CPU 임계값은 180초/5분, 요청당 CPU 임계값은 6ms/요청이다. 요청 수 0과 수집 커버리지 50%인 별도 두 행은 cpu_ms_per_request를 비워 두고 판정을 보류한다. 이 코드는 그래프의 계산 근거를 재현하는 예제이며 ML 모델 학습이나 운영 탐지 성능 평가를 수행하지 않는다.
