[LiteLLM 10] Production 전환 검증 — 복제본·Redis·DB 장애와 k6
LiteLLM 10 — 운영 전환 검증
이 글에서 다룰 주제
- 공유 상태: Proxy를 두 개로 늘렸을 때 요청 제한을 함께 적용한다.
- 의존성 장애: Redis·DB·부서 Gateway가 멈추면 무엇이 계속되는지 확인한다.
- 부하 판정: 정상 요청과 의도된 429·timeout을 구분해 k6 합격 조건을 작성한다.
주요 단어 · replica · 공유 RPM · fail-open · cached key · k6 threshold · 복구
Proxy를 두 대 실행하면 한 프로세스가 멈춰도 다른 프로세스로 요청할 수 있다. 하지만 두 프로세스가 서로 다른 요청 제한 카운터를 사용한다면 허용량이 늘어날 수 있다. DB가 멈춰도 이미 캐시된 키는 계속 동작하는 반면 새 키 발급은 실패할 수 있다. 운영 준비는 이런 차이를 이해하고 정책으로 선택하는 과정이다.
이 글에서는 LiteLLM 1.104.0의 독립 실습 스택에 짧은 장애를 주입했다. LLM 역할은 로컬 Go 모의 서버가 맡았다. 각 단계에서 서비스 복구를 확인하고, 시험 코드의 finally에서도 대상 서비스를 다시 시작하도록 했다.
1. 공유 상태의 역할
공식 배포 문서는 다중 Proxy에서 PostgreSQL과 Redis의 역할을 구분한다. PostgreSQL은 키·팀·사용량·설정의 영속 상태를 담당하고 Redis는 여러 인스턴스가 사용하는 제한·라우터 등의 공유 상태를 제공한다. 스키마 마이그레이션도 모든 복제본이 경쟁해서 실행하지 않도록 별도 단계로 관리한다. Production Deployment
실습에서는 첫 Proxy가 DB를 초기화한 후 두 번째 Proxy를 띄웠고, 두 번째에는 DISABLE_SCHEMA_UPDATE=true를 설정했다. 두 인스턴스는 동일한 전용 PostgreSQL과 Redis를 사용한다. 응답 cache는 끈 상태다. Redis를 쓴다는 사실이 반드시 완성 응답을 cache한다는 뜻은 아니다.
RPM은 분당 허용 요청 수다. rpm_limit: 2인 키를 만들고 두 인스턴스에 번갈아 네 번 요청했다.
Proxy A → 200
Proxy B → 200
Proxy A → 429
Proxy B → 429
두 Proxy가 각각 두 번씩 허용한 것이 아니라 총 두 번을 허용했다. 다만 150ms 간격의 짧은 순차 시험이다. 높은 동시성에서 발생하는 한도 경계 경쟁까지 검증한 것은 아니다.
2. 의존성 장애 결과
한 번에 한 종류의 장애만 주입했다. 다음 표의 값은 장애 후 실제 요청 결과다.
| 시나리오 | 장애 중 관측 | 복구 후 |
|---|---|---|
| 모의 부서 Gateway 중지 | 약 5.06초 뒤 408 | 200 |
| Redis 중지 | 두 Proxy의 테스트 요청 모두 200 | 200 |
| PostgreSQL 중지 | 캐시된 키 호출 200, 새 키 발급 500 | 200 |
| Proxy A 중지 | A 입구 502, B 입구 200 | A도 200 |
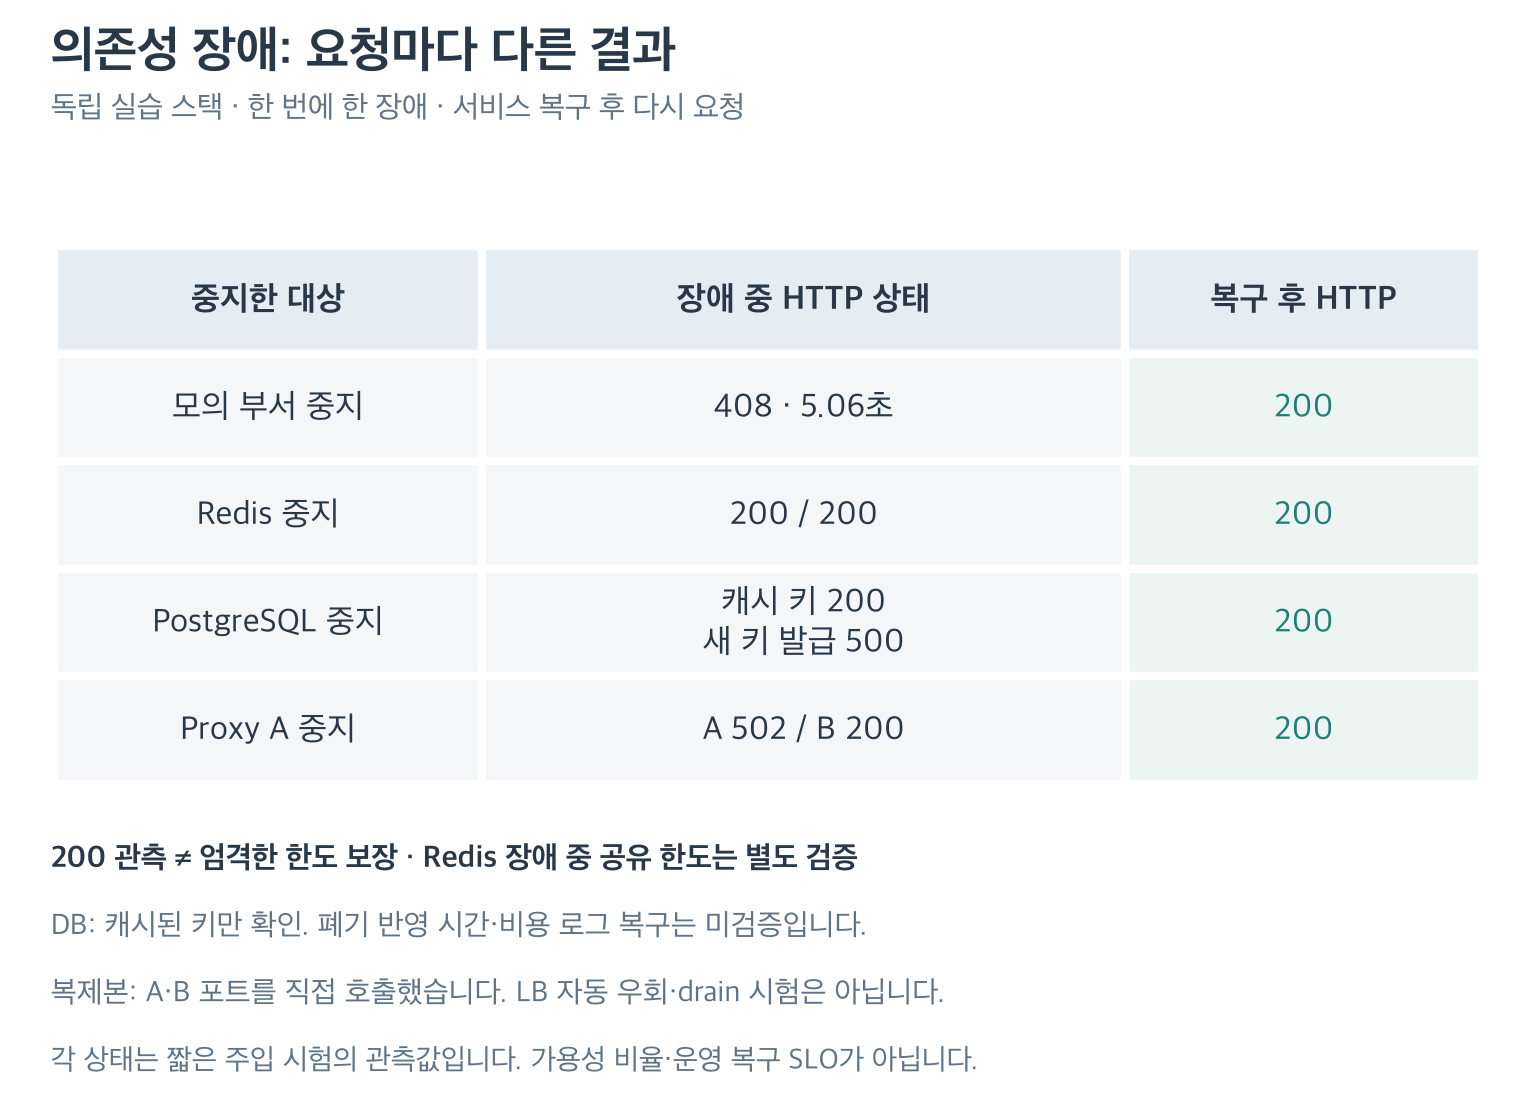
실측 요약 — 독립 모의 환경의 짧은 장애 시험이다. Redis가 멈췄을 때 200이 나왔다는 사실은 엄격한 한도 준수를 입증하지 않는다. 복제본은 다른 포트로 직접 요청했으며 LB 자동 우회는 시험하지 않았다.
Redis 장애에서 200이 나왔다는 사실을 공유 한도가 안전하게 지켜졌다는 뜻으로 해석하면 안 된다. 이 실험은 기본 설정에서 요청이 계속 처리되는 것을 보여 준다. 한도를 반드시 지켜야 한다면 지원 버전의 fail-closed 설정을 별도 프로필로 시험해야 한다. 공식 문서도 Redis 장애 시 기본 인스턴스별 처리와 fail_closed_rate_limit_enforcement의 적용 조건을 구분한다. Budgets and Rate Limits
DB 장애 역시 전체 서비스가 즉시 중지되는 형태가 아니었다. 캐시된 키로 inference를 호출하는 경로와 새 키를 발급하는 관리 경로의 의존성이 다르기 때문이다. 이 결과만으로 키 폐기가 즉시 반영된다거나 장애 중 비용 로그가 모두 복구된다고 보장할 수 없다. 폐기 키의 캐시 만료, 재기동 뒤 사용량 대조는 별도의 시험 항목으로 남긴다.
Proxy A를 중지한 시험은 다른 포트의 B를 직접 호출했다. 따라서 복제본의 개별 생존을 확인한 결과다. Load Balancer의 자동 우회, 진행 중 stream의 drain, 롤링 배포가 검증됐다고 확대하지 않는다.
3. k6 합격 조건
k6 1.3.0으로 정상 요청과 의도된 실패를 분리했다. 아래 시나리오는 로컬 모의 환경의 동작을 확인하는 작은 회귀 검증이다.
| 시나리오 | 부하 | 기대 결과 |
|---|---|---|
| normal | 2 VU, 5초, 요청 후 100ms 대기 | 200과 합성 usage 30 |
| rejected | 4회 | 모의 상위 429가 명시적으로 전달 |
| timeout | 2회 | 해당 설정에서 408 |
VU는 동시에 시나리오를 실행하는 가상 사용자다. 여기의 2 VU는 처리량 한계를 찾는 부하가 아니라 작은 회귀 검증이다.
합격 조건은 모든 업무별 check 성공과 정상 요청의 p95 1초 미만으로 두었다. 1초는 이 합성 실험의 느슨한 검증 문턱이며 운영 SLO가 아니다.
thresholds: {
  checks: ['rate==1'],
  'http_req_duration{scenario:normal}': ['p(95)<1000'],
}
실제 결과는 총 98요청, check 190개 모두 성공, k6 종료 코드 0이었다. 정상 요청은 92개이며 p95는 11.75ms였다. 나머지 6개는 의도한 429 네 번과 timeout 두 번이다.
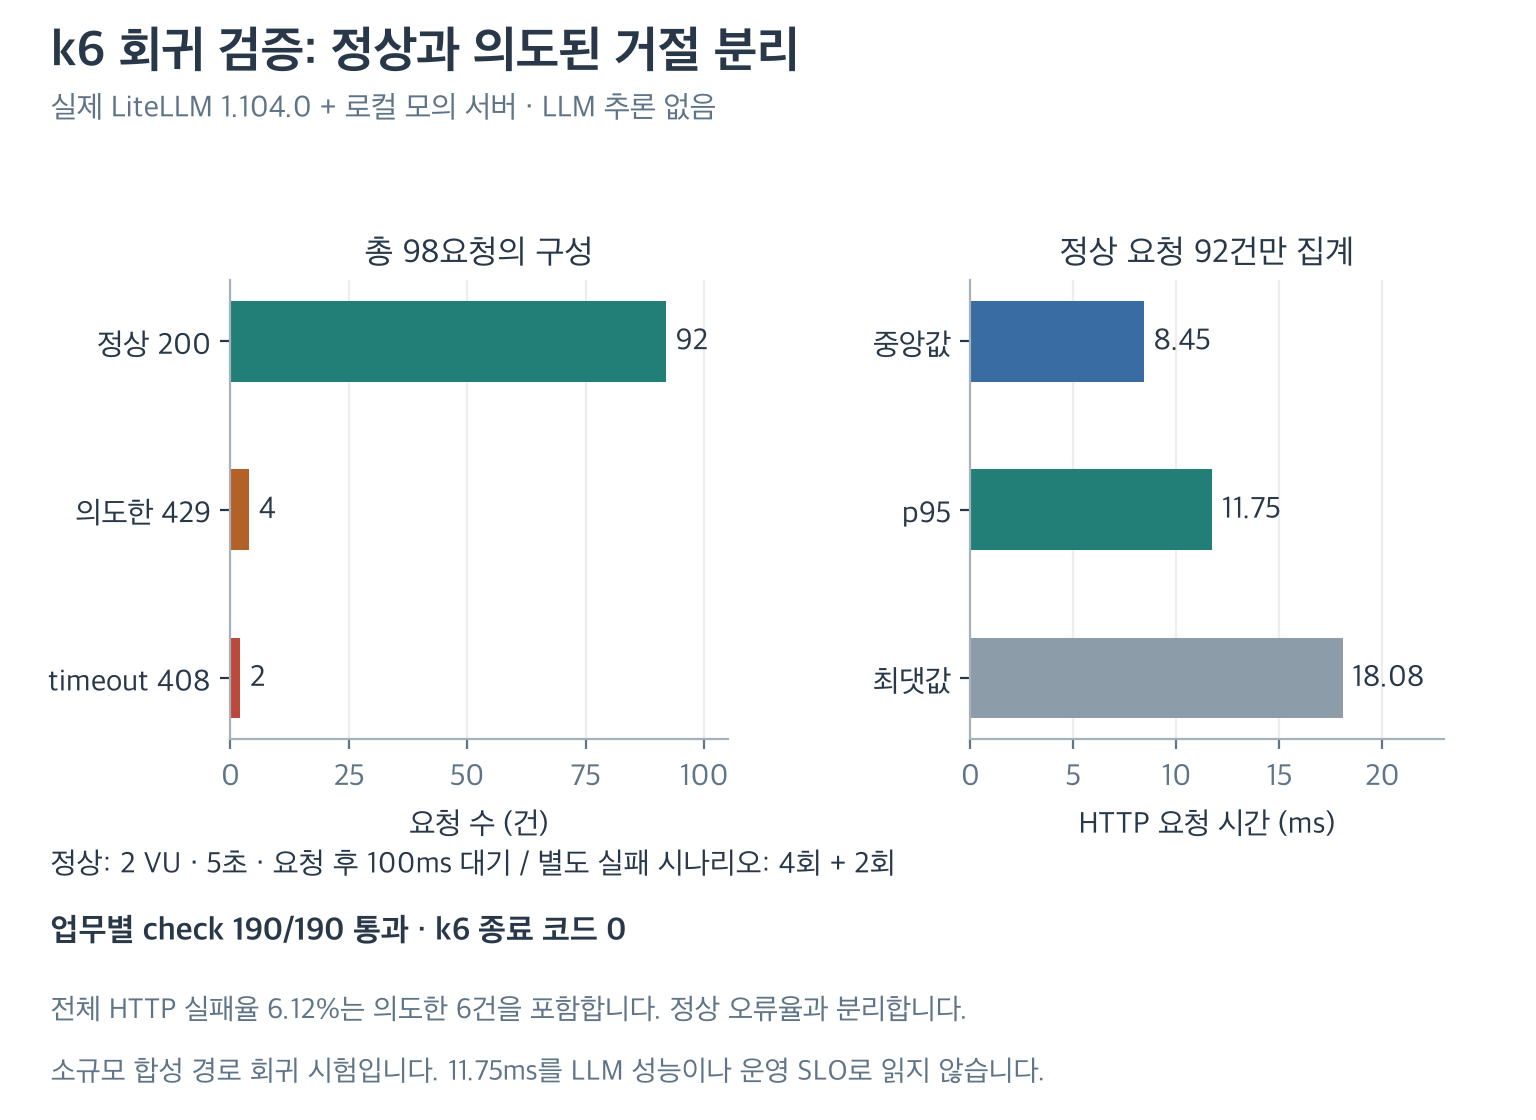
실측 차트 — k6 실행 결과로 계산한 요청 구성과 정상 요청의 지연이다. LiteLLM과 로컬 모의 서버를 측정했으며 LLM 추론은 없다. 정상 2 VU·5초라는 작은 시험 조건을 함께 읽는다.
이때 k6의 전체 HTTP 실패율은 약 6.12%다. 모든 HTTP 오류를 장애로 간주하는 threshold를 걸었다면 의도한 제한 검증 때문에 테스트가 실패했을 것이다. 각 시나리오에서 “올바른 거절인가”를 확인하고 정상 트래픽의 latency·오류율과 분리해야 한다. k6 Thresholds
11.75ms는 모의 서버의 즉시 응답을 포함한 경로 값이다. LLM 추론이 없으므로 실제 Agent의 응답 시간과 비교할 수 없다. 실제 모델 성능은 입력 길이·출력 상한·예열·동시성·품질 기준을 고정한 별도 실험으로 측정해야 한다.
4. 스트림은 다른 측정이 필요하다
이번 k6 시나리오는 일반 HTTP 요청을 사용했다. TTFT와 정확한 취소 시점은 앞 편의 SSE를 읽는 전용 Python 클라이언트로 측정했다. http_req_duration 하나만으로 첫 내용 도착과 상위 생성 중단을 판단하지 않는다.
운영 지표도 같은 원칙으로 나눈다. 요청 latency, Provider latency, Gateway overhead, TTFT는 측정 시작과 종료가 다르다. success/error/cancel 구간과 표본 수를 함께 보며, 서로 다른 요청 집단의 p95끼리 빼서 Gateway overhead라고 계산하지 않는다. LiteLLM Prometheus 지표
5. 검증한 범위와 남은 조건
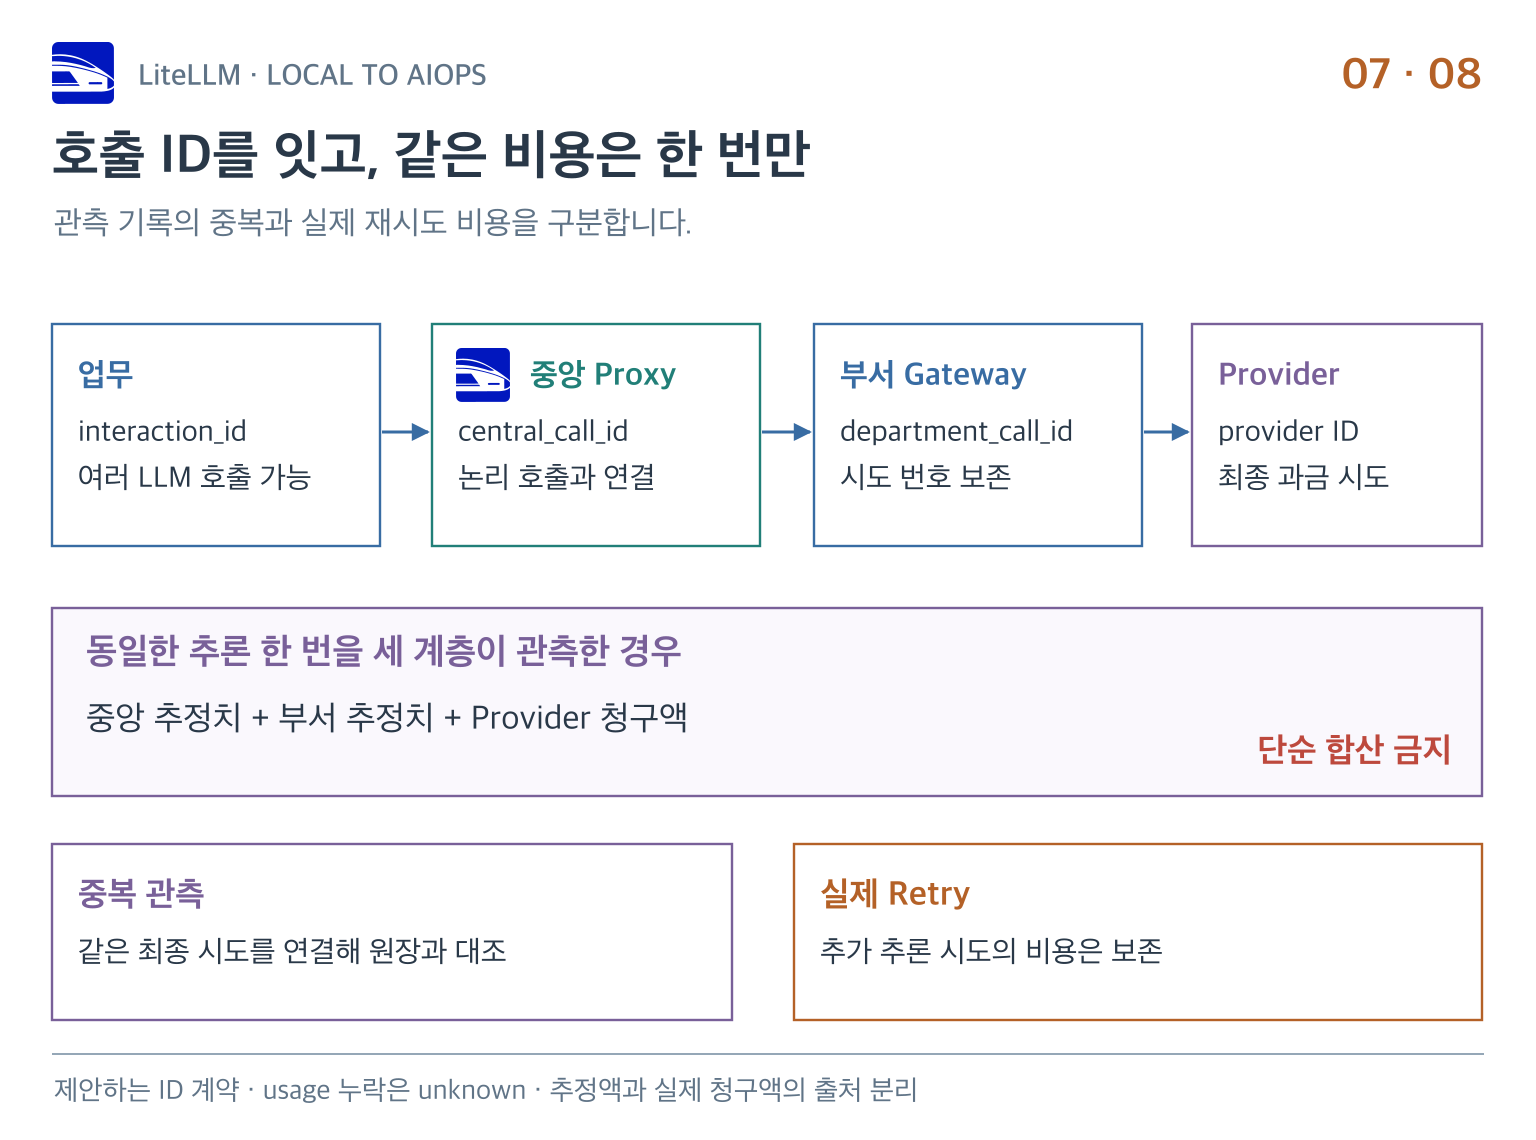
설명용 도식 — 운영 전환에서는 장애 복구뿐 아니라 업무 ID와 각 시도의 비용 출처를 끝까지 연결해야 한다. 로컬 실습의 업무 ID 전달과 실제 Provider 청구 대조는 미완료이므로 아래 조건에 포함한다.
이번 시리즈는 로컬에서 설치, 키·예산, 라우팅, cache, Agent 지표, 다중 Gateway 계약, 스트림과 의존성 장애를 다뤘다. 실제 조직 도입의 최종 판단에는 다음 검증이 더 필요하다.
| 아직 남은 조건 | 필요한 증거 |
|---|---|
| 실제 부서 연동 | 최종 처리 위치·본문 취급·인증·ID 계약 |
| 실제 비용 대조 | Provider 청구와 중앙·부서 기록의 미매칭 금액 |
| 엄격한 예산·요청 제한 | fail-closed 설정, 동시성 경계, Redis·DB 동시 장애 |
| 키 관리 신뢰성 | 회전·폐기·캐시 반영 시간, 관리 접근과 감사 |
| 고가용성 | LB 자동 우회·drain·롤링 배포·리전 장애 |
| 업무 품질 | 실제 장애 질문의 정확도, 부분 응답 판정, 성공 작업당 비용 |
| 복구 | DB와 암호화 키 백업의 독립 복원, 비용 로그 재대조 |
로컬 실습에서 200이 나왔다는 사실은 기능을 관측했다는 증거다. 조직 운영에서는 어떤 장애에서 계속 처리하고 어떤 장애에서 거절할 것인지를 먼저 정한 뒤 같은 조건에서 다시 시험해야 한다. 특히 앞 편의 조기 stream 종료처럼 정상 형식으로 보이는 불완전한 응답까지 품질·비용 판정에 반영해야 한다.
실행 기준: 2026-10-05, LiteLLM 1.104.0, k6 1.3.0. 독립 Docker 환경과 로컬 모의 서버에서 의존성 장애·복구와 HTTP 요청을 검증했다. 실제 LLM 추론 성능이나 운영 환경의 고가용성을 검증한 결과는 아니다.
