[Observability 2/5] 메트릭·로그·트레이스·프로파일은 각각 무엇을 알려줄까?
이 글에서 다룰 주제
- 메트릭: 평균·p95·요청 수를 함께 읽기
- 로그와 트레이스: 사건의 기록을 같은 요청의 처리 경로에 연결하기
- 프로파일: 오래 걸린 시간과 CPU를 쓴 시간을 구분하기
주요 단어 · Metric · Counter · Histogram · Log · Trace · Span · Profile · Cardinality
“검색이 느리다”는 사실을 알았다면 다음에는 어떤 데이터를 열어야 할까? 이 글은 데이터마다 알려주는 것과 알려주지 못하는 것을 작은 예제로 구분한다. 웹 API의 요청·응답을 알면 읽을 수 있고, 끝에서는 한 로그를 트레이스와 연결해 조사할 수 있다.
1. 전체 지도: 같은 요청을 서로 다른 단위로 기록한다
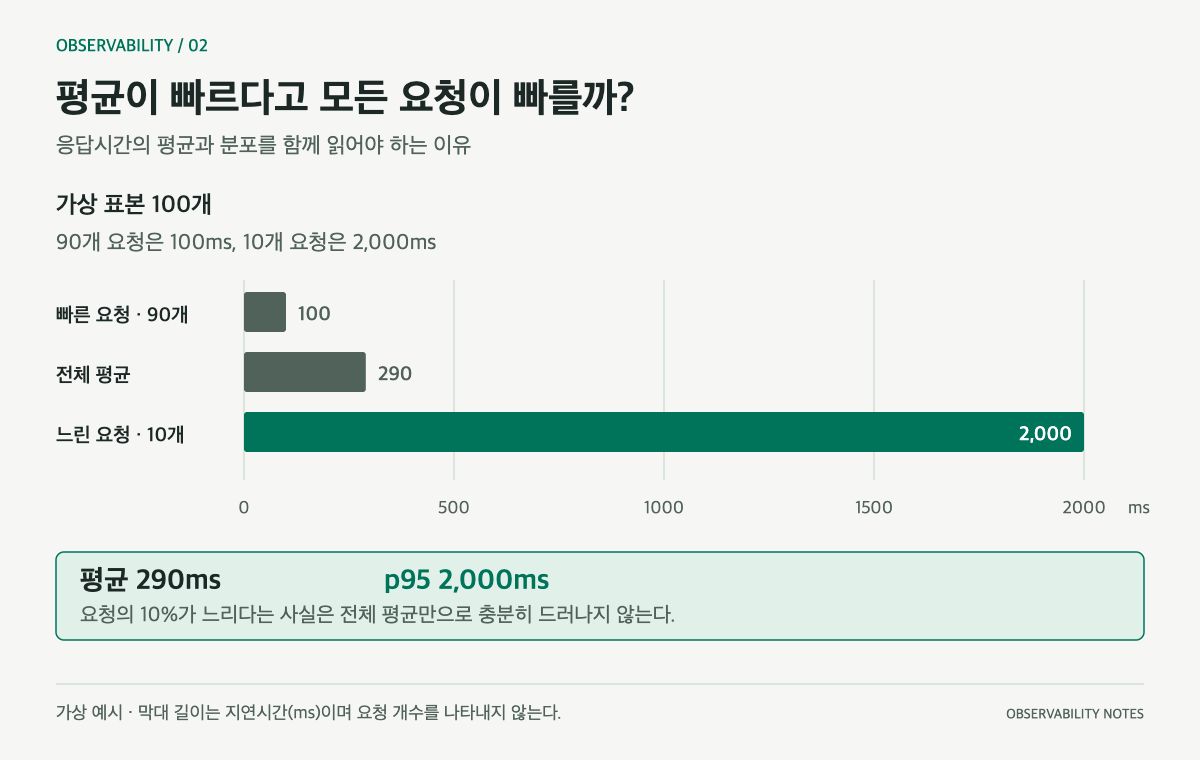
가상의 demo-api, GET /search를 계속 사용한다. 예제 시간창은 2026-10-04 10:00~10:05 KST다. 이 구간의 요청 100건은 모두 HTTP 200이며, 90건은 100ms, 10건은 2,000ms에 완료됐다고 가정한다. 숫자와 로그는 합성 데이터다.
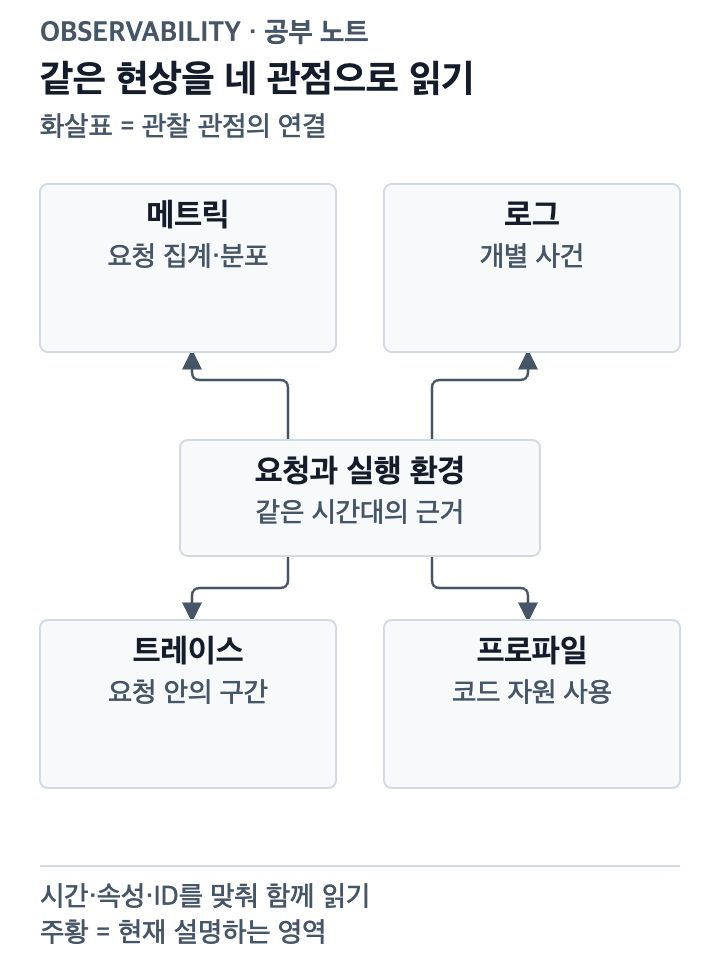
그림 1. 하나의 요청에서 얻을 수 있는 서로 다른 관측 근거. 모든 데이터가 자동으로 연결된다는 뜻은 아니다.
| 데이터 | 주로 읽는 단위 | 이번 예제의 질문 |
|---|---|---|
| 메트릭 | 시간창·그룹의 수치와 분포 | 느린 요청이 얼마나 있는가? |
| 로그 | 시점이 있는 사건 | 그 요청에서 어떤 사건이 있었는가? |
| 트레이스 | 요청의 작업 구간과 관계 | 어느 호출에서 시간을 썼는가? |
| 프로파일 | 함수·호출 스택의 표본/집계 | 어떤 코드가 CPU나 메모리를 썼는가? |
메트릭에서 시작할 수도 있고 오류 로그에서 시작할 수도 있다. 중요한 것은 표의 순서가 아니라 다음 질문에 맞는 데이터로 옮겨 가는 것이다.
2. 메트릭: 평균 290ms가 숨기는 요청 10건
Metric(메트릭)은 요청 수, 처리시간, 사용 메모리처럼 시스템의 특성을 수치로 측정한 데이터다.
우리 표본의 평균은 다음과 같다.
100건의 처리시간 합계 = 90 × 100 + 10 × 2,000
                     = 29,000ms
평균                 = 29,000 / 100 = 290ms
29,000ms는 요청별 처리시간을 더한 값이며, 요청 100건을 모두 수행하는 데 걸린 실제 경과시간을 뜻하지 않는다. 요청들이 동시에 처리됐다면 둘은 다르다. 평균 290ms라는 숫자는 틀리지 않았지만, 이 값을 “대부분의 사용자도 290ms쯤 기다렸다”고 읽으면 잘못이다. 실제 가정에서는 290ms에 완료된 요청이 한 건도 없다.
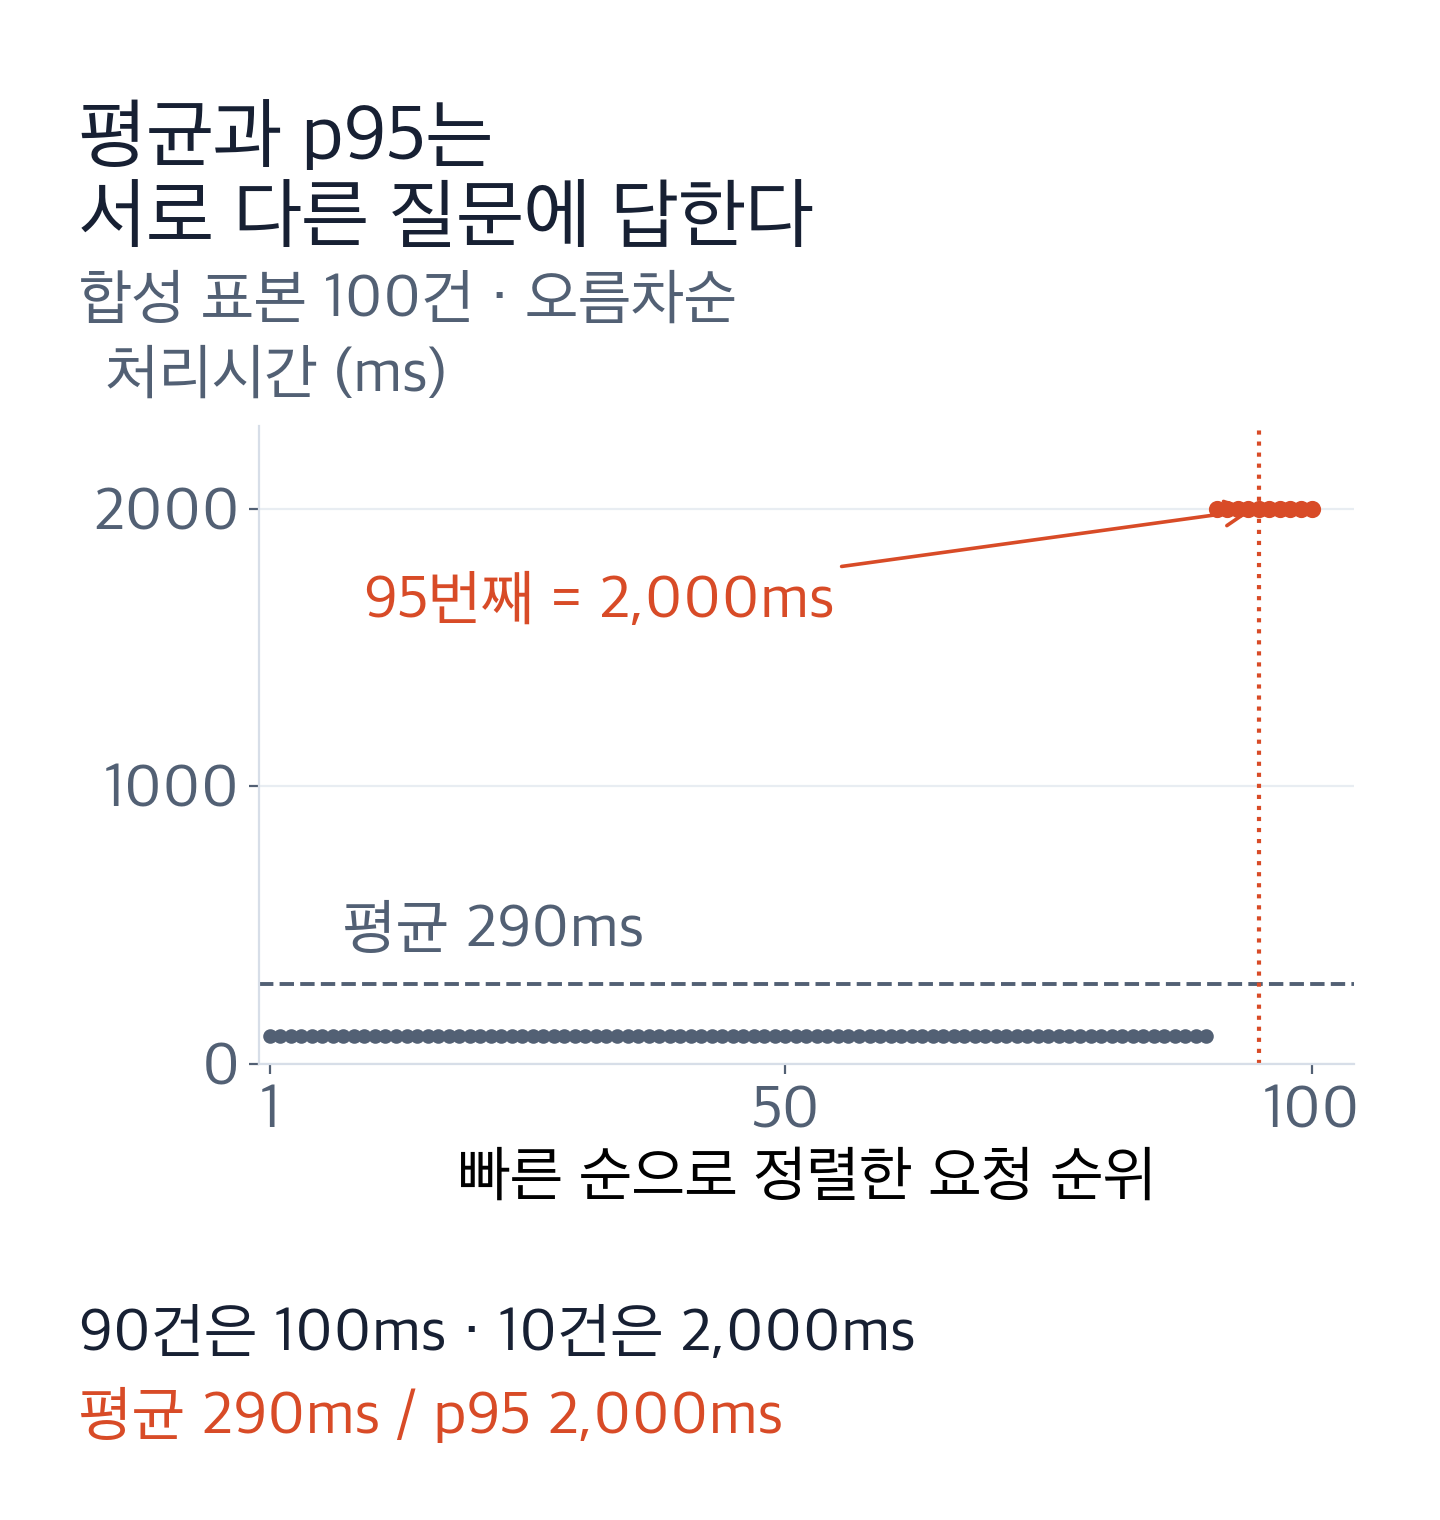
그림 2. 합성 표본을 작은 값부터 정렬했다. 가로축은 시간 순서가 아닌 요청의 순위이고, 세로축은 요청 처리시간이다.
2.1 p95를 손으로 계산하기
p95(95번째 백분위수)는 지연시간 분포에서 느린 쪽 경계를 살펴보는 값이다. 여기서는 정렬 후
ceil(0.95 × 표본 수)번째 값을 고르는 nearest-rank 방식으로 계산한다.
100개를 정렬하면 1~90번째는 100ms, 91~100번째는 2,000ms다. 따라서 95번째 값, 즉 p95는 2,000ms다. p50은 100ms다.
p95는 최대값을 뜻하지 않는다. 이 표본에서는 우연히 p95와 최대값이 같지만, 100번째 값만 10초로 바뀌어도 95번째는 2초다. 같은 값이 반복되므로 “정확히 5%만 p95보다 느리다”는 식으로 읽어서도 안 된다.
실제 저장소에서는 히스토그램 구간과 보간 방법에 따라 분위수를 추정할 수 있다. 또한 서버별 p95 두 개를 평균 낸 값은 전체 요청의 p95가 아니다. 전체를 보려면 합칠 수 있는 분포 데이터로 다시 계산해야 한다. Prometheus 히스토그램·요약 문서
2.2 Counter·Gauge·Histogram을 구분하는 이유
| 형태 | 읽는 방법 | 검색 API 예시 |
|---|---|---|
| Counter | 누적 증가량에서 기간별 변화를 계산 | 지금까지 완료한 요청 수 |
| Gauge | 관찰 시점의 값 | 현재 처리 중인 요청 수 |
| Histogram | 측정값의 개수·합계·분포를 읽음 | 요청 지연시간의 분포 |
Counter가 10,000이라고 해서 초당 10,000건이라는 뜻은 아니다. 60초 동안 10,000에서 10,120으로 늘었다면, 재시작·누락이 없다는 단순 가정에서 평균 2건/초다. 실제 쿼리는 Counter 초기화를 처리해야 한다. OpenTelemetry Metrics
2.3 라벨은 비교 축이며 비용이기도 하다
route="/search", method="GET"처럼 라벨을 두면 그룹을 비교할 수 있다. 카디널리티(Cardinality)는 여기서 실제로 나타나는 서로 다른 라벨 조합의 수와 관련된다.
예를 들어 경로 3개 × 메서드 2개 × 상태 그룹 3개가 모두 등장하면, 단일 값 메트릭 한 종류에 18개 조합이 생긴다. 여기에 요청마다 다른 ID 1만 개를 붙이면 조합이 크게 늘어난다. 실제 개수는 등장한 조합에 따라 달라지고, 히스토그램은 버킷 등 추가 시계열도 고려해야 한다.
개별 요청은 로그·트레이스에서 찾고, 메트릭에서는 제한된 그룹을 비교하는 편이 이해하기 쉽다. /items/12345 대신 /items/{id} 같은 경로 템플릿을 사용하는 이유도 여기에 있다. Prometheus 라벨 지침
3. 로그: 전체 통계에 없던 사건의 문맥
Log(로그)는 어떤 시점에 발생한 사건과 관련 정보를 남긴 기록이다. 구조화 로그는 정보를 이름 있는 필드로 나누어 저장한다.
느린 요청 한 건에서 다음 로그를 남겼다고 가정하자. 아래는 예시 필드이며 제품이 자동으로 만들어 주는 고정 스키마가 아니다.
{
  "timestamp": "2026-10-04T10:02:00+09:00",
  "level": "WARN",
  "service": "demo-api",
  "route": "/search",
  "event": "dependency_slow",
  "duration_ms": 1800,
  "trace_id": "0123456789abcdef0123456789abcdef"
}
먼저 event를 보고 “검색 저장소 호출이 오래 걸렸다는 기록”임을 읽는다. 여기의 duration_ms=1800은 의존성 호출 구간이지 요청 전체의 2,000ms가 아니다. WARN을 남겼어도 요청은 결국 HTTP 200으로 끝날 수 있다.
이 한 건만으로 전체 요청의 오류율을 계산할 수는 없다. 로그가 모든 요청에 남는지, 조건에 맞는 경우만 남는지 알 수 없기 때문이다. 로그의 강점은 개별 사건의 문맥이다. OpenTelemetry Logs
다음 행동은 이 로그의 trace_id로 같은 요청을 찾는 것이다. 시간대만 같다는 이유로 임의의 느린 트레이스를 고르면 다른 요청을 섞을 수 있다. 화면에서 링크로 바로 이동하려면 수집 필드와 데이터 소스 연결 설정도 맞아야 한다.
4. 트레이스: 2초를 어디에 썼는지 분해하기
Trace(트레이스)는 한 작업을 구성하는 구간과 관계를 기록한다. Span(스팬)은 그 안의 작업 한 구간이며 시작·종료 시각, 부모 관계, 속성 등을 갖는다.
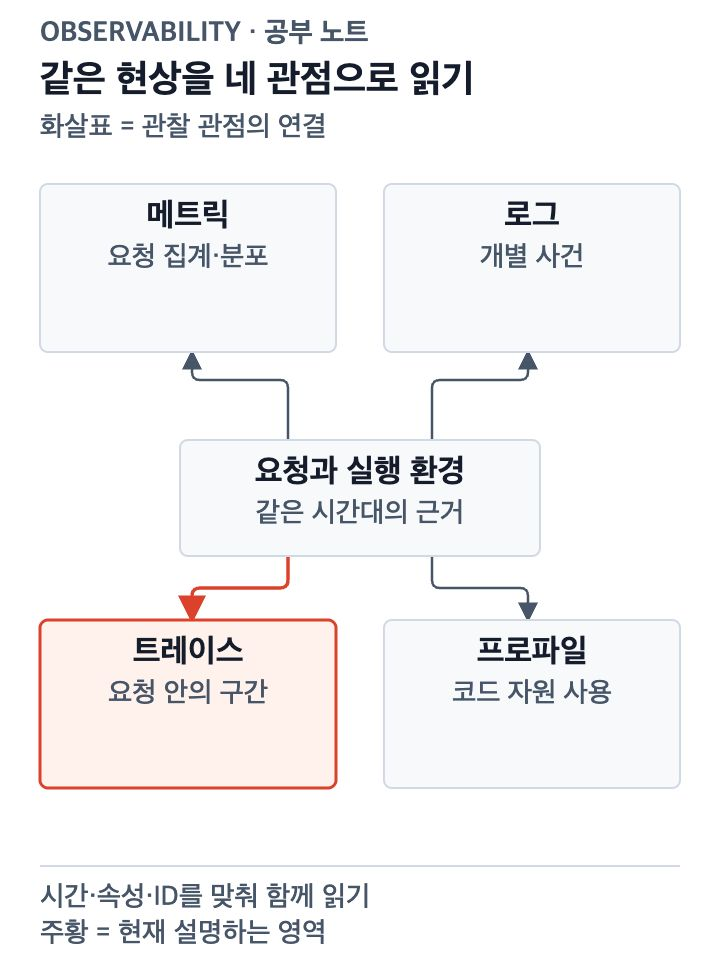
그림 3. 전체 지도에서 이번에는 트레이스에 초점을 맞춘다. 로그의 식별자가 같은 요청으로 이동할 단서가 된다.
앞의 로그와 같은 Trace ID를 가진 요청을 다음처럼 구성했다고 하자.
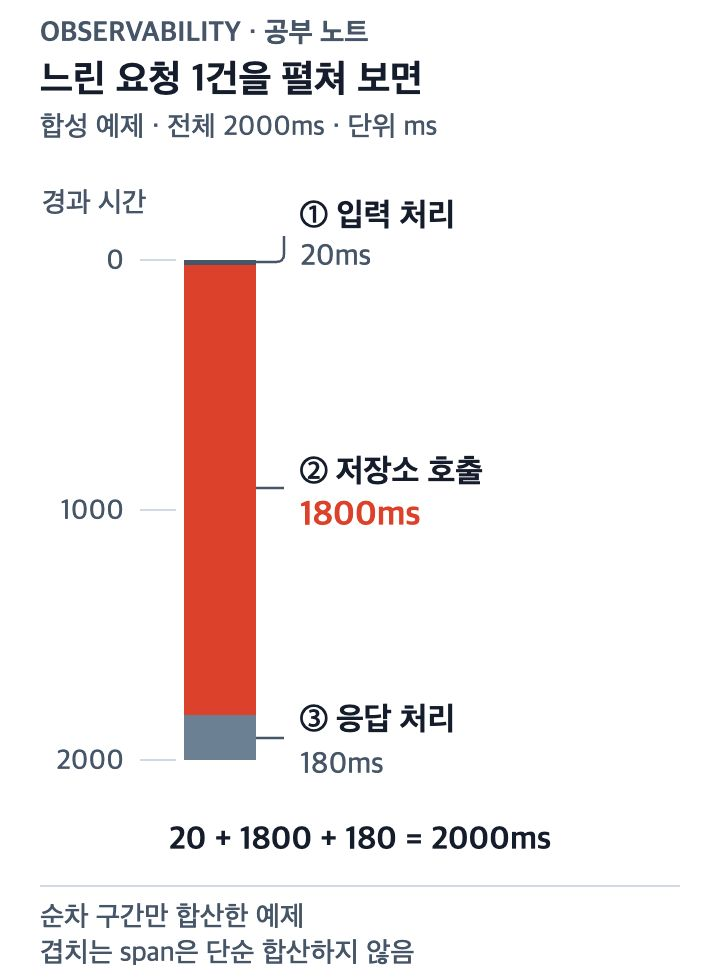
그림 4. 입력 검사 → 저장소 호출 → 응답 생성을 순서대로 수행한 가정이다. 실제 트레이스 화면이 아닌 합성 타임라인이다.
그림에서 요청 전체는 부모 Span, 내부 작업은 자식 Span으로 읽을 수 있다. 저장소 호출이 1,800ms로 길다는 것을 알았으니 해당 호출의 조건과 상대 서비스 기록을 추가로 확인한다. 이 값은 데이터베이스의 CPU 실행시간과 같지 않다.
자식 Span의 시간을 항상 더하면 안 되는 이유도 알아 두자. 두 작업이 동시에 시작해 각각 800ms 후 끝났다면, 두 작업의 합은 1,600ms지만 경과시간은 800ms다. 부모·자식은 시간도 중첩한다. 시작·종료 시각과 겹침을 보아야 한다.
서비스가 여러 개여도 같은 요청을 이어 보려면 추적 문맥 전파(Context propagation)가 필요하다. 다음 서비스로 호출할 때 추적 식별 정보를 전달하고, 받는 쪽이 이를 이어 받아야 한다. 같은 시간대에 실행됐다고 자동으로 한 트레이스가 되지는 않는다. OpenTelemetry Traces
5. 프로파일: 느린 요청과 바쁜 코드를 구분하기
Profile(프로파일)은 실행 중인 호출 스택 등을 수집·집계해 어떤 코드에서 시간이나 자원을 소비했는지 보여주는 데이터다.
트레이스가 “어떤 작업 구간이 길었는가?”를 보여준다면, 프로파일은 “어떤 함수나 호출 경로에 자원 사용이 몰렸는가?”를 조사하는 데 도움을 준다.
예를 들어 앞의 180ms 응답 생성 구간에 CPU 연산이 많다는 별도 근거가 있다면, 정렬과 직렬화 중 어느 코드가 CPU를 많이 쓰는지 확인할 수 있다. 반대로 1,800ms 대부분을 외부 응답 대기로 보냈다면 CPU 프로파일만으로 그 대기 이유를 찾기 어렵다.
| 프로파일 종류 | 확인하는 것 |
|---|---|
| CPU | CPU가 실행한 호출 경로에 분포한 표본/시간 |
| Wall time | 대기를 포함한 경과시간 관점의 분포 |
| Allocation | 객체 할당량 또는 할당 횟수 |
| Heap | 수집 방식에 따라 살아 있는 객체·메모리 관련 값 |
지원 종류와 단위는 언어·프로파일러에 따라 다르다. Flame graph에서 블록이 넓다는 것은 선택한 프로파일 값의 비중이 크다는 뜻이다. 가로 방향을 요청의 시간 순서로 읽거나, 모든 그래프의 너비를 CPU 시간으로 읽으면 안 된다. Pyroscope 프로파일 종류, Flame graph의 축과 해석
여러 요청의 표본을 집계한 프로파일을 특정 요청 한 건의 실행 기록처럼 취급하지 않는 것도 중요하다. 요청과 프로파일을 직접 연결하는 기능은 계측 조합과 별도 설정을 확인해야 한다.
6. 실제로 조사한다면: 같은 범위를 유지하며 연결하기
다음은 가능한 조사 경로 하나다. 단계가 맞지 않으면 필요한 데이터부터 시작해도 된다.
- 메트릭에서
demo-api /search, 10:00~10:05 KST를 본다. p95 2초와 요청 수 100건을 함께 읽는다. - 로그를 같은 서비스·시간창으로 좁혀
dependency_slow사건을 찾는다.trace_id를 확보한다. - 트레이스에서 그 요청의 1.8초 저장소 호출을 확인한다. 빠른 요청과 조건을 비교한다.
- 프로파일은 CPU를 많이 쓰는 코드가 의심될 때 종류와 구간을 맞춰 사용한다. 대기가 긴 경우에는 연결 풀·상대 서비스 등 다른 근거가 먼저 필요할 수 있다.
여기까지의 데이터가 말하는 것은 “느린 요청 하나의 저장소 호출 구간이 길다”까지다. 전체 10건의 원인이 같다는 결론도, 저장소 CPU가 원인이라는 결론도 아직 아니다.
직접 판단해 보기
Q. 트레이스에 느린 요청이 없으면 실제로도 없었을까?
A. 샘플링·누락·보존 기간을 확인해야 한다. 저장된 트레이스 표본은 전체 요청과 같지 않을 수 있다.
Q. 두 서버의 p95가 100ms와 2,000ms라면 전체 p95는 1,050ms일까?
A. 아니다. 각 서버의 요청 수와 분포가 필요하다. 분위수끼리 평균해 전체 분위수로 쓸 수 없다.
Q. CPU 프로파일에서 큰 함수가 안 보이면 느린 요청이 없었다는 뜻일까?
A. 아니다. 요청은 CPU 실행보다 대기에 많은 시간을 쓸 수 있다.
개정: 2026-10-04. 연결한 공식 문서의 신호 정의·트레이스 문맥·히스토그램 해석·프로파일 역할을 확인했다. 합성 표본의 평균·nearest-rank 분위수·순차 시간 합계는 계산으로 검증했다. 서비스와 저장소를 실제 실행한 결과는 아니다.
이전: Monitoring·APM·Observability · 시리즈 전체 · 다음: Grafana 생태계 지도
