[Observability 5/5] k6와 알림으로 이해하는 성능 검증과 장애 대응
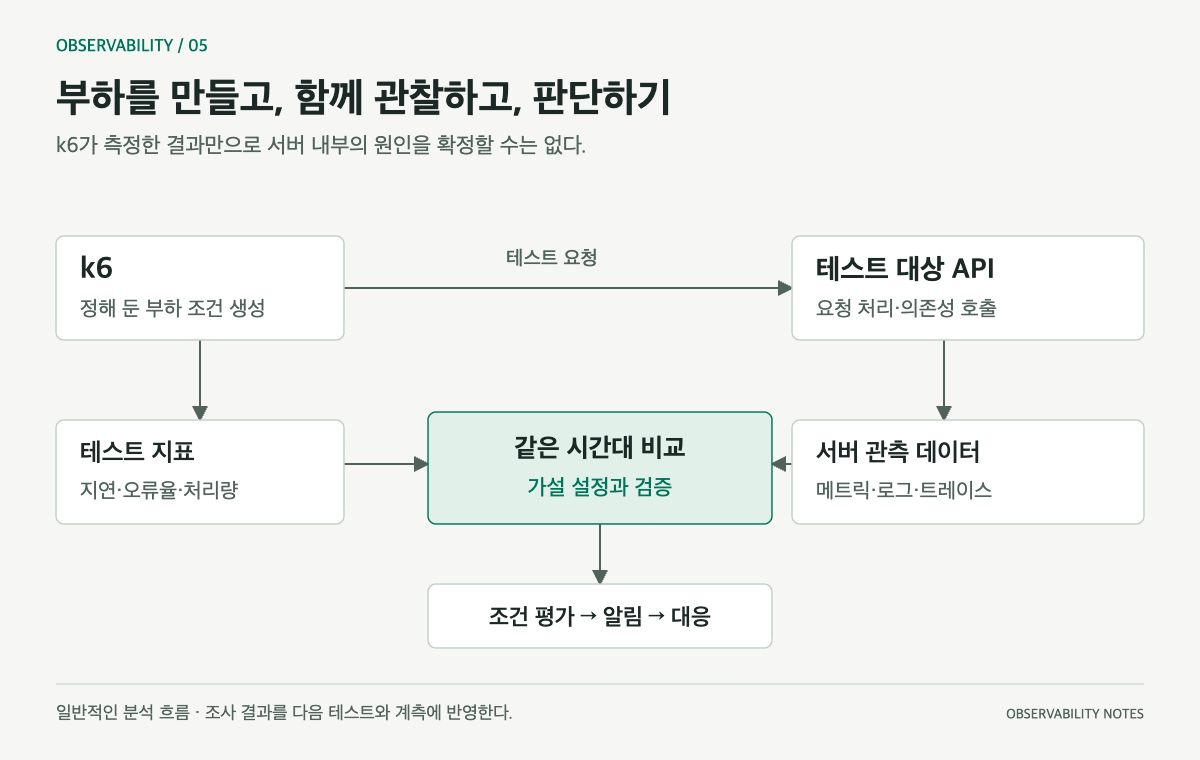
이 글에서 다룰 주제
- 성능 검증: 부하 조건과 합격 기준을 따로 정의하기
- k6 읽기: VU·Check·Threshold·요청 시간을 구분하기
- 관측과 대응: 느려진 구간을 조사하고 행동으로 이어지는 알림 만들기
주요 단어 · Load Test · VU · Check · Threshold · 부하 모델 · Alerting
앞선 편에서는 “무슨 일이 일어났는가?”를 관측했다. 이번에는 “같은 조건에서 다시 느려지는가?”, “바꾼 뒤 개선됐는가?”를 시험한다. 무엇을 검증한 테스트인지 설명하고, 실패했을 때 다음에 볼 데이터를 고르는 것이 목표다.
가상의 demo-api에서 GET /search를 호출하는 예제를 사용한다. 아래 코드는 공식 문법을 확인한 학습용 예제이며 실제 서버에 실행한 결과가 아니다. 회사·실제 프로젝트의 부하 조건이나 운영 정보를 사용하지 않는다.
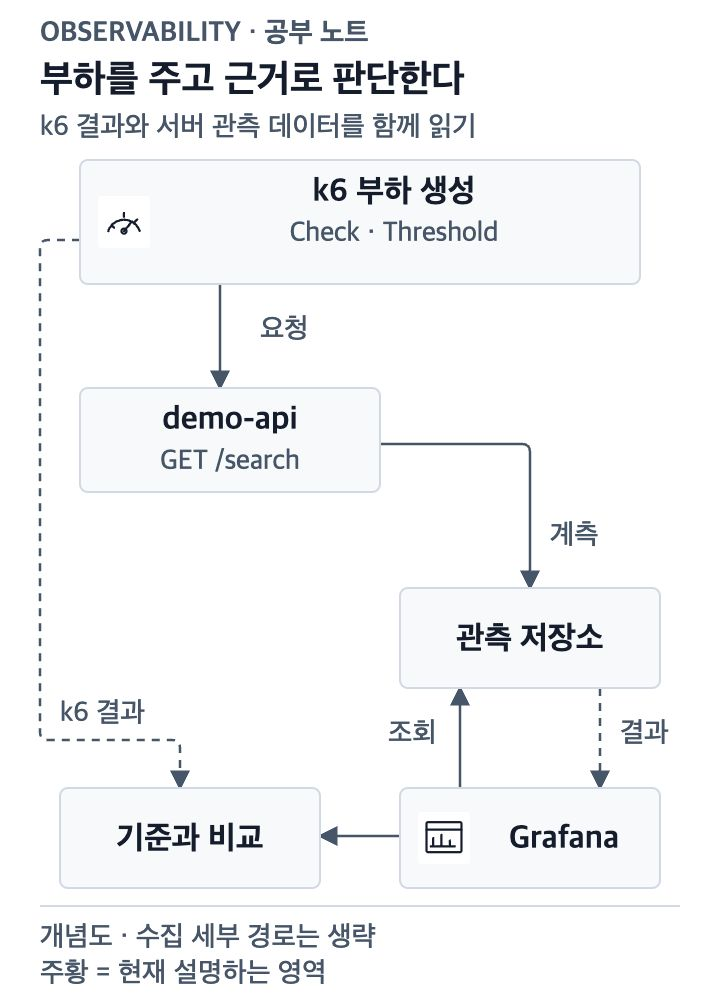
그림 1. 작성자 제작 개념도. 공식 로고 대신 직접 만든 역할 기호와 제품명을 사용했다. 요청을 만드는 경로와 그 결과를 관측하는 경로를 구분한다. k6의 숫자는 결과를 알려 주고, 서버 데이터는 원인 후보를 좁히는 데 쓰인다.
1. 테스트 설계: 부하 조건과 합격 기준부터 적기
부하 테스트는 요청량이나 동시 실행 수 같은 조건을 만들고, 그 조건에서 시스템의 성능과 안정성을 측정하는 시험이다.
RUM은 실제 사용 환경을, 부하 테스트는 시험자가 만든 환경을 관찰한다. RUM에서 찾은 느린 경로를 테스트로 재현할 수 있지만, 하나의 테스트 결과를 모든 사용자 경험으로 일반화하면 안 된다.
이번 예제는 다음과 같이 범위를 좁힌다.
| 정할 항목 | 이번 예제 | 이 조건의 의미 |
|---|---|---|
| 요청 | GET /search 한 번 | 반복 1회에 요청 1개 |
| 부하 | VU 10개, 30초 | 고정된 실행 주체가 반복 |
| 대기 | 요청 후 1초 | 응답 뒤 다음 반복까지 휴식 |
| 합격 기준 | 실패율·Check·p95 | 아래 세 기준을 모두 만족 |
“30초 동안 10 VU”는 작은 동작 확인용 조건이다. 최대 처리량이나 장시간 안정성을 검증하기에 충분하다는 뜻은 아니다. 로그인, 캐시, 입력 데이터 크기, 서버 자원처럼 결과에 영향을 주는 조건도 실제 비교에서는 맞춰야 한다.
2. k6 예제: 한 요청을 반복하고 결과를 판정하기
k6는 성능 테스트를 스크립트로 작성하고 실행하는 도구다. VU(Virtual User)는 시나리오를 실행하는 가상 사용자이며, 실제 사람의 모든 행동을 자동으로 재현하는 개념은 아니다.
다음 코드는 k6가 설치돼 있고 127.0.0.1:8080에서 직접 HTTP 200을 반환하는 /search 테스트 경로를 준비했다고 가정한다. 서비스 구현과 설치는 이 글의 범위 밖이다. 파일을 load-test.js로 저장한다. k6/http는 k6의 모듈이므로 이 코드는 Node.js가 아니라 k6로 실행한다.
import http from 'k6/http';
import { check, sleep } from 'k6';

export const options = {
  vus: 10,
  duration: '30s',
  thresholds: {
    http_req_failed: ['rate<0.01'],
    checks: ['rate>0.99'],
    http_req_duration: ['p(95)<500'],
  },
};

export default function () {
  const url = 'http://127.0.0.1:8080/search';
  const response = http.get(url);

  check(response, {
    'status is 200': (r) => r.status === 200,
  });

  sleep(1);
}
사용자가 준비한 테스트 환경에서 실행하는 명령은 다음과 같다.
k6 run load-test.js컨테이너에서 k6를 실행하면 127.0.0.1은 그 컨테이너 자신을 가리킨다. 테스트 서버에 접근할 수 있는 주소로 바꾸고, 비교를 위해 k6·대상 버전과 실행 위치를 기록한다.
VU마다 요청 → 응답 검사 → 1초 휴식을 반복한다. duration은 부하 실행 구간이다. 진행 중인 반복을 정리하는 시간 등으로 명령의 전체 경과시간은 30초보다 길 수 있다.
2.1 Check는 개별 검사, Threshold는 전체 판정
Check는 응답이 조건을 만족했는지 검사하고 성공 비율을 기록한다. 예제의 Check는 “상태 코드가 정확히 200인가?”다. Check가 실패해도 그것만으로 전체 테스트가 자동으로 실패 종료되지는 않는다. k6 Checks
Threshold는 수집된 통계에 적용하는 합격 기준이다. 예제는 checks에도 Threshold를 걸었으므로 Check의 성공 비율이 기준에 못 미치면 테스트 실패로 연결된다. Threshold가 실패하면 k6는 0이 아닌 종료 코드를 반환하므로 자동화에서 실패를 감지할 수 있다. k6 Thresholds
| Threshold | 이번 예제의 의미 | 경계값 해석 |
|---|---|---|
http_req_failed: rate<0.01 | HTTP 실패 비율 1% 미만 | 정확히 1%는 실패 |
checks: rate>0.99 | Check 성공 비율 99% 초과 | 정확히 99%는 실패 |
http_req_duration: p(95)<500 | 요청 시간 p95 500ms 미만 | 정확히 500ms는 실패 |
이 수치는 설명용 기준이며 모든 API의 권장값은 아니다. 사용자가 기다릴 수 있는 시간과 서비스 목표에 맞춰 정해야 한다.
http_req_failed와 Check도 동일한 조건이 아니다. 기본 HTTP 성공 분류는 200~399이고, 여기서 작성한 Check는 정확히 200만 인정한다. 예를 들어 응답이 201이면 기본 HTTP 실패 비율에는 실패로 잡히지 않아도 이 Check는 실패한다. 또 Check를 여러 개 만들면 checks의 분모는 요청 수가 아니라 수행한 Check 수다. 이번 코드는 요청당 하나라서 해석이 단순하다. k6 HTTP 응답 분류
2.2 요청 시간은 화면 완료 시간이 아니다
http_req_duration은 요청 전송·응답 대기·응답 수신 시간을 더한 값이다. 초기 DNS 조회와 연결 수립 시간은 포함하지 않는다. 따라서 모든 네트워크 준비 비용을 포함한 전체 경과시간이나 서버 내부 처리 시간과 동일하지 않다. k6 기본 메트릭
이 코드는 HTTP 응답을 측정한다. 4편의 예제처럼 응답을 받은 뒤 브라우저가 검색 결과를 그리는 시간은 측정하지 않는다. “API의 p95가 통과했다”를 “사용자가 결과를 보는 시간이 통과했다”로 바꾸어 읽지 않는 것이 중요하다.
3. 결과 해석: 모두 200이어도 성능 테스트는 실패할 수 있다
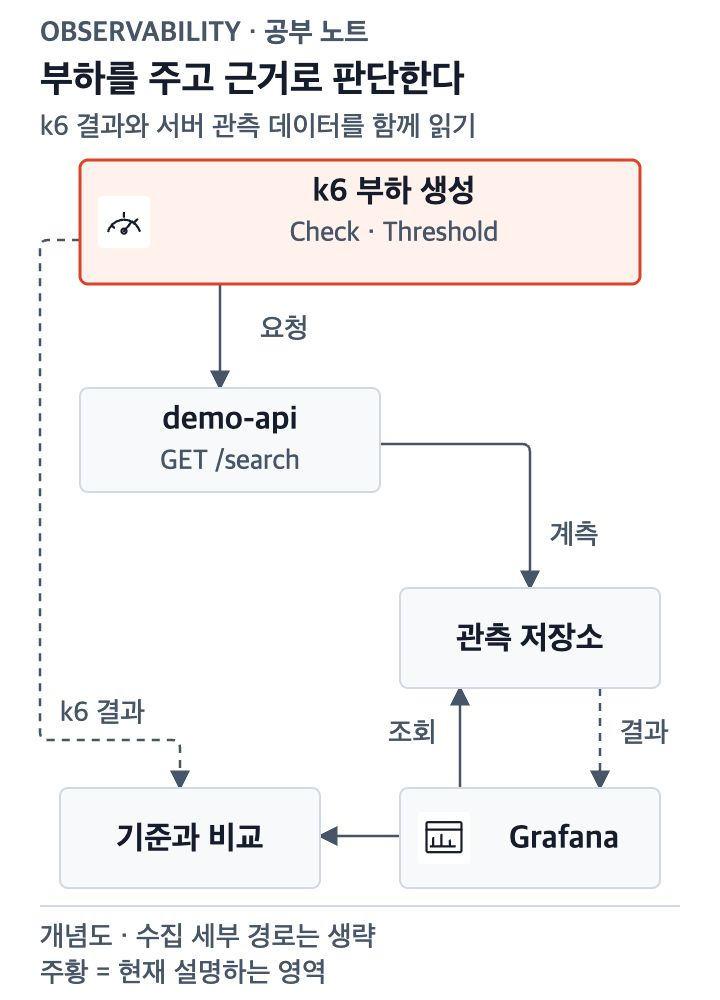
그림 2. 작성자 제작 강조판. 주황색은 측정값을 기준과 비교하는 부분이다. 상태 코드 성공과 응답 속도 통과는 별개의 판단이다.
시리즈에서 쓴 100건 분포를 판정 연습에 다시 사용하자. 90건은 100ms, 10건은 2000ms이고 모두 HTTP 200이다. 이번 절에서는 이 시간을 http_req_duration의 가상 표본이라고 가정한다. 위 k6 스크립트를 실행해 얻은 출력이 아니며, 서버 처리 시간과 k6 요청 시간이 현실에서 항상 같다는 뜻도 아니다.
HTTP 실패 비율   0%       → 1% 미만 통과
Check 성공 비율  100%     → 99% 초과 통과
요청 시간 p95   2000ms   → 500ms 미만 실패
100건을 정렬하면 뒤쪽 10건이 모두 2000ms여서 p95는 2000ms다. 평균 290ms가 낮아 보여도 지연 기준은 실패다. 세 조건 중 하나가 실패했으므로 전체 테스트도 실패한다.
통과해도 이번 요청 구성·부하·시간에서 기준을 만족했다는 의미다. 표본이 적거나 워밍업 영향을 받으면 다음 실행의 p95가 달라질 수 있다. 한 번의 합격은 최대 처리량이나 미래의 모든 상황을 보증하지 않는다.
4. 부하 모델: VU 10개는 초당 요청 10개가 아니다
예제는 각 VU가 요청을 마치고 1초 쉰 다음 새 반복을 시작한다. 응답이 느려지면 그 VU의 다음 요청도 늦어진다. 이런 모델을 폐쇄형 모델(Closed model)이라고 한다.
다른 비용을 무시하고 요청 1개가 100ms 걸리면 한 반복은 약 1.1초다. 10 VU의 대략적인 요청률은 다음처럼 계산한다.
요청 100ms: 10 / (0.1 + 1) ≈ 9.09회/초
요청 2000ms: 10 / (2 + 1) ≈ 3.33회/초
이는 순차 반복과 일정한 요청 시간을 가정한 계산이지 실측 결과가 아니다. 핵심은 서버가 느려질수록 시험 도구가 보내는 요청률도 낮아질 수 있다는 점이다. 실제 사용자가 계속 새 요청을 보내는 상황을 시험하려는데 이 모델을 고르면, 만들려던 부하와 달라질 수 있다.
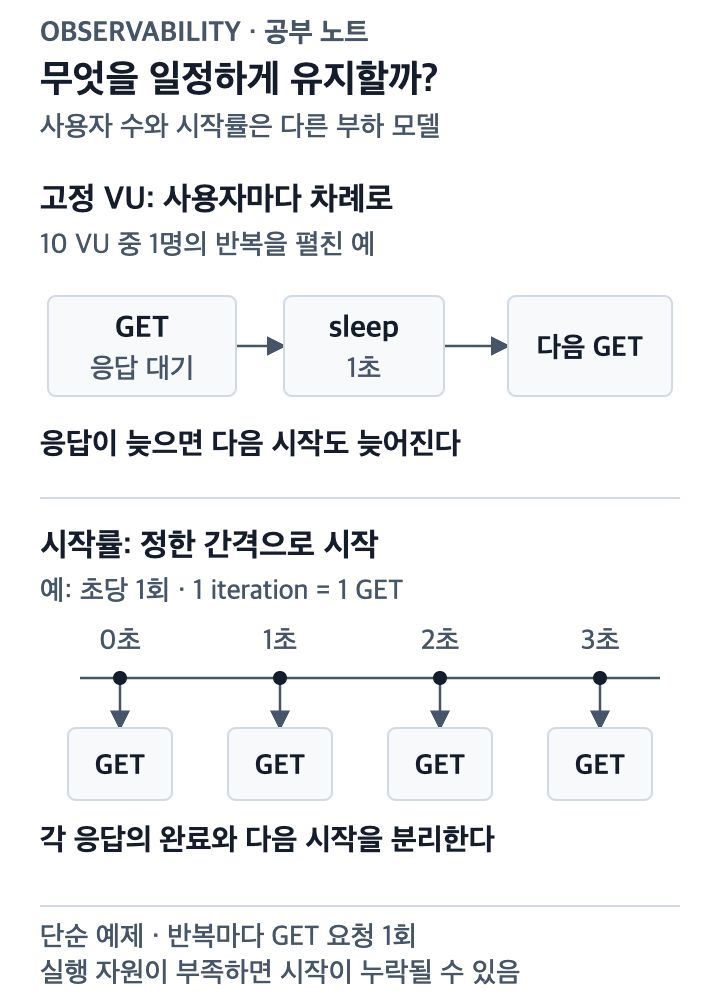
그림 3. 작성자 제작 상세도. 폐쇄형은 반복 완료가 다음 시작에 영향을 준다. 개방형은 시작률을 따로 정하지만 이를 실행할 충분한 VU와 생성기 자원이 필요하다.
개방형 모델(Open model)에서는 반복 시작률을 응답 완료와 분리한다. k6의 constant-arrival-rate는 일정한 속도로 반복을 시작하는 방식이다. 반복당 요청이 하나일 때만 계획한 반복 시작률을 요청 시작률과 직접 연결할 수 있다. 요청이 여러 개이거나 조건 분기가 있으면 둘은 달라진다. k6의 개방형·폐쇄형 모델
도착률 기반 실행에서는 실행기가 시작 간격을 조절하므로 예제의 sleep(1)을 그대로 붙여 요청률을 맞추려 하지 않는다. 또 여유 VU가 부족하면 계획한 반복을 시작하지 못할 수 있다. dropped_iterations를 보고 시험하려던 부하를 실제로 만들었는지부터 확인한다. constant-arrival-rate 실행기
5. 관측 연결: 느리다는 결과에서 원인 후보로 이동하기
k6가 지연 증가를 알려 주더라도 서버의 원인을 확정해 주지는 않는다. 예를 들어 요청 시간이 길어진 이유가 서버 CPU, 연결 대기, 외부 저장소, 네트워크 또는 부하 생성기 자체의 한계일 수 있다.
여기서는 관측 화면을 2026-10-04 10:00~10:05 KST로 맞추고, 그 안에서 별도로 수행할 30초 테스트의 시작·종료를 표시한다고 가정한다. 5분 관측창과 30초 부하 실행 구간은 다르다.
| 발견한 현상 | 함께 볼 데이터 | 다음 질문 |
|---|---|---|
| 지연 증가 | 요청 수·CPU·실행 중 요청 수 | 부하 증가와 자원 포화가 겹쳤나? |
| 일부 요청만 지연 | 느린 요청의 트레이스 | 어느 호출 구간이 길었나? |
| 오류 증가 | 오류 로그·의존성 상태 | 타임아웃인가, 응답 오류인가? |
공통 예제의 서버 트레이스에서는 총 2000ms 중 저장소 호출이 1800ms였다고 가정했다. 같은 요청의 dependency_slow 로그와 관련 저장소 지표를 보면 조사 범위를 더 좁힐 수 있다. 그래도 긴 Span 하나로 저장소 내부 실행이 원인이라고 확정하지 않는다. 연결을 얻기 위한 대기나 네트워크 비용이 포함됐을 수 있다.
개선 전후에는 입력 데이터·캐시·부하·실행 시간·생성기 위치를 맞춘다. 여러 조건이 함께 바뀌면 어떤 변화가 결과를 만들었는지 해석하기 어렵다.
6. 알림 설계: 기준 위반을 조사 가능한 메시지로 만들기
Alerting은 관측 데이터를 조건과 비교해 주의가 필요한 상태를 평가하고 전달하는 과정이다. 테스트의 합격 판정과 달리 운영 중에 반복 평가하며 누구에게 무엇을 전달할지까지 정해야 한다.
시리즈의 가상 요청은 모두 HTTP 200이었으므로 오류율 알림만으로는 느림을 잡지 못한다. 이번에는 검색 지연을 대상으로 설명용 알림을 설계해 보자. 아래는 복사해서 실행하는 설정 코드가 아니라 설정 의도를 적은 예다.
대상: demo-api / GET /search
조회: 최근 5분의 요청 시간 p95
조건: p95 >= 500ms, 요청 수 >= 100
평가: 30초마다
대기: 조건이 2분 동안 유지될 때 알림
5분은 매번 데이터를 읽는 조회 범위, 30초는 평가 주기, 2분은 잠깐의 튐을 걸러내기 위해 기다리는 조건 유지 시간이다. 세 시간을 합쳐 하나의 지연 시간처럼 해석하지 않는다. 임계값·최소 요청 수·유지 시간은 설명용 선택이며, 실제로는 사용자 영향과 탐지해야 할 속도에 맞춘다. Grafana의 알림 규칙 평가
메트릭의 단위도 맞춰야 한다. 저장된 요청 시간이 초 단위라면 500ms는 0.5초다. 500이라는 숫자를 그대로 넣으면 완전히 다른 조건이 된다. p95의 집계 대상과 시간 범위가 테스트 Threshold와 다르면 두 판정이 다를 수 있는 것도 자연스럽다.
데이터가 사라지면 지연이 0으로 좋아졌다고 해석하지 않는다. Grafana 관리형 알림에는 No Data와 Error 상태가 있다. 데이터 없음과 질의 오류를 어떻게 처리할지 규칙에 맞춰 정하고, 수집 대상 상태나 수집기 오류를 별도로 확인하도록 연결한다. 특정 시계열 하나만 사라진 경우도 전체 조회의 No Data와 구분해 점검해야 한다. No Data와 Error 상태
6.1 받은 사람이 무엇을 할 수 있어야 할까?
“서버 느림”만 보내면 대상과 근거를 다시 찾아야 한다. 메시지에는 서비스·경로, 관측 구간과 시간대, 현재 값과 기준, 관련 화면, 첫 확인 항목을 넣는다.
대상: demo-api / GET /search
증상: 최근 5분 p95가 500ms 이상
근거: 현재 p95, 요청 수, 평가 시각
탐색: 동일 서비스·시간의 대시보드 링크
첫 확인: 요청량 → 느린 트레이스 → 의존성 상태
여기에 전달 대상인 Contact point와 전달 경로인 Notification policy를 연결한다. 알림 규칙을 만들었다는 사실과 누군가에게 통지가 도착했다는 사실은 다르므로 전달도 확인해야 한다. Grafana Alerting 구성요소
온콜(On-call)은 문제가 생겼을 때 누가 받아 확인하고, 언제 다른 담당자에게 넘길지 정한 대응 체계다. 도구 이름보다 수신·확인·조사·조치·해결 확인의 책임이 중요하다. 알림을 읽었다는 상태와 사용자의 문제가 해결됐다는 상태도 구분한다. 조치 후에는 같은 조건과 지표로 회복을 확인한다.
7. 적용 질문: 결과와 다음 행동을 연결하기
Q1. HTTP 200 비율이 100%면 위 테스트는 통과할까?
보장되지 않는다. p95가 500ms 이상이면 지연 Threshold가 실패한다. HTTP 성공, Check 성공, 지연 기준은 따로 판정한다.
Q2. 10 VU를 유지했는데 요청률이 줄었다. 무엇을 먼저 볼까?
폐쇄형 모델에서 응답 시간이 늘었는지 본다. 부하 생성기 자원과 오류도 확인한다. 일정 요청 도착률을 시험하려던 것이라면 모델이 질문에 맞는지도 다시 검토한다.
Q3. 대시보드가 비고 알림 값도 없다. 정상으로 처리할까?
데이터가 없는 이유부터 확인한다. 트래픽이 없을 수도 있지만 수집·전송·질의가 실패했을 수도 있다. 정상 값 0과 관측 불가 상태는 다른 상태다.
상태 변화에서 출발해 신호를 고르고, 수집 경로와 브라우저 경험을 확인했다. 그 근거로 시험 조건을 만들고 실패하면 다시 조사한다. 다음 계측을 추가할 이유는 이번에 답하지 못한 질문에서 나온다.
검증 범위 — 2026-10-04: 공식 문서에서 k6 Check·Threshold·HTTP 메트릭·부하 모델과 Grafana 알림 평가·전달·No Data/Error를 확인했다. k6 코드는 공식 구문 기반 미실행 예제다. 수치와 알림 조건은 학습용 가정이며 실측 결과가 아니다.
