영속성 컨텍스트
- 개념적으론 엔티티를 영속적으로 저장하는 환경
- JPA에선 엔티티의 생명주기 관리, 앱과 DB 사이의 여러 최적화 작업을 해주는 논리적 공간
영속성 컨텍스트의 속성
1차 캐시
Map 형태의 캐시 저장소
- 먼저 1차 캐시를 확인
- 동일한 ID의 엔티티 객체가 있으면 DB 조회 없이 즉시 반환
동일성(Identity) 보장
같은 트랜잭션 안에서 같은 ID로 조회한 엔티티는 항상 동일한 메모리 주소의 인스턴스임이 보장
(==비교 시true보장)
변경 감지 (Dirty Checking)
- 트랜잭션이 커밋되기 직전에 영속성 컨텍스트는 1차 캐시의 스냅샷과 현재 상태를 비교
- JPA가 알아서 수정을 감지하고
UPDATESQL을 생성하여 DB에 반영
@Transactional
public void updateMemberName(Long id, String newName) {
    Member member = memberRepository.findById(id).orElseThrow(
		    () -> new IllegalStateExcetion("존재하지 않는 유저 입니다.")
    ); // 영속성 컨텍스트가 관리 시작

    // member.updateName()만 호출했을 뿐이고, update 쿼리는 없는 상황!
    member.updateName(newName);
} // 👈🏻 트랜잭션이 끝나는 이 시점에 JPA가 변경을 감지하고 UPDATE 쿼리를 날려준다.- 트랜잭션 도중에 명시적으로 업데이트하려면
memberRepository.save()를 호출
쓰기 지연 (Transactional Write-Behind)
- 수정사항이 곧바로 DB에 반영되지 않음
- 수정된 엔티티는 1차 캐시에 저장
- JPA는 DB에 반영하기 위한 SQL(
INSERT등)을 모아둠 - 트랜잭션이 커밋되는 순간 모아뒀던 SQL을 한 번에 DB로 보냄 (flush)
- DB 상호작용을 최소화하여 성능 최적화 가능
EntityManager
- 내부적으로 영속성 컨택스트 공간을 가지고 있음
- JpaRepository는 내부적으로 EntityManager 사용
- Spring Data JPA는 EntityManager를 편리하게 사용할 수 있도록 추상화한 것
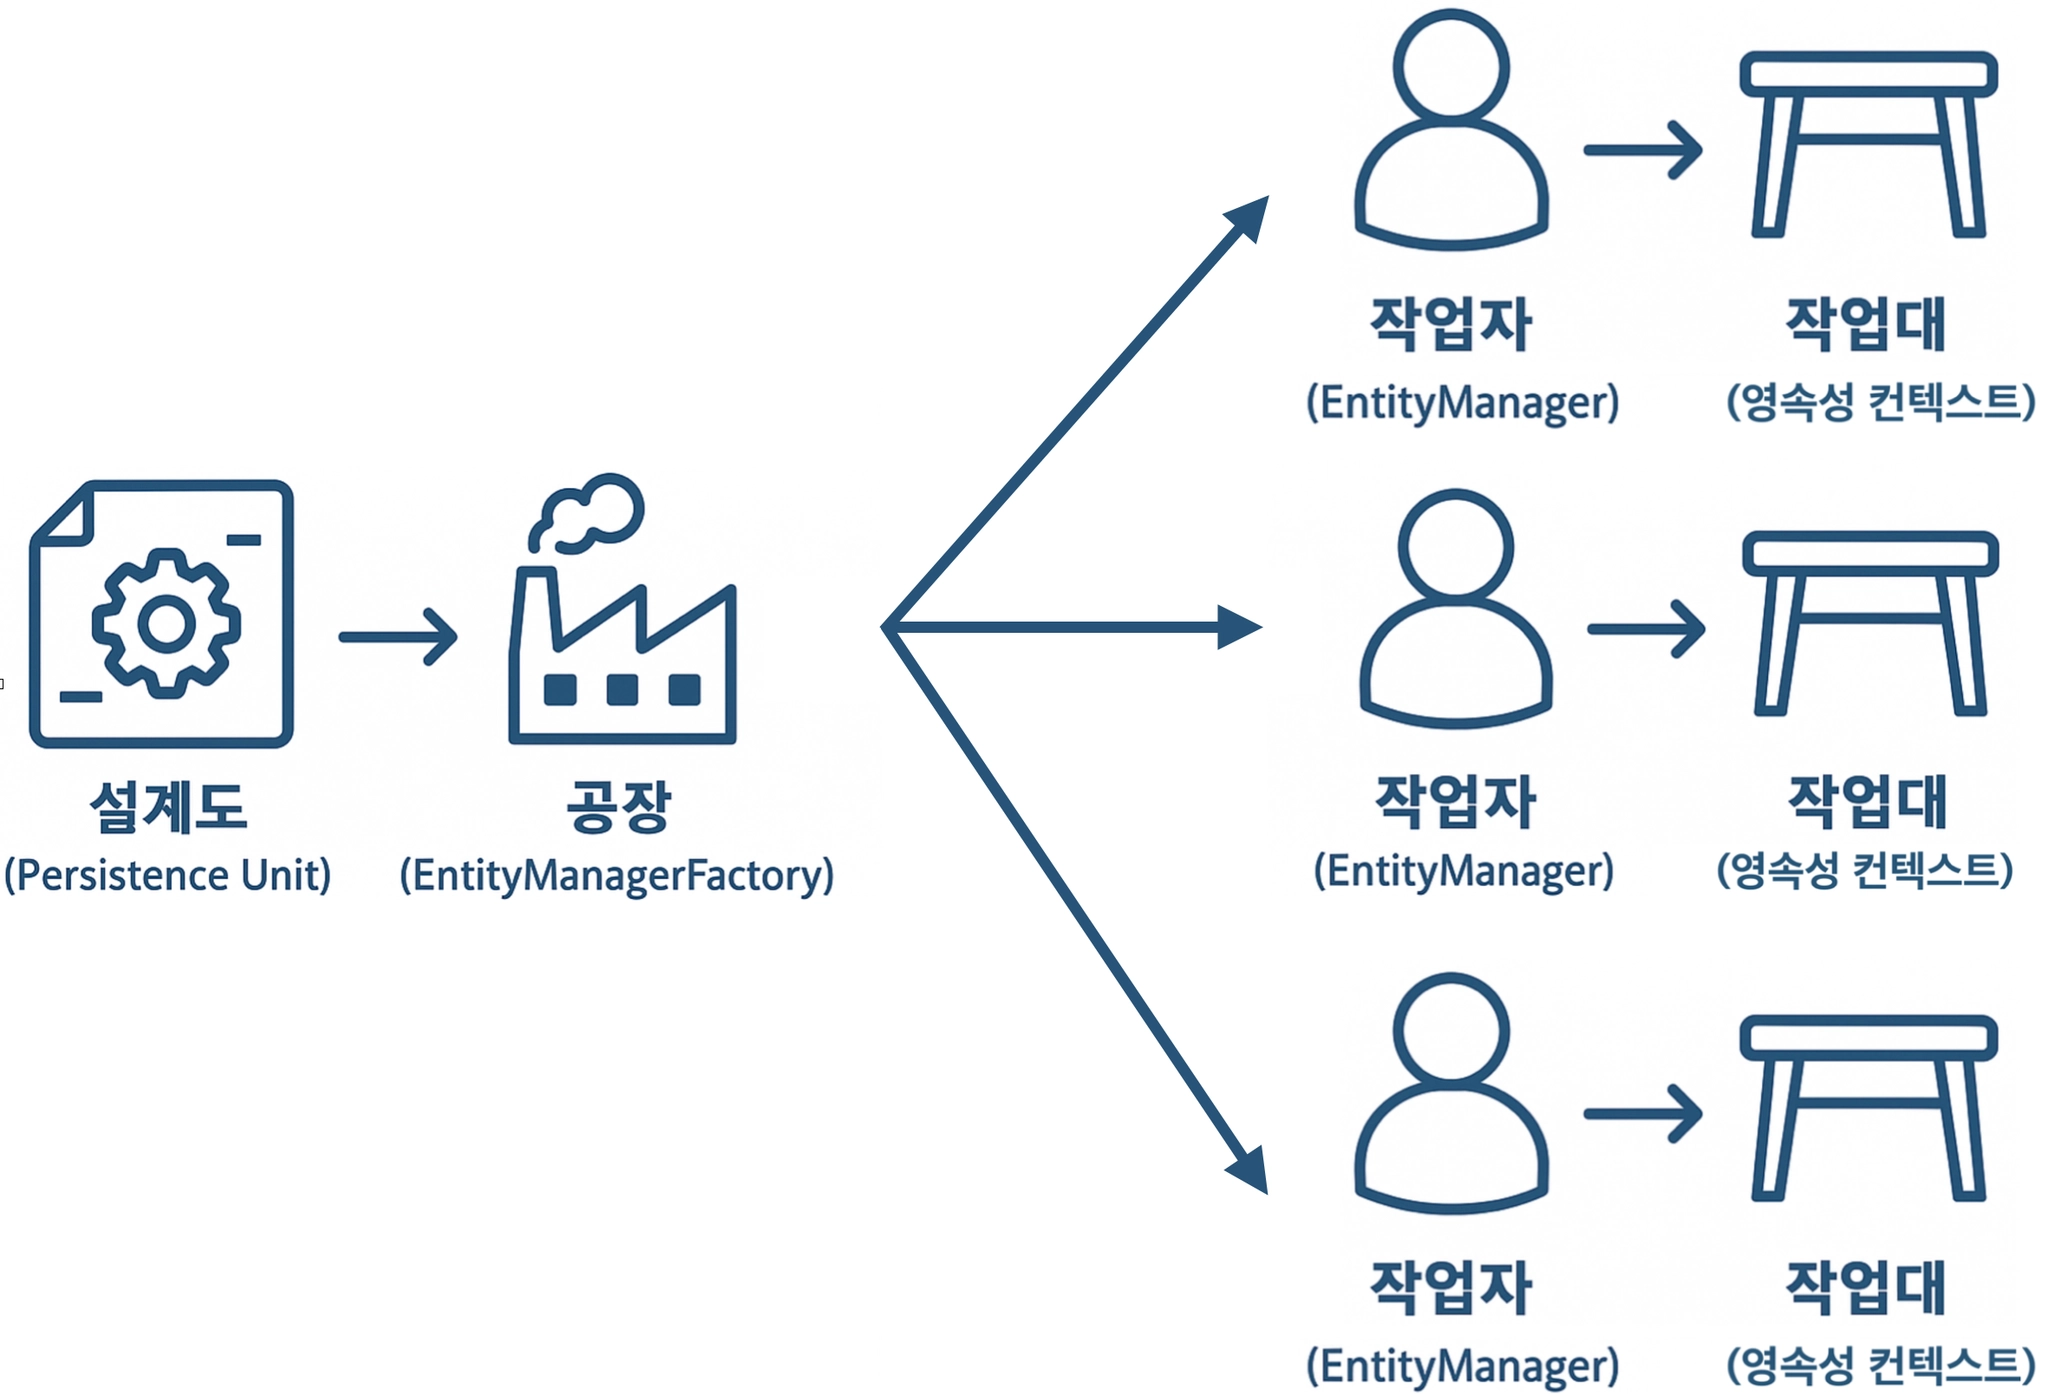
- Persistence Unit
- 설계도
- JPA 설정 정보 단위
- DB 연결 정보, 엔티티 클래스 관리, Hybernate 설정 등을 포함
- EntityManagerFactory
- 공장
- 생성 비용이 비쌈
- 설정 파일 읽고, DB 커넥션 풀을 만드는 등 리소스 사용 큼
- 애플리케이션 전체에 단 하나만 생성되어 공유
- Thread-Safe: 여러 스레드가 동시 접근 가능
- EntityManager
- 작업자
- 엔티티를 저장(
persist), 수정, 삭제(remove), 조회(find) - 내부적으로 DB 커넥션을 사용하여 SQL 실행
- 생명주기
- 트랜잭션과 동일
- 하나의 비즈니스 로직이 시작될 때 생성, 끝날 때 닫힘
- Not Thread-Safe
- 여러 스레드가 동시에 한 EntityManager에 접근하면 안됨.
- 요청마다 개별 EntityManager 사용
- 생성 비용이 저렴함
코드 예시
JpaRepository(Spring Data JPA)
public interface MemberRepository extends JpaRepository<Member, Long> {
}
EntityManager
@Repository
public class MemberRepository {

    @PersistenceContext
    private EntityManager em;

    public Member save(Member member) {
        if (member.getId() == null) {
            em.persist(member);
            return member;
        } else {
            return em.merge(member);
        }
    }

    public Optional<Member> findById(Long id) {
        Member member = em.find(Member.class, id);
        return Optional.ofNullable(member);
    }

    public List<Member> findAll() {
        return em.createQuery("select m from Member m", Member.class)
                .getResultList();
    }

    public boolean existsById(Long id) {
        Long count = em.createQuery(
                "select count(m) from Member m where m.id = :id", Long.class)
                .setParameter("id", id)
                .getSingleResult();
        return count > 0;
    }

    public void deleteById(Long id) {
        Member member = em.find(Member.class, id);
        if (member != null) {
            em.remove(member);
        }
    }
}
Spring Data JPA는 JPA의 핵심인 Entity Manager를 편리하게 사용할 수 있도록 추상화한 것!
트랜잭션 전파
@Transactional어노테이션이 달린 메서드를 실행하고 있는데, 그 메서드 안에서@Transactional어노테이션이 달린 또다른 메서드를 실행하면 어떻게 될까?
propagation 옵션
-
REQUIRED(기본값)- 부모 트랜잭션이 있다면 그 트랜잭션에 참여
- 없다면 새 트랜잭션 생성
- 거의 대부분의 서비스 로직에 사용
-
REQUIRES_NEW- 부모 트랜잭션의 존재 여부와 무관
- 무조건 새 트랜잭션 생성
- 반드시 기록되어야 하는 부가 기능에 사용
- 로그 기록 등에 사용
- 메인 작업이 실패해도, '실패했다'는 로그를 DB에 반드시 남겨야 할 때
- 부모가 롤백되어도 커밋될 수 있음
-
NESTED- 부모 트랜잭션이 있다면, '중첩된 트랜잭션'을 생성
- 없다면 새 트랜잭션 생성
- 부모 트랜잭션에 종속적
- 부모가 롤백되면 자식도 반드시 롤백
- 큰 작업 내에서 실패할 수 있는 부분을 따로 분리하여 예외처리 하는 등
-
SUPPORTS- 부모 트랜잭션이 있다면 참여
- 없다면 트랜잭션 없이 실행
- 읽기 전용 요청에 주로 사용 (트랜잭션으로 엄격히 관리하지 않아도 문제가 생기지 않음)
-
NOT_SUPPORTED- 항상 트랜잭션 없이 실행
- 부모 트랜잭션이 있다면, 해당 트랜잭션을 멈춰두고 트랜잭션이 없는 상태로 로직 수행
- 트랜잭션과 관련없는 특정 로직 수행할 때 사용
- 이 동안 DB 커넥션을 잠시 반납하며 시스템 효율 높일 수 있음
-
MANDATORY- 부모 트랜잭션이 반드시 있어야 함
- 없다면
IllegalTransactionStateException던짐 - 안전장치 개념
-
NEVER- 트랜잭션이 없는 상태에서만 실행 가능
- 부모 트랜잭션이 있다면
IllegalTransactionStateException던짐 - 안전장치 개념
일단 이런 게 있구나 정도로 넘어가자. 실제 쓰이는 것은
REQUIRED가 99.9%이다.
트랜잭션 격리 수준
트랜잭션들이 어느 정도까지 격리되어 실행될 것인가?
일관성과 동시 처리 성능 중 뭐가 더 중요한가?
-
READ UNCOMMITTED
- 각 트랜잭션의 변경 사항이 커밋되거나 롤백되는 것을 신경쓰지 않음
- 정합성에 문제가 많아 위험
- Dirty Read
- 트랜잭션 작업이 완료되지 않았는데, 다른 트랜잭션에서 변경 내용을 볼 수 있다
-
READ COMMITTED
- 커밋된 데이터만 읽음
- 일반적인 RDB 기본 격리 수준
- Non-Repeatable Read
- 한 트랜잭션 내에서 같은 쿼리를 두 번 실행하는데, 그 사이에 다른 트랜잭션이 수정 및 커밋을 완료한 상황이라면 두 쿼리의 결과가 달라진다
- 실제 테이블이 아닌 Undo 영역에서 레코드를 가져옴
-
REPEATABLE READ
- 내 트랜잭션이 생성되기 이전에 커밋된 데이터만 읽음
- MySQL의 기본 격리 수준
- 트랜잭션마다 ID 부여, 나보다 작은 ID의 변경사항만 읽음
- 트랜잭션 도중 하나의 특정 데이터가 바뀌는 문제는 없다
- Phantom Read
- 아예 새로운 레코드를
INSERT하거나 기존 레코드를DELETE함으로써 쿼리의 결과 집합 행 개수가 달라질 수 있다 - 일반적인 조회에서는 방어가 가능하지만, 실제 테이블을 참조해야 하는 상황에서 발생할 수 있다. (
SELECT ... FOR UPDATE: 쓰기 잠금을 걸고 조회,UPDATE시도 등)
- 아예 새로운 레코드를
-
SERIALIZABLE
- 항상 Lock을 걸고 데이터 조회
- 무조건 한 트랜잭션만 값에 관여할 수 있음
- 성능 문제로 널리 쓰이진 않음