오늘은 LG AI Research에서 연구한 ICML '24 Binning as a Pretext Task: Improving Self-Supervised Learning in Tabular Domains 를 정리해보고자 한다. 일을 하다보면 도메인 특성상 tabular 데이터들을 대부분 다루게 되는데 이 논문에서 논하는 바와 같이 tabular 데이터는 대부분 딥러닝보다는 boost계열의 traditional ML 기반 모델들에서 좋은 성능을 보이는 것이 사실이다. 석사 시절 계속 딥러닝만을 다뤄왔다보니 비슷한 고민을 계속해왔는데 이런 tabular 데이터들을 딥러닝 기반 모델에서 잘 작동하게 하려는 시도들은 역시 흥미로울 수 밖에 없는 것 같다!
0. Abstract
- LG AI Research 블로그에서 본 논문에 대해 짧게 요약해놓은 글의 일부를 빌리자면, 해당 논문을 이렇게 소개하고 있다.
간략히 설명하자면, 본 논문에서는 Tabular Learning에서의 딥 네트워크의 한계점을 극복하기 위해 Binning Algorithm을 활용하여 수치형(Numerical) 변수를 범주형(Discrete) 변수로 변환하고, Unsupervised Learning에서 Bin Index에 해당하는 범주형 변수를 예측하는 문제(Pretext Task)를 수행하는 방식으로 Representation을 학습합니다. 학습된 Representation은 데이터 별 Downstream Task에 따라 Linear Evaluation 또는 Fine-tuning을 통해 평가됩니다. Workshop 논문에서는 비교적 단순한 인코더(Encoder)인 MLP와 FT-Transformer 구조만 사용되었던 반면, 본 논문에서는 최근 발표된 Tabular Learning 모델 구조 중 하나인 T2G-Former[2] 가 추가로 활용되었습니다. 또한 본 방식의 성능 개선 효과를 설명할 수 있도록 Discussion에서 시각화를 포함한 다양한 실험 결과를 제안합니다.
[ICML 2024] Tabular Learning 연구 동향 중 발췌
1. Introduction
- DNN이 뛰어난 representation learning 능력을 가진 것은 데이터셋의 본질적 특성을 고려해 적절한 inductive bias를 활용하는 데 달려 있다. 그러나, tabular 데이터의 경우에는 수치형 및 범주형의 heterogeneous한 피처들을 통일된 방식으로 잘 처리하고 구간별 함수(Piecewise function)과 같은 irregular 함수를 파악하는 것이 중요해 XGBoost, CatBoost같은 트리 기반 ML 알고리즘이 꾸준히 강세를 보여왔다. 딥러닝 모델들은 본질적으로 smooth한 함수를 잘 학습하는 구조인 반면에, 트리 기반 모델들은 연속형 수치를 binning하거나, 범주형 피처를 분리된 노드로 잘 나누면서, 실제 데이터가 가지는 piecewise function의 형태, 즉 불연속성과 locality 을 잘 포착하기 때문이다.
- 이러한 tabular 데이터의 heterogenity를 완화하기 위해 기존 연구들은 feature tokenizer나 abstract layer같은 추가 모듈을 활용해왔으나, 큰 성능 개선을 보이지 못했다고 한다.
- 저자는 tree-based 근본적으로 적용될 수 없는 unsupervised learning 형식의 딥러닝 task를 다루기 위해, classical binning 방법을 autoencoding-based self-supervised learning(SSL)에 제안한다.
Binning as a Pretext Task
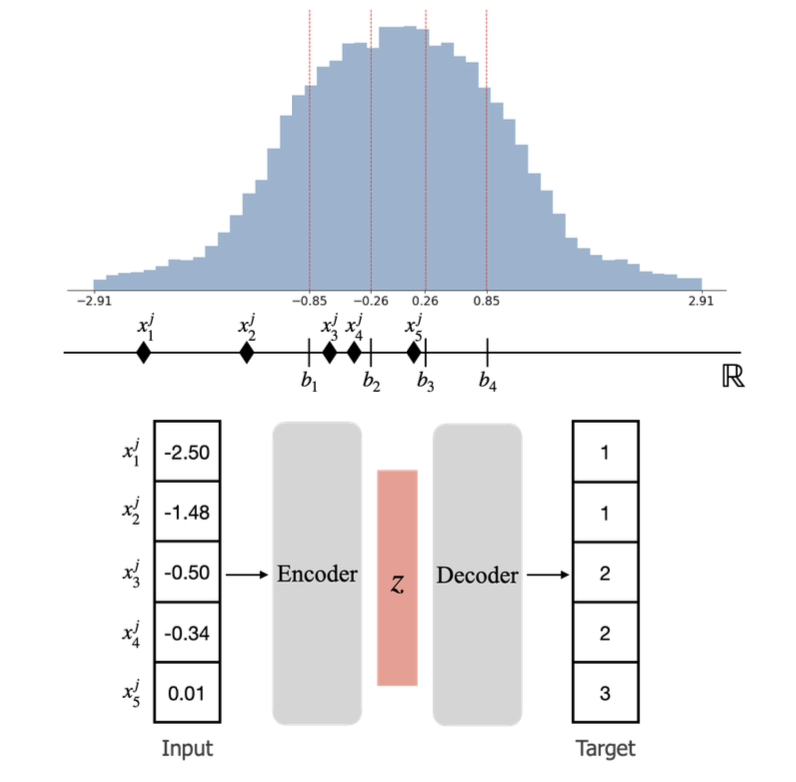
- 제안 방법은 단순한데, raw-values를 복원하는 대신 연속성 수치를 일정한 개수의 구간(bin)으로 나누고, 그 bin index를 복원하도록 학습하는 것이다.
- 예컨대 원래 값이 74.6이면, 전체 분포에서 해당 값이 속하는 bin을 찾아내고, 그 bin index를 예측하는 task를 설정한다. 이건 결국 continuous → discrete mapping을 학습하는 구조가 되는데, 바로 이 점이 중요하다. 왜냐하면 트리 기반 모델들도 결국 이렇게 구간 나눔을 통해 학습을 하기 때문에, 이 방식은 딥러닝에 트리 모델의 inductive bias를 흉내 내는 효과를 줄 수 있기 때문이다.
- 논문에서는 bin index를 순서형 (BinRecon) 으로 다루거나, 클래스형 (BinXent) 으로 다루는 두 가지 방식을 모두 소개한다. BinRecon은 regression-style로 학습하며, 순서 정보까지 고려한다. 반면 BinXent는 단순히 클래스 분류 문제처럼 다룬다. 이 두 가지 방식 모두 raw value를 복원하는 기존 방식(ValueRecon)에 비해 훨씬 더 불연속적인 패턴, 즉 비선형성이나 경계 정보 등을 더 잘 학습한다는 것이 핵심이다. 또 중요한 건, 이 방식은 모든 피처를 공통된 형태의 목표 (categorical target) 로 바꿔버리기 때문에, tabular 데이터가 가진 피처 간 heterogenity 문제도 자연스럽게 해결된다. 결국 모든 피처가 '이 값이 어느 bin에 속하는가?'라는 동일한 pretext task를 공유하게 되는 셈이다.
2. Background
논문에서 제안하는 binning pretext task는 autoencoding 기반의 SSL 구조에서 동작하므로, 입력 데이터를 어떻게 변형하고, 어떤 목적 함수로 학습할 것인지를 서술한다.
Input Transformation
-
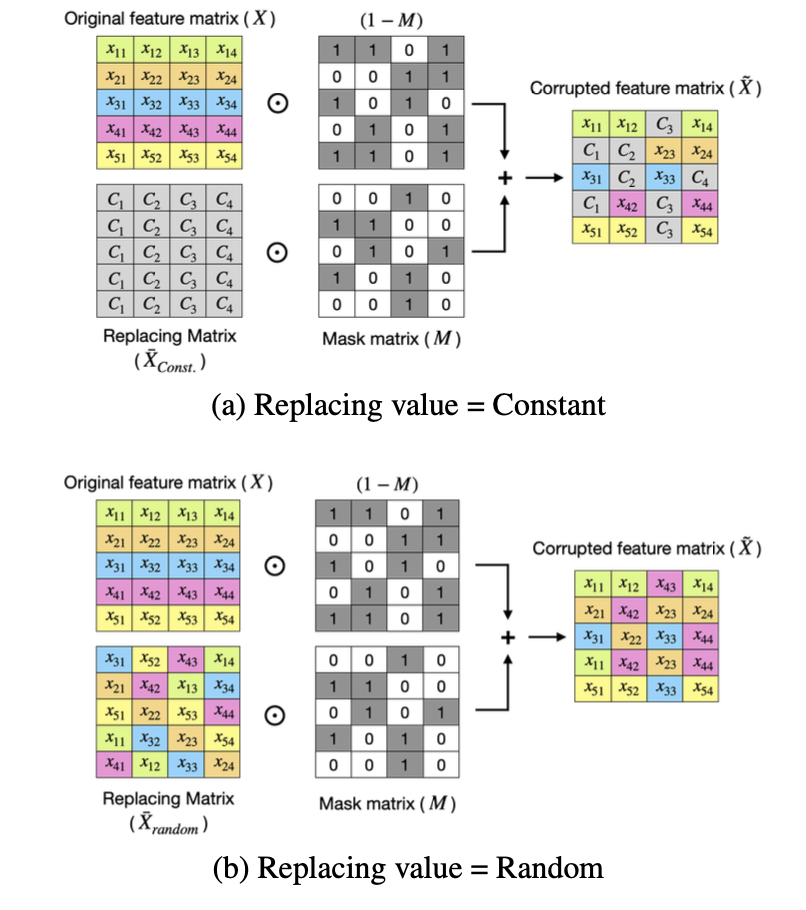
SSL에서 input을 그대로 쓰게 되면 모델이 너무 쉽게 identity mapping만 학습해버려서 의미 있는 representation을 얻지 못한다. 그래서 일부 정보를 가리고(masking), 이를 복원하게 하는 방식이 자주 사용된다. tabular 데이터에서는 특히 중요한데, 각 값들이 다른 피처에 독립적으로 영향을 주기 때문에 조금만 변경해도 전체 의미가 달라질 수 있기 때문이다.
-
이 논문에서는 대표적인 두 가지 masking 전략을 쓴다:
1. Constant Replacement: 마스킹된 값을 각 피처의 평균값으로 교체
e.g. 'age' 피처가 마스킹되면 전체 평균 나이로 대체
→ noise는 적지만 단조로운 입력이 될 수 있음
2. Random In-Batch Replacement: 같은 배치 내 다른 샘플에서 값을 가져와 교체
e.g. 샘플 A의 'income'을 샘플 B의 값으로 교체
→ 데이터 다양성이 생기고, 더 어려운 복원 문제를 유도 -
실제로 입력은 마스킹 벡터 m_i를 이용해 무작위로 일부 피처만 가리고, 나머지는 유지한 채 학습이 진행된다. 이런 방식은 CNN이나 Transformer처럼 순서를 고려하지 않는 MLP 기반 모델에서도 잘 작동한다.
SSL Objectives
-
변형된 입력을 넣고 나서, decoder가 학습할 목표는 여러 가지가 있다. 이 논문에서는 기존 방식인 두 가지 objective와, 새로운 방식인 binning 기반 두 가지 objective를 모두 비교한다.
-
기존 방식은 다음과 같다:
1. Value Reconstruction (ValueRecon): 마스킹된 값을 정확한 원래 값으로 복원하도록 학습
- L2 loss (평균제곱오차)를 사용
- 문제는 연속적인 부드러운 값을 학습하려는 경향이 생김 → irregular pattern에 취약
2. Mask Detection (MaskXent): 어떤 피처가 마스킹됐는지를 맞추는 binary classification
- cross-entropy loss 사용
- 이상치나 이상한 패턴을 포착하는 데는 유리하지만, 의미 있는 표현을 만드는 데는 한계가 있음 -
저자는 여기에 새로운 pretext task 두 가지를 제안한다:
3. Bin Reconstruction (BinRecon): 원래 값이 속한 bin index (순서형) 을 예측
- 연속적인 값을 복원하지 않고, 구간에 해당하는 정수 인덱스만 맞춘다
- L2 loss 사용 → 순서 정보 반영
4. Bin Classification (BinXent): bin index를 범주형 class로 간주하여 one-hot classification
- cross-entropy loss 사용 → 순서는 무시되지만 확실한 경계 학습 가능 -
이 두 가지 binning 기반 objective는 기존의 smooth한 값 복원 방식과 다르게, 불연속적 경계(boundary information) 를 중심으로 representation을 학습하게 한다는 점에서 큰 차이가 있다.
3. Method
이 논문의 핵심 아이디어는 tabular 데이터를 self-supervised 방식으로 학습할 때, 기존의 값 복원 방식 대신 binning된 정보를 예측하는 pretext task를 적용하자는 것이다. 앞에서 설명했듯이 기존의 value reconstruction이나 mask detection 방식은 연속적인 회귀값을 학습하거나 이진적인 마스킹 여부만 예측하기 때문에, 복잡한 경계 구조나 비선형적인 피처 변화를 충분히 학습하기 어렵다는 한계가 있었다. 이에 따라 저자들은 binning이라는 수단을 통해 “경계 정보(boundary information)”를 학습하는 inductive bias를 주자는 전략을 취한다. 구체적으로는, 각 피처의 값을 미리 정의된 구간들로 나눈 후 그 bin index를 예측하는 task를 통해, 모델이 해당 피처 값이 어떤 구간에 위치했는지를 예측하도록 설계한 것이다.
논문에서는 이 binning 기반 task를 구현하기 위해 3가지 세부 구성 요소를 정의한다:
(1) binning scheme, (2) bin prediction objectives, (3) decoder design
3.1 Binning Scheme
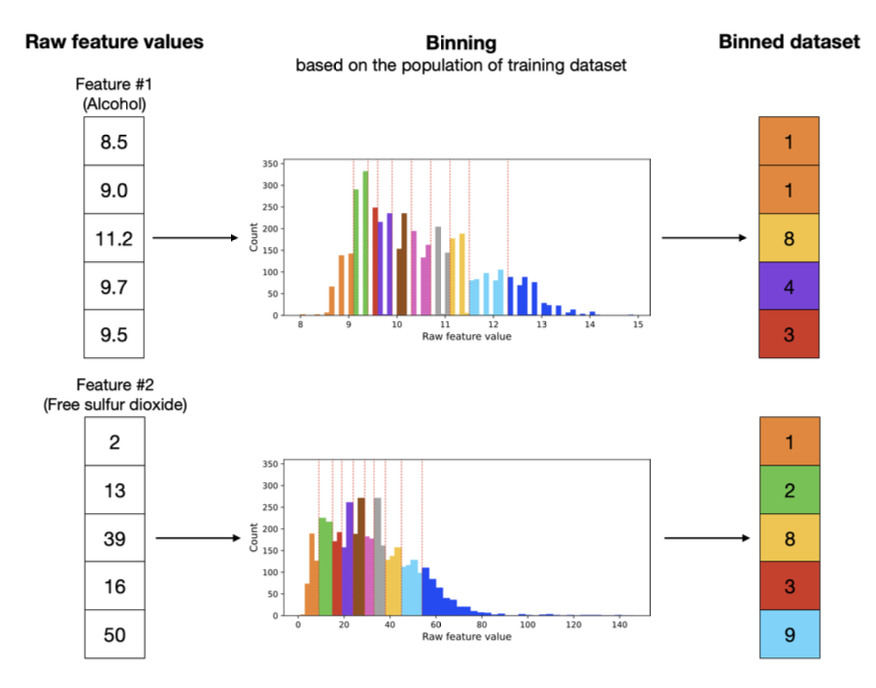
- Equal Width Binning: 피처의 최소값과 최대값을 기준으로 같은 폭(width)으로 구간을 나눈다.
e.g. [0, 20), [20, 40), ..., [80, 100] - Quantile Binning: 데이터를 빈도 기반으로 나누어 각 구간에 데이터가 균등하게 들어가도록 bin을 설정한다.
- 특히 tabular 데이터는 분포가 비대칭인 경우가 많기 때문에, 이 방식이 더 안정적인 표현을 얻는 데 유리하다.
- 모든 연속형 피처는 위 방식 중 하나로 정해진 개수의 bin으로 변환되고, 모델은 결국 그 bin index를 예측하는 형태로 학습된다. 이 bin index는 연속적인 값이 아니라 불연속적인 순서형 정보로 간주되며, 이로 인해 모델은 연속값보다 경계에 민감하게 반응하게 된다.
3.2 SSL Objectives with Binning
앞에서 Background에서 설명한 네 가지 self-supervised objective 중 이 논문에서 가장 주목하는 것은 바로 BinRecon과 BinXent이다.
BinRecon: bin index를 숫자값(0, 1, 2, …) 으로 예측하는 회귀적 접근 (L2 loss)
BinXent: bin index를 범주형 class로 다루는 분류 접근 (Cross-entropy loss)
- 저자들은 특히 bin을 클래스처럼 다루면 모델이 경계 기반의 명확한 의사결정을 학습할 수 있기 때문에 BinXent를 주요한 objective로 사용한다. 예를 들어, income이 49.9면 bin 2, 50.1이면 bin 3이라면 이 경계를 확실하게 인식해야 하는 상황에서, 회귀보다는 분류 방식이 더 명확한 구분을 유도할 수 있다. 결국 binning을 통해 모델이 feature의 분포를 단순히 기억하는 것이 아니라, 변곡점(threshold)이나 boundary에 민감하게 반응하는 representation을 학습하게 된다.
- 또한, 이 방식은 일반적인 regression과 달리 label smoothing이나 순서에 대한 명시적 정보 없이도 의미 있는 표현을 만들어낸다. 이게 바로 tabular 데이터에서 딥러닝 모델이 기존 tree 기반 모델에 비해 약했던 부분을 보완하는 지점이다.
3.3 Decoder Design
-
논문에서는 decoder를 간단한 MLP로 구현하며, 각 마스킹된 피처별로 해당 bin index를 예측하게 구성되어 있다. decoder는 다중 피처를 동시에 예측해야 하기 때문에 output 구조는 다음과 같다:
- 전체 입력 피처 수: d
- 각 피처의 bin 개수: B (피처마다 다를 수 있음)
- 출력 차원: d × B → 피처별 bin class 확률 분포 -
각 피처별로 예측된 bin 분포는 cross-entropy loss를 기준으로 학습된다. 즉, 모델은 각 피처마다 이 값은 어느 bin에 속했는가?를 확률 분포로 예측하고, 정답 bin에 가장 높은 확률을 주도록 최적화된다.
4. Experiments
4.1 Experimental Setup
- 전체 실험은 대표적인 tabular benchmark인 UCI suite, OpenML datasets, SAPS에서 진행되었다. 특히 OpenML은 45개의 classification 태스크로 구성되어 있고, SAPS는 structured electronic health record 데이터로, 고차원 sparse한 real-world 데이터를 포함하고 있다는 점에서 일반화를 테스트하기에 적합한 환경이었다.
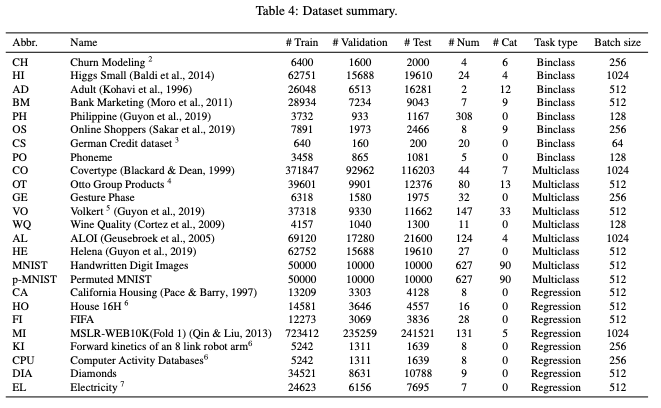
실험은 다음과 같은 두 설정으로 나뉜다:
- Linear Evaluation: pretraining된 encoder를 freeze하고, linear classifier만 학습
- Fine-tuning: encoder와 classifier를 모두 학습 (end-to-end)
또한 baseline 모델로는 다음을 비교 대상으로 삼았다:
- Supervised (fully-labeled)
- Self-supervised baselines: VIME, SCARF, DAE, TabNet MAE 등
- Transformer 기반: FT-Transformer
4.2 Binning Objective Analysis

- 먼저 저자들은 binning-based objective가 실제로 도움이 되는지를 살펴보기 위해 다양한 objective 간의 성능을 비교했다. 결과적으로는 BinXent objective가 다른 방식들, 예를 들어 MAE (masked autoencoding)나 BinRecon 방식에 비해 전반적으로 가장 높은 성능을 보였다.
- 특히, BinXent 방식은 fine-tuning 성능뿐 아니라 linear evaluation 성능에서도 뛰어난 결과를 기록한 반면, 기존 MAE 방식은 linear probing에서는 다소 부진했고, fine-tuning에서도 성능 편차가 컸다.
- 이는 결국 boundary information를 정확하게 인식하는 능력이 downstream task에 큰 영향을 미친다는 걸 보여주는 간접적인 증거라고 할 수 있다.
4.3 Benchmarks Results: OpenML, UCI, SAPS
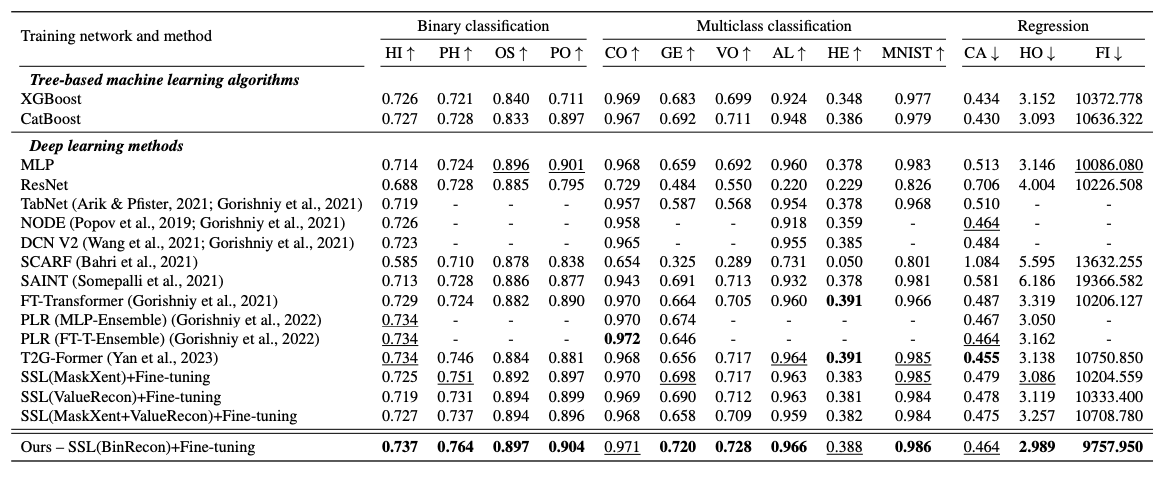
OpenML
- 45개 classification task로 구성된 OpenML에서, binning pretraining은 supervised-only 방식과 거의 대등하거나 그 이상의 성능을 보였다. 특히 BinXent objective로 사전학습한 모델은 FT-Transformer에 비해 약 1.3%p 높은 평균 accuracy를 기록했다.
- 이는 OpenML은 다양한 데이터 스케일, feature type, imbalance level을 포함하고 있는데, supervised 방식은 full label을 쓰는 반면, SSL은 label 없이 학습되었다는 점에서 인상적인 결과라고 할 수 있다. 즉, label 없이도 더 나은 representation을 만들 수 있다는 걸 입증한 셈이다.
UCI Benchmarks
- UCI 데이터셋은 tabular ML에서 가장 자주 쓰이는 벤치마크 중 하나다. 여기서도 binning 기반 pretraining은 기존 DAE (denoising autoencoder), VIME, SCARF 같은 SSL 방식들보다 지속적으로 높은 accuracy를 보였다. 특히 supervised baseline과의 격차를 줄였다는 점에서 binning objective의 generalizability를 다시 한번 확인할 수 있다.
SAPS (Electronic Health Record)
- 가장 challenging한 환경인 SAPS 실험에서는 더욱 인상적인 결과가 나왔다. 이 환경은 고차원 sparse feature와 real-world EHR 데이터 특성상 일반적인 pretraining이 어려운 환경인데도 불구하고, binning pretraining은 supervised baseline 대비 3.8%p 높은 AUROC를 기록했다.
- 이는 특히 linear evaluation setting에서도 관찰되어, encoder가 단순한 linear classifier만으로도 성능을 높일 만큼 유의미한 표현을 학습했다는 걸 보여준다.
5. Discussion: Ablation Study & Robustness
-
저자들은 binning의 경계 개수(B)를 바꾸거나, binning 방법 (equal-width vs quantile)을 바꿨을 때 성능이 어떻게 변화하는지도 분석했다.
- 일반적으로 bin 개수가 너무 작으면 정보가 부족해지고,
- 반대로 너무 많으면 overfitting되기 쉬웠다.
- 대체로 B=10~20 수준에서 가장 안정적인 성능을 기록했다.
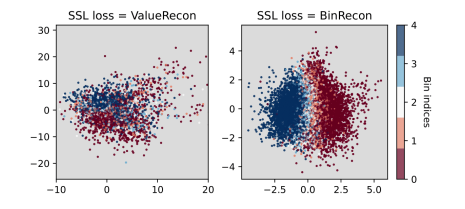
-
representation 품질을 PCA로 시각화했을 때도, binning-based encoder는 label 없이도 클래스 간 구조가 자연스럽게 분리된 표현 공간을 형성하고 있었다. 이는 단순한 회귀적 pretext task보다 정보적으로 훨씬 더 구조적인 표현을 만들고 있음을 보여주고 있다.
References
원문은 여기에! Binning as a Pretext Task: Improving Self-Supervised Learning in Tabular Domains