석사 졸업 논문을 ECG 데이터로 쓰면서 Time Series Classification을 하기도 했고 요즘 업무에서도 Time Series를 계속 보다보니 오늘은 시계열 데이터의 개념 및 특성을 정리하고 머신러닝 기반의 시계열 예측 모델들에 대해서 중점적으로 다뤄보고자 한다!📈🔎 였는데 시계열 데이터의 개념 및 특성 정리가 엄청 길어진 관계로 끊어가는 것으로 하겠다...😇
Time Series란?
-
시계열 데이터란, 시간의 순서에 따라 나열된 데이터로, 주가, 날씨, 수요량, 교통량, 센서 데이터등과 같이 시간의 흐름에 따라 변화하는 데이터를 말한다.
-
일반적인 데이터와 달리 시계열 데이터는 시간의 흐름에 따른 패턴이 존재하며, 과거 데이터가 미래에 영향을 미친다는 점에서 예측 분석에서 매우 중요한 역할을 수행한다. 이런 특성 때문에 시계열 데이터는 Trend(추세 변동), Cycle (순환, 주기 변동), Seasonal variation(계절 변동), Random fluctuation(우연 변동)과 같은 주요 구성요소를 가진다.
시계열 데이터의 주요 구성요소
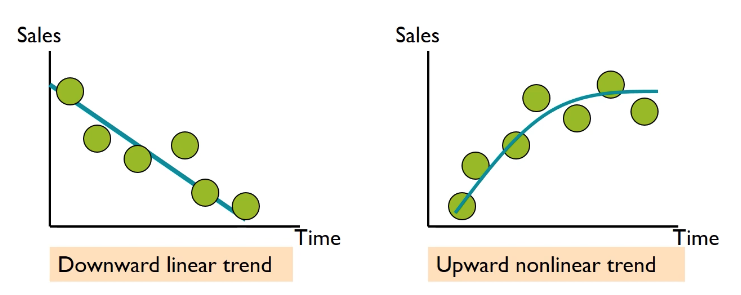
- Trend(추세 변동): 시간이 경과함에 따라 관측값이 지속적으로 증가하거나 감소하는 추세를 가지는 경우의 변동. 일정한 방향성을 보이며, 계절적 영향과 무관하게 주로 사회, 경제적 변화 등 구조적인 요인과 관련된다. 경제와 관련된 데이터에서 자주 발생한다.
e.g. 인구 증가에 따른 도시 교통량 증가, 기술 발전에 따른 스마트폰 보급률 상승
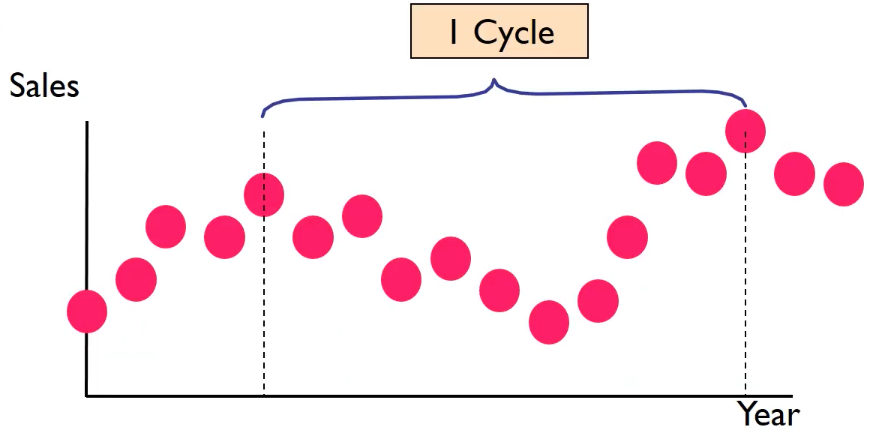
- Cycle (순환, 주기 변동): 주기적인 변화를 가지나 특정 계절에 의한 것이 아니고 주기가 긴 경우의 변동. 일정한 주기를 두고 반복되지만, 그 주기가 고정되지 않은 장기적인 변동 패턴을 말한다. 반복 주기는 수 년에서 수십 년까지 다양하며, 정기적이지 않을 수도 있음.
e.g. 경제 침체 및 회복 사이클, 부동산 가격의 상승과 하락 사이클
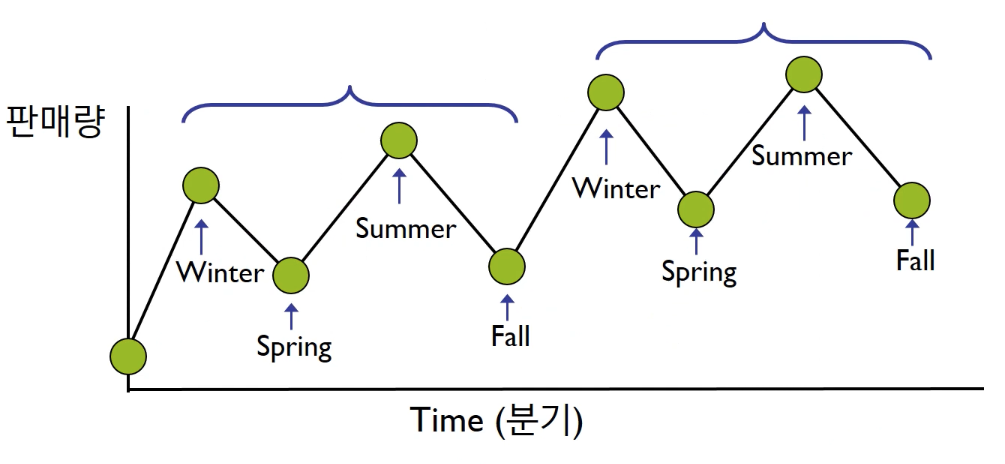
- Seasonal variation(계절 변동): 일정한 시간 간격(주기)으로 반복되는 패턴으로, 주, 월, 계절에 따라 발생하는 규칙적인 변화를 말한다.
e.g. 주말과 평일 간의 소비 패턴 차이, 연말 쇼핑 시즌 트래픽 증가
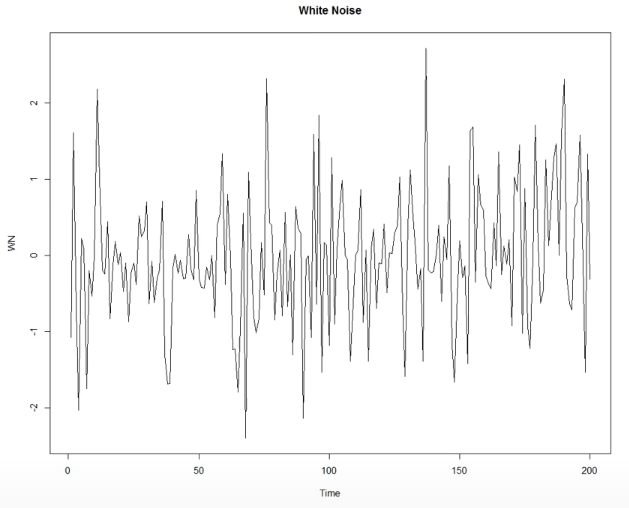
- Random fluctuation(우연 변동): 시간에 따른 규칙적인 움직임과는 무관하게 발생하는 불규칙하고 예측 불가능한 노이즈 요소를 말한다.
e.g. 갑작스러운 자연재해로 인한 매출 급감, 예기치 못한 서버 다운으로 인한 트래픽 변화
- White Noise(백색 잡음): Random fluctuation 중 제일 대표적인 예시. 시계열에서 완전히 예측 불가능하고, 특정한 패턴이 없는 순수한 랜덤 신호를 말한다. 평균이 0이고, 분산이 일정한 시계열 데이터 (모든 시점 간 Auto-correlation이 없음)
e.g. 동전을 던져서 계속 앞, 뒤를 시간 순서대로 기록한 경우
- White Noise 왜 중요한가?
1. 모델의 잔차가 white noise인지 확인: 예측 모델을 만들고 나서 잔차(= 실제값 - 예측값)이 백색 잡음이라면 예측 불가능한 부분만 남겨놨다는 뜻으로 좋은 모델(=최적화된 모델)임.
2. 시계열 데이터 자체가 백색잡음일 경우, 예측 불가능하므로 모델을 만들 필요가 없음.
Decomposition: Additive Model vs Multiplicative Model
앞서 정리한 시계열 데이터의 구성요소를 어떻게 결합하여 해석할 것인지에 따라 시계열 모델은 크게 두가지 형태로 구분된다.
-
Additive Model (가법 모형):
-
Multiplicative Model (승법 모형):
-
: 시계열의 실제 값, : 추세, :순환 변동, : 계절 변동, : 불규칙 성분 Irregular
-
가법 모형은 각 구성요소가 서로 독립적이고, 선형적으로 합쳐지는 경우에 사용하며 승법 모형은 이들이 비율 관계로 곱해지는 구조라고 볼 수 있다.
-
그러나 현실에서는 변동성의 크기가 추세에 따라 달라지는 등 완전한 독립성을 가정하기가 힘들기 때문에, 보통 승법 모델을 활용하며 여기에 로그를 취하여 선형 관계를 가진 가법 모형처럼 활용한다.
Auto-Correlation (자기상관)
- Auto-Correlation (자기상관)이란, 시계열 데이터의 과거 값과 현재 값 간의 상관관계를 의미한다.
- : 시차 k에 대한 자기상관 계수, : 현재 시점의 값, : 과거 시점의 값, : 분산
- 자기상관은 과거 값이 현재 값에 얼마나 영향을 주는지를 보여주기 때문에, 시계열의 예측 가능성을 판단하는 기준이 된다. 일정한 시차(lag)에서 상관이 높다는 것은 그 시차 정보를 활용해 미래를 예측할 수 있다는 뜻이다. 잘 알려진 ARIMA, SARIMA, GARCH 등이 자기상관 구조를 모델링하는 방식이다.
- 이러한 자기상관은 ACF (Auto-Correlation Function), PACF (Partial ACF)를 통해 시각화할 수 있는데, ACF가 다양한 시차에 대해 자기상관 계수를 시각화한 그래프라면, PACF는 특정 시차에 대해 중간 시차들의 영향을 제외하고 순수한 자기상관을 계산하여 시각화한다고 할 수 있다. ()
- 데이터가 정상성을 만족한다고 가정했을 때, ACF, PACF의 형태에 따라 AR, MA, ARIMA 중 어떤 모델을 활용하면 적절할지를 추정하는 방법 중 하나로 쓰인다.
| Model | ACF | PACF |
|---|---|---|
| MA(q) | Cut off after lag q | Die out |
| (q 시차 이후 0으로 절단) | (지수적으로 감소, 소멸하는 sine 함수 형태) | |
| AR(p) | Die out | Cut off after lag p |
| (지수적으로 감소, 소멸하는 sine 함수 형태) | (p 시차 이후 0으로 절단) | |
| ARMA(p, q) | Die out | Die out |
| (시차 q-p 이후부터 소멸) | (시차 q-p 이후부터 소멸) |
Stationarity (정상성)
- 데이터가 정상성을 띈다는 것은 시간의 흐름에 따라 데이터의 통계적 특성이 일정하게 유지되는 것을 말한다. 즉, 다음과 같은 세 가지 조건을 만족해야 한다.
1. 특정한 트렌드가 없어야 한다. (일정하게 줄어들거나 늘어나지 않는다.)- 평균 (Mean), 분산 (Variance)이 시간에 따라 변하지 않는다. (시간과 무관하게 분포가 같다.)
- 자기상관이 일정하다.
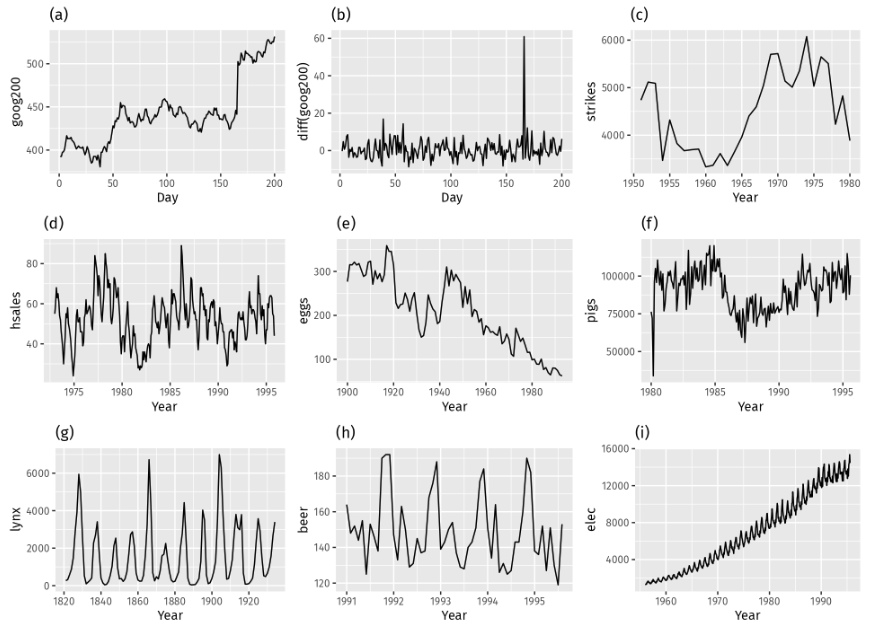
이 중 정상성을 띄는 데이터를 고르면, d, h, i는 계절성이 보이기에 제외하고, a, c, e, f, i는 추세와 변화폭이 보이기 때문에 제외해야 한다. 또 i는 분산이 증가하는 것 역시 보인다. 이런 식으로 소거해나가다보면 결국 정상성을 띄는 데이터는 b, g만 남게 되는 것이다.
그렇다면 이런 정상성은 왜 중요할까?
- 일단, 비정상 시계열은 시간에 따라 데이터 분포가 바뀌므로, 미래 값이 과거와 다른 규칙을 따를 수 있어 과거 데이터를 학습해도 미래 예측 성능이 낮아지게 된다.
- AR, MA, ARIMA와 같은 모델들은 선형 회귀 기반의 구조로, 회귀 계수들은 고정된 평균과 분산을 갖는 데이터를 전제로 해야 안정적으로 추정된다. 비정상 시계열에서는 회귀 계수 자체가 시간에 따라 변할 수 있어 모델이 불안정하게 작동하게 된다.
- 자기상관 해석이 왜곡된다. 앞서 설명한 ACF, PACF는 데이터가 정상성을 띌 때 의미 있는 결과를 준다. 정상 시계열에서는 시차가 커질수록 자기상관이 점점 0에 가까워지는 반면, 비정상 시계열에서는 시차가 커져도 천천히 감소하거나 거의 유지되는 것처럼 보여 마치 과거 값이 계속 현재값에 영향을 주는 것처럼 보이게 된다.
비정상 시계열의 정상화
| 방법 | 목적 | 적용 상황 | 참고 |
|---|---|---|---|
| 차분 | 추세 제거 | 우상향/우하향 데이터 | 1차로 안 되면 2차 차분 시도 |
| 로그 변환 | 분산 안정화 | 진폭이 점점 커지는 시계열 | 0 이하 값에서는 사용 불가 |
| 계절 차분 | 계절성 제거 | 월별, 주간 등 주기 반복 패턴 | 주기(lag)를 정확히 설정해야 함 |
| ADF Test | 정상성 검정 | 전처리 후 데이터 평가 | p-value < 0.05면 정상성 있다고 판단 |
위 표에 명시된 방법으로 시계열을 정상화할 수 있고, 보통
데이터를 시각화 -> 추세 및 계절성을 확인 -> 필요에 따라 로그 변환 / 차분 / 계절 차분 수행 -> ADF Test로 정상성 확인
의 순서로 진행하게 된다.
- 차분 (Differencing): 시계열 데이터에서 바로 이전 시점의 값을 빼서 변화량만 보는 방식. 추세를 제거하여 평균을 일정하게 만든다. ()
- 로그 변환 (Log Transform): 데이터에 로그를 취해 값의 범위를 축소. 변동성(분산)이 클 때 안정화시키는 데 효과적이다. ()
- 계절 차분 (Seasonal Differencing): 이전 해 혹은 이전 시즌의 값과 비교하여 차분. (, 는 계절 주기로 월별 데이터일 경우 12가 된다.)
- ADF (Augmented Dickey-Fuller Test): 시계열이 단위근 (Unit Root)를 가지는지 검사하여 정상성 여부를 판단하는 통계적 시험. 이때 귀무가설()은 이 시계열은 비정상이다 (단위근 존재) 이며 대립가설()은 이 시계열은 정상이다 (단위근 없음)이다.
Evaluation Metrics
| 지표명 | 설명 | 특징 |
|---|---|---|
| MAE (Mean Absolute Error) | 오차 절댓값의 평균 | 직관적이며 이상치에 덜 민감 |
| MSE (Mean Squared Error) | 오차 제곲의 평균 | 큰 오차에 더 큰 패널티 부여 |
| RMSE (Root Mean Squared Error) | MSE의 제곱근 | 실제 단위와 동일, 해석 용이 |
| MAPE (Mean Absolute Percentage Error) | 오차를 실제값 기준으로 백분율로 환산 | 직관적이나, 실제값이 0에 가까울 때 문제 발생 |
- 시계열 예측 성능을 평가할 때는 일반적으로
K-fold대신TimeSeriesSplit(Sickit-learn)을 사용한다.
References
Time Series Forecasting 101: A Beginner’s Guide
고려대 산업경영공학부 김성범 교수님 유튜브
https://otexts.com/fpp2/stationarity.html