벨로그를 시작하게 된 이유라고 봐도 무방한 LLM을 첫번째 주제로 정해보았다!
챗 지피티의 등장 이후 LLM-based AI Chatbots가 매우 핫해진 것은 물론 이제는 그 종류를 다 알기도 힘든 새로운 챗봇들이 시장에 쏟아지는데 하나하나 따라가기가 힘들어서 한번은 정리해야지 늘 생각했었는데 벨로그를 핑계로 처음 실행에 옮겨본다.
감사하게도 좋은 Survey 논문들이 많아서 열심히 참고해보았으나 그래도 부족할 수 있다는 점🥹
ChatGPT가 만들어준 썸네일... 약간 소름끼친다
1. Pre-LLM Chatbots
-
1950년대 튜링 테스트 Can Machines think? 로 챗봇 연구가 시작되었으나, 초기 챗봇은 제한적인 맥락 이해 능력과 특정 분야에 국한된 지식으로 부정확한 응답을 제공하는 경우가 많았다.
-
대표적인 초기 예시로는
- 1966년 ELIZA: MIT에서 개발된 심리 상담 챗봇
키워드 매칭을 사용해 사용자의 문장을 분석하고 단순한 응답을 생성하는 방식을 사용했으나, 실제 의미는 이해하지 못했다고 한다.
- 1972년 PARRY: 편집증 환자의 언어 패턴을 모방한 챗봇
ELIZA보다는 좀 더 정교한 구조와 감정이 섞인 답변을 보였다고 한다.
-
그리고 1980년대부터 2000년대 초반까지 Ractor, Jabberwacky, Dr. Sbaitso, A.L.I.C.E (Alicebot), SmarterChild, Cleverbot 등 다양한 챗봇이 등장하였는데, 이들은 간단한 Rule-based 혹은 키워드 매칭 방식을 사용하여 극초기 모델들 보다는 발전한 성능을 보였다고 한다.
- A.L.I.C.E: AIML이라는 언어를 사용하여 지식 기반을 확장하고 대화 가이드라인을 설정
- Cleverbot: 미리 프로그래밍된 응답 대신 인간의 입력으로부터 학습하는 전략을 활용
그럼에도 불구하고, 이 시기의 챗봇들은 여전히 인간과 같은 자연스러운 대화 능력이 부족해 사용자 경험이 단절되는 경우가 많았다고 한다.
-
2010년대부터 주목해볼만한 발전은 답변의 퀄리티 역시 큰 진보를 이뤄냈지만 무엇보다, messaging apps들을 비롯한 다양한 플랫폼에 search agents로서 결합되거나 voice를 활용하여 우리의 일상적인 테스크에 챗봇이 깊이 관여하게 되었다는 점이다.
- e.g. Apple의 Siri, Amazon의 Alexa, Google의 Google Assistant등
그러나 현재와 비교했을 때는 비교적 제한된 문맥 이해력(Long-term Context)과 유연한 응답 생성 능력이 부족했다.
2. LLM의 등장과 LLM-based Chatbots의 발전
-
2020년부터 LLM이 등장하면서 챗봇 분야가 혁신을 이뤄냈는데, 이 때부터 우리가 아는 인간과 같은 미묘한 뉘앙스를 이해하는 응답들이 등장하기 시작한다. 방대한 양의 텍스트 데이터로 사전 학습된 LLM은 챗봇이 더욱 상세하고 'human-like'한 답변들을 제공할 수 있도록 하였다.
-
특히, 2022년 11월, OpenAI의 ChatGPT 3.5 출시 이후 LLM 기반 챗봇에 대한 관심이 폭발적으로 증가했다.
이때쯤 나도 석사과정 중 처음으로 GPT를 써보고 감탄과 경악을 금치 못했던 기억이 있다. 그리고 2년여가 지난 지금 GPT는 결국 내 코딩 버디로 자리 잡아버렸다. -
이 중에서도 가장 유명한 GPT, BERT, PaLM, LLaMA에 대해 좀 더 자세히 살펴보고자 한다.
Token
- 언어 모델이 텍스트를 처리하는 기본적인 단위라고 볼 수 있다. 일반적으로 Word, Subword, 문장 부호 등이 하나의 토큰이 될 수 있다. Large Language Models의 경우, "Large", "Language", "Models"라는 세 개의 토큰으로 나뉠 수도 있고, "Language"가 "lang", "uage"로 더 작게 나뉠 수도 있는 것이다.
- 긴 텍스트를 작은 단위로 나누기 때문에 처리 효율성이 증가하고, 각 토큰에 대한 Word Embedding을 학습하여 단어의 의미와 컨텍스트상의 관계를 잘 파악할 수 있게 된다. (비슷한 단어들은 Vector Space 상에서 가까운 위치에 클러스터링 되기 때문에)
Context Window
- 모델이 한번에 처리할 수 있는 토큰의 최대 개수를 의미한다. 여기서 모델이 특정 시점에서 얼마나 많은 이전 정보를 기억하고 활용할지가 결정된다. 즉, 컨텍스트 윈도우의 크기 = 모델의 Input 및 Output 텍스트의 길이 이다.
- 큰 컨텍스트 윈도우를 가진 모델은 장기적인 의존성을 파악하고 유지하는 데 유리하고, 넓은 컨텍스트를 이해할 수 있게 되어 긴 문서를 요약한다거나 여러 단계를 거치는 추론과 같은 더 많은 정보를 고려해야하는 작업에서 더 양질의 답변을 생성해내게 된다.
이 두 요소가 모델의 기억력과 이해 범위, 처리할 수 있는 텍스트 길이를 결정하는 중요한 요소인 것이다.
GPT (Generative Pre-trained Transformer) 시리즈
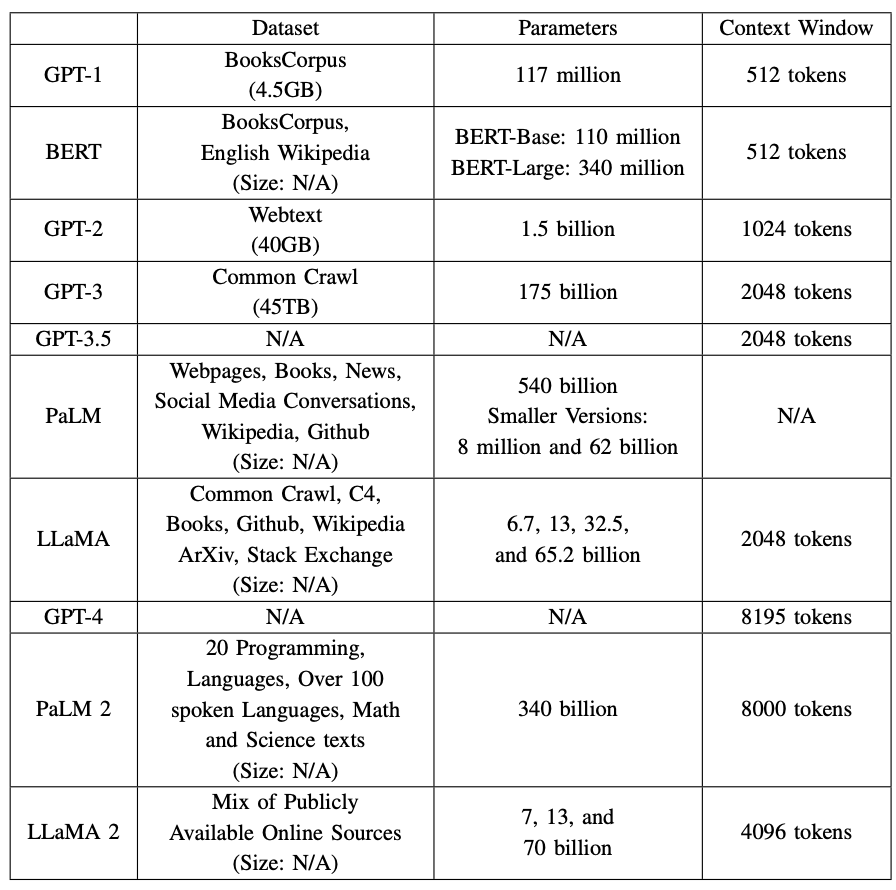
- 2018년 OpenAI에서 발표한 최초의 주목할 만한 LLM으로, Generative Pre-training 방식을 통해 언어 이해 능력을 대폭 향상시켰다. GPT-1의 경우, BooksCorpus (4.5GB) 데이터셋으로 트레인됐고, 1억 1,700만개의 파라미터와 512 토큰의 컨텍스트 윈도우를 가진다.
- 이후 GPT-2가 후속 모델로 2019년에 발표되었는데 Webtext (40GB) 라는 더 큰 데이터셋을 활용해 트레인되었으며 15억개의 파라미터와 1024 토큰의 컨텍스트 윈도우를 가지며 더 긴 텍스트와 복잡한 언어 패턴을 처리할 수 있게 되었다.
- 2020년에 발표된 GPT-3는 Common Crawl (45TB)을 포함한 거대한 데이터셋으로 훈련되었으며, 1,750억 개의 파라미터와 2048 토큰의 컨텍스트 윈도우를 가진다. In-context learning (ICL)이라는 중요한 기능을 도입하여, 추가적인 Fine Tuning 없이도 주어진 프롬프트의 지시에 따라 다양한 작업을 수행할 수 있는 것이 특징.
- GPT-3.5: GPT-3의 개선 버전으로, 구체적인 데이터셋이나 파라미터 수는 명시되어 있지 않지만, 2048 토큰의 컨텍스트 윈도우를 가지며 OpenAI의 AI 챗봇인 ChatGPT의 기반 모델로 사용되어 2022년 11월에 처음 공개된 이후 인간과 유사한 자연스러운 대화 능력으로 엄청난 인기를 얻게 됐다.
- 이후로도 multi-modal이 지원되는 GPT-4, 연산비용이 낮아져 무료로 사용할 수 있는 GPT-4o등 다양한 모델이 출시되고 있다.
BERT (Bidirectional Enconder Representations from Transformers)
- 2018년에 Google에서 발표한 모델로, 양방향 트랜스포머 인코더 아키텍처를 기반으로 한다. BERT는 BooksCorpus와 English Wikipedia 데이터셋으로 사전 훈련되었으며 (정확한 크기는 미공개), BERT-Base는 1억 1,000만 개, BERT-Large는 3억 4,000만 개의 파라미터를 가진다고 한다. BERT는 512 토큰의 컨텍스트 윈도우를 가지며, 주로 텍스트 이해 작업에 뛰어난 성능을 보인다.
- GPT 시리즈와 달리, BERT는 문맥의 양방향 정보를 모두 활용하여 단어의 의미를 더 정확하게 파악하는 데 중점을 둔 모델이다. 비교적 작은 모델이지만, 텍스트 이해에 그 강점을 두고 있는 만큼 검색 및 NLP 태스크에서 강하다고 알려져 있다. 실제로 Google 검색 엔진에 적용되어 있다고 알려져 있다.
PaLM (Pathways Language Model)
- PaLM은 Google에서 개발한 모델로, 2022년 PaLM-1이 처음 공개되었으며 5,400억 개의 파라미터를 가지는 매우 거대한 모델이다. 훈련 데이터로는 웹페이지, 도서, 뉴스, 소셜 미디어 대화, 위키피디아, Github 등 다양한 대규모 텍스트 데이터를 사용한 것으로 알려져 있으며, 매우 큰 규모 덕분에 복잡한 추론 능력과 다양한 언어에 대한 이해 능력을 보여준다고 한다. PaLM의 파생 모델은 Google의 LLM 기반 챗봇이었던 BARD (현재의 Gemini)의 기반이 되었다. PaLM-2는 3,400억 개의 파라미터를 가지며, 20개 이상의 프로그래밍 언어, 100개 이상의 구어체 언어, 수학 및 과학 텍스트로 훈련되었고, 8000 토큰의 컨텍스트 윈도우를 가지는 모델이다.
- PaLM의 경우 Multi-task Learning을 도입하여 다양한 작업을 동시에 수행할 수 있으며 GPT와 함께 가장 강력한 Generative Model로 알려져 있다. 실제로 체감상 ChatGPT와 Gemini가 제일 많이 활용되고 있는 것 같고, 대화, 텍스트 생성, 코드 작성 등에서 확실히 뛰어난 성능을 체험할 수 있다. 또한 아무래도 Google에서 개발한 모델이다 보니 초기 ChatGPT가 최신 정보에 대한 접근이 불가능했을 때 (
지금보다 훨씬 outdated했음 아무래도 웹 검색 기능이 도입된지 얼마 안됐기 때문에) 유저 입장에서는 큰 장점이 있었다.
LLaMA (Large Language Model Meta AI)
- Meta AI에서 개발한 Open Source 모델. 다양한 크기의 모델이 존재하며, 표에서 볼 수 있듯이 따르면 67억, 130억, 325억, 652억 개의 파라미터를 가진 모델들이 있다. Common Crawl, C4, Books, Github, Wikipedia, ArXiv, Stack Exchange 등 다양한 공개된 온라인 소스로 트레인되었으며 2048 토큰의 컨텍스트 윈도우를 가진다. LLaMA는 비교적 작은 모델 크기에도 불구하고 강력한 성능을 보여주고 있다. 실제로 경량화된 모델에 오픈소스라는 장점 때문에 대형 모델들에 비해 성능이 강력하지 않더라도 다양한 연구 및 개발 커뮤니티에서 활발하게 사용되고 있다.
Bing Chat, Claude, DeepSeek
Bing Chat
- Google이 BARD를 공개한 직후 Microsoft에서 공개한 검색 엔진 기능으로 GPT-4에 의해 구동되며, 사용자들이 검색어를 직접 입력하는 대신 챗봇과 대화할 수 있도록 하였다. 실시간 인터넷에 접근이 가능하고 출처가 명시된 답변을 제공한다는 장점이 있다. 또 사용자의 질문에 따라 '창의적인', '균형 잡힌', '정확한' 등과 같이 다양한 응답 스타일을 선택할 수 있도록 하는 사용자 맞춤형 상호작용을 제공한 것이 특징이다.
Claude
- Anthropic에서 개발한 챗봇으로 특히 Claude2는 포괄적인 추론 능력과 Constitutional AI라는 파인튜닝 과정을 통해 더 안전한 응답을 제공하는 것으로 알려져 있다. 이 방식은 AI가 스스로 Constitution(헌법)에 따라 자신의 응답을 평가하고 개선하도록 학습시키는 방식이다. 전통적인 강화 학습에서 인간의 피드백을 통해 모델을 튜닝한 것과는 달리 모델이 스스로 더 안전한 응답을 제공하도록 하는 것이 그 특징이다.
DeepSeek
- 최근 가장 화제의 중심이 되었던 DeepSeek는 중국 기반의 연구팀이 개발한 모델로 특히 Meta의 LLaMA 시리즈와 같은 유사한 경량화된 구조를 가지면서도 강력한 성능을 보여 주목을 받았다. 공개된 벤치마크 데이터에 따르면, 오픈 소스 모델인데 훨씬 경량화된 크기로 GPT-4o와 비슷한 성능을 보여준다고 한다. 비용 자체도 V3를 개발하는 데 80억 원 수준의 적은 비용이 들었다고 보고 되어 수천억원의 비용을 들이며 엄청난 Computational Cost를 요구하는 LLM 시장에 충격을 주었다.
안타깝게도 DeepSeek는 출시와 동시에 보안과 신뢰성 논란으로 주가가 폭락하고 있지만 ... 생각해볼 계기가 되는 것은 분명할지도...?
3. LLM 핵심 기술
1. Transformer Architecture
트랜스포머 모델의 등장이 자연어 처리 분야에서 혁명을 일으켰고, 이를 통해 챗봇 시장이 크게 성장한 것이기 때문에 해당 모델을 언급하지 않을 수 없다.
Encoder-Decoder Structure
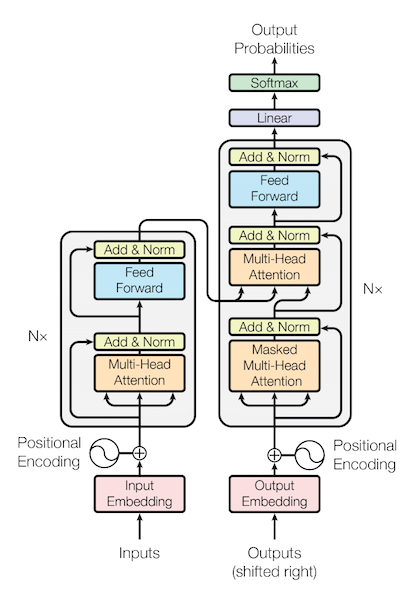
- Transformer 모델은 인코더와 디코더 아키텍쳐를 기반으로 한다. 인코더는 input 데이터의 abstract representations를 생성하고, Multi-Head Self-Attention을 통해 input sequence의 여러 부분에 집중하게 된다. 그러면 디코더가 이러한 representations를 활용하여 autoregressive한 방식으로 output sequence를 생성하며, 인코더의 representations에 대해서 cross-attention을 수행하는 것이다.
Causal and Bidirectional Decoder
- LLM기반의 챗봇들은 주로 두가지의 디코더 방식을 활용하는데, 사실 위에 소개된 모델들 중 BERT를 제외하고는 모두 Autoregressive 즉, Causal Decoder를 활용하고 있다. 이는 하나 방향으로 작동하는 구조로 현재 단어를 생성할 때 미래 단어를 참고하지 않기 때문에 자기회귀 모델이라 불리는 것이다.
- Bidirectional Decoder같은 경우에는 문장의 앞뒤 문맥을 모두 고려하여 학습하는 방식으로 Masked Language Model이라고도 불리는데 문장에서 일부 단어를 마스킹한 다음 주변 단어를 보고 예측하는 식으로 ('빈칸 채우기') 학습을 진행하게 된다.
- 이러한 두가지 방식의 차이 때문에 이전에 언급하였듯이 GPT를 비롯한 다른 모델들은 텍스트 생성에 좀 더 강점을 가지게 되는 것이고 - '텍스트 생성'에 그 초점을 둔다, BERT와 같은 모델들은 문맥 이해력이 뛰어나 검색, 번역, 요약 등에 강점을 가지게 되는 것이다 - '문장 이해'에 그 초점을 둔다.
Self-Attention Mechanism
- 셀프 어텐션은 트랜스포머 모델의 핵심 요소로 문장에서 각 단어가 다른 단어들과 어떤 관계를 가지는지를 학습하는 방식이다. 이 특별한 매커니즘이 기존의 RNN, LSTM 모델들과 비교했을 때, 가장 이슈가 됐던 장기 의존성 문제 (Long-Term Dependency Issue)를 해결하고, 병렬 연산이 가능하게 만들어 자연어 처리 분야에 혁신을 일으켰다고 할 수 있다.
Self-Attention은 입력 문장을 벡터로 변환한 후, 각 단어가 다른 단어들과 얼마나 연관성이 있는지를 수치화하는 과정이다. 동작 원리는 크게 3단계로 나눌 수 있는데
- Query (Q), Key (K), Value (V) 벡터 생성
• 입력된 각 단어를 세 개의 벡터(Query, Key, Value)로 변환.
• Query(Q): “현재 단어가 다른 단어들과 얼마나 관련이 있는지” 질문.
• Key(K): “각 단어가 얼마나 중요한지” 나타냄.
• Value(V): “각 단어의 실제 값(정보)“을 담고 있음. - 각 단어 간의 유사도 계산 (Dot Product Attention Score)
• Query와 Key의 내적(Dot Product)을 통해 각 단어가 다른 단어와 얼마나 관련이 있는지 스코어 계산.
• 결과 값에 Softmax 함수를 적용하여 가중치를 정규화. (0~1 사이로 아웃풋 나오게 됨) - 가중치를 반영한 최종 출력 계산
• Softmax로 정규화된 가중치를 Value 벡터에 곱해 최종 출력 벡터 생성.
- Query (Q), Key (K), Value (V) 벡터 생성
- 또한 트랜스포머에서는 하나의 Self-Attention을 여러 개 병렬로 실행하여 다양한 시각에서 문맥을 이해할 수 있도록 하는데, 이를 바로 Multi-Head Self-Attention이라고 부른다.
2. LLM-based Chatbots의 주요 기능
In-Context Learning (ICL)
- GPT-3에서 도입된 핵심 기술로, LLM이 추가적인 훈련 없이도 대화 맥락을 이해하고 적절하게 응답할 수 있도록 한다. 모델은 입력된 텍스트의 지침을 따르며, 주어진 예제나 맥락을 기반으로 새로운 패턴을 학습할 수 있다. 이를 더욱 향상시키는 방법이 Instruction Tuning(명령 튜닝)으로, 이는 다양한 멀티태스킹 데이터셋을 활용한 미세 조정 기법이라고 한다. 이 과정에서 모델은 자연어 명령을 학습하여, 익숙하지 않은 작업도 유사한 명령을 활용해 처리할 수 있는 일반화 능력을 갖추게 된다.
Chain-of-Thought (CoT) 프롬프팅
- LLM이 복잡한 문제를 논리적으로 해결할 수 있도록 돕는 기법이다. 기존의 작은 언어 모델들은 단순한 질의응답에는 강하지만, 다단계 추론이 필요한 문제 해결에는 한계가 있었다. CoT 프롬프팅은 한 번에 최종 답을 생성하는 대신, 해결 과정을 단계별로 나누어 설명하도록 유도한다. 이를 통해 LLM이 논리적 사고를 강화하고, 수학 문제 해결, 논리 퍼즐, 프로그래밍 문제 등 복잡한 작업을 더 잘 수행할 수 있도록 한다고 알려져 있다.
Reinforcement Learning from Human Feedback (RLHF)
- LLM이 사람과의 상호작용을 통해 지속적으로 성능을 개선하도록 하는 중요한 학습 기법으로, 모델이 보다 인간 친화적인 응답을 생성하도록 하기 위해, 실제 사용자 피드백을 기반으로 보상을 제공하는 강화 학습 기법을 적용한다. RLHF를 활용하면 사용자 선호도와 윤리적 기준에 부합하는 답변을 생성하는 능력이 향상된다고 알려져 있으며 유해하거나 부적절한 콘텐츠를 줄이고, 보다 신뢰할 수 있는 AI 시스템을 구축할 수 있다고 한다.
References
다양한 논문을 읽었지만 Dam, S.K., Hong, C.S., Qiao, Y. and Zhang, C., 2024. A complete survey on llm-based ai chatbots. arXiv preprint arXiv:2406.16937.가 매우 구조화가 잘되어있어 메인으로 참고하였다!