KL divergence
들어가기에 앞서
정보 엔트로피(information entropy)
step1. 정보량
- 어떤 사건이 자주 일어나면 별로 놀랍지 않고, 거의 안 일어나는 사건이 발생하면 놀라움
- 정보이론에서는 이 “놀라움의 정도”를 정보량이라고 봄
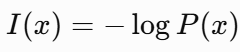
- 어떤 사건의 확률이 0.5라면 정보량은 비교적 작고, 확률이 0.01이라면 정보량은 훨씬 큼 그러면 아래와 같이
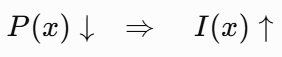
step2. 왜 -(log P(x))를 사용할까?
- 확룰이 작을수록 정보량이 커져야함
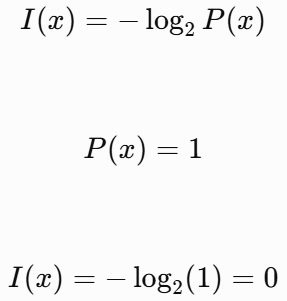
- 100% 일어나는 사건은 새로운 정보가 없음을 의미
하지만
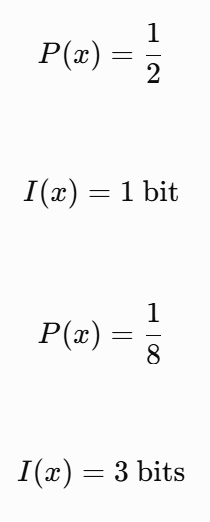
드문 사건일수록 정보량이 커짐
step3. 왜 로그를 쓰는가?
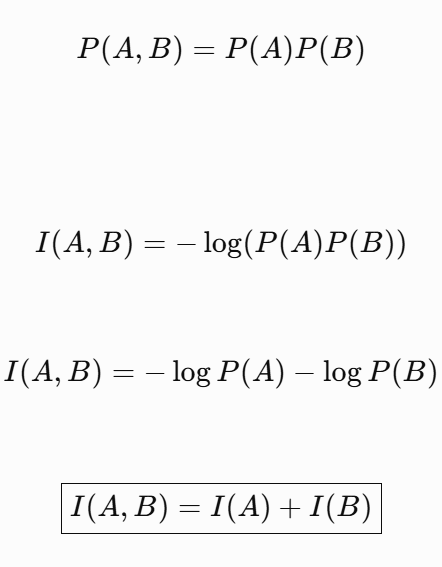
로그 성질때문에 이렇게 진행이 됨
step4. 그러면 엔트로피는 무엇인가? -> 정보량의 평균값
- 각 사건마다 정보량이 다르기 때문에 전체 시스템이 평균적으로 얼마나 많은 정보를 가지는지를 계산함
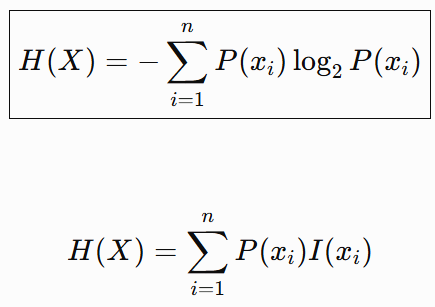
발생 확률 × 그 사건의 정보량
step5. 주사위로 보면
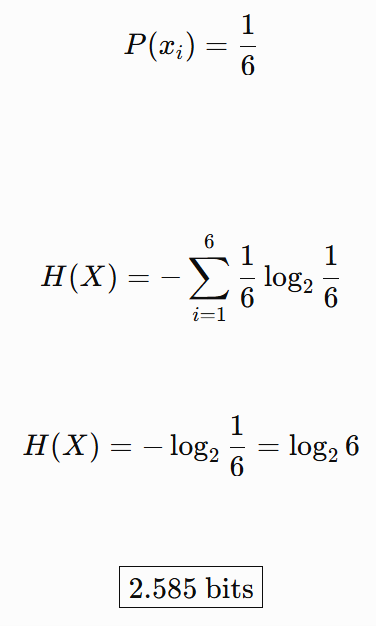
-
해당 부분에서 머신러닝을 진행할때 softmax가 확률을 출력함
-
모델이 얼마나 확신하고 있는지 판단하는 데 사용할 수 있음
-
bit를 사용한 것은 log_{2}를 사용했을 떄의 정보량 단위임
ex)
빨강 100%
파랑 0%
꺼내기 전에도
“무조건 빨간색이겠네.”
라고 알 수 있습니다.
별로 놀랍지 않습니다.
그래서 Entropy가 낮습니다.
빨간 사탕 50개, 파란 사탕 50개라면?
빨강 50%
파랑 50%
뽑기 전에는 무슨 색인지 모릅니다.
“빨간색일까? 파란색일까?”
불확실성이 큽니다.
그래서 Entropy가 높습니다.
즉, entropy는 결과가 얼마나 불확실한가를 본다.
크로스 엔트로피(cross entropy)
실제 분포 (P)를 기준으로 봤을 때, 모델이 예측한 분포 (Q)가 얼마나 잘못되었는지를 나타내는 값
-> 예측과 달라서 생기는 깜놀도(즉 정보량)을 의미함
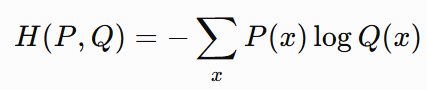
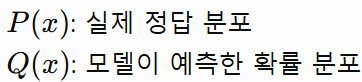
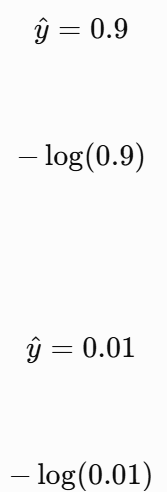
- 핵심은 정답이 실제로 발생했는데, 모델이 그 정답에 낮은 확률을 줬다면 큰 손실을 준다는 것
- 정답이 0 또는 1인 이진 분류에서는 다음과 같이 씀
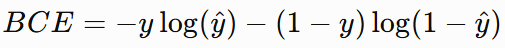
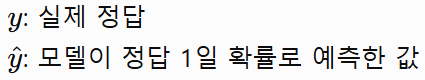
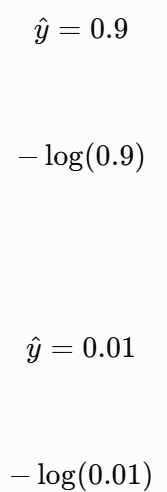
여기서 보이듯이
- 정답이 높은 확률을 부여하면 -> cross entropy가 작음
- 정답에 낮은 확률을 부여하면 -> cross entropy 큼
ex)
실제 정답은
고양이
입니다.
AI A
고양이 90%
강아지 10%
라고 예측했습니다.
정답인 고양이에 높은 확률을 줬죠.
그래서
“잘 맞췄네.”
Cross Entropy가 작습니다
AI B
고양이 1%
강아지 99%
라고 예측했습니다.
그런데 실제로는 고양이입니다.
AI는
“강아지라고 거의 확신했는데 고양이라고?”
하게 됩니다.
이런 경우 Cross Entropy가 매우 큽니다
정답과 예측이 얼마나 안맞는가를 봄
Entropy와 Cross Entropy의 차이
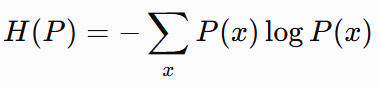
-> 실제 분포 (P) 자체가 얼마나 불확실한가 = entropy
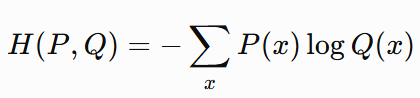
-> 실제는 (P)인데 모델이 (Q)라고 생각했을 때 필요한 평균 정보량 = Cross Entropy
KL Divergence는?
- KL Divergence는 두 확률분포 (P)와 (Q)가 얼마나 다른지를 정보량 관점에서 나타낸 값
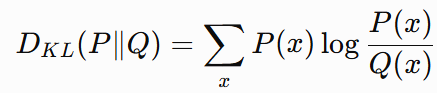
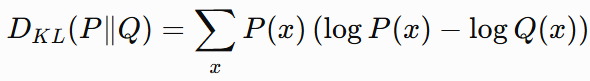
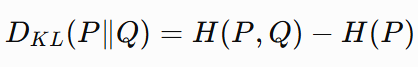
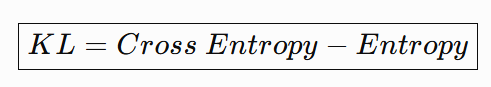
즉 해당 것은 모델 떄문에 추가로 발생한 차이임
두 생각의 차이가 얼마나 큰가로
ex)
이제 두 사람이 사탕 상자를 보고 있다고 합시다.
실제 상자는
빨강 80%
파랑 20%
입니다.
이게 실제 확률 분포 (P)입니다.
그런데 철수는
빨강 70%
파랑 30%
이라고 생각합니다.
실제와 꽤 비슷합니다.
그래서 KL Divergence가 작습니다.
그런데 영희는
빨강 10%
파랑 90%
이라고 생각합니다.
실제는 빨강이 대부분인데 완전히 반대로 생각하고 있습니다.
그래서 KL Divergence가 큽니다.
-> 원래 문제 자체도 어려움
+
내 예측도 틀림
=
Cross Entropy가 큼