PP-노이즈처리, 스케일링
1. 노이즈
1.1 노이즈
노이즈라는 말은 원래 소음·잡음을 의미하는데, 이 말이 각 분야에서 여러 가지 의미로 쓰이고 있다. 데이터 분야에서는 측정된 변수에 무작위의 오류 또는 분산이 존재하는 것, 데이터를 사용할 때 제거되거나 무시되어야 하는 의미 없이 첨가된 비트나 단어들을 의미한다.
1.2 정형 데이터의 노이즈
-
정형 데이터에서 노이즈는 분산으로 나타난다.
- 분산 : 데이터의 무작위 변동
- 이상치 -> 데이터의 무작위 변동을 초과하는 특정한 값으로 별도 처리 -
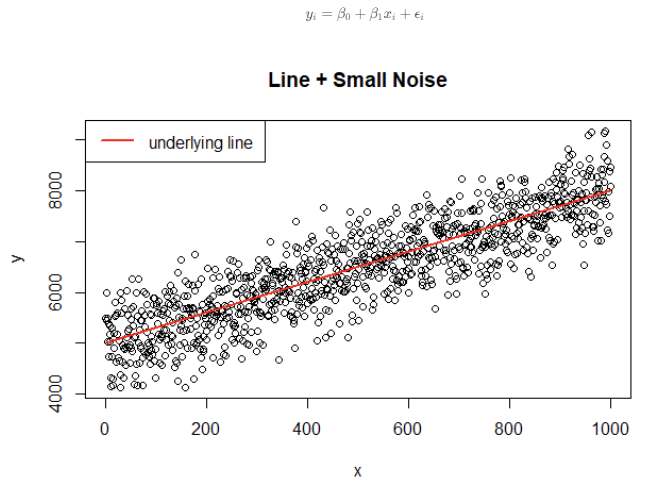
통계 모형에서 노이즈는 오차항으로 나타난다.
-오차항 : 모형에서 설명하지 못하는 무작위 변동
-예) 단순선형회귀모형에서는 오차항 ϵi가 노이즈
1.3 이미지/영상 데이터의 노이즈
-
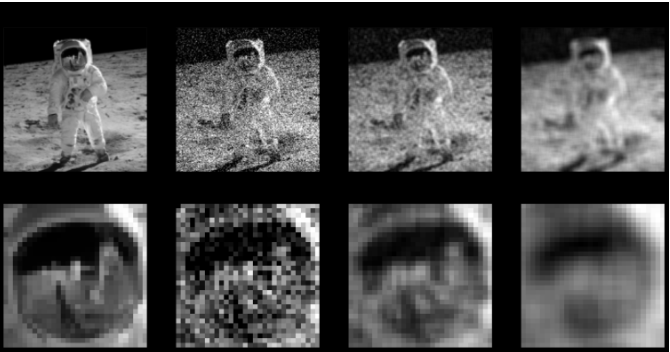
이미지/영상 데이터에서 노이즈는 다양한 형태로 나타난다.
-blur : 이미지가 흐릿하게 보이는 현상
-white noise(백색 잡음) : 모든 주파수 영역에서 동일한 에너지를 가지는 잡음
-pink noise : 특정 주파수 대역에서 강하게 나타나는 노이즈, 일반적으로 낮은 주파수 대역에서 강하게 나타남
-Gaussian noise : 평균이 0이고, 분산이 1인 정규분포(가우시안 분포)를 따르는 잡음
-
이미지/영상 데이터의 노이즈 주요 원인
-이미지를 얻는 과정에서 수집된 광자의 양 너무 적음
-이미지를 얻는 과정에서 센서나 렌즈의 열화가 발생
-이미지를 전송 중에 무선 통신의 에코 및 대기 왜곡 발생 등
1.4 시계열/음성/신호 데이터의 노이즈
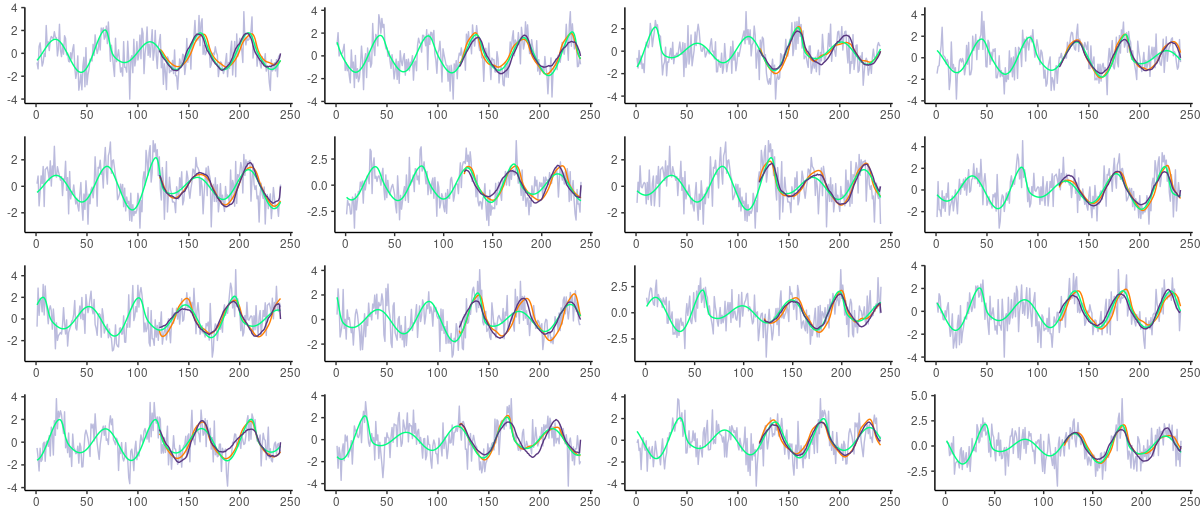
시계열/음성/신호에서 노이즈는 일반적으로 white noise나 Gaussian noise로 나타난다. (이미지 -> 가우시안 잡음에 관한 것.)
1.5 텍스트 데이터의 노이즈
- 텍스트 데이터의 노이즈 발생 원인은 일반적으로 철자 오류, 약어나 비표준 단어 사용, 반복되는 말, 구두점이나 대소 문자 정보 누락, “음” 및 “어”와 같은 의성어 사용 등이 있다.
- 텍스트 데이터의 노이즈는 자연어 처리의 성능을 저하시키므로 처리 대상이다.
- 자동 음성 인식, 광학 문자 인식, 기계 번역, Web Scraping 등으로 수집한 데이터에 노이즈가 많다.
1.6 비슷한 다른 용어들
- Defact(결함) : 전체 데이터에 존재하는 일부 오류 데이터
-범위에서 벗어난 이상치(outlier)가 아니라 잘못된(error) 데이터
-주로 생산이나 제조 분야에서 사용한다. (이미지 -> 반도체 결함)
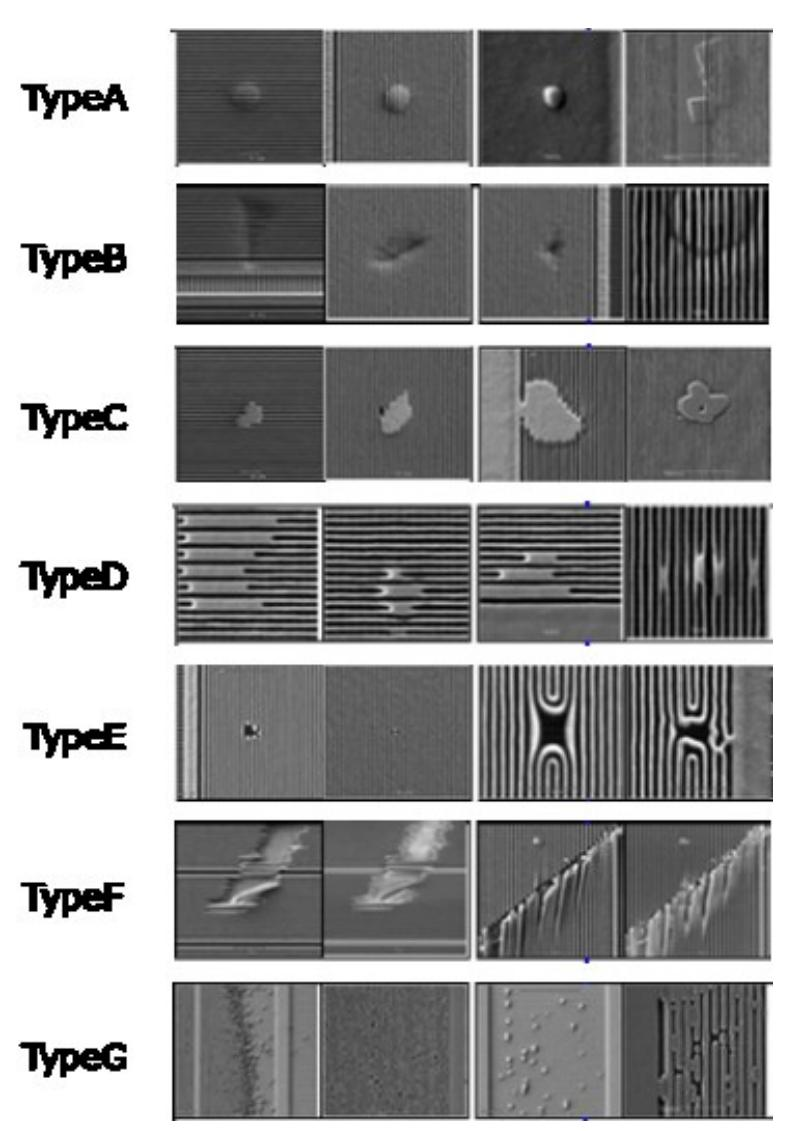
- Fault(불량/기능이상) : Defact에 의해 제품/설비의 기능에 손상을 입으면 발생한다.
-모든 defect가 fault를 야기하지는 않음
- Artifact : 주로 과학기술 분야에서 사용하는 용어로 특히, 이미지의 결함을 지칭한다.
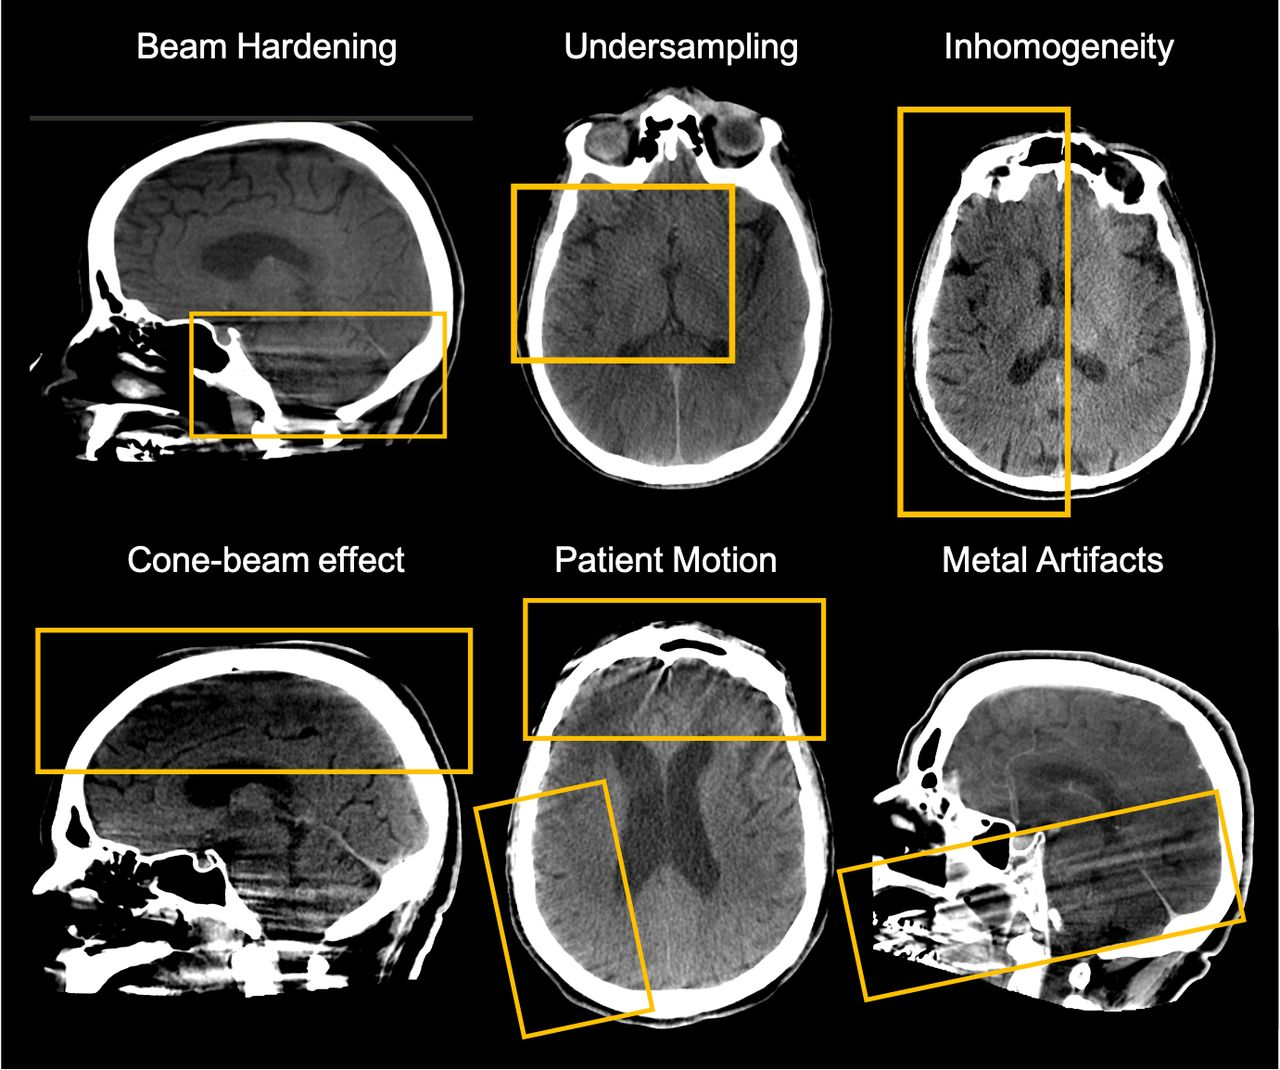
- Noise : 일반적으로 그 원인을 알 수 없는 무작위 변동을 의미한다. 데이터 과학에서는 데이터의 무작위 변동을 의미한다.
-무작위(ramdom)가 발생하는 메커니즘을 알 수 없다는 의미로 발생 메커니즘을 알게 되면 무작위 중 수학적 모형을 통하여 반영된 것을 제외한 것이 random이 된다.
-주로 신호처리(signal processing) 분야에서 사용하는 용어임
-동작 메커니즘을 모르므로 제거는 불가하기 때문에 이를 저감(Denoising)하여야 한다.
2. 디노이징
2.1 디노이징
디노이징은 데이터에서 노이즈를 저감하여 모형이 더 좋은 성능을 할 수 있도록 하는 전처리 과정이다. 앞에서 언급했듯이 노이즈는 제거가 불가능하기 때문에 디노이징이 필요하다. 기본적인 기법으로는 평활화(smoothing, 구간평균), 구간화(binning, 구간집계), 필터링(filtering, 주파성분 저감)기법이 있다.
2.2 정형 데이터의 디노이징
- 정형 데이터의 디노이징 방법으로는 구간화와 군집화가 있다.
-구간화 : 정렬된 데이터 값들을 몇 개의 bin(혹은 bucket)으로 분할하여 대표값으로 대체하는 방법
-군집화 : 유사한 값들을 하나의 군집으로 처리하여 중심점(centroid)을 대표값으로 대체하는 방법
2.3 구간화
-
구간 설정 방법
1. 동일 간격(equal-distance) 구간화 → pandas의 cut() 사용
-정상 데이터가 한쪽으로 편중(biased)되고 이상치의 영향을 많이 받는다.
-한쪽으로 몰려있는 데이터들은 다 동일한 bin으로 들어오기 때문에 skewed data를 다룰 수 없다.
2. 동일 빈도(eual-frequency) 구간화 → pandas의 qcut() 사용
-동일한 개수의 데이터를 가지는 구간으로 설정한다. -
구간별 대표값 설정 방법
-평균값 평활화 : bin에 있는 값들을 평균값으로 대체
-중앙값 평활화 : 중앙값으로 대체
-경계값 평활화 : 경계값 중 가까운 값으로 대체 -
기본
import pandas as pd
import numpy as np

df = pd.DataFrame({'uniform': np.sort(np.random.uniform(0,10,10)),
                     'normal': np.sort(np.random.normal(5,1,10)),
                     'gamma': np.sort(np.random.gamma(2, size=10))})
df.plot(kind='hist', bins=15, alpha=0.5)
df.describe()

col = 'uniform'
num_bins = 5
df_binned = pd.DataFrame()
df_binned[col] = df[col].sort_values()
df_binned['eq_dist_auto'] = pd.cut(df_binned[col], num_bins)
df_binned['eq_dist_fixed'] = pd.cut(df_binned[col], bins=[0,2,4,6,8,10])
df_binned['eq_freq_auto'] = pd.qcut(df_binned[col], num_bins)
df_binned

cols = ['uniform', 'normal', 'gamma']
df_ew = df.copy()
for col in cols:
    df_ew[col+'_eq_dist'] = pd.cut(df_ew[col], 3)
    means = df_ew.groupby(col+'_eq_dist')[col].mean()
    df_ew.replace({col+'_eq_dist': means}, inplace=True)
display(df_ew)
df_ef = df.copy()
for col in cols:
    df_ef[col+'_eq_freq'] = pd.qcut(df_ef[col], 3)
    means = df_ef.groupby(col+'_eq_freq')[col].mean()
    df_ef.replace({col+'_eq_freq': means}, inplace=True)
display(df_ef)

import matplotlib.pyplot as plt

fig, axes = plt.subplots(1, 2, figsize=(10,5))
df_ew.astype(float).plot(ax=axes[0])
df_ef.astype(float).plot(ax=axes[1])
plt.show()- 학습 (학습한 내용 #으로 표시)
import pandas as pd
import numpy as np

# 데이터를 랜덤으로 생성한다. 또한 데이터 결과를 보기 용이하도록 sort한다. 10개씩 (균일분포, 정규분포, 감마분포 추출)
aa = pd.DataFrame({'uniform': np.sort(np.random.uniform(0,10,10)),
                     'normal': np.sort(np.random.normal(5,1,10)),
                     'gamma': np.sort(np.random.gamma(2, size=10))})

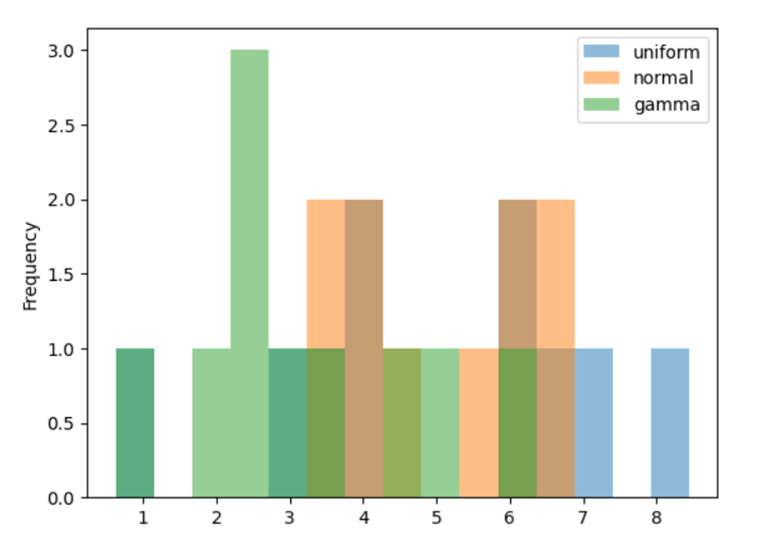
# 생성한 데이터를 확인한다. 히스토그램으로 나타낸다.(15)
aa.plot(kind='hist', bins=15, alpha=0.5)
aa.describe()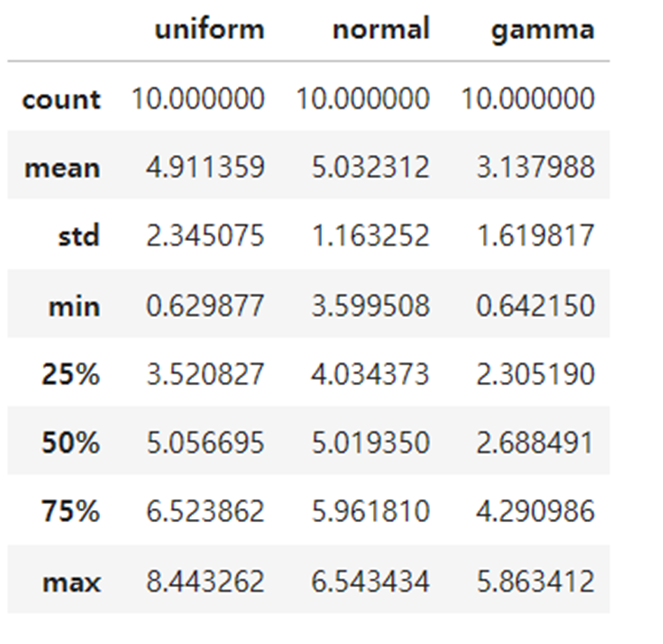
- Pandas로 구간화
# cut(), qcut() 기본 동작 확인, cut()는 동일한 길이로 나누는 함수이고, qcut()는 동일한 개수로 나누는 함수이다.
col = 'uniform'
num_bins = 5
aa_binned = pd.DataFrame()
aa_binned[col] = aa[col].sort_values()  # 원 데이터(해당 열)를 오름차순 정렬
aa_binned['eq_dist_auto'] = pd.cut(aa_binned[col], num_bins)  # 동일한 간격(5)으로 나누기
aa_binned['eq_dist_fixed'] = pd.cut(aa_binned[col], bins=[0,2,4,6,8,10]) # 지정된 구간으로 나누기, 예) 0~2 사이, 2~4 사이...
aa_binned['eq_freq_auto'] = pd.qcut(aa_binned[col], num_bins) # 동일 빈도(5개 묶음)로 나누기
aa_binned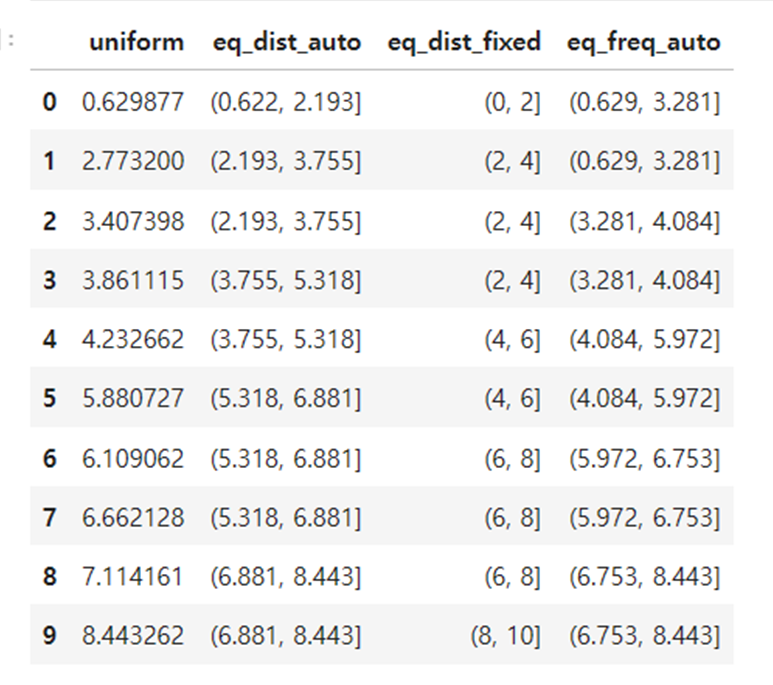
# 구간화하여 평균값 대체하기
cols = ['uniform', 'normal', 'gamma']

# 동일 간격 구간화 -> cut
aa_ew = aa.copy()
for col in cols:
    aa_ew[col+'_eq_dist'] = pd.cut(aa_ew[col], 3)   # 열 별로 구간(3) 나누기
    means = aa_ew.groupby(col+'_eq_dist')[col].mean() # 구간(3)별 평균값 계산
    aa_ew.replace({col+'_eq_dist': means}, inplace=True) # 각 구간별 평균값으로 대체

display(aa_ew)

# 동일 빈도 구간화 -> 묶이는 개수가 같게(qcut)
aa_ef = aa.copy()
for col in cols:
    aa_ef[col+'_eq_freq'] = pd.qcut(aa_ef[col], 3)   # 구간 개수(3)으로 나누기
    means = aa_ef.groupby(col+'_eq_freq')[col].mean() # 구간별 평균값 계산
    aa_ef.replace({col+'_eq_freq': means}, inplace=True) # 평균값으로 대체

display(aa_ef)

# 시각화
import matplotlib.pyplot as plt

fig, axes = plt.subplots(1, 2, figsize=(10,5))
aa_ew.astype(float).plot(ax=axes[0])
aa_ef.astype(float).plot(ax=axes[1])
plt.show()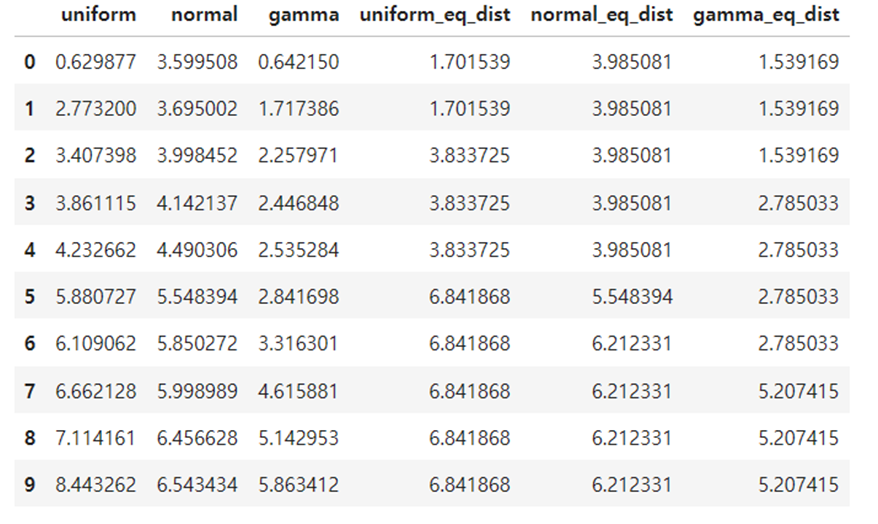
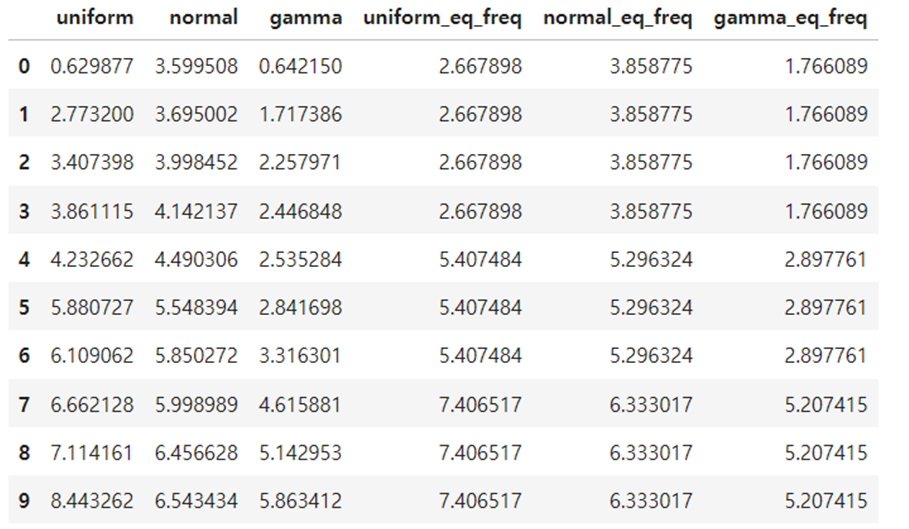
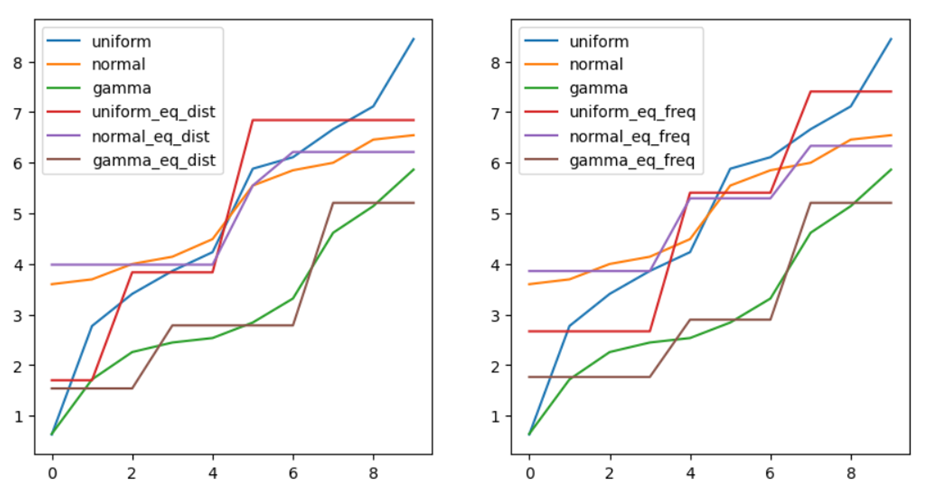
실행 결과 정리 -> cut을 이용해 동일 간격, qcut을 이용해 동일 빈도로 구간화하여 평균에 대한 새로운 열을 생성한 후 그래프로 시각화 하였음.
- 응용
import pandas as pd
import numpy as np

ee = pd.DataFrame({"gender": np.random.randint(0, 2, size=11),
                   "age": np.random.randint(20, 70, size=11),
                   'happiness': np.random.randint(1, 6, size=11)})
gender_lv = ['male', 'female']
ee["gender"] = pd.Categorical.from_codes(ee["gender"], gender_lv)

ee['age_cut'] = pd.cut(ee['age'], 3)
ee['age_qcut'] = pd.qcut(ee['age'], 4)
ee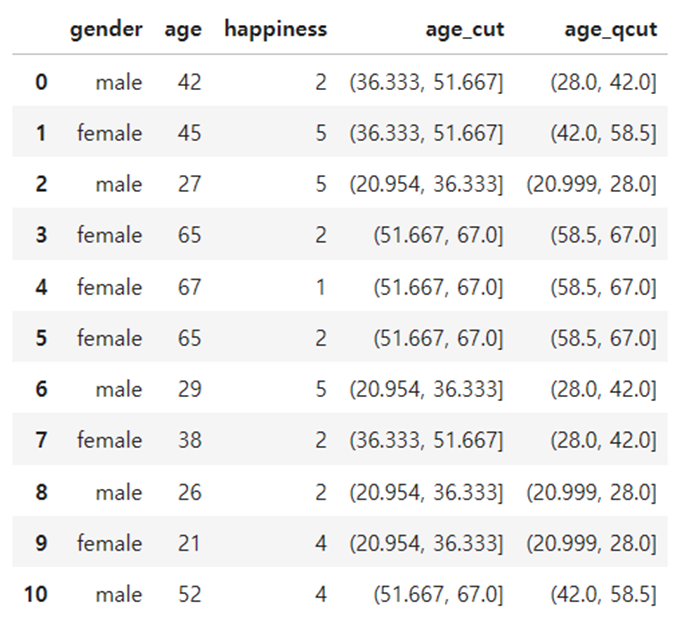
실행 결과 정리 -> 임의의 데이터 ee를 생성한 후 cut과 qcut을 사용하여 구간화 하였다.
2.4 군집화
- Scikit-Learn으로 구간화
- 기본
import warnings
warnings.filterwarnings("ignore")
from sklearn.preprocessing import KBinsDiscretizer

ed_binner = KBinsDiscretizer(n_bins=3, encode='ordinal', strategy='uniform', subsample=None)
df_ed = ed_binner.fit_transform(df)
ef_binner = KBinsDiscretizer(n_bins=3, encode='ordinal', strategy='quantile', subsample=None)
df_ef = ef_binner.fit_transform(df)
km_binner = KBinsDiscretizer(n_bins=3, encode='ordinal', strategy='kmeans', subsample=None)
df_km = km_binner.fit_transform(df)
df_ed = pd.DataFrame(df_ed, columns=df.columns+'_eq_dist')
df_ef = pd.DataFrame(df_ef, columns=df.columns+'_eq_freq')
df_km = pd.DataFrame(df_km, columns=df.columns+'_km')
df_bin = pd.concat([df, df_ed, df_ef, df_km], axis=1)
df_bin

for bin_col in df_bin.columns:
    col = bin_col.split('_')[0]
    means = df_bin.groupby(by=bin_col)[col].mean()
    df_bin.replace({bin_col: means}, inplace=True)
df_bin

import matplotlib.pyplot as plt

fig, axes = plt.subplots(1, 3, figsize=(15,5))
pd.concat([df_bin.iloc[:,:3], df_bin.iloc[:,3:6]], axis=1).astype(float).plot(ax=axes[0])
pd.concat([df_bin.iloc[:,:3], df_bin.iloc[:,6:9]], axis=1).astype(float).plot(ax=axes[1])
pd.concat([df_bin.iloc[:,:3], df_bin.iloc[:,9:]], axis=1).astype(float).plot(ax=axes[2])
plt.show()- 학습
from sklearn.preprocessing import KBinsDiscretizer
#KBinsDiscretizer() -> 파라미터 n_bins(간격/구간 수), encode, strategy, subsample=none -> training 데이터 모두 사용
# encode -> onehot(수많은 0과 하나의 1로 구분)/onehot-dense(onehot 인코딩&조밀한 배열)/ordinal(정수 값으로 인코딩)
#strategy -> uniform(동일간격)/quantile(동일빈도)/kmeans(K-Means 군집화)
#fit_transform -> train data로 학습된 Scaler()의 parameter를 통해 test data의 feature 값들이 스케일 되는 것

# 동일 간격 구간화 -> uniform 사용
ed_binner = KBinsDiscretizer(n_bins=3, encode='ordinal', strategy='uniform', subsample=None)
aa_ed = ed_binner.fit_transform(aa)

# 동일 빈도 구간화 -> quantile 사용
ef_binner = KBinsDiscretizer(n_bins=3, encode='ordinal', strategy='quantile', subsample=None)
aa_ef = ef_binner.fit_transform(aa)

# K-means 구간화 -> kmeans 사용
km_binner = KBinsDiscretizer(n_bins=3, encode='ordinal', strategy='kmeans', subsample=None)
aa_km = km_binner.fit_transform(aa)

# 결과 확인
aa_ed = pd.DataFrame(aa_ed, columns=aa.columns+'_eq_dist')
aa_ef = pd.DataFrame(aa_ef, columns=aa.columns+'_eq_freq')
aa_km = pd.DataFrame(aa_km, columns=aa.columns+'_km')
aa_bin = pd.concat([aa, aa_ed, aa_ef, aa_km], axis=1)
aa_bin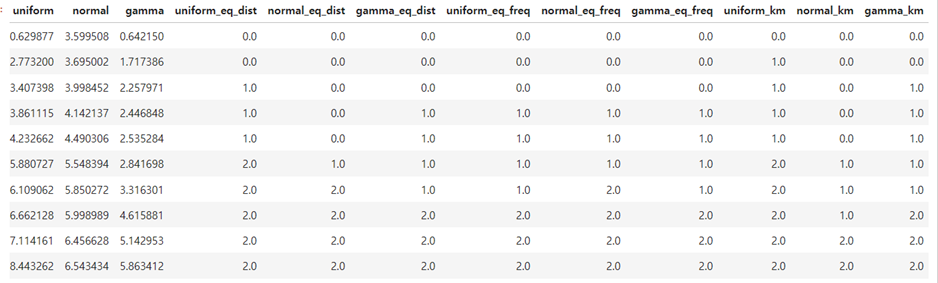
# 구간화하여 평균값 대체하기 (n_bins=3)
for bin_col in aa_bin.columns:
    col = bin_col.split('_')[0] #uniform/normal/gamma
    means = aa_bin.groupby(by=bin_col)[col].mean() # 구간별 평균값 계산
    aa_bin.replace({bin_col: means}, inplace=True) # 평균값으로 대체

aa_bin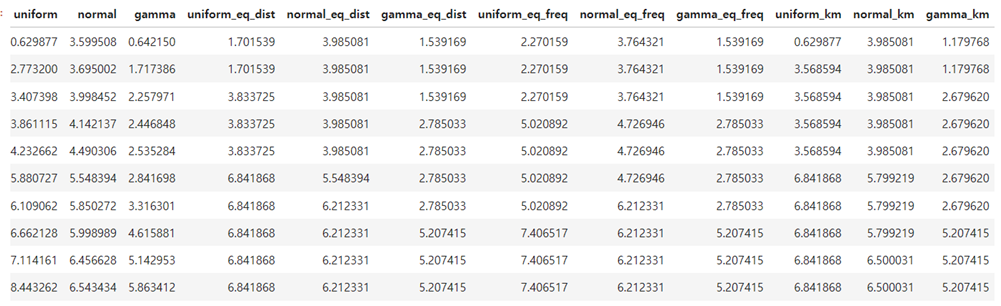
# 시각화
import matplotlib.pyplot as plt

fig, axes = plt.subplots(1, 3, figsize=(15,5))
pd.concat([aa_bin.iloc[:,:3], aa_bin.iloc[:,3:6]], axis=1).astype(float).plot(ax=axes[0])
pd.concat([aa_bin.iloc[:,:3], aa_bin.iloc[:,6:9]], axis=1).astype(float).plot(ax=axes[1])
pd.concat([aa_bin.iloc[:,:3], aa_bin.iloc[:,9:]], axis=1).astype(float).plot(ax=axes[2])
plt.show()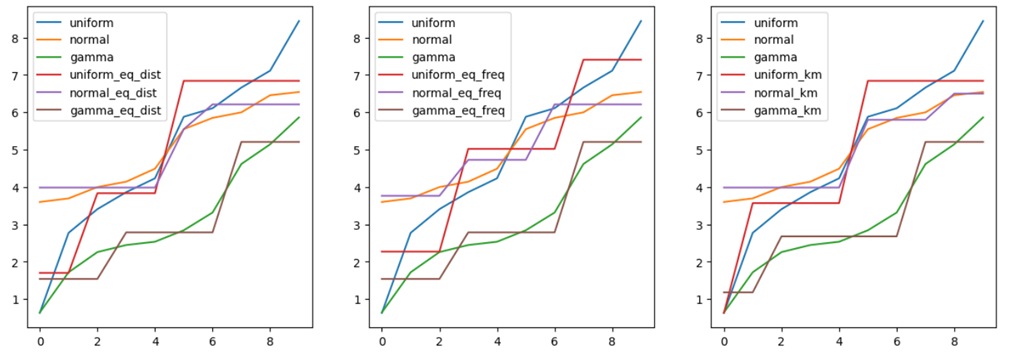
실행 결과 정리 -> strategy 파라미터로 각 방법별로 구간화를 한 후(구간 별 0/1/2로 표현) 구간별 평균값을 행별로 구하여 대체한 후 시각화를 하였다.
- 응용
# strategy = uniform, mean 기준
from sklearn.preprocessing import KBinsDiscretizer
import matplotlib.pyplot as plt
train_pt = pd.DataFrame(ii['sepal_length'])

est_uni = KBinsDiscretizer(n_bins=2, encode='ordinal', strategy='uniform')
est_uni.fit(train_pt)

Xt_uni=est_uni.transform(train_pt)
print("edges : ", est_uni.bin_edges_[0])

unique, counts = np.unique(Xt_uni, return_counts=True)
print(dict(zip(unique, counts)))

plt.hist(Xt_uni, bins='auto')
plt.xticks([0,0.5,1])
plt.rcParams['figure.figsize']=(5.5,6)
plt.show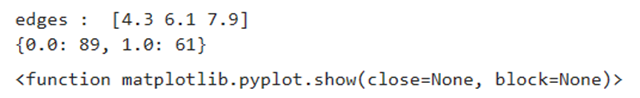
# strategy = quantile, median 기준

est_quan = KBinsDiscretizer(n_bins=2, encode='ordinal', strategy='quantile')
est_quan.fit(train_pt)

Xt_quan=est_quan.transform(train_pt)
print("edges : ", est_quan.bin_edges_[0])

unique_q, counts_q = np.unique(Xt_quan, return_counts=True)
print(dict(zip(unique_q, counts_q)))

plt.hist(Xt_quan, bins='auto')
plt.xticks([0,0.5,1])
plt.rcParams['figure.figsize']=(5.5,6)
plt.show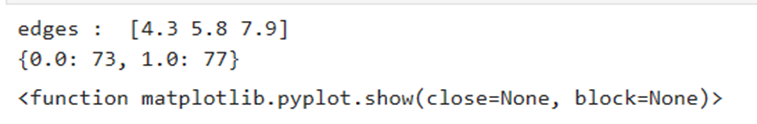
# strategy = kmeans, normal distribution 2개 생성

est_km = KBinsDiscretizer(n_bins=2, encode='ordinal', strategy='kmeans')
est_km.fit(train_pt)

Xt_km=est_km.transform(train_pt)
print("edges : ", est_km.bin_edges_[0])

unique_k, counts_k = np.unique(Xt_km, return_counts=True)
print(dict(zip(unique_k, counts_k)))

plt.hist(Xt_km, bins='auto')
plt.xticks([0,0.5,1])
plt.rcParams['figure.figsize']=(5.5,6)
plt.show()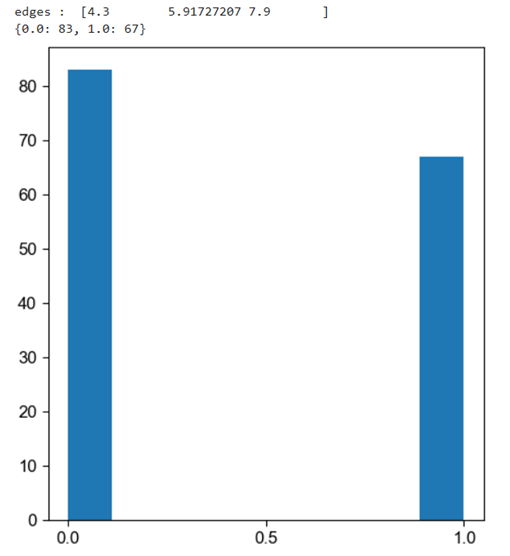
실행 결과 정리 -> iris의 sepa_length 열을 그룹핑하여 세 방법으로 범주화하였다.
3. Scikit-Learn
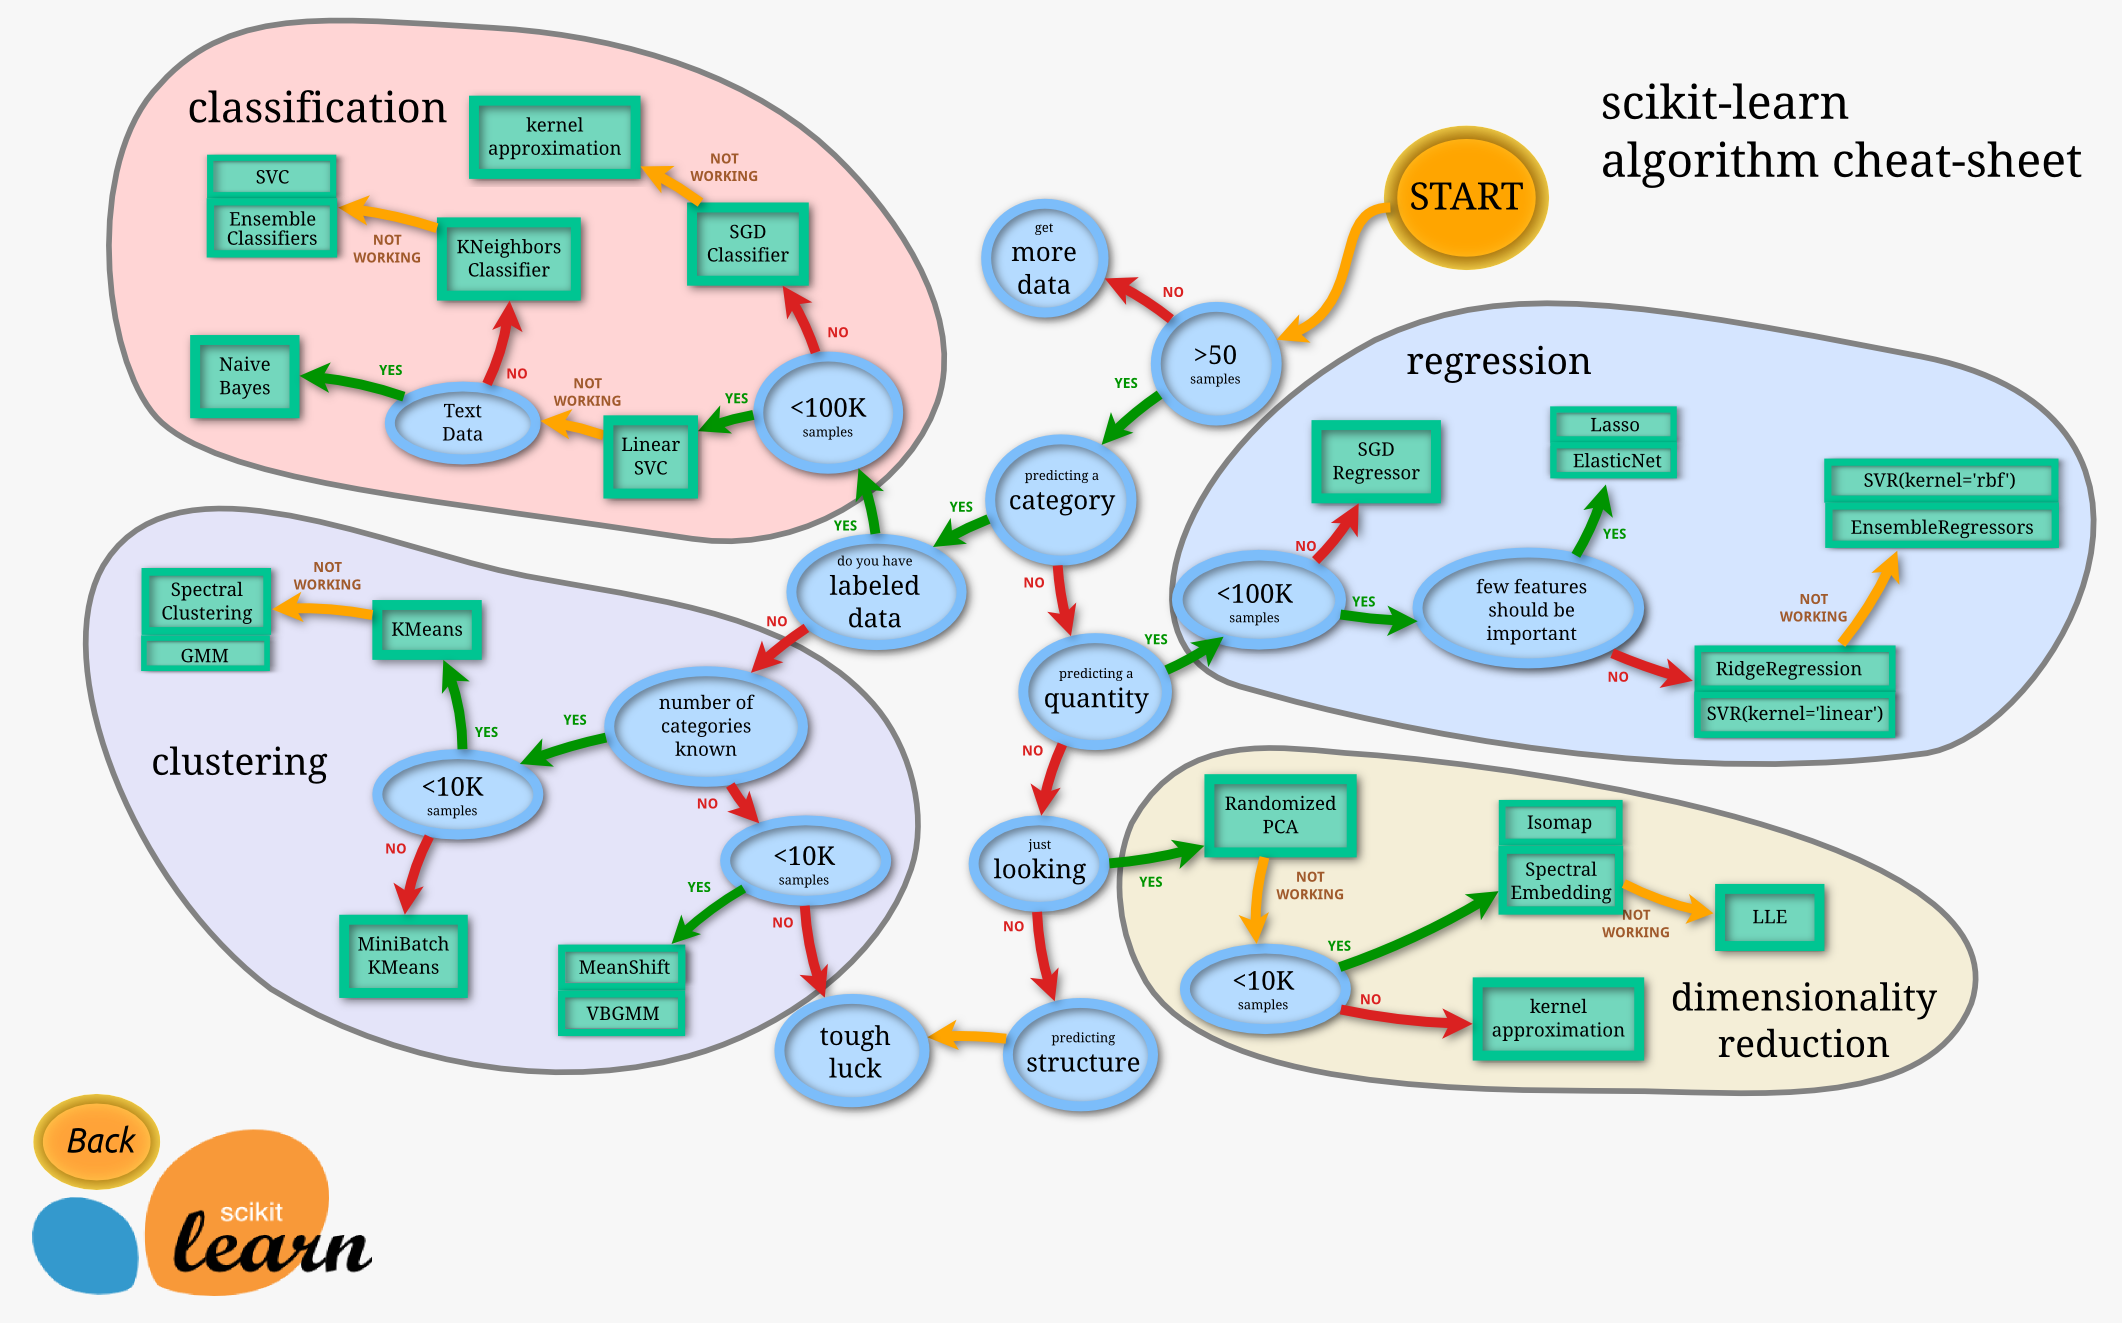
3.1 Scikit-Learn
python을 대표하는 머신러닝 라이브러이다. Scikit-Learn이 시행할 수 있는 여러 가지 데이터 전처리 도구 및 알고리즘은 지도 학습, 비지도 학습, 데이터 평가 등 기계 학습의 다양한 분야를 망라하고 있다.
3.2 주요 기능
분류: 로지스틱 회귀, 결정 트리, 서포트 벡터 머신(SVM)
회귀: 선형 회귀, 릿지 회귀 등
군집화: k-평균 군집화, 계층적 군집화 등
차원 축소: 주성분 분석(PCA), t-분산 확률적 이웃 내재화(t-SNE) 등
전처리: 데이터 정규화, 스케일링, 인코딩 등
3.3 장점
-
매우 다양한 전처리 도구와 알고리즘을 제공하고 있어 머신러닝 기법을 배우는 데 적합하다.
-예제와 사용 설명서가 잘 되어있어 참고하여 코드를 작성하기 용이하다. -
데이터 분석을 위한 간단하고 효율적인 도구를 제공한다.
-간단하고 직관적인 API를 제공하므로 다양한 수준의 전문 지식을 가진 사용자가 접근 가능하다.
-fit(), transform(), predict() 등 체계적이고 일관된 분석 및 학습모형 운용 체계를 갖추고 있다.
-다른 많은 패키지도 scikit-learn과 동일한 체계를 제공하여 유사한 프레임에서 사용이 가능하다. -
NumPy, Pandas, SciPy 및 matplotlib를 기반으로 구축되어 있어 다른 파이썬 패키지와 함께 사용하기 용이하다.
-NumPy: 다차원 배열을 위한 기본 패키지
-Pandas: 데이터프레임을 위한 기본 패키지
-SciPy: 과학 계산용 함수를 모아놓은 패키지
-matplotlib: 데이터 시각화를 위한 패키지
3.4 단점
하지만 딥러닝, 강화학습, 시계열 모형에는 매우 약하고 최근 개발된 대용량을 위한 데이터프레임인 Polars와 같은 라이브러리와는 연동이 잘 안 된다는 단점이 있다.
4. 스케일링
4.1 Scikit-Learn Preprocessing
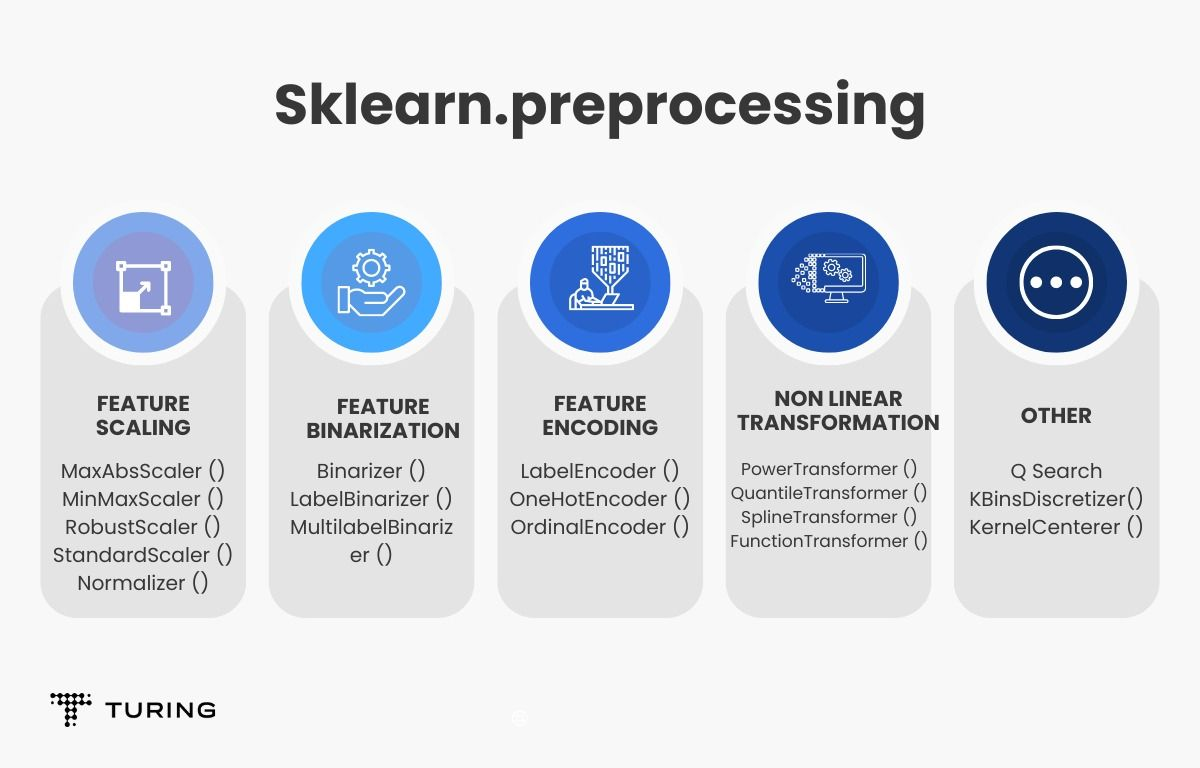
- Scikit-learn의 전처리 기능은 크게 4가지로 나눌 수 있다.
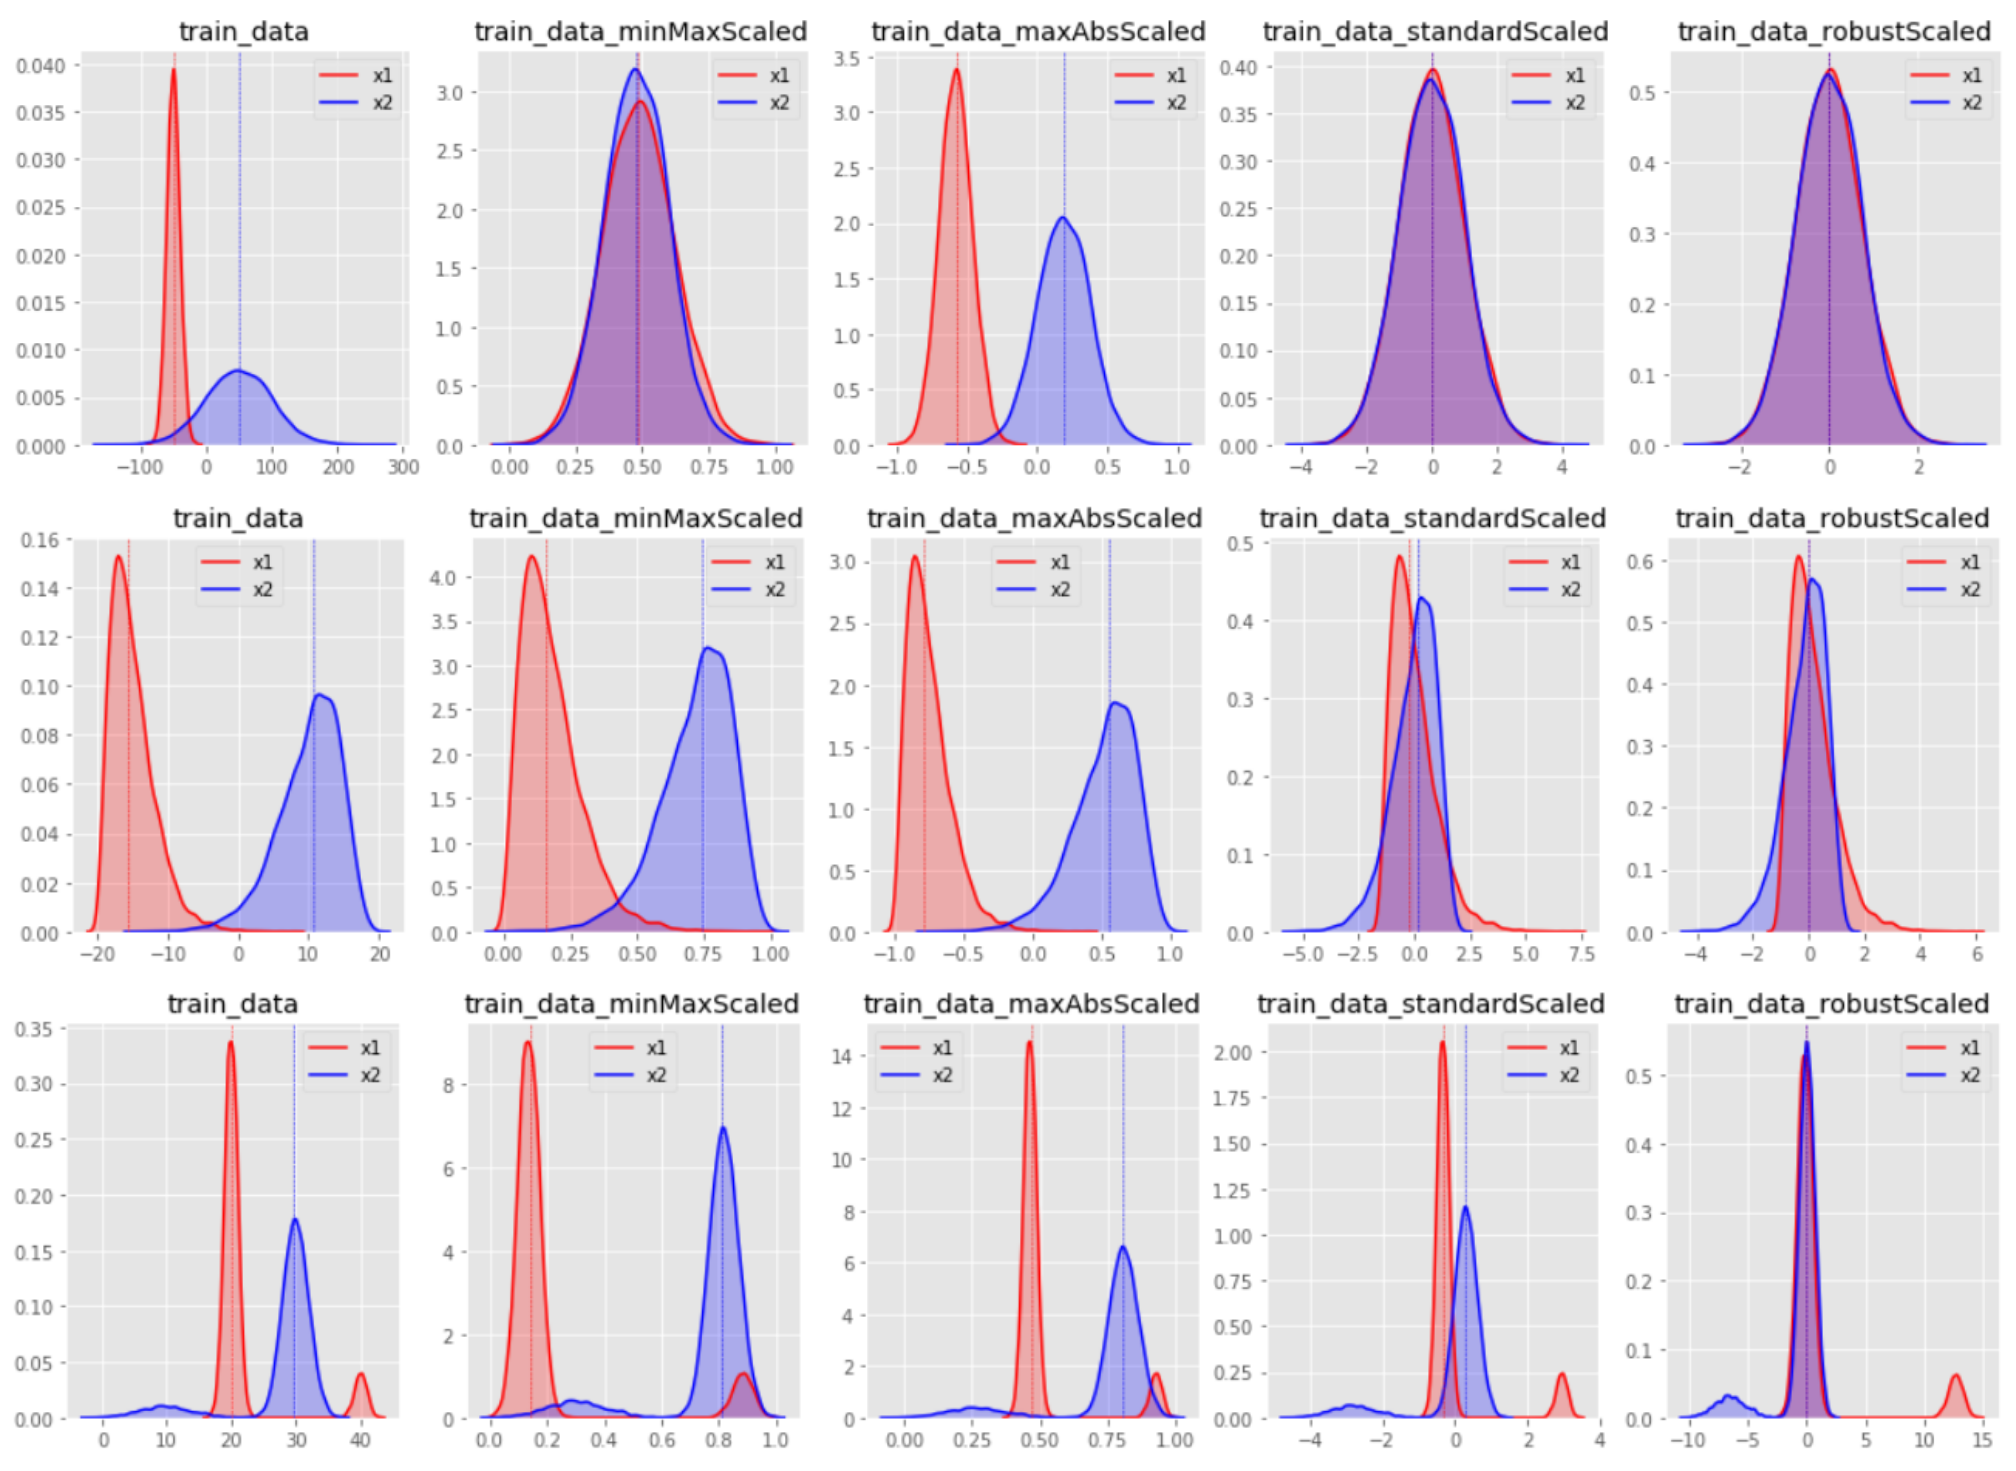
-스케일링(scaling): 서로 다른 변수의 값 범위를 선형변환을 통하여 일정한 수준으로 맞추는 것으로 표준화, 정규화, 변환이 있음
-이진화(binarization): 연속적인 값을 0 또는 1로 나누는 것, 연속형 변수 → 이진형 변수
-인코딩(encodig): 범주형 값을 적절한 숫자형으로 변환하는 작업, 범주형 변수 → 수치형 변수
-변환(transformation): 데이터의 분포를 변환하여 정규성을 확보하는 것
4.2 스케일링의 필요성
- 독립변수(feature)별로 값의 변위가 다르면 종속변수(target)에 대한 영향이 독립변수의 변위에 따라 크게 달라지기 때문에 머신러닝 시 학습효과가 떨어지므로 스케일링이 필요하다.
- 다차원의 값들을 동일한 수준에서 비교 분석하기 용이하게 만들어 준다.
- 컴퓨터의 비트수로 인하여 다른 값으로 인식되는 오버플로우(overflow)나 언더플로우(underflow)를 방지한다.
- 최적화 과정에서의 안정성 및 수렴 속도를 향상한다.
- 특히 k-means 등 거리 기반의 모델에서는 스케일링이 매우 중요하다.
4.3 스케일링 절차
-
Scaler 객체를 이용한다.
-fit(): 주어진 데이터에 맞추어 학습한다. 데이터 변환을 위한 기준 정보 설정을 적용한다. (ex.최소값,최대값 등)
-transform(): Scaler 적용, fit()된 정보를 이용해 데이터를 변환한다.
-fit_transform() : fit()과 transform()을 한 번에 실행한다. -
훈련(training) 데이터와 평가(test) 데이터의 스케일링 변환 시 유의점
-훈련 데이터는 fit()과 transform() 모두 적용 가능하다.
-평가 데이터는 fit()은 필요없으므로 transform()만 적용해야 한다. 훈련 데이터로 fit()된 스케일링 기준 정보를 그대로 테스트에 적용해야하기 때문이다.
4.4 표준화
-
표준화를 하면 평균은 0, 분산과 표준편차는 1이 되므로 데이터의 분포가 단순화되어 독립변수간 데이터 수준의 비교가 용이하다.
-
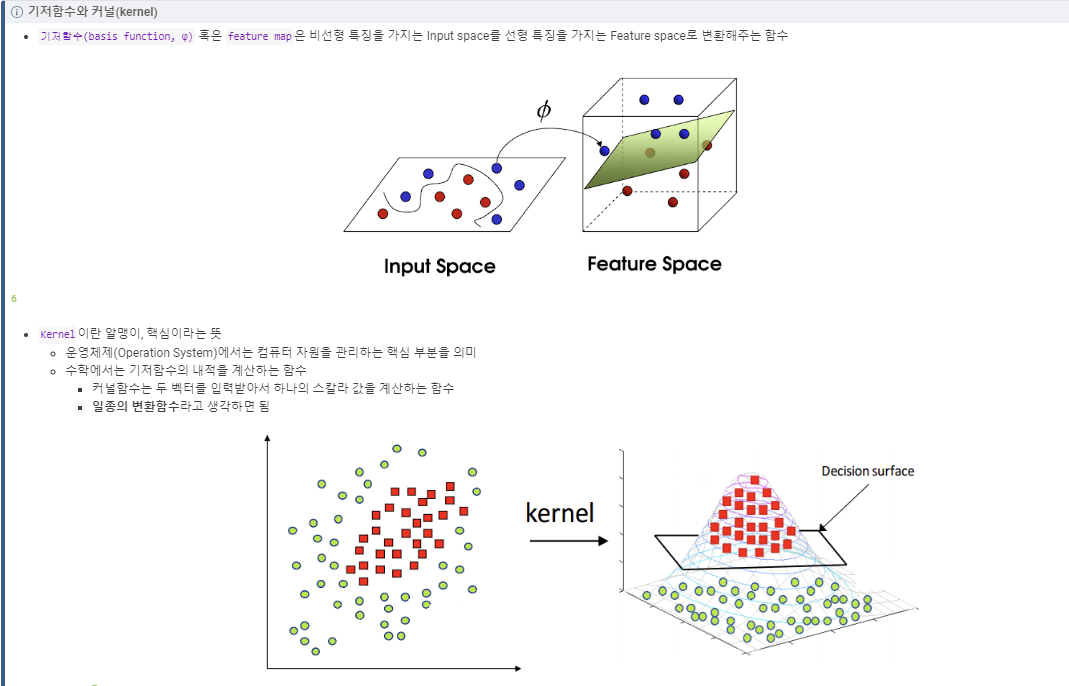
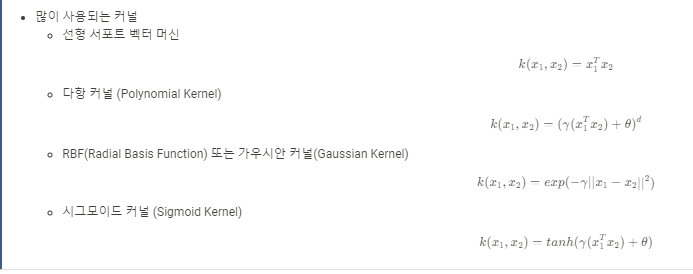
RBF 커널(가우시안 방사 기저함수)을 이용하는 서포트 벡터 머신, 선형회귀, 로지스틱 회귀는 데이터가 정규분포를 가지고 있다고 가정하고 구현되므로 표준화를 하면 좋다.
-
표준화는 이상치에 민감하며, 분류보다는 회귀에 유용하다.
-
기본
import pandas as pd
import seaborn as sns

pd.set_option('display.float_format', lambda x: f'{x:.4f}')
iris = sns.load_dataset('iris')
iris = iris.select_dtypes(exclude='object')
iris.describe()
sns.jointplot(data=iris, x='petal_length', y='petal_width', kind='reg')

from sklearn.preprocessing import StandardScaler, RobustScaler

standard_scaler = StandardScaler()
robust_scaler = RobustScaler()
iris_standard = pd.DataFrame(standard_scaler.fit_transform(iris), columns=iris.columns)
iris_robust = pd.DataFrame(robust_scaler.fit_transform(iris), columns=iris.columns)
print('Standard Scaled: \n', iris_standard.describe())
print()
print('Robust Scaled: \n', iris_robust.describe())

import seaborn as sns
import patchworklib as pw
pw.overwrite_axisgrid()

g1 = sns.jointplot(data=iris_standard, x='petal_length', y='petal_width', kind='reg')
g1 = pw.load_seaborngrid(g1)
g1.set_suptitle("Standard Scaled")
g2 = sns.jointplot(data=iris_robust, x='petal_length', y='petal_width', kind='reg')
g2 = pw.load_seaborngrid(g2)
g2.set_suptitle("Robust Scaled")
g12 = (g1|g2)
g12- 학습
#데이터 로드
import pandas as pd
import seaborn as sns

# 소수점 4째자리 이하에서 반올림 설정
pd.set_option('display.float_format', lambda x: f'{x:.4f}')

# iris 데이터 로드
ii = sns.load_dataset('iris')

# iris의 수치형 변수만 선택(문자형 제외)
ii = ii.select_dtypes(exclude='object')

# iris의 기술통계량을 확인
ii.describe()

# sepal_lengh와 petal_length의 jointplot을 그림
# 조인트 플롯 -> 두 수치형 변수 간의 관계 연구 가능
sns.jointplot(data=ii, x='petal_length', y='petal_width', kind='reg')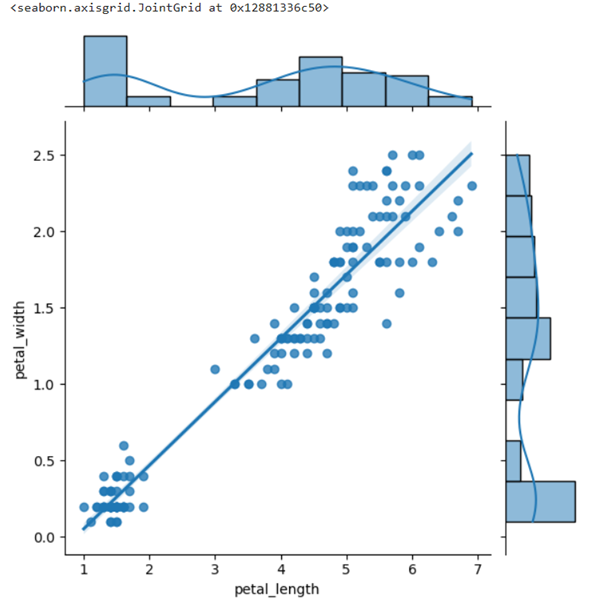
#표준화
from sklearn.preprocessing import StandardScaler, RobustScaler

# Scaler 객체 생성
#StandardScaler(): 기본 스케일러, 평균과 표준편차 사용
#RobustScaler(): 중앙값과 IQR(Q3-Q1)을 사용. 이상치의 영향을 최소화
standard_scaler = StandardScaler()
robust_scaler = RobustScaler()

# 데이터 변환, 각각 (평균=0, 표준편차=1) (중앙값=0, IQR=1)
ii_standard = pd.DataFrame(standard_scaler.fit_transform(ii), columns=ii.columns)
ii_robust = pd.DataFrame(robust_scaler.fit_transform(ii), columns=ii.columns)

# 결과 출력
print('Standard Scaled: \n', ii_standard.describe())
print()
print('Robust Scaled: \n', ii_robust.describe())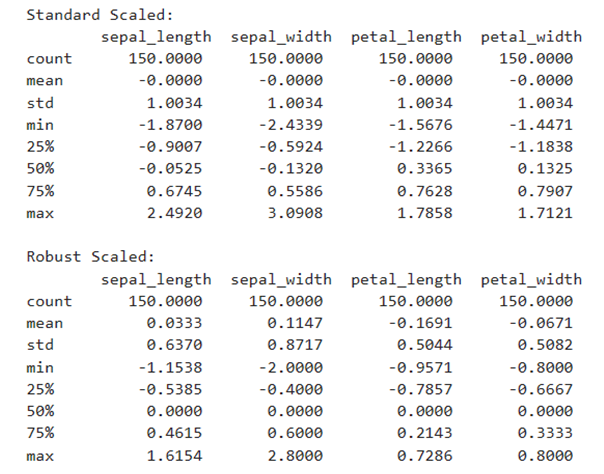
# 그래프로 확인
# seaborn의 jointplot은 figure의 axes를 지정할 수 없어 subplot을 그리기가 어려움
# patchworklib 패키지를 사용하여 subplot을 그림
import seaborn as sns
import patchworklib as pw
pw.overwrite_axisgrid()

# 첫번째 그래프
g1 = sns.jointplot(data=ii_standard, x='petal_length', y='petal_width', kind='reg')
g1 = pw.load_seaborngrid(g1)
g1.set_suptitle("Standard Scaled")

# 두번째 그래프
g2 = sns.jointplot(data=ii_robust, x='petal_length', y='petal_width', kind='reg')
g2 = pw.load_seaborngrid(g2)
g2.set_suptitle("Robust Scaled")

# 그래프 합치기
g12 = (g1|g2)
g12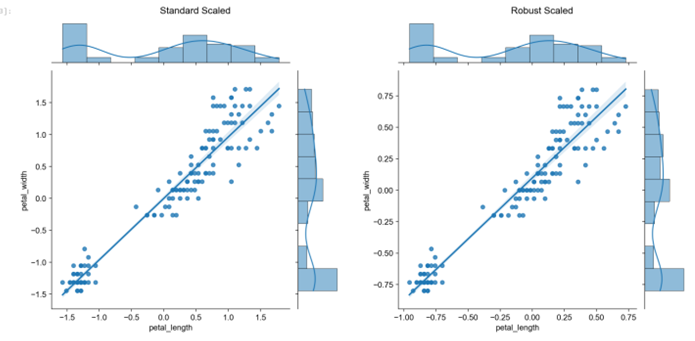
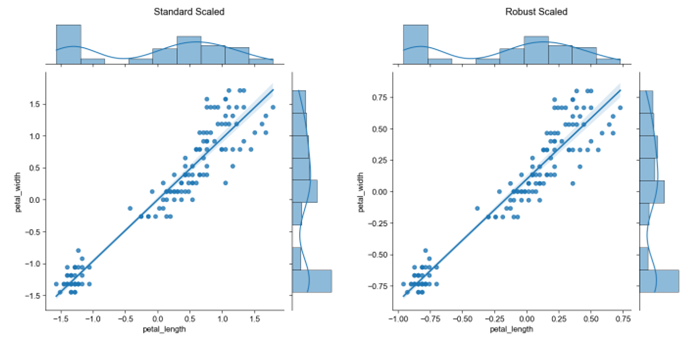
실행 결과 정리 -> iris 데이터의 수치형 변수만을 골라서 변수 간의 관계에 대하여 시각화 하였다. 그리고 두 스케일러를 사용하여 데이터를 변환한 다음 시각화를 하였다.
4.5 정규화
-
정규화 → 규격화(특정 범위(주로 [0,1]) 로 스케일링)
-
기본
from sklearn.preprocessing import MinMaxScaler, MaxAbsScaler

minmax_scaler = MinMaxScaler()
maxabs_scaler = MaxAbsScaler()
iris_minmax = pd.DataFrame(minmax_scaler.fit_transform(iris), columns=iris.columns)
iris_maxabs = pd.DataFrame(maxabs_scaler.fit_transform(iris), columns=iris.columns)
print('MinMax Scaled: \n', iris_minmax.describe())
print()
print('MaxAbs Scaled: \n', iris_maxabs.describe())

g3 = sns.jointplot(data=iris_minmax, x='petal_length', y='petal_width', kind='reg')
g3 = pw.load_seaborngrid(g3)
g3.set_suptitle("MinMax Scaled")
g4 = sns.jointplot(data=iris_maxabs, x='petal_length', y='petal_width', kind='reg')
g4 = pw.load_seaborngrid(g4)
g4.set_suptitle("MaxAbs Scaled")
g34 = (g3|g4)
g34- 학습
from sklearn.preprocessing import MinMaxScaler, MaxAbsScaler

# Scaler 객체 생성
# MinMaxScaler(): 범위가 [0,1]이 되도록 스케일링
# MaxAbsScaler(): 양수는 [0,1], 음수는 [-1,0], 양수&음수는 [-1,1]이 되도록 스케일링
minmax_scaler = MinMaxScaler()
maxabs_scaler = MaxAbsScaler()

# 데이터 변환 각각 [0,1] [0,1]로
ii_minmax = pd.DataFrame(minmax_scaler.fit_transform(ii), columns=ii.columns)
ii_maxabs = pd.DataFrame(maxabs_scaler.fit_transform(ii), columns=ii.columns)

# 결과 출력
print('MinMax Scaled: \n', ii_minmax.describe())
print()
print('MaxAbs Scaled: \n', ii_maxabs.describe())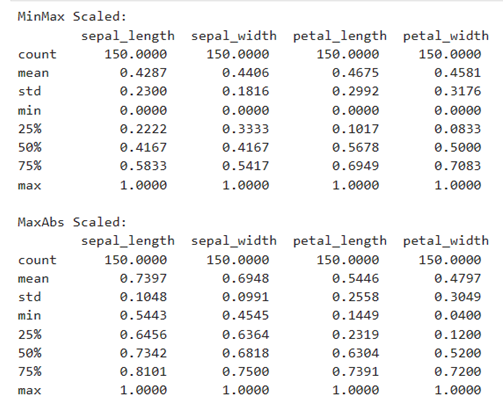
# 세번째 그래프
g3 = sns.jointplot(data=ii_minmax, x='petal_length', y='petal_width', kind='reg')
g3 = pw.load_seaborngrid(g3)
g3.set_suptitle("MinMax Scaled")

# 네번째 그래프
g4 = sns.jointplot(data=ii_maxabs, x='petal_length', y='petal_width', kind='reg')
g4 = pw.load_seaborngrid(g4)
g4.set_suptitle("MaxAbs Scaled")

# 그래프 합치기
g34 = (g3|g4)
g34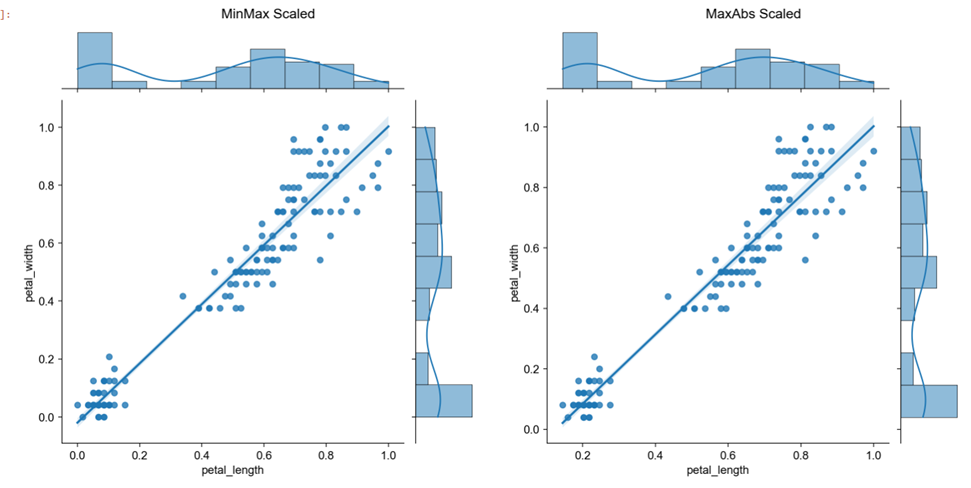
실행 결과 정리 -> 표준화 때와 마찬가지로 두 스케일러를 가지고 그래프로 시각화 하여 두 변수 사이의 관계를 나타냈다.
4.6 변환
-
변환(특정한 분포나 모양을 따르도록 스케일링)
-
기본
import numpy as np
from sklearn.preprocessing import PowerTransformer, Normalizer

power_scaler = PowerTransformer()
normal_scaler = Normalizer()
iris_power = pd.DataFrame(power_scaler.fit_transform(iris), columns=iris.columns)
iris_normal = pd.DataFrame(normal_scaler.fit_transform(iris), columns=iris.columns)
print('PowerTranformer Scaled: \n', iris_power.describe())
print()
print('Normalizer Scaled: \n', iris_normal.describe())
print('Euclidian Distance from 0: \n', np.linalg.norm(iris_normal, axis=1))

g5 = sns.jointplot(data=iris_power, x='petal_length', y='petal_width', kind='reg')
g5 = pw.load_seaborngrid(g5)
g5.set_suptitle("PowerTransformer Scaled")
g6 = sns.jointplot(data=iris_normal, x='petal_length', y='petal_width', kind='reg')
g6 = pw.load_seaborngrid(g6)
g6.set_suptitle("Normalizer Scaled")
g56 = (g5|g6)
g56

from sklearn.preprocessing import QuantileTransformer

gaussian_scaler = QuantileTransformer(output_distribution='normal')
uniform_scaler = QuantileTransformer(output_distribution='uniform')
iris_gaussian = pd.DataFrame(gaussian_scaler.fit_transform(iris), columns=iris.columns)
iris_uniform = pd.DataFrame(uniform_scaler.fit_transform(iris), columns=iris.columns)
print('QuantileTranformer_Gaussian Scaled: \n', iris_gaussian.describe())
print()
print('QuantileTranformer_Uniform Scaled: \n', iris_uniform.describe())

g7 = sns.jointplot(data=iris_gaussian, x='petal_length', y='petal_width', kind='reg')
g7 = pw.load_seaborngrid(g7)
g7.set_suptitle("QuantileTranformer_Gaussian Scaled")
g8 = sns.jointplot(data=iris_uniform, x='petal_length', y='petal_width', kind='reg')
g8 = pw.load_seaborngrid(g8)
g8.set_suptitle("QuantileTranformer_Uniform Scaled")
g78 = (g7|g8)
g78
(g1|g2|g3|g4)/(g5|g6|g7|g8)- 학습
import numpy as np
from sklearn.preprocessing import PowerTransformer, Normalizer

# Scaler 객체 생성
# PowerTransformer(): 정규분포화(정규성 변환)(Box-Cox 변환, Yeo-Johnson 변환)
# Normalizer(): 한 행의 모든 피처들 사이의 유클리드 거리가 1이 되도록 변환
power_scaler = PowerTransformer()
normal_scaler = Normalizer()

# 데이터 변환 각각 (평균=0, 표준편차=1) (각 행의 벡터 크기 1)
ii_power = pd.DataFrame(power_scaler.fit_transform(ii), columns=ii.columns)
ii_normal = pd.DataFrame(normal_scaler.fit_transform(ii), columns=ii.columns)

# 결과 출력
print('PowerTranformer Scaled: \n', ii_power.describe())
print()
print('Normalizer Scaled: \n', ii_normal.describe())
print('Euclidian Distance from 0: \n', np.linalg.norm(ii_normal, axis=1))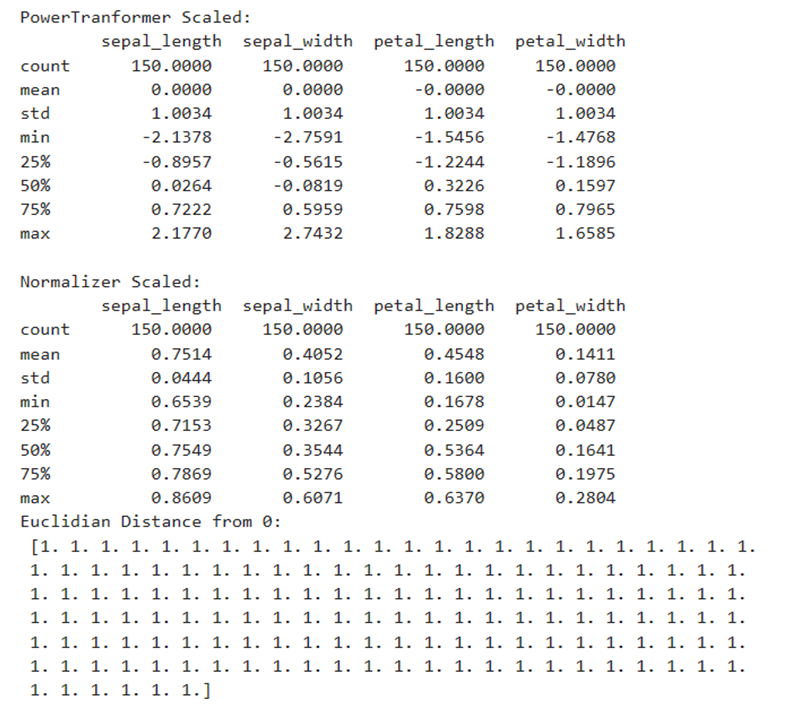
# 다섯번째 그래프
g5 = sns.jointplot(data=ii_power, x='petal_length', y='petal_width', kind='reg')
g5 = pw.load_seaborngrid(g5)
g5.set_suptitle("PowerTransformer Scaled")

# 여섯번째 그래프
g6 = sns.jointplot(data=ii_normal, x='petal_length', y='petal_width', kind='reg')
g6 = pw.load_seaborngrid(g6)
g6.set_suptitle("Normalizer Scaled")

# 그래프 합치기
g56 = (g5|g6)
g56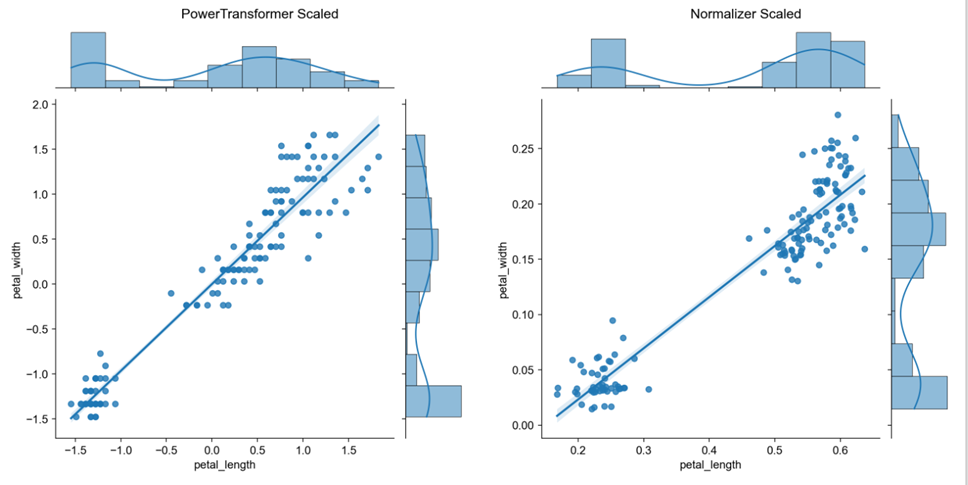
from sklearn.preprocessing import QuantileTransformer

# Scaler 객체 생성
# QuantileTransformer(): 균일(Uniform)분포 또는 정규(Gaussian)분포로 변환
gaussian_scaler = QuantileTransformer(output_distribution='normal')
uniform_scaler = QuantileTransformer(output_distribution='uniform')

# 데이터 변환
ii_gaussian = pd.DataFrame(gaussian_scaler.fit_transform(ii), columns=ii.columns)
ii_uniform = pd.DataFrame(uniform_scaler.fit_transform(ii), columns=ii.columns)

# 결과 출력
print('QuantileTranformer_Gaussian Scaled: \n', ii_gaussian.describe())
print()
print('QuantileTranformer_Uniform Scaled: \n', ii_uniform.describe())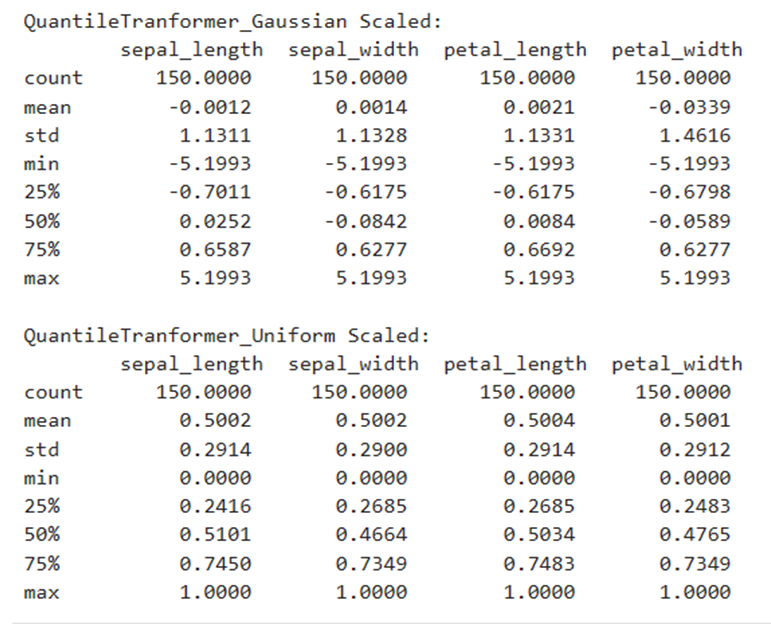
# 일곱번째 그래프
g7 = sns.jointplot(data=ii_gaussian, x='petal_length', y='petal_width', kind='reg')
g7 = pw.load_seaborngrid(g7)
g7.set_suptitle("QuantileTranformer_Gaussian Scaled")

# 여덟번째 그래프
g8 = sns.jointplot(data=ii_uniform, x='petal_length', y='petal_width', kind='reg')
g8 = pw.load_seaborngrid(g8)
g8.set_suptitle("QuantileTranformer_Uniform Scaled")

# 그래프 합치기
g78 = (g7|g8)
g78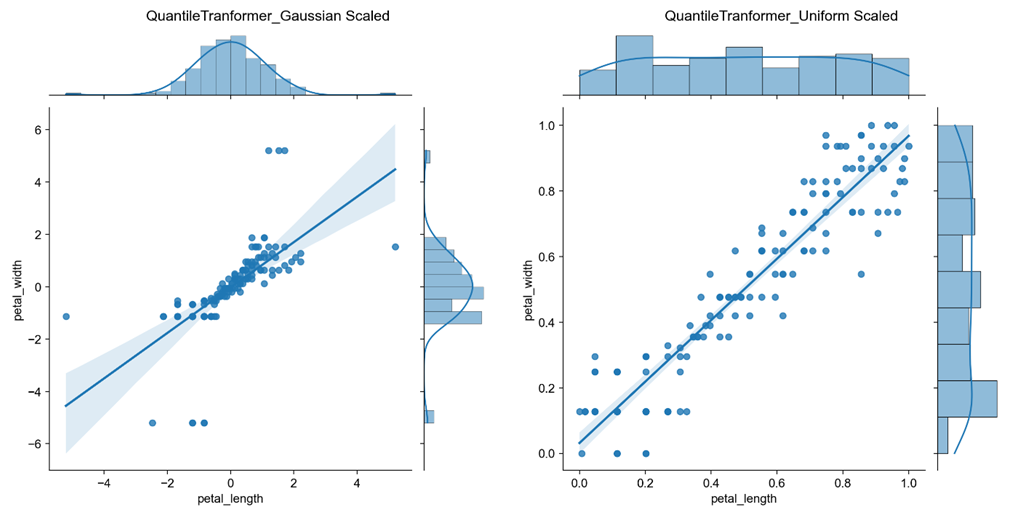
# 모든 그래프 합치기
(g1|g2|g3|g4)/(g5|g6|g7|g8)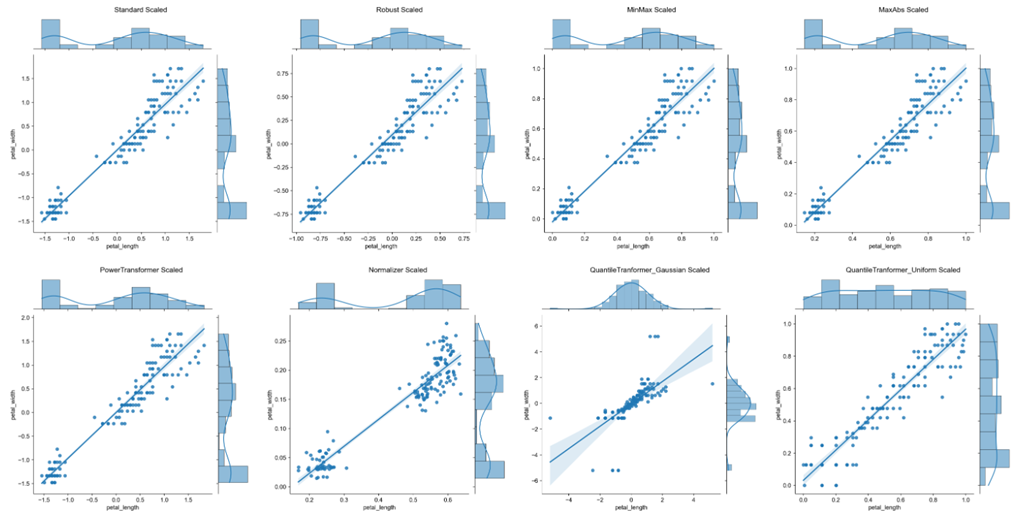
실행 결과 정리 -> 마찬가지로 세 스케일러를 통해 데이터를 변환한 후 그래프로 시각화하여 변수간 관계를 나타냈다.
- 응용
import pandas as pd
import numpy as np

df = pd.DataFrame({'x1' : np.arange(11), 'x2' : np.arange(11) ** 2})
from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()
df_std = scaler.fit_transform(df)

pd.DataFrame(df_std, columns = ['x1_std', 'x2_std'])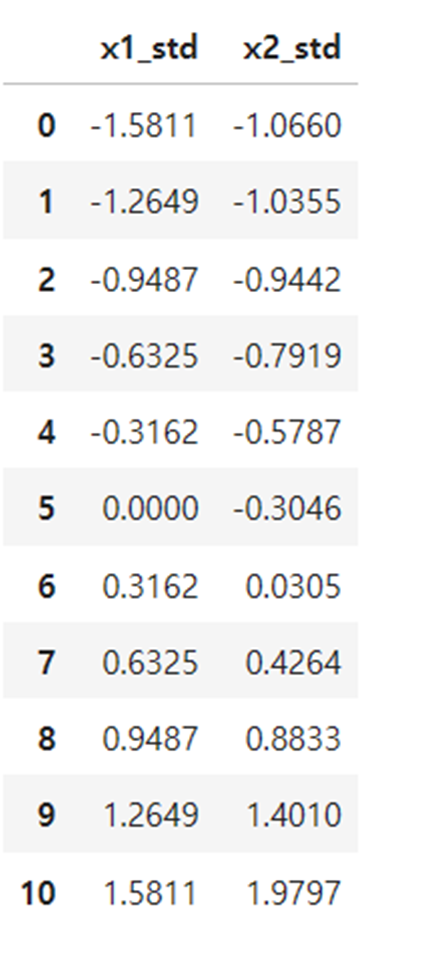
import pandas as pd
import numpy as np

df = pd.DataFrame({'x1' : np.arange(11), 'x2' : np.arange(11) ** 2})
from sklearn.preprocessing import RobustScaler

scaler = RobustScaler()
df_std = scaler.fit_transform(df)

pd.DataFrame(df_std, columns = ['x1_std', 'x2_std'])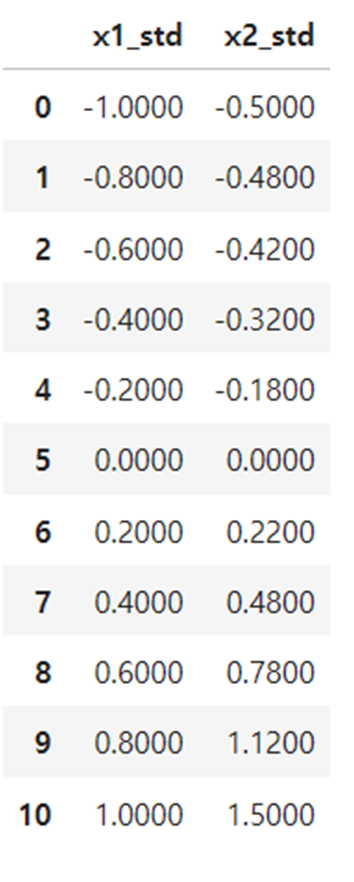
실행 결과 정리 -> 간단한 데이터셋(x, x^2)에 대하여 StandardScaler와 RobustScaler를 적용하여 새로운 데이터셋으로 나타내었다. 확실히 후자가 이상치의 영향을 덜 받는다는 것이 납득이 간다.