데이터 전처리 프로젝트
1. 서론
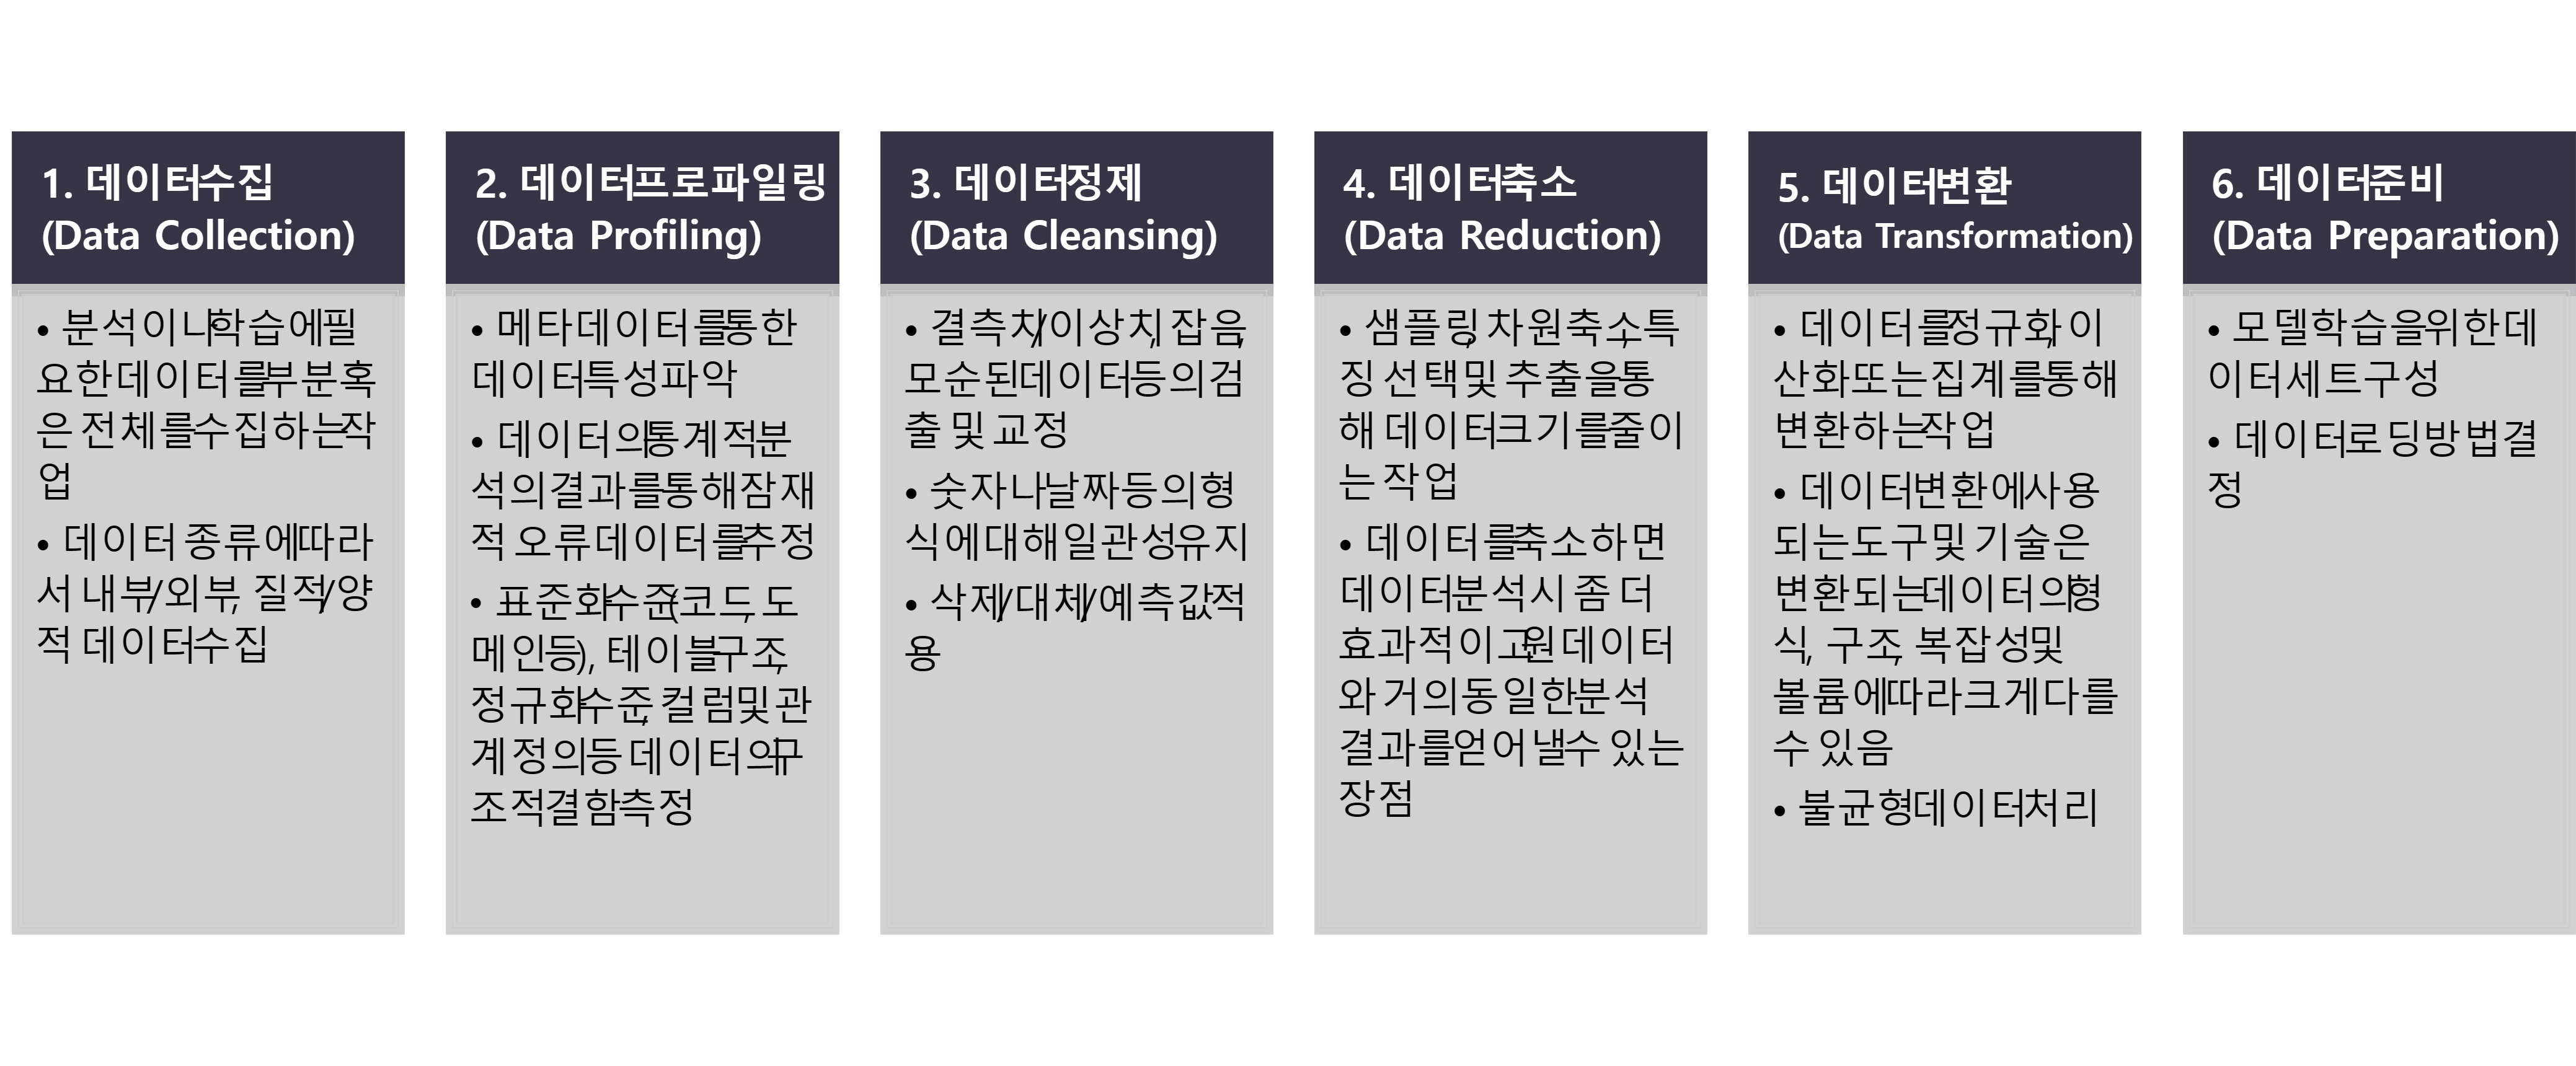
데이터 전처리는 데이터를 분석하기 전에 적합한 형태로 가공하는 과정이다. 데이터 전처리는 매우 중요한 과정으로 전체 프로세스의 80% 정도를 차지한다. 특히, 머신러닝의 학습을 위해서 학습이 용이한 형태로 가공이 필요하다. 데이터 전처리는 보통 데이터 수집 -> 데이터 프로파일링 -> 데이터 정제 -> 데이터 축소 -> 데이터 변환 -> 데이터 준비의 과정을 거친다.
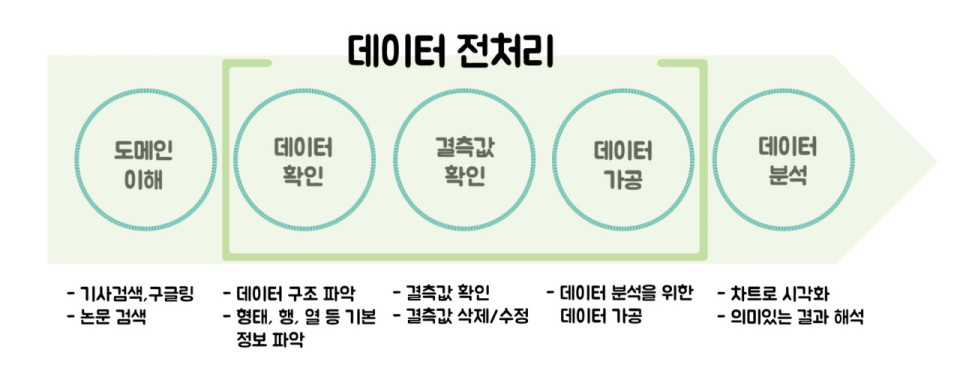
최초에 수집된 데이터는 다양한 요인에 의해 분석을 방해하는 요소가 존재하기 마련이다. 그렇기 때문에 데이터의 잘못된 분석 결과를 막기 위해서 데이터 전처리는 필수적이다. 하지만 데이터 전처리 과정을 이해하는 것은 아직 나에게는 매우 어려운 일이다. 통계적인 지식은 물론이고, 파이썬을 비롯한 다양한 프로그래밍 언어 또한 숙련되어야 한다. 거기다 많이 수행해봐야 한다는 점에서 포털에 존재하는 다양한 데이터들로 연습을 해봐야 한다. 따라서, 아직 나의 상태로는 데이터 전처리를 아무 도움 없이 하기에 매우 서툴고 어렵기 때문에 데이터 전처리 강의를 통해 배운 내용과 타인이 수행한 데이터 전처리 코드와 내용을 참고하여 해당 내용을 직접 연습해보고 진행 과정을 스스로 분석해봄으로써 데이터 전처리 과정과 목적을 다시 한번 깨닫고 부족한 코딩 실력에도 도움이 될 수 있게 연습하는 게 이번 프로젝트의 목적이다.
이번 데이터 전처리의 내용은 질병관리청의 지역사회 건강조사 사이트에서 진행된 설문조사 자료를 통해 진행된다. 공원과 건강 간의 상관관계를 분석해보고자 해당 데이터를 수집하여 데이터 전처리를 해보는 것이다. 해당 자료를 수집한 후 데이터 전처리 과정을 통해 정제 및 변환을 수행하고, 데이터를 시각화 해보는 순서로 프로젝트가 진행된다.
2. 본론
데이터 수집
- 2019년에 각 설문조사가 진행된 보건소정보와 세대유형
- 2019년에 진행된 설문조사에서 서울특별시에 해당하는 설문조사 (지역 사회 건강 조사 원시 자료)
- 2019년 서울시 주민등록인구(연령별구별) 통계 (이미 정제된 데이터)
- 2019년 서울시 자치구 재정자립도 (이미 정제된 데이터)
- 2019년 서울시 신고 등록 체육시설 통계 (이미 정제된 데이터)
- 2019년 서울시 공원 데이터 (이미 정제된 데이터)
데이터 정리
- 서울시의 각 자치구별 구분을 하기 위해서 1번 자료에서 보건소 정보를 추출하였다.
import pandas as pd

df = pd.read_excel('C:/Users/Public/zrzr/walk_with_me-main/raw/지역사회건강조사 2019년 원시자료 이용지침서 등'+\
                   '/지역사회건강조사 2019 원시자료 참고사항_보건소정보, 세대유형.xlsx',
                   header=3) # # 엑셀 파일이기 때문에 시작위치가 고정되지 않음. header를 사용하여 불러올 시작 위치 지정
df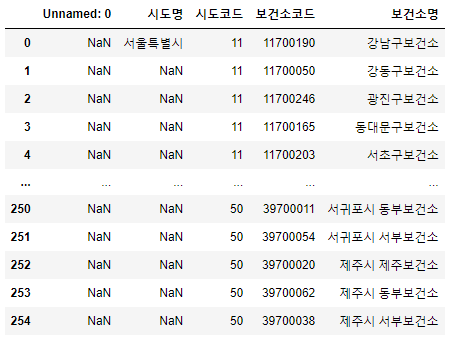
시도명이 서울특별시인 보건소코드와 보건소명을 데이터프레임으로 뽑는다. 다음에 다른 데이터프레임에 사용할 것이다.
data_pbhlth_code = df[df['시도코드'] == 11][['보건소코드','보건소명']]
# 시도코드 11 (서울특별시)인 보건소코드와 보건소명만 데이터프레임으로 입력

data_pbhlth_code["보건소명"] = data_pbhlth_code["보건소명"].str.replace('보건소', '', regex=True)
# 보건소명을 제외하고 자치구만 남기기 위해서 replace로 공백 대체

data_pbhlth_code.columns=['보건소코드','자치구'] # 보건소코드와 자치구를 column으로 지정

data_pbhlth_code.set_index('보건소코드',inplace=True)
# inplace = True는 원본 데이터프레임을 변경하는 것이다. (기본값은 False여서 해당 데이터프레임을 copy한 결과를 보여준다)
# 보건소코드를 인덱스로 지정하여 추후에 데이터프레임에서 인덱스로 연산
data_pbhlth_code.head(6)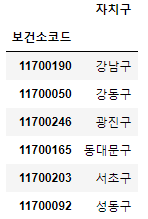
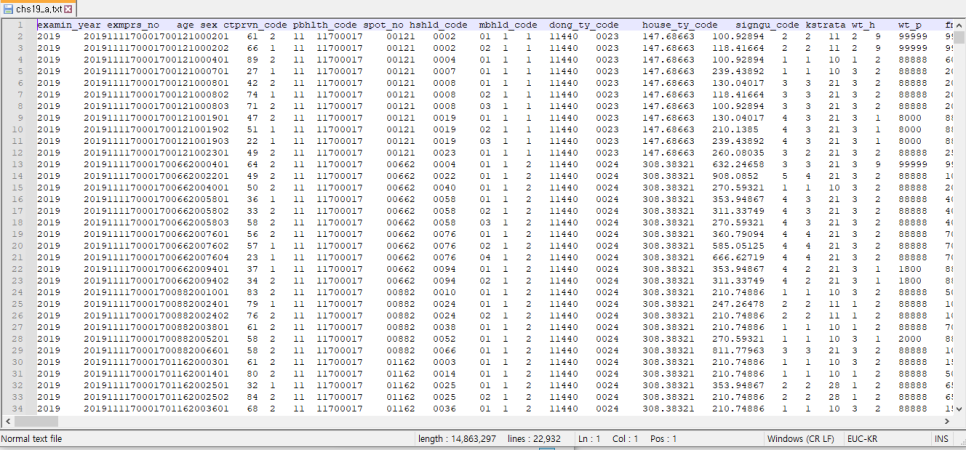
2. 위는 2번 자료에 대한 사진이다. 해당 자료에는 다양한 항목들이 존재한다. 서론에서의 목적에 맞게 공원이나 신체활동, 건강상태와 관련된 항목들을 추출한다. 추가로 소득도 관련이 있나 뽑아보았다. 그리하여 가져오기로 한 자료의 변수 명에 대하여 알아보자면 age는 만 나이, sex는 성별, pbhlthcode는 보건소번호, qoa_01z1는 주관적 건강수준, pha_04z1는 격렬한 신체활동 일수, pha_05z1는 격렬한 신체활동 시간(시), pha_06z1는 격렬한 신체활동 시간(분), pha_07z1는 중등도 신체활동 일수, pha_08z1는 중등도 신체활동 시간(시), pha_09z1는 중등도 신체활동 시간(분), phb_01z1는 걷기 실천 일수, phb_02z1는 걷기 실천 시간(시), phb_03z1는 걷기 실천 시간(분), obb_01z1는 체중조절 경험 여부, mta_01z1는 주관적 스트레스 수준, mtb_01z1는 우울감 경험 여부, qoc_07z1는 행복감 지수, ena_01d1는 사회환경동네 자연환경, ena01e1는 사회환경동네 생활환경, fma01z1는 가구원수, fma_12z1는 가구소득년월, fma13z1는 가구소득년금액, fma14z1는 가구소득월금액, fma_24z2는 조건부가구소득이다.
data_raw = pd.read_csv('C:/Users/Public/zrzr/walk_with_me-main/raw/지역사회건강조사 원시자료/chs19_a.txt',sep ='\t', encoding = 'cp949')
data_raw.head()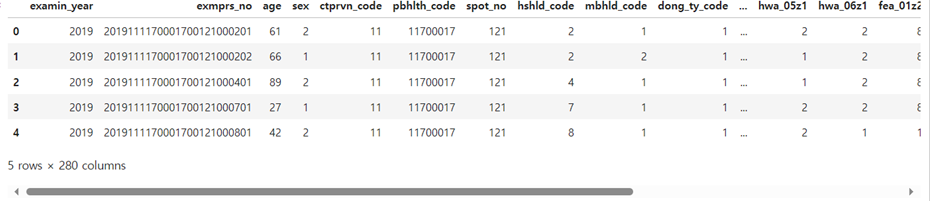
df_raw1 = data_raw[['age','sex','pbhlth_code','qoa_01z1',
                    'pha_04z1','pha_05z1','pha_06z1','pha_07z1','pha_08z1','pha_09z1',
                    'phb_01z1','phb_02z1','phb_03z1','obb_01z1','mta_01z1','mtb_01z1',
                    'qoc_07z1','ena_01d1','ena_01e1',
                    'fma_01z1','fma_12z1','fma_13z1','fma_14z1','fma_24z2']]

index = ['만나이','성별','보건소번호','주관적 건강수준',
         '격렬한 신체활동 일수','격렬한 신체활동 시간(시)','격렬한 신체활동 시간(분)',
         '중등도 신체활동 일수','중등도 신체활동 시간(시)','중등도 신체활동 시간(분)',
         '걷기 실천 일수','걷기 실천 시간(시)','걷기 실천 시간(분)',
         '체중조절 경험 여부','주관적 스트레스 수준','우울감 경험 여부','행복감 지수',
         '사회환경_동네 자연환경','사회환경_동네 생활환경',
         '가구원수','가구소득_년월','가구소득_년금액','가구소득_월금액','조건부가구소득']

df_raw1.columns = index # 각 항목에 들어있는 코드들을 이해할 수 있는 변수 라벨로 변경하여 column으로 설정
df_raw2 = df_raw1.copy() # SettingWithCopyWarning 방지

df_raw2['자치구'] = df_raw2['보건소번호'].map(data_pbhlth_code.to_dict()['자치구'])
# map을 이용하여 위에서 구한 보건소번호에 해당하는 자치구를 df_raq2에 추가
df_raw3 = df_raw2.drop(['보건소번호'],axis=1) # 더 이상 필요없는 보건소번호를 drop을 시킴
df_raw3.to_csv("C:/Users/Public/zrzr/walk_with_me-main/raw/지역사회건강조사 1차 전처리_2019.csv", mode='w',encoding = 'utf-8-sig')
df_raw3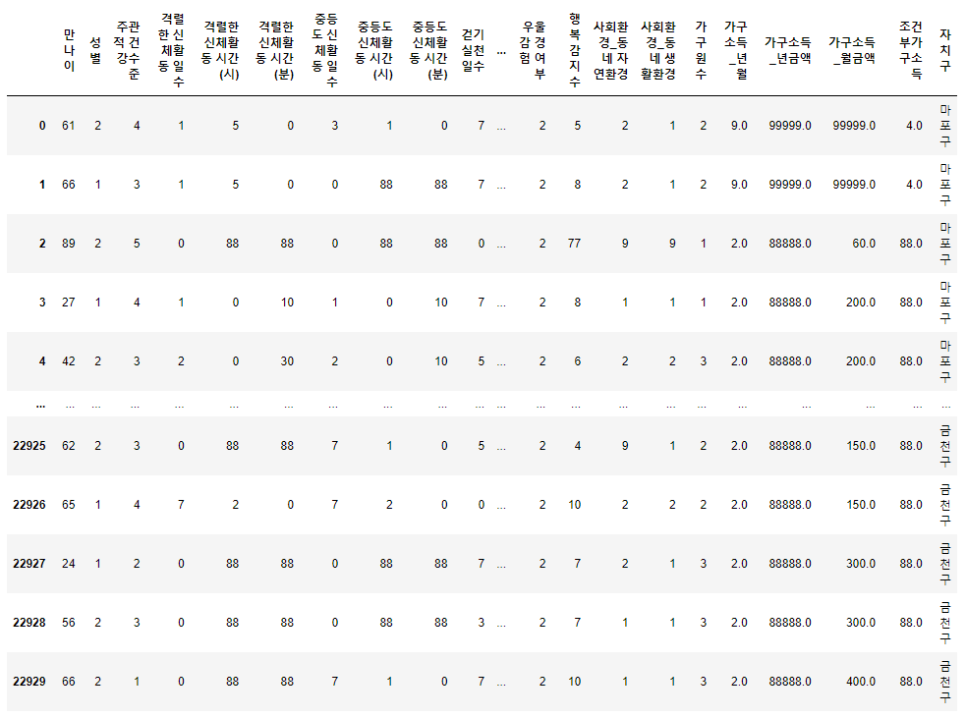
이 다음부터 사용할 데이터는 지역사회건강조사 1차 전처리_2019.csv 파일이다.
범주형 데이터 전처리
- 주관적 건강수준이나 행복감지수 같은 범주형 데이터는 결측치를 제거하고, 전체와 각 자치구 별로 나누었다. 그리고 그 안에서도 나이대별과 성별로 나눠서 인덱스를 지정하였다. (코드 진행이 비슷)
- 결측치에 해당하는 모름이나 응답거부에 해당하는 데이터들을 삭제하였다.(예-행복감지수에서 77은 응답거부, 99는 모름이다.)
- 행복감지수 전처리 수행
data_raw = pd.read_csv('C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 1차 전처리_2019.csv')

df = data_raw[['만나이','성별','행복감 지수','자치구']]

df_hi1=df[df['행복감 지수'] != 99] # 99는 모름
df_hi2=df_hi1[df_hi1['행복감 지수'] != 77] # 77은 응답거부

data_pbhlth_code = pd.read_excel('C:/Users/Public/zrzr/walk_with_me-main/raw/지역사회건강조사 2019년 원시자료 이용지침서 등/지역사회건강조사 2019 원시자료 참고사항_보건소정보, 세대유형.xlsx',header=3)
data_pbhlth_code = data_pbhlth_code[data_pbhlth_code['시도코드'] == 11][['보건소코드','보건소명']]
data_pbhlth_code["보건소명"] = data_pbhlth_code["보건소명"].str.replace('보건소', '', regex=True)
data_pbhlth_code.columns=['보건소코드','자치구']

list_region = list(data_pbhlth_code.to_dict()['자치구'].values()) + ['서울시'] # 전체 합에 해당하는 서울시 추가
list_region.reverse() # 서울시가 맨 위에 올라오도록 reverse 사용
list_region에는 서울시를 비롯한 각 자치구가 들어오게 된다. 그 다음 데이터들을 자치구끼리 묶고, 전체 데이터를 서울시로 묶는다.
list_df = []
for value in list_region:
    temp = df_hi2['자치구'] == value
    # list_region에 들어있는 자치구와 df_hi2에 있는 자치구와 동일하면 temp에는 True과 들어가고, 같지 않으면 False

    list_df.append(df_hi2[temp]) # 그래서 temp가 true이면 value와 동일한 자치구를 가진 데이터프레임을 리스트에 넣는다

list_df[0] = df_hi2
# df_hi2에서 자치구 column에는 서울시가 없기 때문에 list_df[0]은 빈 데이터프레임이 들어있는데 여기에 전체 데이터를 넣어준다.
각 자치구별 데이터들을 연령별, 성별로 나눠서 하나의 데이터프레임으로 만든다.
list_age = ['19~200','19~44','45~64','65~74','75~200'] # 전체 / 19~44  45~64 / 65~74 / 75이상 으로 나누기 위해서 범위 설정
list_sex = ['계','남','여']
idx_sex = []
idx_age = []
idx_region = []
value_hi = []
# 크게 자치구 -> 연령대 -> 성별로 하위 인덱스를 만드식으로 작업하면서 계(전체)에 해당하는 값을 살리려고 함
for i, value1 in enumerate(list_region): # enumerate를 이용해 list_df의 인덱스와 자치구로 이용
    for j in list_age:
        for k in list_sex:
            temp = list_df[i][list_df[i]['만나이']>=int(j.split('~')[0])]
            temp1 = temp[temp['만나이'] <= int(j.split('~')[1])] # 연령대를 ~를 기준으로 이상, 이하로 데이터 처리

            # 이 부분은 위에 list_age에서 넘어오는 계 / 남 / 여를 구분해서 만들기 위해 아래와 같이 조건문 사용
            if k == '남':
                temp2 = temp1[temp1['성별'] == 1]
            elif k == '여':
                temp2 = temp1[temp1['성별'] == 2]
            else:
                temp2 = temp1

            # 행복감 지수는 범주형 데이터여서 value_counts()롤 각각의 값에 해당하는 데이터들의 갯수를 세어서 딕셔너리로 만듬
            temp3 = temp2['행복감 지수'].value_counts().to_dict()
            # 행복감 지수는 1부터 10까지 이루어져있지만, 설문조사상 해당하는 값이 없는 경우는 딕셔너리가 만들어지지 않음
            # 그래서 없는 값도 생성 후 0으로 넣어서 추후 전처리 작업 진행간에 오류 발생 방지
            for m in range(1,11):
                if m not in temp3:
                    temp3[m] = 0

            temp_sum = 0
            # 이 구간에서 없는 값은 오류가 발생할 수도 있어서 위에서 방지
            # 그리고 각 구간별 수와 값을 곱해서 계속해서 더한 후 나눠서, 전체 평균을 구함
            for n in range(1,11):
                temp_sum += temp3[n]*n
            value_hi.append(round(temp_sum / len(temp2['행복감 지수']),2))

            # 아래 작업은 멀티 인덱스를 생성하기 위해서 순서대로 idx 리스트에 해당하는 값을 삽입
            if j == '19~200':
                idx_age.append('계')
            elif j == '75~200':
                idx_age.append('75 이상')
            else:
                idx_age.append(j)
            idx_sex.append(k)
            idx_region.append(value1)

df_final = pd.DataFrame({'행복감 지수':value_hi, '지역':idx_region,'연령별':idx_age,'성별':idx_sex})

df_final = df_final.set_index(['지역','연령별','성별'])

df_final.to_csv("C:/Users/Public/zrzr/walk_with_me-main/raw/지역사회건강조사 (전처리된 데이터)_2019/지역사회건강조사 (행복감 지수)_2019.csv", mode='w',encoding = 'utf-8-sig')

df_final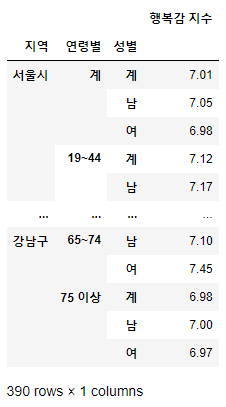
- 체중조절 경험 여부 전처리 수행
(9 -> 모름, 7 -> 응답거부)
import pandas as pd
import numpy as np

data_raw = pd.read_csv('C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 1차 전처리_2019.csv')

df = data_raw[['만나이','성별','체중조절 경험 여부','자치구']]

df_cw1=df[df['체중조절 경험 여부'] != 9]
df_cw2=df_cw1[df_cw1['체중조절 경험 여부'] != 7]
df_cw2['체중조절 경험 여부'].value_counts(normalize = True)
# 고유 값별 데이터 수를 나타낸다.
# normalize 옵션도 가능.

data_pbhlth_code = pd.read_excel('C:/Users/Public/zrzr/walk_with_me-main/raw/지역사회건강조사 2019년 원시자료 이용지침서 등/지역사회건강조사 2019 원시자료 참고사항_보건소정보, 세대유형.xlsx',header=3)
data_pbhlth_code = data_pbhlth_code[data_pbhlth_code['시도코드'] == 11][['보건소코드','보건소명']]
data_pbhlth_code["보건소명"] = data_pbhlth_code["보건소명"].str.replace('보건소', '', regex=True)
data_pbhlth_code.columns=['보건소코드','자치구']
list_region = list(data_pbhlth_code.to_dict()['자치구'].values()) + ['서울시']
list_region.reverse()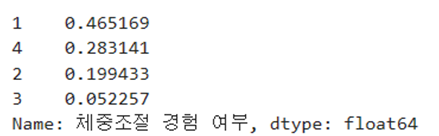
list_df = []
for value in list_region:
    temp = df_cw2['자치구'] == value
    list_df.append(df_cw2[temp])
list_df[0] = df_cw2

list_age = ['19~200','19~44','45~64','65~74','75~200']
list_sex = ['계','남','여']
idx_sex = []
idx_age = []
idx_region = []
value_cw = []
for i, value1 in enumerate(list_region):
    for j in list_age:
        for k in list_sex:
            temp = list_df[i][list_df[i]['만나이']>=int(j.split('~')[0])]
            temp1 = temp[temp['만나이'] <= int(j.split('~')[1])]
            if k == '남':
                temp2 = temp1[temp1['성별'] == 1]
            elif k == '여':
                temp2 = temp1[temp1['성별'] == 2]
            else:
                temp2 = temp1
            temp3 = temp2['체중조절 경험 여부'].value_counts(normalize = True).to_dict()
            if 4 not in temp3:
                temp3[4] = 0
            if 3 not in temp3:
                temp3[3] = 0
            value_cw.append(round(100 - (temp3[3]+temp3[4])*100,1)) # 위 조건으로 경험 여부(1,2,3,4)가 최종 형태처럼(한지 안 한지에 대한 비율 형태) 변함.

            if j == '19~200':
                idx_age.append('계')
            elif j == '75~200':
                idx_age.append('75 이상')
            else:
                idx_age.append(j)
            idx_sex.append(k)
            idx_region.append(value1)

df_final = pd.DataFrame({'체중조절 경험 여부':value_cw, '지역':idx_region,'연령별':idx_age,'성별':idx_sex})

df_final = df_final.set_index(['지역','연령별','성별'])

df_final

df_final.to_csv("C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 (체중조절)_2019.csv", mode='w',encoding = 'utf-8-sig')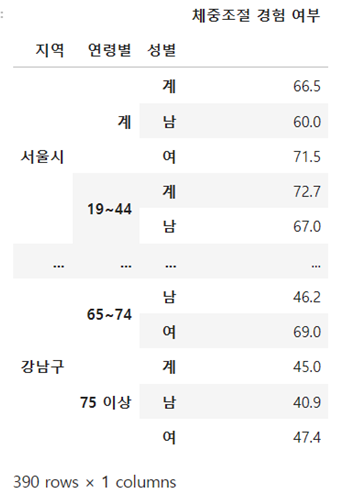
- 우울감 전처리 수행
(9 -> 모름, 7 -> 응답거부, 응답 -> 1 or 2)
import pandas as pd
import numpy as np

data_raw = pd.read_csv('C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 1차 전처리_2019.csv')

df = data_raw[['만나이','성별','우울감 경험 여부','자치구']]

df_dep1=df[df['우울감 경험 여부'] != 9]
df_dep2=df_dep1[df_dep1['우울감 경험 여부'] != 7]

data_pbhlth_code = pd.read_excel('C:/Users/Public/zrzr/walk_with_me-main/raw/지역사회건강조사 2019년 원시자료 이용지침서 등/지역사회건강조사 2019 원시자료 참고사항_보건소정보, 세대유형.xlsx',header=3)
data_pbhlth_code = data_pbhlth_code[data_pbhlth_code['시도코드'] == 11][['보건소코드','보건소명']]
data_pbhlth_code["보건소명"] = data_pbhlth_code["보건소명"].str.replace('보건소', '', regex=True)
data_pbhlth_code.columns=['보건소코드','자치구']
list_region = list(data_pbhlth_code.to_dict()['자치구'].values()) + ['서울시']
list_region.reverse()

list_df = []
for value in list_region:
    temp = df_dep2['자치구'] == value
    list_df.append(df_dep2[temp])
list_df[0] = df_dep2

list_age = ['19~200','19~44','45~64','65~74','75~200']
list_sex = ['계','남','여']
idx_sex = []
idx_age = []
idx_region = []
value_dep = []
for i, value1 in enumerate(list_region):
    for j in list_age:
        for k in list_sex:
            temp = list_df[i][list_df[i]['만나이']>=int(j.split('~')[0])]
            temp1 = temp[temp['만나이'] <= int(j.split('~')[1])]
            if k == '남':
                temp2 = temp1[temp1['성별'] == 1]
            elif k == '여':
                temp2 = temp1[temp1['성별'] == 2]
            else:
                temp2 = temp1
            value_dep.append(round(100 - temp2['우울감 경험 여부'].value_counts(normalize = True)[2]*100,1))
            if j == '19~200':
                idx_age.append('계')
            elif j == '75~200':
                idx_age.append('75 이상')
            else:
                idx_age.append(j)
            idx_sex.append(k)
            idx_region.append(value1)

df_final = pd.DataFrame({'우울감 경험률':value_dep, '지역':idx_region,'연령별':idx_age,'성별':idx_sex})

df_final = df_final.set_index(['지역','연령별','성별'])

df_final

df_final.to_csv("C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 (우울감)_2019.csv", mode='w',encoding = 'utf-8-sig')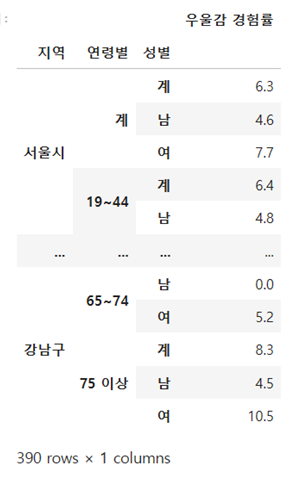
- 스트레스 전처리 수행 (9 -> 모름, 7 -> 응답거부)
import pandas as pd
import numpy as np

data_raw = pd.read_csv('C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 1차 전처리_2019.csv')

df = data_raw[['만나이','성별','주관적 스트레스 수준','자치구']]

df_sl1=df[df['주관적 스트레스 수준'] != 9]
df_sl2=df_sl1[df_sl1['주관적 스트레스 수준'] != 7]
df_sl2['주관적 스트레스 수준'].value_counts(normalize = True)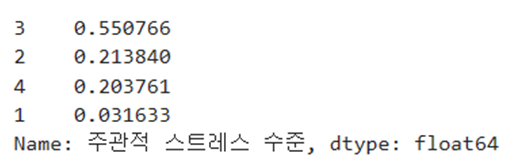
data_pbhlth_code = pd.read_excel('C:/Users/Public/zrzr/walk_with_me-main/raw/지역사회건강조사 2019년 원시자료 이용지침서 등/지역사회건강조사 2019 원시자료 참고사항_보건소정보, 세대유형.xlsx',header=3)
data_pbhlth_code = data_pbhlth_code[data_pbhlth_code['시도코드'] == 11][['보건소코드','보건소명']]
data_pbhlth_code["보건소명"] = data_pbhlth_code["보건소명"].str.replace('보건소', '', regex=True)
data_pbhlth_code.columns=['보건소코드','자치구']
list_region = list(data_pbhlth_code.to_dict()['자치구'].values()) + ['서울시']
list_region.reverse()

list_df = []
for value in list_region:
    temp = df_sl2['자치구'] == value
    list_df.append(df_sl2[temp])
list_df[0] = df_sl2

list_age = ['19~200','19~44','45~64','65~74','75~200']
list_sex = ['계','남','여']
idx_sex = []
idx_age = []
idx_region = []
value_hl = []
for i, value1 in enumerate(list_region):
    for j in list_age:
        for k in list_sex:
            temp = list_df[i][list_df[i]['만나이']>=int(j.split('~')[0])]
            temp1 = temp[temp['만나이'] <= int(j.split('~')[1])]
            if k == '남':
                temp2 = temp1[temp1['성별'] == 1]
            elif k == '여':
                temp2 = temp1[temp1['성별'] == 2]
            else:
                temp2 = temp1
            temp3 = temp2['주관적 스트레스 수준'].value_counts(normalize = True).to_dict()
            if 4 not in temp3:
                temp3[4] = 0
            if 1 not in temp3:
                temp3[1] = 0
            value_hl.append(round((temp3[1]+temp3[2])*100,1))

            if j == '19~200':
                idx_age.append('계')
            elif j == '75~200':
                idx_age.append('75 이상')
            else:
                idx_age.append(j)
            idx_sex.append(k)
            idx_region.append(value1)

df_final = pd.DataFrame({'주관적 스트레스 수준':value_hl, '지역':idx_region,'연령별':idx_age,'성별':idx_sex})

df_final = df_final.set_index(['지역','연령별','성별'])

df_final

df_final.to_csv("C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 (스트레스)_2019.csv", mode='w',encoding = 'utf-8-sig')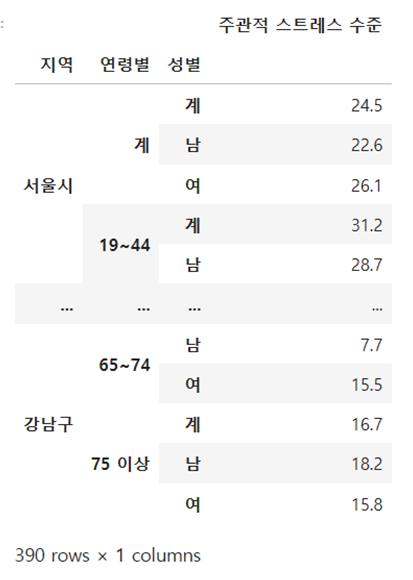
- 자연환경 전처리 수행 (9 -> 모름, 7 -> 응답거부)
import pandas as pd
import numpy as np

data_raw = pd.read_csv('C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 1차 전처리_2019.csv')

df = data_raw[['만나이','성별','사회환경_동네 자연환경','자치구']]

df_ne1=df[df['사회환경_동네 자연환경'] != 9]
df_ne2=df_ne1[df_ne1['사회환경_동네 자연환경'] != 7]

data_pbhlth_code = pd.read_excel('C:/Users/Public/zrzr/walk_with_me-main/raw/지역사회건강조사 2019년 원시자료 이용지침서 등/지역사회건강조사 2019 원시자료 참고사항_보건소정보, 세대유형.xlsx',header=3)
data_pbhlth_code = data_pbhlth_code[data_pbhlth_code['시도코드'] == 11][['보건소코드','보건소명']]
data_pbhlth_code["보건소명"] = data_pbhlth_code["보건소명"].str.replace('보건소', '', regex=True)
data_pbhlth_code.columns=['보건소코드','자치구']
list_region = list(data_pbhlth_code.to_dict()['자치구'].values()) + ['서울시']
list_region.reverse()

list_df = []
for value in list_region:
    temp = df_ne2['자치구'] == value
    list_df.append(df_ne2[temp])
list_df[0] = df_ne2

list_age = ['19~200','19~44','45~64','65~74','75~200']
list_sex = ['계','남','여']
idx_sex = []
idx_age = []
idx_region = []
value_ne = []
for i, value1 in enumerate(list_region):
    for j in list_age:
        for k in list_sex:
            temp = list_df[i][list_df[i]['만나이']>=int(j.split('~')[0])]
            temp1 = temp[temp['만나이'] <= int(j.split('~')[1])]
            if k == '남':
                temp2 = temp1[temp1['성별'] == 1]
            elif k == '여':
                temp2 = temp1[temp1['성별'] == 2]
            else:
                temp2 = temp1
            value_ne.append(round(temp2['사회환경_동네 자연환경'].value_counts(normalize = True)[1]*100,1))
            if j == '19~200':
                idx_age.append('계')
            elif j == '75~200':
                idx_age.append('75 이상')
            else:
                idx_age.append(j)
            idx_sex.append(k)
            idx_region.append(value1)

df_final = pd.DataFrame({'긍정적 태도율(자연환경)':value_ne, '지역':idx_region,'연령별':idx_age,'성별':idx_sex})

df_final = df_final.set_index(['지역','연령별','성별'])

df_final

df_final.to_csv("C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 (긍정적 태도율(자연환경))_2019.csv", mode='w',encoding = 'utf-8-sig')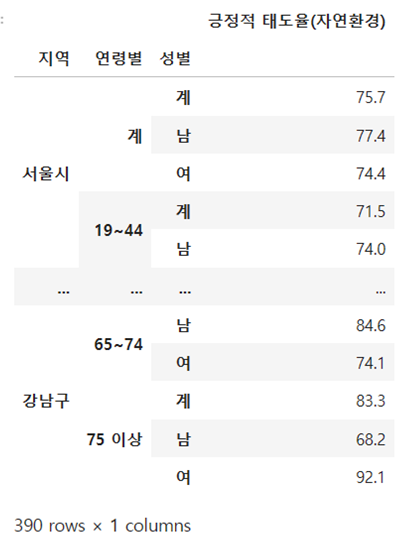
- 건강수준 전처리 수행 (9 -> 모름, 7 -> 응답거부)
import pandas as pd
import numpy as np

data_raw = pd.read_csv('C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 1차 전처리_2019.csv')

df = data_raw[['만나이','성별','주관적 건강수준','자치구']]

df_hl1=df[df['주관적 건강수준'] != 9]
df_hl2=df_hl1[df_hl1['주관적 건강수준'] != 7]
df_hl2['주관적 건강수준'].value_counts(normalize = True)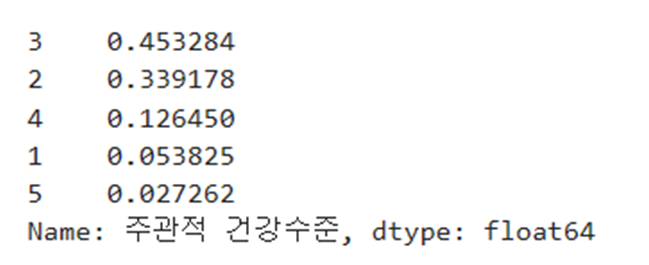
data_pbhlth_code = pd.read_excel('C:/Users/Public/zrzr/walk_with_me-main/raw/지역사회건강조사 2019년 원시자료 이용지침서 등/지역사회건강조사 2019 원시자료 참고사항_보건소정보, 세대유형.xlsx',header=3)
data_pbhlth_code = data_pbhlth_code[data_pbhlth_code['시도코드'] == 11][['보건소코드','보건소명']]
data_pbhlth_code["보건소명"] = data_pbhlth_code["보건소명"].str.replace('보건소', '', regex=True)
data_pbhlth_code.columns=['보건소코드','자치구']
list_region = list(data_pbhlth_code.to_dict()['자치구'].values()) + ['서울시']
list_region.reverse()

list_df = []
for value in list_region:
    temp = df_hl2['자치구'] == value
    list_df.append(df_hl2[temp])
list_df[0] = df_hl2

list_age = ['19~200','19~44','45~64','65~74','75~200']
list_sex = ['계','남','여']
idx_sex = []
idx_age = []
idx_region = []
value_hl = []
for i, value1 in enumerate(list_region):
    for j in list_age:
        for k in list_sex:
            temp = list_df[i][list_df[i]['만나이']>=int(j.split('~')[0])]
            temp1 = temp[temp['만나이'] <= int(j.split('~')[1])]
            if k == '남':
                temp2 = temp1[temp1['성별'] == 1]
            elif k == '여':
                temp2 = temp1[temp1['성별'] == 2]
            else:
                temp2 = temp1
            temp3 = temp2['주관적 건강수준'].value_counts(normalize = True).to_dict()
            if 5 not in temp3:
                temp3[5] = 0
            if 1 not in temp3:
                temp3[1] = 0
            value_hl.append(round(100 - (temp3[3]+temp3[4]+temp3[5])*100,1))
            if j == '19~200':
                idx_age.append('계')
            elif j == '75~200':
                idx_age.append('75 이상')
            else:
                idx_age.append(j)
            idx_sex.append(k)
            idx_region.append(value1)

df_final = pd.DataFrame({'주관적 건강수준':value_hl, '지역':idx_region,'연령별':idx_age,'성별':idx_sex})

df_final = df_final.set_index(['지역','연령별','성별'])

df_final

df_final.to_csv("C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 (건강수준)_2019.csv", mode='w',encoding = 'utf-8-sig')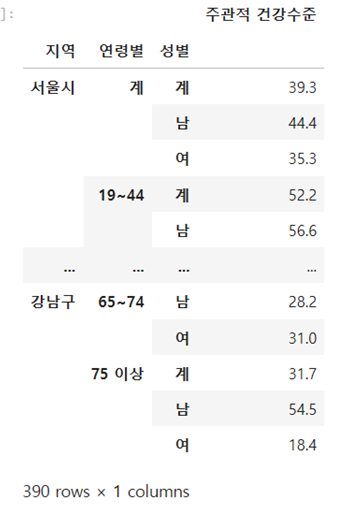
연속형 데이터 전처리
- 해당 자료에서 남은 데이터들은 시간이나 날짜로 나누어져 있기 때문에 이를 합치는 전처리를 진행할 것이다.
- 함수를 만들어 합치고 apply를 적용한 후, 멀티 인덱스를 적용하여 전처리한다.
- 중등도 신체활동 전처리 (99 -> 모름, 77 -> 응답거부)
import pandas as pd
import numpy as np

data_raw = pd.read_csv('C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 1차 전처리_2019.csv')

df = data_raw[['만나이','성별','자치구', '중등도 신체활동 일수', '중등도 신체활동 시간(시)','중등도 신체활동 시간(분)']]

df1=df[df['중등도 신체활동 일수'] != 99]
df2=df1[df1['중등도 신체활동 일수'] != 77]

data_pbhlth_code = pd.read_excel('C:/Users/Public/zrzr/walk_with_me-main/raw/지역사회건강조사 2019년 원시자료 이용지침서 등/지역사회건강조사 2019 원시자료 참고사항_보건소정보, 세대유형.xlsx',header=3)
data_pbhlth_code = data_pbhlth_code[data_pbhlth_code['시도코드'] == 11][['보건소코드','보건소명']]
data_pbhlth_code["보건소명"] = data_pbhlth_code["보건소명"].str.replace('보건소', '', regex=True)
data_pbhlth_code.columns=['보건소코드','자치구']

list_region = list(data_pbhlth_code.to_dict()['자치구'].values()) + ['서울시'] # 전체 합에 해당하는 서울시 추가
list_region.reverse() # 서울시가 맨 위에 올라오도록 reverse 사용
def transtime(df_activity) : # 시와 분을 합쳐서 총 분으로 환산하는 과정
if 0 <= df_activity['중등도 신체활동 시간(시)'] <= 24 and df_activity['중등도 신체활동 시간(분)'] <= 59 :
return df_activity['중등도 신체활동 시간(시)']*60 + df_activity['중등도 신체활동 시간(분)']
else :
return 0
def health_index(df_activity) :
if df_activity['중등도 신체활동 일수'] < 5 :
return 0
# 중등도 신체활동 실천율은 다음과 같다
# 최근 1주일 동안 평소보다 몸이 조금 힘들거나 숨이 약간 가쁜 중등도 신체활동을 1일 30분 이상, 주 5일 이상 실천한 사람의 분율
# 따라서 아래 조건으로 해당하는 사람들은 1을 리턴하고 아니면 0을 리턴하도록 한다.
elif 5 <= df_activity['중등도 신체활동 일수'] and df_activity['중등도 시분 환산'] >= 30 :
return 1
else :
return 0
df_activity = df2.copy()
# 먼저 시분 환산이라는 새로운 column을 만들고 우리가 사용할 데이터프레임에 함수를 적용하자
df_activity["중등도 시분 환산"] = df_activity.apply(transtime, axis =1)
# 그리고 추가로 만들어진 시분 환산 column과 신체활동 일수를 이용하여
# 이 사람이 중등도 신체활동을 실천했으면 1, 그렇지 않으면 0을 주도록 하자.
df_activity['중등도 신체활동 실천'] = df_activity.apply(health_index, axis =1)
# 그리고 필요없는 column은 drop 함수를 이용하여 제거하자
df_activity = df_activity.drop(['중등도 신체활동 시간(시)','중등도 신체활동 시간(분)','중등도 신체활동 일수','중등도 시분 환산'],axis=1) list_df = []
for value in list_region:
temp = df_activity['자치구'] == value
list_df.append(df_activity[temp])
list_df[0] = df_activity
list_age = ['19~200','19~44','45~64','65~74','75~200']
list_sex = ['계','남','여']
idx_sex = []
idx_age = []
idx_region = []
value_act = []
for i, value1 in enumerate(list_region):
for j in list_age:
for k in list_sex:
temp = list_df[i][list_df[i]['만나이']>=int(j.split('~')[0])]
temp1 = temp[temp['만나이'] <= int(j.split('~')[1])]
if k == '남':
temp2 = temp1[temp1['성별'] == 1]
elif k == '여':
temp2 = temp1[temp1['성별'] == 2]
else:
temp2 = temp1
temp3 = temp2['중등도 신체활동 실천'].value_counts(normalize = True).to_dict()
if 1 not in temp3:
temp3[1] = 0
if 0 not in temp3:
temp3[0] = 0
value_act.append(round(temp3[1]*100,1))
if j == '19~200':
idx_age.append('계')
elif j == '75~200':
idx_age.append('75 이상')
else:
idx_age.append(j)
idx_sex.append(k)
idx_region.append(value1)
df_final = pd.DataFrame({'중등도 신체활동 실천':value_act, '지역':idx_region,'연령별':idx_age,'성별':idx_sex})
df_final = df_final.set_index(['지역','연령별','성별'])
df_final
df_final.to_csv("C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 (중등도 신체활동)_2019.csv", mode='w',encoding = 'utf-8-sig')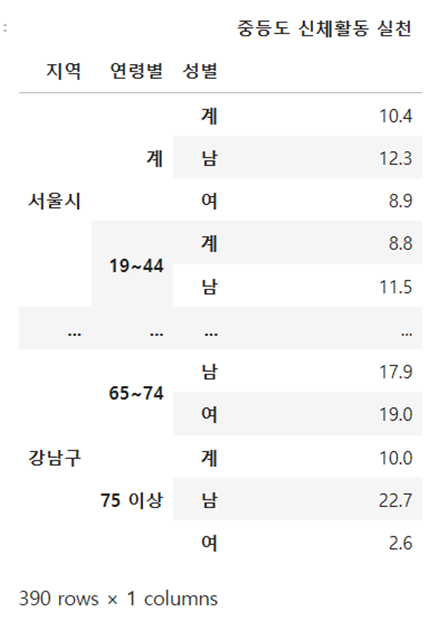
- 격렬한 신체활동 전처리 (99 -> 모름, 77 -> 응답거부)
import pandas as pd
import numpy as np

data_raw = pd.read_csv('C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 1차 전처리_2019.csv')

df = data_raw[['만나이','성별','자치구', '격렬한 신체활동 일수', '격렬한 신체활동 시간(시)','격렬한 신체활동 시간(분)']]

df1=df[df['격렬한 신체활동 일수'] != 99]
df2=df1[df1['격렬한 신체활동 일수'] != 77]
df3=df2[df2['격렬한 신체활동 시간(시)'] != 99]
df4=df3[df3['격렬한 신체활동 시간(시)'] != 77]

data_pbhlth_code = pd.read_excel('C:/Users/Public/zrzr/walk_with_me-main/raw/지역사회건강조사 2019년 원시자료 이용지침서 등/지역사회건강조사 2019 원시자료 참고사항_보건소정보, 세대유형.xlsx',header=3)
data_pbhlth_code = data_pbhlth_code[data_pbhlth_code['시도코드'] == 11][['보건소코드','보건소명']]
data_pbhlth_code["보건소명"] = data_pbhlth_code["보건소명"].str.replace('보건소', '', regex=True)
data_pbhlth_code.columns=['보건소코드','자치구']
list_region = list(data_pbhlth_code.to_dict()['자치구'].values()) + ['서울시']
list_region.reverse()

def transtime(df_activity) :
    if 0 <= df_activity['격렬한 신체활동 시간(시)'] <= 24 and df_activity['격렬한 신체활동 시간(분)'] <= 59 :
        return df_activity['격렬한 신체활동 시간(시)']*60 + df_activity['격렬한 신체활동 시간(분)']
    else :
        return 0

def health_index(df_activity) :
    if df_activity['격렬한 신체활동 일수'] < 3 :
        return 0
    elif 3 <= df_activity['격렬한 신체활동 일수'] and df_activity['격렬 시분 환산'] >= 20 :
        return 1
    else :
        return 0

df_activity = df4.copy() # 오류제거
df_activity["격렬 시분 환산"] = df_activity.apply(transtime, axis =1)
df_activity['격렬한 신체활동 실천'] = df_activity.apply(health_index, axis =1)
df_activity = df_activity.drop(['격렬한 신체활동 시간(시)','격렬한 신체활동 시간(분)','격렬한 신체활동 일수','격렬 시분 환산'],axis=1)

list_df = []
for value in list_region:
    temp = df_activity['자치구'] == value
    list_df.append(df_activity[temp])
list_df[0] = df_activity

list_age = ['19~200','19~44','45~64','65~74','75~200']
list_sex = ['계','남','여']
idx_sex = []
idx_age = []
idx_region = []
value_act = []
for i, value1 in enumerate(list_region):
    for j in list_age:
        for k in list_sex:
            temp = list_df[i][list_df[i]['만나이']>=int(j.split('~')[0])]
            temp1 = temp[temp['만나이'] <= int(j.split('~')[1])]
            if k == '남':
                temp2 = temp1[temp1['성별'] == 1]
            elif k == '여':
                temp2 = temp1[temp1['성별'] == 2]
            else:
                temp2 = temp1
            temp3 = temp2['격렬한 신체활동 실천'].value_counts(normalize = True).to_dict()
            if 1 not in temp3:
                temp3[1] = 0
            if 0 not in temp3:
                temp3[0] = 0
            value_act.append(round(temp3[1]*100,1))

            if j == '19~200':
                idx_age.append('계')
            elif j == '75~200':
                idx_age.append('75 이상')
            else:
                idx_age.append(j)
            idx_sex.append(k)
            idx_region.append(value1)

df_final = pd.DataFrame({'격렬한 신체활동 실천':value_act, '지역':idx_region,'연령별':idx_age,'성별':idx_sex})

df_final = df_final.set_index(['지역','연령별','성별'])

df_final

df_final.to_csv("C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 (격렬한 신체활동)_2019.csv", mode='w',encoding = 'utf-8-sig')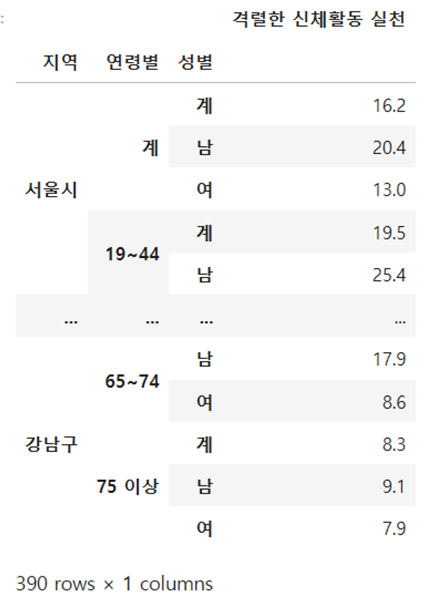
- 걷기 전처리 (99 -> 모름, 77 -> 응답거부)
import pandas as pd
import numpy as np

data_raw = pd.read_csv('C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 1차 전처리_2019.csv')

df = data_raw[['만나이','성별','자치구', '걷기 실천 일수', '걷기 실천 시간(시)','걷기 실천 시간(분)']]

df1=df[df['걷기 실천 일수'] != 99]
df2=df1[df1['걷기 실천 일수'] != 77]

data_pbhlth_code = pd.read_excel('C:/Users/Public/zrzr/walk_with_me-main/raw/지역사회건강조사 2019년 원시자료 이용지침서 등/지역사회건강조사 2019 원시자료 참고사항_보건소정보, 세대유형.xlsx',header=3)
data_pbhlth_code = data_pbhlth_code[data_pbhlth_code['시도코드'] == 11][['보건소코드','보건소명']]
data_pbhlth_code["보건소명"] = data_pbhlth_code["보건소명"].str.replace('보건소', '', regex=True)
data_pbhlth_code.columns=['보건소코드','자치구']
list_region = list(data_pbhlth_code.to_dict()['자치구'].values()) + ['서울시']
list_region.reverse()

def transtime(df_walk) :
    if 0 <= df_walk['걷기 실천 시간(시)'] <= 24 and df_walk['걷기 실천 시간(분)'] <= 59 :
        return df_walk['걷기 실천 시간(시)']*60 + df_walk['걷기 실천 시간(분)']
    else :
        return 0

def health_index(df_walk) :
    if df_walk['걷기 실천 일수'] < 5 :
        return 0
    elif 5 <= df_walk['걷기 실천 일수'] and df_walk['걷기 시분 환산'] >= 30 :
        return 1
    else :
        return 0

df_walk = df2.copy() # 오류제거
df_walk["걷기 시분 환산"] = df_walk.apply(transtime, axis =1)
df_walk['걷기 실천'] = df_walk.apply(health_index, axis =1)
df_walk = df_walk.drop(['걷기 실천 시간(시)','걷기 실천 시간(분)','걷기 실천 일수','걷기 시분 환산'],axis=1)

list_df = []
for value in list_region:
    temp = df_walk['자치구'] == value
    list_df.append(df_walk[temp])
list_df[0] = df_walk

list_age = ['19~200','19~44','45~64','65~74','75~200']
list_sex = ['계','남','여']
idx_sex = []
idx_age = []
idx_region = []
value_walk = []
for i, value1 in enumerate(list_region):
    for j in list_age:
        for k in list_sex:
            temp = list_df[i][list_df[i]['만나이']>=int(j.split('~')[0])]
            temp1 = temp[temp['만나이'] <= int(j.split('~')[1])]
            if k == '남':
                temp2 = temp1[temp1['성별'] == 1]
            elif k == '여':
                temp2 = temp1[temp1['성별'] == 2]
            else:
                temp2 = temp1
            temp3 = temp2['걷기 실천'].value_counts(normalize = True).to_dict()
            if 1 not in temp3:
                temp3[1] = 0
            if 0 not in temp3:
                temp3[0] = 0
            value_walk.append(round(temp3[1]*100,1))

            if j == '19~200':
                idx_age.append('계')
            elif j == '75~200':
                idx_age.append('75 이상')
            else:
                idx_age.append(j)
            idx_sex.append(k)
            idx_region.append(value1)

df_final = pd.DataFrame({'걷기 실천':value_walk, '지역':idx_region,'연령별':idx_age,'성별':idx_sex})

df_final = df_final.set_index(['지역','연령별','성별'])

df_final

df_final.to_csv("C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 (걷기)_2019.csv", mode='w',encoding = 'utf-8-sig')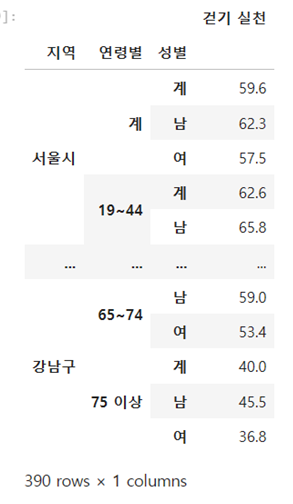
- 소득 전처리 (9, 99999 -> 모름, 7, 77777 -> 응답거부)
import pandas as pd
import numpy as np

data_raw = pd.read_csv('C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 1차 전처리_2019.csv')

df = data_raw[['만나이','성별','가구원수','가구소득_년월','가구소득_년금액','가구소득_월금액','자치구']]

df_hi1=df[df['가구소득_년금액'] != 99999]
df_hi2=df_hi1[df_hi1['가구소득_년금액'] != 77777]
df_hi3=df_hi2[df_hi2['가구소득_월금액'] != 99999]
df_hi4=df_hi3[df_hi3['가구소득_월금액'] != 77777]
df_hi5=df_hi4[df_hi4['가구소득_년월'] != 9]
df_hi6=df_hi5[df_hi5['가구소득_년월'] != 7]

data_pbhlth_code = pd.read_excel('C:/Users/Public/zrzr/walk_with_me-main/raw/지역사회건강조사 2019년 원시자료 이용지침서 등/지역사회건강조사 2019 원시자료 참고사항_보건소정보, 세대유형.xlsx',header=3)
data_pbhlth_code = data_pbhlth_code[data_pbhlth_code['시도코드'] == 11][['보건소코드','보건소명']]
data_pbhlth_code["보건소명"] = data_pbhlth_code["보건소명"].str.replace('보건소', '', regex=True)
data_pbhlth_code.columns=['보건소코드','자치구']
list_region = list(data_pbhlth_code.to_dict()['자치구'].values()) + ['서울시']
list_region.reverse()

def transincome(df_income) :
    if df_income['가구소득_년월'] == 1: # 1은 년
        return df_income['가구소득_년금액'] / df_income['가구원수']
    elif df_income['가구소득_년월'] == 2: # 2는 월
        return df_income['가구소득_월금액']*12  / df_income['가구원수']
    else :
        return 0

df_income = df_hi6.copy() # 오류제거
df_income["소득 연봉 환산"] = df_income.apply(transincome, axis =1)
df_income = df_income.drop(['가구소득_년월','가구소득_년금액','가구소득_월금액','가구원수'],axis=1)

list_df = []
for value in list_region:
    temp = df_income['자치구'] == value
    list_df.append(df_income[temp])
list_df[0] = df_income

list_age = ['19~200','19~44','45~64','65~74','75~200']
list_sex = ['계','남','여']
idx_sex = []
idx_age = []
idx_region = []
value_hi = []
for i, value1 in enumerate(list_region):
    for j in list_age:
        for k in list_sex:
            temp = list_df[i][list_df[i]['만나이']>=int(j.split('~')[0])]
            temp1 = temp[temp['만나이'] <= int(j.split('~')[1])]
            if k == '남':
                temp2 = temp1[temp1['성별'] == 1]
            elif k == '여':
                temp2 = temp1[temp1['성별'] == 2]
            else:
                temp2 = temp1
            temp3 = temp2["소득 연봉 환산"].value_counts().to_dict()
            total_sum = 0
            for m,n in temp3.items():
                total_sum += m*n
            value_hi.append(round(total_sum/len(temp2['소득 연봉 환산']),1))
            if j == '19~200':
                idx_age.append('계')
            elif j == '75~200':
                idx_age.append('75 이상')
            else:
                idx_age.append(j)
            idx_sex.append(k)
            idx_region.append(value1)

df_final = pd.DataFrame({'1인당 연소득':value_hi, '지역':idx_region,'연령별':idx_age,'성별':idx_sex})

df_final = df_final.set_index(['지역','연령별','성별'])

df_final

df_final.to_csv("C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/지역사회건강조사 (1인당 연소득)_2019.csv", mode='w',encoding = 'utf-8-sig')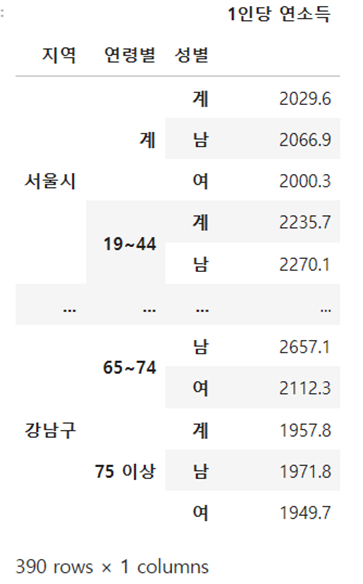
전처리된 데이터 통합
- OS 모듈 사용
- 편한 시각화를 위해 통합된 테이블이 필요함.
- 건강 관련 데이터 통합
import pandas as pd
import os

path_dir = 'C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/'

file_list = os.listdir(path_dir)
data_list = []
for i in file_list:
    if i =='지역사회건강조사 1차 전처리_2019.csv':
        continue
    if i.split(' ')[0] == '지역사회건강조사':
        data_list.append(pd.read_csv('C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/%s' % i))

for i in data_list:
    i.set_index(['지역','연령별','성별'],inplace=True)

df_health = pd.concat(data_list, axis=1, join='inner')

df_health

df_health.to_csv("C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/통합 테이블(건강)_2019.csv", mode='w',encoding = 'utf-8-sig')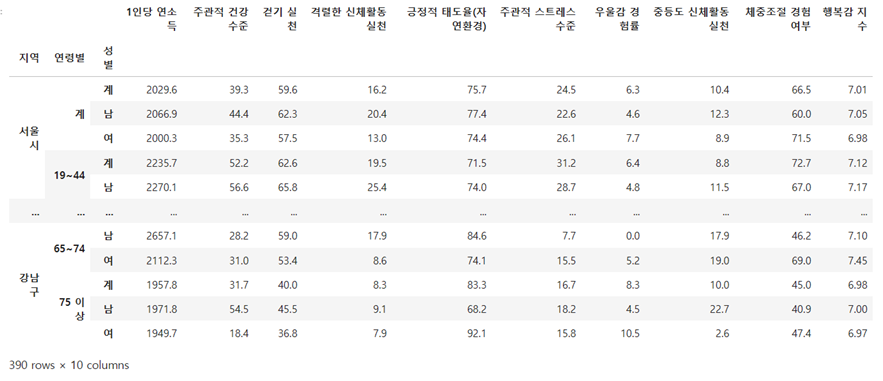
- 전처리된 데이터 모두 통합
import pandas as pd

data_park = pd.read_csv('C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/통합 테이블(공원)_2019.csv')
data_health = pd.read_csv('C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/통합 테이블(건강)_2019.csv')
data_finance = pd.read_csv('C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/서울시 자치구 재정자립도_2019.csv')
data_athletic = pd.read_csv('C:/Users/Public/zrzr/walk_with_me-main/전처리된 데이터/서울시 신고_등록 체육시설 통계_2019.csv')
data_health.rename(columns={'지역':'자치구'},inplace = True) # 지역을 자치구로 변경하여 하나로 통일
data_health1 = data_health[(data_health['연령별'] == '계') & (data_health['성별'] == '계')]
data_health1.set_index('자치구',inplace = True)
data_park.set_index('자치구',inplace = True)
data_finance.set_index('자치구',inplace = True)
data_athletic.set_index('자치구',inplace = True)
df = pd.concat([data_health1, data_finance, data_athletic,data_park],axis=1)
df = df.drop(df.index[0]) # 서울시를 일단 없앤다
df = df.drop(['연령별','성별'],axis=1) # 멀티인덱스때 사용했던 column들 삭제

df.reset_index(inplace = True)
df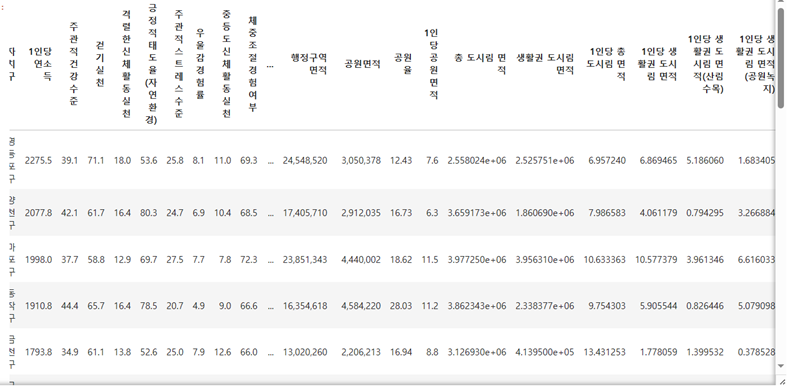
시각화
- 다양한 변수들의 상관관계에 대하여 알아보기 위해 seaborn의 heatmap을 사용하였음
- 통합된 데이터에 공원과 관련된 변수가 너무 많아서 각 자치구별 인구 비율을 반영할 수 있는 1인당 생활권 도시림 면적을 사용하였음
import numpy as np
import seaborn as sns
import matplotlib as mp
import matplotlib.pyplot as plt

df1 = df.drop(['공원율','1인당 공원 면적','총 도시림 면적','생활권 도시림 면적','1인당 총 도시림 면적',
               '1인당 생활권 도시림 면적(산림수목)','1인당 생활권 도시림 면적(공원녹지)'],axis=1)

corr=df1.corr()

# 그림 사이즈 지정
fig, ax = plt.subplots( figsize=(15,15) )


# 삼각형 마스크를 만든다(위 쪽 삼각형에 True, 아래 삼각형에 False)
mask = np.zeros_like(corr, dtype=np.bool)
mask[np.triu_indices_from(mask)] = True

# 히트맵 생성
sns.heatmap(corr,
            cmap = 'RdYlBu_r',
            annot = True,   # 실제 값을 표시
            mask=mask,      # 표시하지 않을 마스크 부분을 지정
            linewidths=1,  # 실선 조절
            cbar_kws={"shrink": 1},# 컬러바 크기 조절
            vmin = -1,vmax = 1   # 컬러바 범위 조절
           )
plt.show() 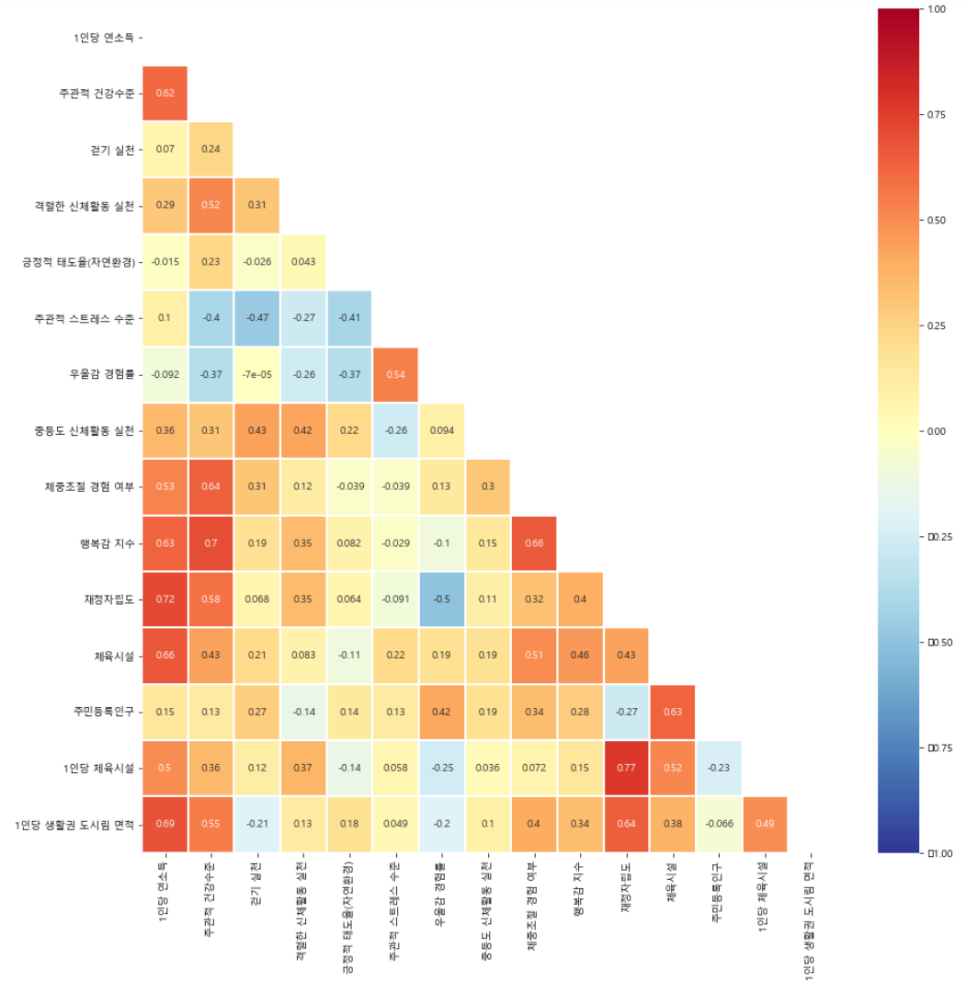
-> 1인당 생활권 도시림 면적과 다른 변수들과의 상관관계를 비교하면 신체활동과 관련된 지표에서는 큰 상관관계를 발견하기 어려웠지만 주관적 건강수준이나 행복감 지수 등에서 유의미한 양의 상관관계를 발견할 수 있음
-> 1인당 생활권 도시림 면적과 가장 큰 상관관계를 갖는 변수는 재정자립도와 1인당 연소득임
- 행복감 지수와 1인당 생활권 도시림 면적 간의 관계를 막대그래프와 선 그래프로 나타냄
import scipy.stats as stats
import seaborn as sns

df2= df1[['행복감 지수','주관적 건강수준','우울감 경험률']]

plt.rcParams['figure.figsize'] = (20, 10) # 크기 지정
plt.rcParams['font.size'] = 10 # 폰트 크기 지정

# subplots를 이용하여 figure 객체(전체 영역)와 axex 객체(들어갈 그래프들)을 가져온다
fig, ax = plt.subplots()

# ax에 그리고 싶은 막대그래프에 대한 정보를 넣는다
ax.bar(df["자치구"], df["1인당 생활권 도시림 면적"], color='deeppink', label='1인당 생활권 도시림 면적', alpha=0.3, width=0.7)

# y축에 대해서 라벨과 스케일을 조절
ax.set_ylabel('1인당 생활권 도시림 면적')
ax.set_yscale('log') # 자치구별 차이가 커서 로그 스케일로 보여주는 차이를 줄여주었다

plt.legend(loc=2, fontsize=13) # loc=2 는 upper left다

# twinx()를 이용하여 y축을 하나 더 추가하자
ax1 = ax.twinx()

# plot을 이용하여 선 그래프를 그려주자
ax1.plot(df["자치구"], df["행복감 지수"], '-s', color='purple', linewidth=2, alpha=0.5, label='행복감 지수')
ax1.set_xlabel('자치구')

ax1.set_ylabel('행복감 지수')
ax1.tick_params(axis='both', direction='in')
plt.legend(loc=1, fontsize=13) # loc=1 는 upper right
plt.ylim([6,8]) # 행복감 지수의 값이 6에서 8사이에 형성되어서 6과 8사이 오도록 설정

plt.show()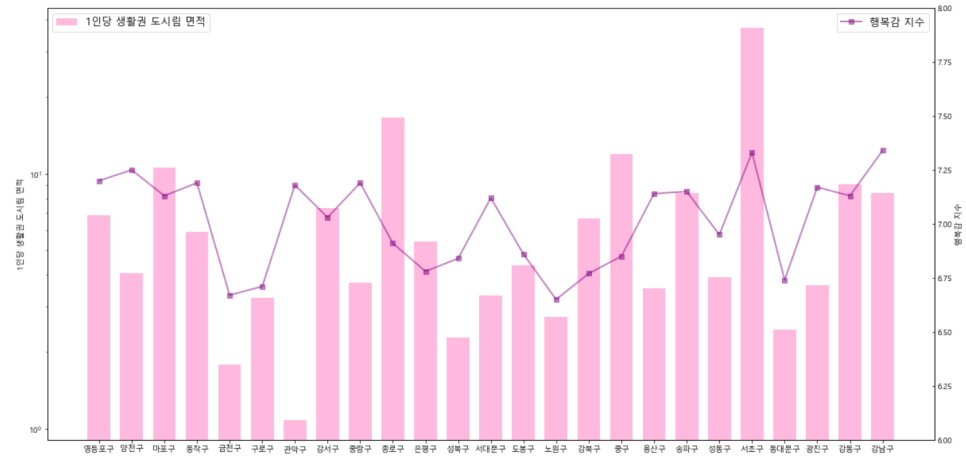
-> 행복감 지수와 주관적 건강수준이 1인당 생활권 도시림 면적과 유의미한 양의 상관관계가 있어 보이지만, 위에서도 확인했듯이 그 자치구의 재정자립도나 1인당 연소득이 더 높은 상관관계를 가지고 있음
- 위의 결과에 대한 내용인 (행복감 지수, 주관적 건강수준)과 (1인당 생활권 도시림 면적, 재정자립도, 1인당 연소득) 간의 관계를 막대그래프로 나타냄
A =corr[['1인당 생활권 도시림 면적','1인당 연소득','재정자립도']]
B= A.T.reset_index()


plt.rcParams['figure.figsize'] = (10, 8)
plt.rcParams['font.size'] = 10


index = np.arange(3)/2
label=['1인당 생활권 도시림 면적','1인당 연소득','재정자립도']

ax = plt.subplot()
p1 =ax.barh(index-0.1,B["행복감 지수"],height=0.2,color='deeppink', label='행복감 지수', alpha=0.3)
p2 =ax.barh(index+0.1,B["주관적 건강수준"], height=0.2,  color='pink', label='주관적 건강수준', alpha=0.3)

plt.xlabel('상관 계수', fontsize=18)


plt.legend((p1[0], p2[0]), ('행복감 지수', '주관적 건강수준'),loc='upper center', ncol=1, bbox_to_anchor=(0.83, 0.8), fontsize=15)


plt.yticks(index, label,fontsize=12)

plt.show()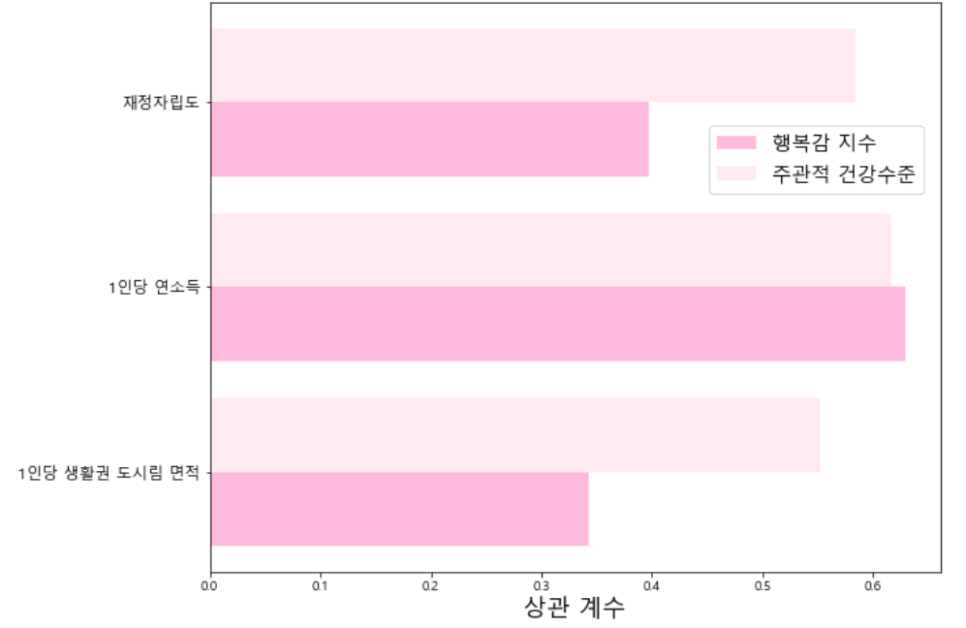
3. 결론
데이터 전처리 과정 중 데이터 수집, 데이터 정제, 가공의 과정을 직접 수행하였다. 특히, 결측치를 제거와 단순 대체법을 수행하였다. 수집한 모든 데이터들을 전처리한 후, 통합하여 분석 목적인 공원과 건강, 소득 간의 상관관계를 알아보고자 시각화를 수행하였다. 시각화 결과 신체적 건강(걷기, 중등도, 격렬)과 공원(도시림 면적) 간에는 큰 상관관계가 나타나지 않았고, 신체적 건강과 소득(재정자립도, 연소득) 역시 큰 상관관계가 나타나지 않았다. 반면에 심리적 건강(행복감지수, 주관적 건강수준 등)은 공원과 유의미한 상관관계가 나타났고, 소득과도 유의미한 상관관계가 나타났다.
이번 프로젝트를 진행하면서 데이터 전처리는 아직도 매우 어렵고, 복잡한 과정이지만 이 과정이 데이터 분석에 있어서 얼마나 중요한지 다시금 깨닫게 되었다. 그리고 스스로한테도 앞으로의 전공과 진로에 대하여 많은 도움을 받게 되었다. 데이터 전처리 과정이 단순하게 값과 데이터를 조작하는 것이 아닌 논리적이고 통계적인 지식을 갖고 수행해야 함을 또 느꼈다. 더 많은 데이터를 접해보고 기초적인 지식을 쌓아야 할 필요성을 느끼게 되었다. 아직 데이터를 변환하는 것이 약한 것 같아서 그 부분에 있어서 이번 프로젝트와 같은 추가적인 예제 학습과 분석을 방학동안 수행해야 겠다고 생각했다.
4. 참고 문헌
인용, 출처, 참고 모두 포함
1) https://chs.kdca.go.kr/chs/index.do
2) https://blog.naver.com/udo_peanut/222527849666
3) https://github.com/jj150618/walk_with_me/tree/main
4) https://data.seoul.go.kr/