동시성모델
1. 동시성과 병렬성
동시성
동시성은 여러 작업을 동시에 진행되는 것처럼 다루는 것이다.
예를 들어 한 사람이 여러 일을 번갈아 처리하는 멀티태스킹이 동시성에 해당한다.
한 사람이 여러 작업을 번갈아 처리함
→ 동시에 하는 것처럼 보임
→ 동시성
병렬성
병렬성은 여러 작업이 실제로 동시에 실행되는 것이다.
예를 들어 여러 사람이 각각 작업을 나눠서 동시에 처리하는 것이 병렬성이다.
여러 작업자가 일을 나누어 동시에 수행함
→ 실제 동시 실행
→ 병렬성
동시성과 병렬성 예시
한 사람이 멀티태스킹
→ 동시성

학생 한 명이 카드 다섯 개씩 만들기
→ 병렬성

교수와 조교가 역할을 나눠 실습 수업 진행
→ 동시성 + 병렬성
2. 동시성과 병렬성의 결정성
동시성
동시성은 사건이 일어나는 순서나 시점에 따라 결과가 달라질 수 있다.
그래서 비결정적이다.
실행 순서에 따라 결과가 달라질 수 있음
→ non-deterministic
병렬성
병렬성은 작업을 나누어 동시에 처리하더라도 결과가 같다면 결정적이다.
예를 들어 모든 숫자에 2를 곱하는 작업은 나눠서 처리해도 결과가 같다.
배열 앞부분은 코어 1
배열 뒷부분은 코어 2

결과는 전체 배열에 2를 곱한 것과 동일
→ deterministic
3. 병렬 아키텍처
병렬 아키텍처는 컴퓨터가 작업을 더 빠르게 처리하기 위해 병렬적으로 실행하는 구조를 말한다.
비트 수준 병렬성
한 번에 처리할 수 있는 비트 수가 많을수록 더 많은 데이터를 처리할 수 있다.
64비트 컴퓨터 > 8비트 컴퓨터명령어 수준 병렬성
명령어를 순서대로 하나씩만 실행하지 않고, 겹쳐서 실행하거나 미리 실행하는 방식이다.
- 파이프라이닝
- 비순차 실행
- 추측 실행
speculative execution: 작은 모델로 나눠서 더 빠르게 돌림.
데이터 병렬성
대량의 데이터에 같은 작업을 동시에 수행하는 방식이다.
- GPU가 여러 픽셀의 밝기를 동시에 조절
태스크 수준 병렬성
서로 다른 작업을 병렬로 수행하는 방식이다.
- 공유 메모리 방식
- 분산 메모리 방식
4. 동시성적 세계와 동시적 소프트웨어
현실의 소프트웨어는 대부분 여러 일이 동시에 일어난다.
IDE에서 타이핑하면서 동시에 문법 검사
스마트폰에서 음악 재생 + 네트워크 통신 + 터치 감지
백그라운드 작업을 통한 반응형 시스템
즉, 동시성은 사용자가 시스템을 끊김 없이 사용할 수 있도록 만드는 중요한 개념이다.
빠르게 스케쥴링하고 컨텍스트 스위치를 한다.
5. 분산된 세계와 분산 소프트웨어
소프트웨어는 하나의 컴퓨터에서만 실행되지 않고, 여러 지역과 여러 서버에 분산되어 실행될 수 있다.
분산 소프트웨어에서 중요한 개념은 장애 내성이다.
장애 내성 = 일부가 실패해도 전체 시스템이 계속 동작할 수 있는 성질이런 시스템을 견고한 시스템, 즉 resilient system이라고 한다.
6. 예측 불가한 세계와 탄력적 소프트웨어
동시성은 시스템을 더 탄력적으로 만들 수 있다.
동시성
→ 작업 간 독립성
→ 장애 감지 가능
→ 장애 허용 가능
독립성
한 작업이 실패해도 다른 작업에 영향을 주지 않는 성질이다.
최대한 독립성을 가져라
장애 감지
문제가 발생했을 때 이를 발견하고 복구할 수 있는 성질이다.
7. 복잡한 동시 세계, 단순한 소프트웨어
동시적인 문제를 무조건 순차적인 방식으로 해결하려고 하면 코드가 복잡해진다.
따라서 하나의 복잡한 스레드가 모든 일을 처리하는 것보다,
각각 하나의 문제를 담당하는 여러 스레드로 나누는 것이 더 단순할 수 있다.
8. 스레드와 잠금장치
스레드와 lock을 사용하면 동시성 프로그램을 작성할 수 있다.
코드 작성은 쉬울 수 있으나, 유지보수는 어렵다.
여러 스레드가 같은 데이터를 동시에 접근하면 문제가 생길 수 있기 때문이다.
9. 스레드
스레드는 프로그램 안에서 실행되는 작업 흐름이다.
하나의 프로그램 안에서도 여러 스레드가 동시에 실행될 수 있다.
예를 들어 main thread와 new thread가 따로 실행될 수 있다.
두 스레드가 동시에 실행되면 출력 순서가 항상 같지 않을 수 있다.
→ 즉 비결정적이라서 멀티코어를 통해서 멀티 쓰레드를 사용한다고 해서 무조건 빨라지는게 아닐 수 있다.
- 두 개의 스레드가 따로 실행
public class HelloWorld { public static void main(String[] args) throws InterruptedException { Thread myThread = new Thread() { //새 스레드 public void run() { //새 스레드가 작업할 작업 System.out.println("Hello from new thread"); } }; myThread.start(); //새 스레드 시작 Thread.yield(); //현재 실행 중인 스레드가 다른 스레드에게 실행 기회를 양보 System.out.println("Hello from main thread"); myThread.join(); //myThread가 끝날때까지 main Thread가 기다리게 함 } } - 두 개의 스레드가 동시에 실행
public class Counting { public static void main(String[] args) throws InterruptedException { class Counter { private int count = 0; public void increment() { ++count; } public int getCount() { return count; } } final Counter counter = new Counter(); //카운터 객체 생성 class CountingThread extends Thread { public void run() { //새 스레드가 할 작업 -> increment()를 10000번 실행 for (int x = 0; x < 10000; ++x) { counter.increment(); } } } CountingThread t1 = new CountingThread(); //스레드 1 CountingThread t2 = new CountingThread(); //스레드 2 //두 개의 스레드가 동시에 실행 t1.start(); t2.start(); t1.join(); t2.join(); System.out.println(counter.getCount()); } }- t1과 t2에서 카운터가 10000번씩 증가했으므로 카운트 결과가 20000일거 같지만 아닐 수 있다. → 두 스레드가 동시에 카운트에 접근하기 때문
- 공유 변수에 여러 스레드가 동시에 접근할 때는 동기화가 필요하다!
-
stchronized 사용
public synchronized void increment() { ++count; } // 한 번에 하나의 스레드만 increment()를 실행할 수 있다. -
AtomicInteger 사용
AtomicInteger count = new AtomicInteger(0);
//여러 스레드가 동시에 접근해도 안전하게 정수 값을 증가시킬 수 있게 해줌
-
- t1과 t2에서 카운터가 10000번씩 증가했으므로 카운트 결과가 20000일거 같지만 아닐 수 있다. → 두 스레드가 동시에 카운트에 접근하기 때문
10. 동적 최적화, 정적 최적화
공유 메모리 환경에서는 실행 성능을 높이기 위해 코드 실행 순서가 바뀔 수 있다.
- 컴파일러 → 정적 최적화
- JVM → 동적 최적화
- 하드웨어 → 실행 순서 변경 가능
즉, 우리가 코드에 작성한 순서와 실제 실행 순서가 항상 같다고 보장할 수 없다.
특히 여러 스레드가 같은 변수를 공유할 때는 이런 최적화 때문에 예상과 다른 결과가 나올 수 있다.
public class Puzzle {
    static boolean answerReady = false;
    static int answer = 0;

    //t1 → answer 값을 42로 바꾸고, answerReady를 true로 바꿈
    static Thread t1 = new Thread() {
        public void run() {
            answer = 42;
            answerReady = true;
        }
    };
		//t2 → answerReady가 true이면 answer 출력
    static Thread t2 = new Thread() {
        public void run() {
            if (answerReady)
                System.out.println("The meaning of life is: " + answer);
            else
                System.out.println("I don't know the answer");
        }
    };

    public static void main(String[] args) throws InterruptedException {
        t1.start();
        t2.start();

        t1.join();
        t2.join();
    }
}
서로 실행되므로, answerReady가 true라면 당연히 answer는 42일 것처럼 보인다.
하지만 동시성 환경에서는 컴파일러, JVM, 하드웨어가 최적화를 위해 실행 순서를 바꿀 수 있다.
(코딩할 때는 명확한 실행 순서가 필요하다!)
- answerReady = true가 먼저 보임
- answer = 42는 아직 다른 스레드에 안 보임
→ 메모리 가시성 문제!
11. 메모리 가시성
메모리 가시성이란 한 스레드가 바꾼 값이 다른 스레드에게 보이는지를 의미한다.
→ 하나는 전역변수, 하나는 스태틱으로 두면 확인할 수 있다.
한 스레드가 메모리에 가한 변화가
다른 스레드에 보이는 경우
→ 메모리 가시성
동시성 프로그램에서는 단순히 값을 바꾸는 것뿐 아니라,
다른 스레드가 그 변경을 제대로 볼 수 있는지도 중요하다.
12. 스레드와 잠금장치 가이드
스레드와 lock을 사용할 때는 다음 원칙이 중요하다.
공유 변수 접근은 반드시 동기화한다.
쓰는 스레드와 읽는 스레드 모두 동기화한다.
여러 잠금장치를 사용할 때는 정해진 순서로 요청한다.
잠금장치는 최대한 짧게 보유한다.- 정해진 순서 (데드락 방지! 세마포어!)
import java.util.Random; class Philosopher extends Thread { private Chopstick first, second; //공유 자원: 젓가락 2개 private Random random; private int thinkCount; //ID가 작은 젓가락를 먼저 잡음 => 항상 같은 순서로 잡게 함 public Philosopher(Chopstick left, Chopstick right) { if (left.getId() < right.getId()) { first = left; second = right; } else { first = right; second = left; } random = new Random(); } public void run() { try { while (true) { ++thinkCount; if (thinkCount % 10 == 0) { System.out.println("Philosopher " + this + " has thought " + thinkCount + " times"); } Thread.sleep(random.nextInt(1000)); // 잠깐 생각함 //sychronized = 한번에 한 스레드만 해당 객체를 사용 가능 synchronized (first) { // 첫 번째 젓가락을 잡음 synchronized (second) { // 두 번째 젓가락을 잡음 Thread.sleep(random.nextInt(1000)); // 잠깐 식사함 } } } } catch (InterruptedException e) { } } } - 공유 변수 접근 동기화
자칫 잘못해서 다른 리스너의 의존관계가 발생하기 시작하면 데드락이 생길 수 있다. → 무조건 snychronized를 건다고 해결되는게 아니라, 내부 상황에 따라서 데드락이 걸릴 수 있다.//다운로더는 스레드이기 때문에 여러 스레드가 동시에 다운로드 작업을 실행할 수 있다. class Downloader extends Thread { private InputStream in; private OutputStream out; private ArrayList<ProgressListener> listeners; public Downloader(URL url, String outputFilename) throws IOException { in = url.openConnection().getInputStream(); out = new FileOutputStream(outputFilename); listeners = new ArrayList<ProgressListener>(); } //lisener를 추가하는 함수 public synchronized void addListener(ProgressListener listener) { listeners.add(listener); } //lisener를 제거하는 함수 public synchronized void removeListener(ProgressListener listener) { listeners.remove(listener); } // 현재 진행 상황을 모든 lisener에게 알려주는 함수 private synchronized void updateProgress(int n) { for (ProgressListener listener : listeners) { listener.onProgress(n); } } }
하지만 근본적인 문제는 가변 공유 메모리이다.
여러 스레드가 같은 변경 가능한 데이터를 공유함
→ 복잡한 버그 발생 가능
13. 함수형 언어
함수형 언어에서는 가변성을 제거하는 것이 핵심이다.
즉, 값을 직접 바꾸기보다 새로운 값을 만들어 사용한다.
가변성 제거
→ 공유 데이터 변경 문제 감소
→ 동시성 문제 완화
함수형 언어는 스타일만 좋은게 아니라, 깔끔한 개발에도 좋다. 공유된 뮤테이블한 오브젝트에 대한 의존도를 줄여준다.
- 숨은 가변성
이터레이터에 synchronized이 붙어있어서 안전해 보이지만 이터레이터를 반환한 이후에는 lock이 풀린다!import java.util.Iterator; import java.util.LinkedList; import java.util.List; public class Tournament { //토너먼트의 참가자 목록인 players private List<Player> players = new LinkedList<Player>(); //새로운 참가자를 리스트에 추가 public synchronized void addPlayer(Player p) { players.add(p); } //플레이어 목록을 순회할 수 있는 이터레이터를 반환 public synchronized Iterator<Player> getPlayerIterator() { return players.iterator(); } }
→ 다른 코드가 이 Iterator를 가지고players를 순회하는 동안, 다른 스레드가addPlayer()로 리스트를 수정 → 문제 발생- LinkedList는 순회 중에 다른 스레드가 수정하면 ConcurrentModificationException이 발생할 수 있다.
- CopyOnWriteArrayList는 수정할 때 복사본을 만들어 변경하므로 순회 중 변경 문제를 줄일 수 있다.
14. 불변성
불변성이란 한 번 만들어진 값이 바뀌지 않는 성질이다.
Java에서는 보통 누적 변수를 바꾸면서 합계를 구한다.
public int sum(int[] numbers) {
    int accumulator = 0;
    for (int n : numbers)
        accumulator += n;
    return accumulator;
}
여기서 accumulator는 계속 값이 바뀐다.
0 + 첫 번째 요소 → accumulator 값 변경
accumulator + 두 번째 요소 → accumulator 값 변경
accumulator + 세 번째 요소 → accumulator 값 변경
반면 Clojure 같은 함수형 언어에서는 기존 값을 바꾸기보다 새로운 값을 만들어 계산한다.
#재귀 방식
(defn recursive-sum [numbers]
  (if (empty? numbers)
    0
    (+ (first numbers) (recursive-sum (rest numbers)))))

 #reduce를 사용한 방식
 (defn reduce-sum [numbers]
  (reduce (fn [acc x] (+ acc x)) 0 numbers))

#더 짧은 방식
(defn sum [numbers]
  (reduce + numbers))
0 + 첫 번째 요소 → a1
a1 + 두 번째 요소 → a2
a2 + 세 번째 요소 → a3
즉, 이전 값을 수정하는 것이 아니라 새로운 결과값을 만들어 다음 계산에 사용한다.
15. Clojure
Clojure는 JVM 위에서 동작하는 함수형 언어다.
REPL(Read-Evaluate-Print-Loop)을 통해 코드를 입력하고 바로 결과를 확인할 수 있다.
클로져는 연산자가 앞에 오는 방식이라 처음 보면 괄호가 많아서 어색할 수 있다.
하지만 피연산자들을 같은 줄에 맞춰 쓰면, 계산 구조가 오히려 눈에 잘 들어온다.
(max 3 5)
(+ 1 (* 2 3))
(def meaning-of-life 42)
16. Clojure 병렬성
Clojure에서는 병렬 처리를 간결하게 표현할 수 있다.
예를 들어 parallel-sum은 여러 데이터를 나누어 병렬로 합계를 계산한다.
(defn parallel-sum [numbers]
  (r/fold + numbers))
4-core 맥북프로에서 천만 개 아이템 기준 약 2.5배 성능 향상이 있었다.
17. 단어 세기 예제
단어 개수를 세기 위해 map 자료구조를 사용할 수 있다.
>(def counts {"apple" 2 "orange" 1})
>(get counts "apple" 0)
2
>(get counts "banana" 0)
0
>(assoc counts "banana" 1)
{"banana" 1, "apple" 2, "orange" 1}
의미는 다음과 같다.
apple 개수 조회 → 2
banana가 없으면 기본값 0
banana를 1개로 추가
18. frequencies 함수
(defn word-frequencies [words]
  (reduce
    (fn [counts word] (assoc counts word (inc (get counts word 0))))
    {} words))

(word-frequencies ["one" "potato" "two" "potato"])
;; ?????- 표준 frequency 함수 이미 존재함.
frequencies는 컬렉션 안의 값들이 각각 몇 번 등장하는지 세어주는 함수다.
>(frequencies ["one" "potato" "two" "potato"])
{"one" 1, "potato" 2, "two" 1}
19. map 함수
map은 컬렉션의 각 원소에 같은 함수를 적용하는 함수다.
- 각 원소에 2를 곱함
>(map (fn [x] (* 2 x)) [0 1 2 3 4 5])
0 2 4 6 8 10
20. 순차적 단어 세기
(defn count-words-sequential [pages]
  (frequencies (get-words pages)))
전체 페이지에서 단어를 가져온 뒤, 한 번에 단어 빈도를 계산하는 방식이다.
전체 데이터 → 단어 추출 → 빈도 계산21. 병렬 단어 세기
(defn count-words-parallel [pages]
  (reduce (partial merge-with +)
          (pmap #(frequencies (get-words %)) pages)))
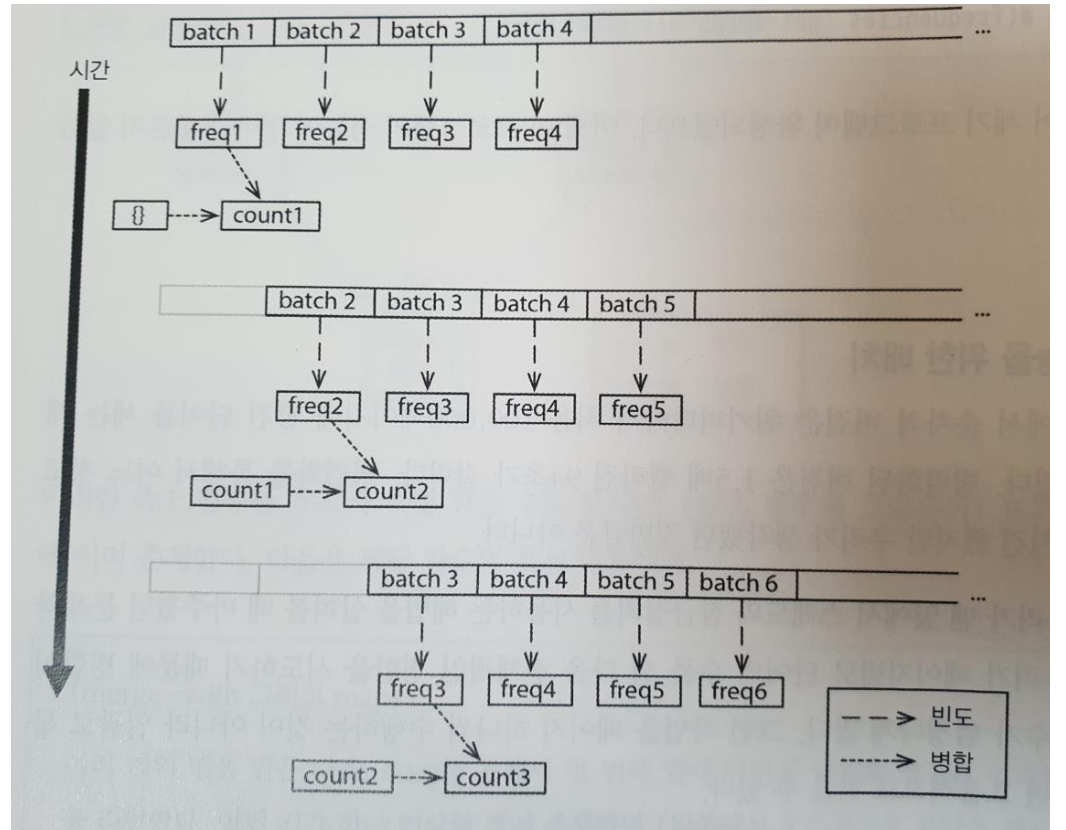
페이지별로 단어 빈도를 병렬 계산한 뒤, 결과를 합친다.
페이지 1 → frequencies
페이지 2 → frequencies
페이지 3 → frequencies
...
각 결과를 merge-with + 로 합침
즉, 큰 데이터를 여러 부분으로 나눠 병렬 처리하는 방식이다.
22. fold 활용
fold는 데이터를 나눠 병렬로 처리한 뒤 결과를 합치는 방식이다.
(defn parallel-frequencies [coll]
  (r/fold
    (partial merge-with +)
    (fn [counts x] assoc counts x (inc (get counts x 0))))
    coll))
데이터를 나눔
→ 각 부분의 빈도 계산
→ 부분 결과를 병합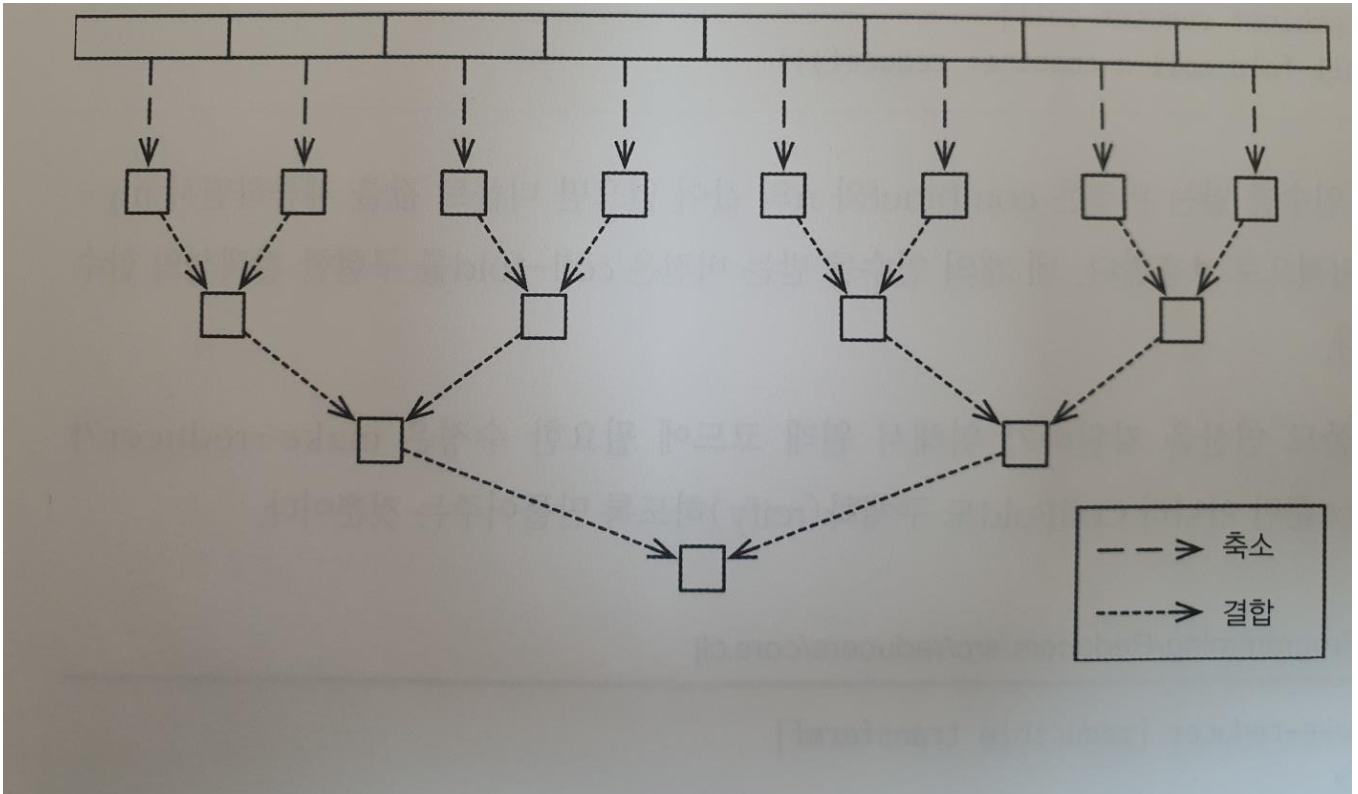
23. MapReduce
MapReduce는 대용량 데이터를 분산 처리하는 대표적인 모델이다.
- Map 단계
→ 데이터를 나누어 각 부분을 처리 - Reduce 단계
→ 처리 결과를 하나로 합침
단어 세기 예제로 보면 다음과 같다.
Map: 각 문서 또는 페이지에서 단어 빈도 계산
Reduce: 각 결과를 합쳐 전체 단어 빈도 계산
MapReduce의 기본 아이디어는 예전부터 있던 방식이다.
예를 들어 큰 작업을 하나가 한 번에 처리하는 것보다,
작은 부분으로 나누어서 여러 개가 동시에 처리하면 더 빠르다.
이런 방식은 원래 컴퓨터 구조나 운영체제에서도 쓰이던 개념이다.
MapReduce는 이 개념을 분산 시스템 환경에 적용한 것이다.
24. Hadoop 생태계
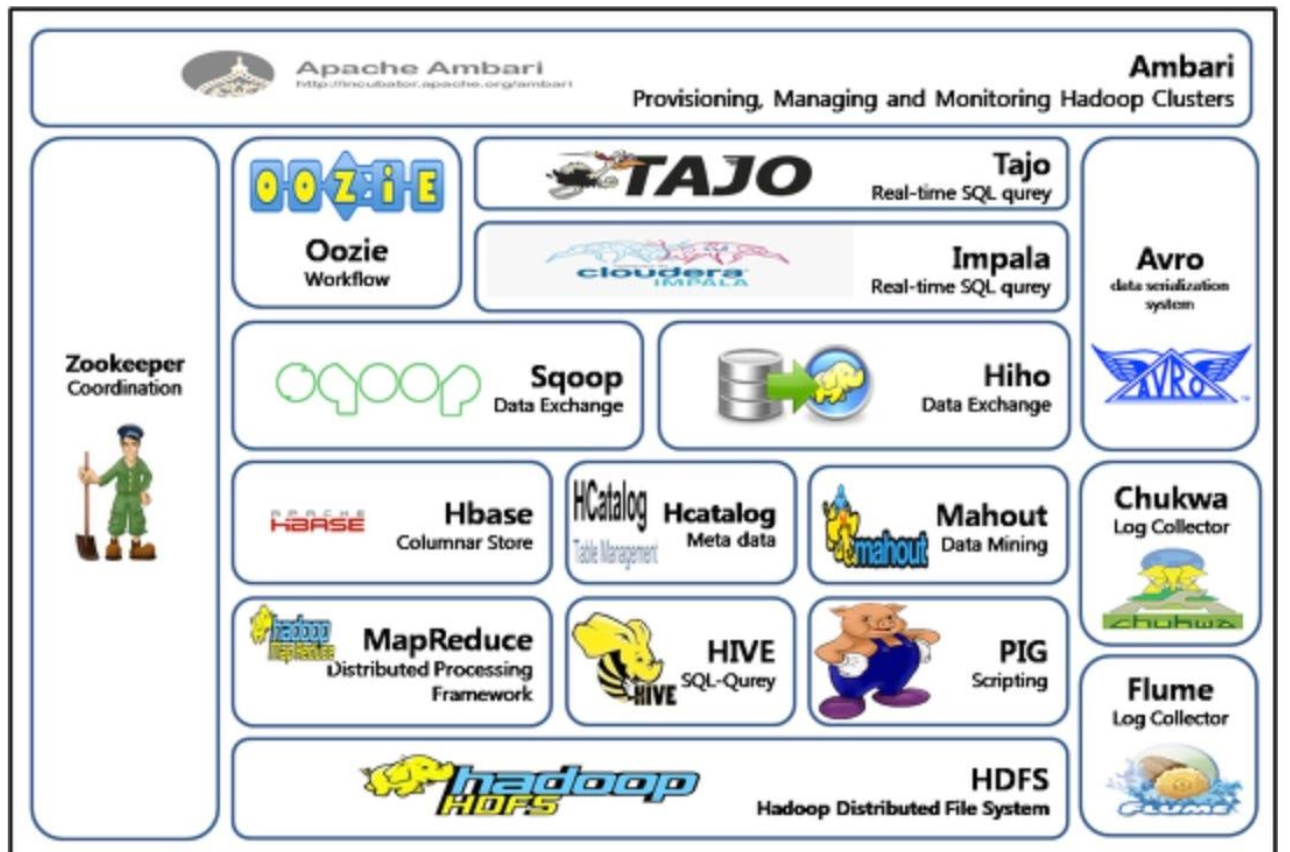
Hadoop은 대용량 데이터를 여러 컴퓨터에 나누어 저장하고, 병렬로 처리하기 위한 분산 처리 플랫폼이다.
전체 요약
동시성은 여러 작업을 동시에 다루는 구조이고,
병렬성은 여러 작업을 실제로 동시에 실행하는 구조이다.

스레드와 lock은 동시성 구현에 사용할 수 있지만,
공유 가변 메모리 때문에 유지보수가 어렵고 버그가 발생하기 쉽다.

이를 줄이기 위해 함수형 언어는 불변성을 강조하며,
Clojure 같은 언어는 병렬 처리와 대용량 데이터 처리를 간결하게 표현할 수 있다.

MapReduce는 데이터를 나누어 처리하고,
결과를 합치는 대표적인 병렬/분산 처리 모델이다.