프로젝트 관리(Management)
목적
- 작업 수행에 필요한 자원(인력/비용/재료/기술 등)을 가장 효과적으로 사용해 프로젝트 목표 달성
관리의 어려움
- 개발 대상이 눈에 보이지 않음
- SW 기술 발전이 매우 빠름
- 조직마다 프로세스가 다름
프로젝트 관리 활동 요소
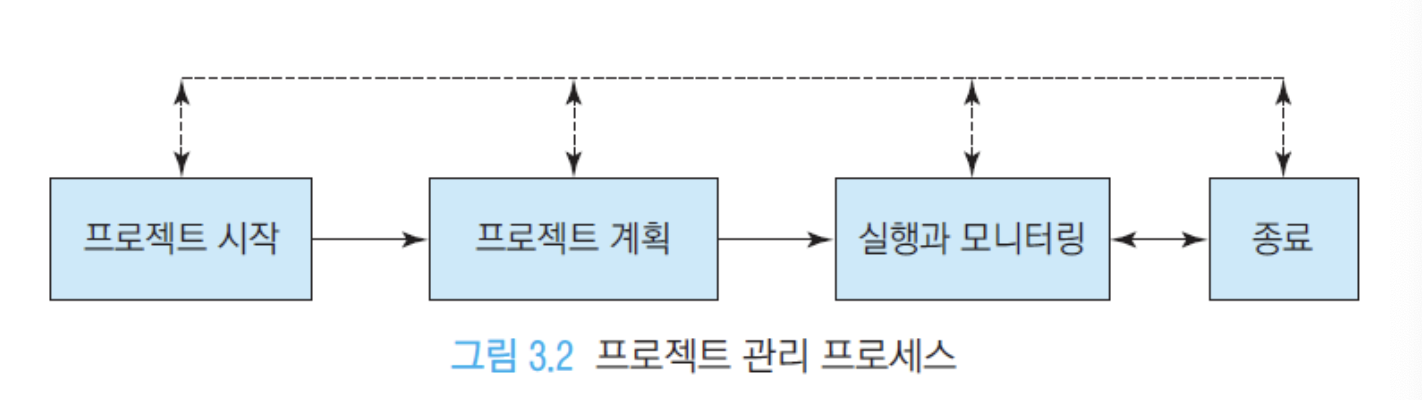
- 계획(Planning)
- 조직(Organizing)
- 모니터링(Monitoring)
- 조정(Controlling/Coordinating)
1 프로젝트 시작
시작 시 해야 할 것
- 목표를 세우고 가치(Value)와 리스크(Risk)를 이해
프로젝트의 시작을 결정할 요인
- 프로젝트가 제공할 가치
- 프로젝트와 관련된 리스크
1.1 프로젝트 가치
포르젝트 가치를 평가하는 방법
- 투자 회수 기간
투자금과 같은 금액을 벌어들이는 데 걸리는 시간 - ROI(Return of Investment)
총비용에 대한 연간 평균 이익률 - 순수 현재 가치
현재 투자금과 미래 수익금을 현재 가치로 비료하는 방법 - 평가표
금액적인 요소 이외에 기술, 품질, 시간 여유, 인력 등을 고려하여 점수화하는 방법 - SWOT
프로젝트의 강점, 약점, 기회요인, 위험요인을 파악하여 타당성을 이해하는 방법
1.2 프로젝트 리스크
위험 요인
- 자원(현재 사용량/가용성, 예상 사용량/가용성, 우선순위/중요도)
- 시간 (너무 빠르거나 느린 배포는 경쟁사가 유사한 소프트웨어를 출시할 수도 있다)
- 기술적 어려움
1.3 타당성 분석
타당성 분석 항목
- SOW: 프로젝트가 성취해야 할 일
- 비즈니스 목표(가치): 결과물
- 예산: 비용/수익 요약
- 프로젝트 일정: 대략 일정
- 프로젝트 리스크: 위험 요소
- 대안: 구축/구매 등 방법
- 평가: 프로젝트 가치 평가 결과
2 프로젝트 계획과 스케줄링
초기 계획(Initial Planning)
- 목표 설정
프로젝트의 특성은 무엇이며 누가 자원을 제공하며 누가 사용할 것인지 정한다. - 일정 정의
프로젝트 작업의 진행 스케줄과 할당한 자원을 정한다.
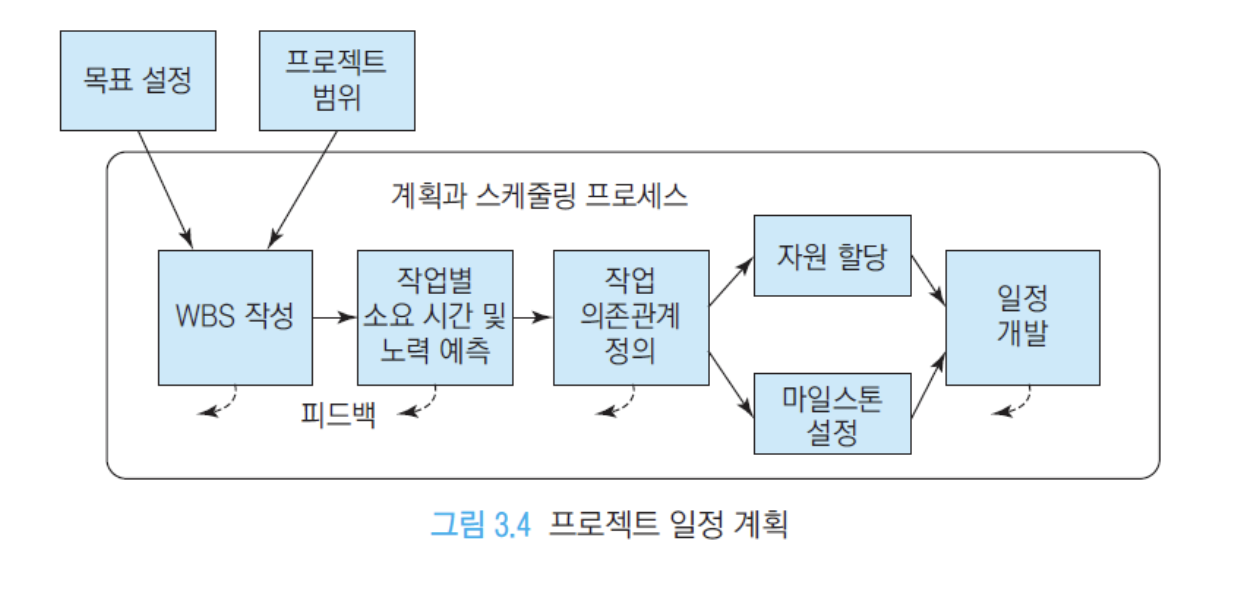
목표+범위 설정 → SOW (프로젝트의 문제를 정의한 문서) 작성 → WBS 분석 → … - 비용 추정
프로젝트를 완성시키기 위하여 필요한 비용을 추정한다.
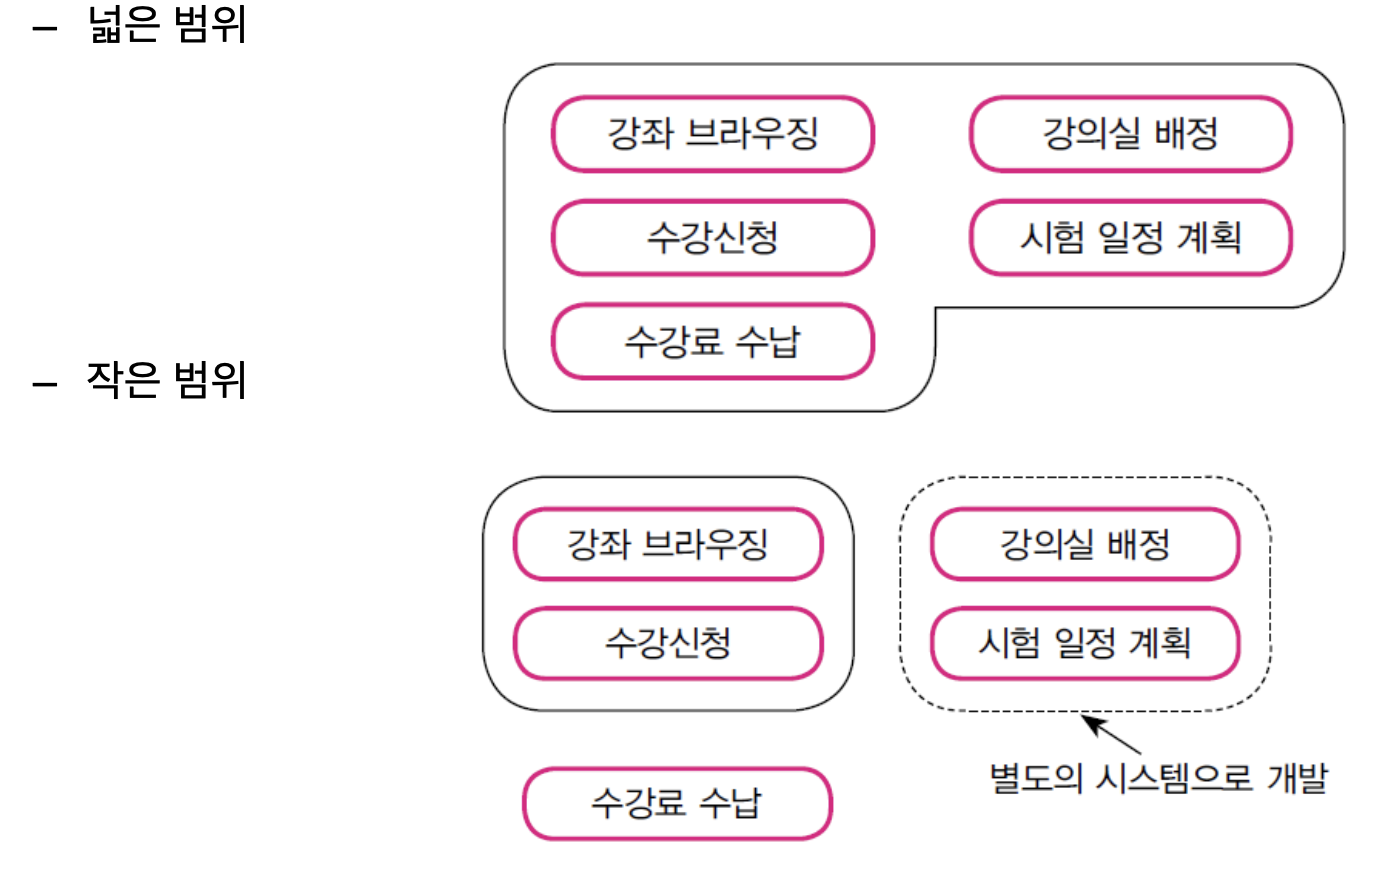
2.2 프로젝트 범위 정하기(Scope)
- (예시로 수강신청 시스템) 넓은 범위 vs 작은 범위로 범위를 어떻게 잡느냐에 따라 프로젝트가 달라짐
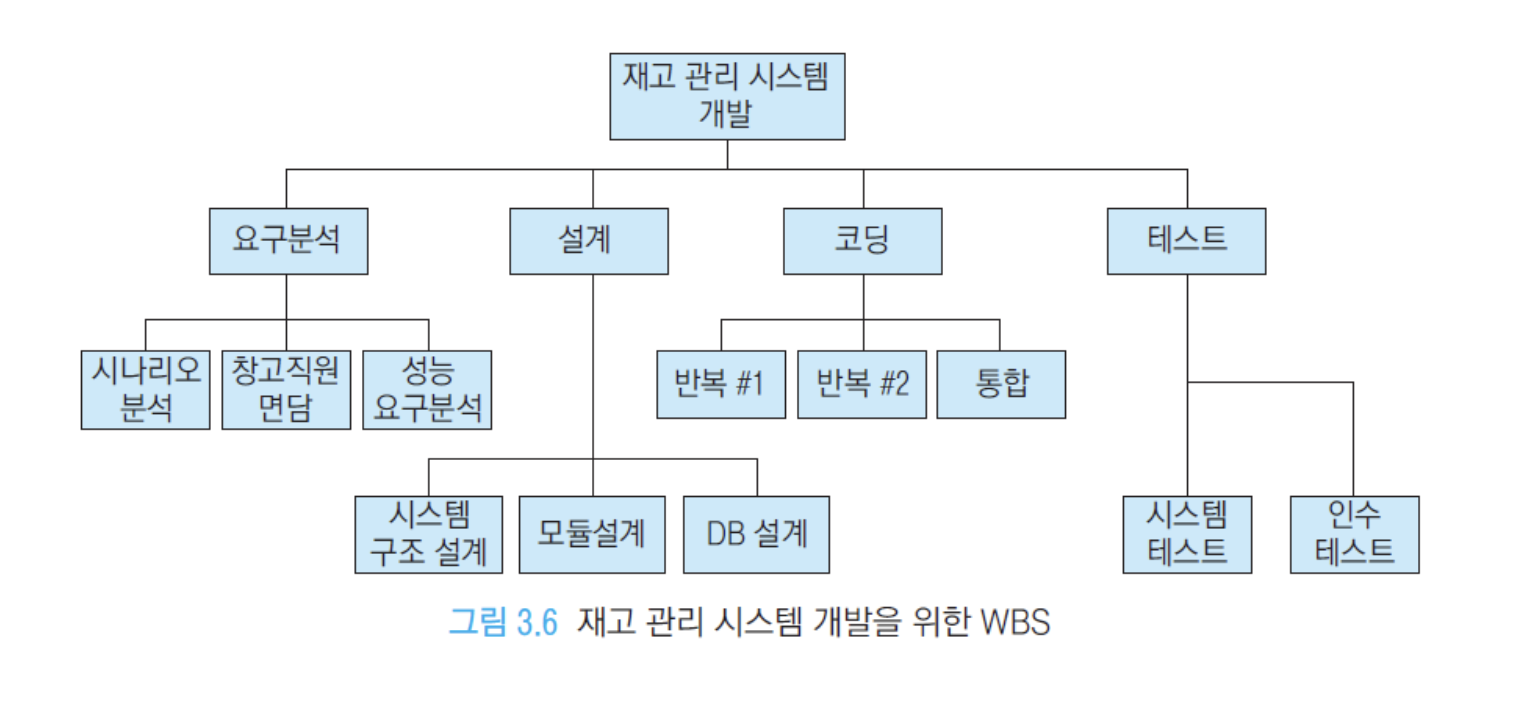
2.3 WBS(Work Breakdown Structure)
- 프로젝트 목표 달성/결과물 산출을 위해 해야 할 작업을 계층적으로 분할한 것
- (교수님 설명) “여러분에게 WBS를 짜오라 할 거예요. 어떤 DB를 사용할지 같은 것까지 포함해서, 여러분이 무엇을 할지를 계층적으로 정리하는 게 WBS예요. 잘 기억해야 해요.”
- WBS에는 “해야 할 일”뿐 아니라, 목표를 달성하기 위한 방법/접근(어떻게 할지)도 함께 정리된다고 보면 됨
2.4 스케줄링(Scheduling)
WBS를 기초로 하여 일정을 정의하는 것.
스케쥴링 결과는 간트 차트로 표현되는데 다음과 같은 순서의 작업이 필요하다.
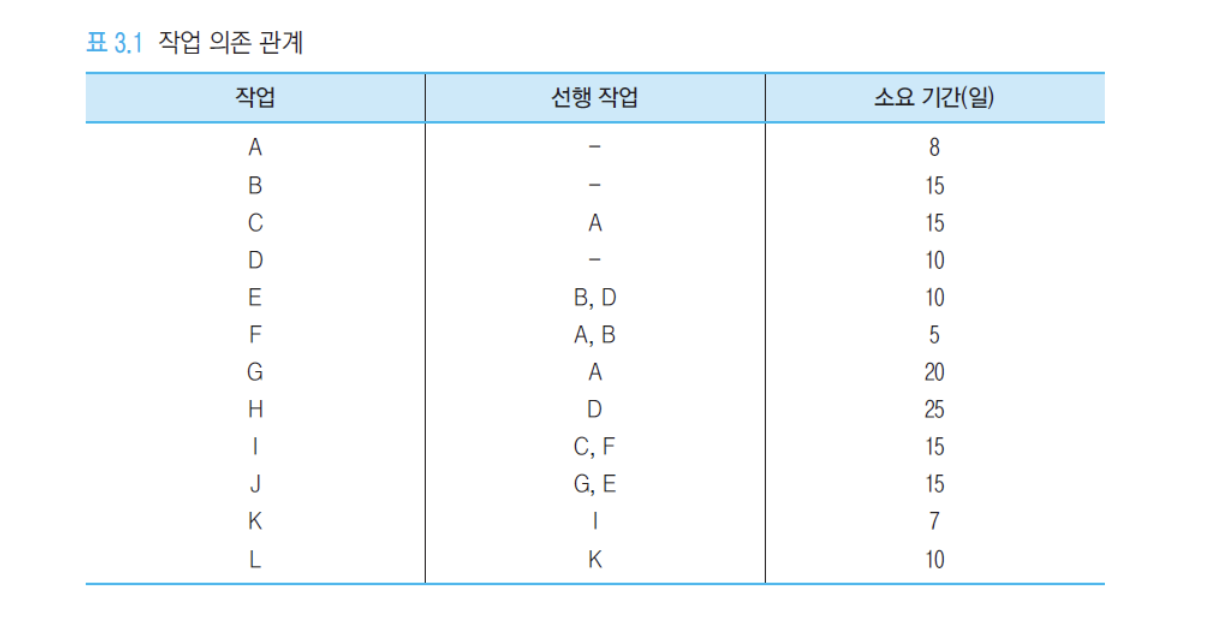
- 작업 사이의 의존 관계 파악
- CPM 방법을 이용한 여유 시간 계산
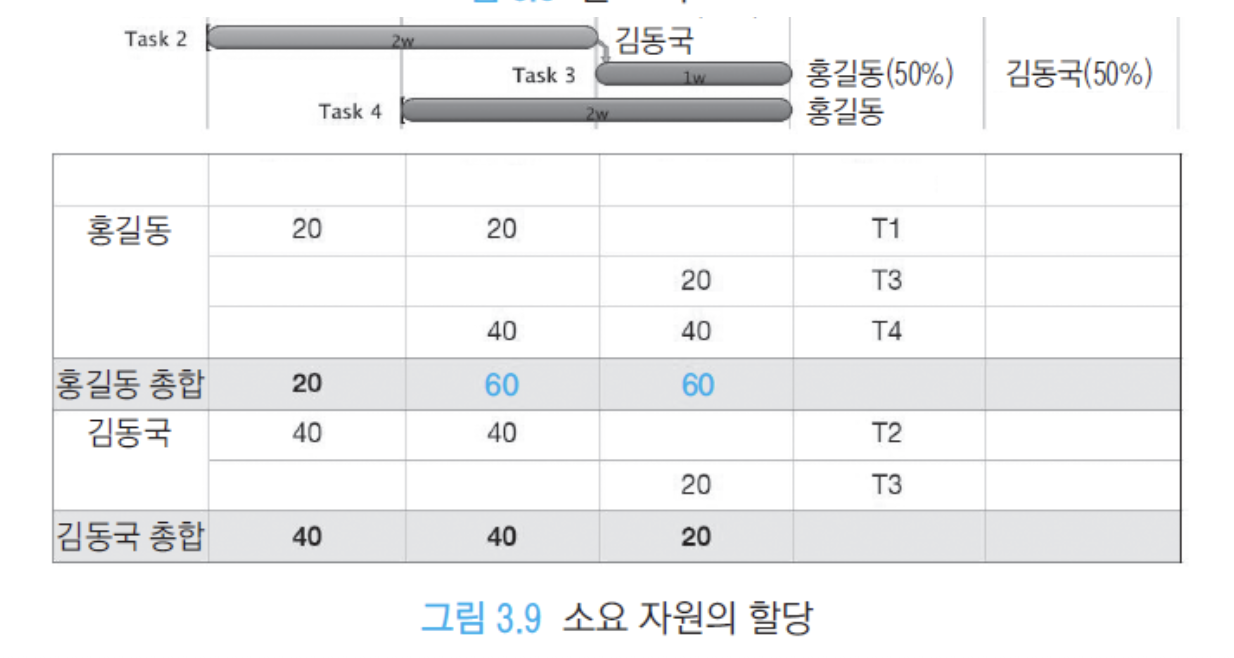
- 소요 자원의 할당
- 목표 설정 / 프로젝트 범위 → WBS 작성 → 작업별 소요 시간 및 노력 예측 → 작업 의존관계 정의 → 자원 할당 / 마일스톤 설정 → 일정 개발(스케줄 확정)
- 각 단계는 진행하면서 피드백을 통해 다시 조정될 수 있음
작업 의존관계(Dependency)
- 작업 사이의 선후관계를 정리하는 단계
- (교수님 설명) “작업 간 의존관계를 잘 생각해야 해요. 이 작업을 하기 위해 먼저 해야 할 작업이 무엇인지를 정해야 해요.”
- 선행 작업이 끝나야 다음 작업이 시작될 수 있도록 순서를 잡고, 그 흐름대로 일정을 만들면 됨
- 강한 의존관계 : 코딩이 끝나야지 테스팅이 가능함.
- 약한 의존관계: 순서에 따라 다른 계획이 가능함.
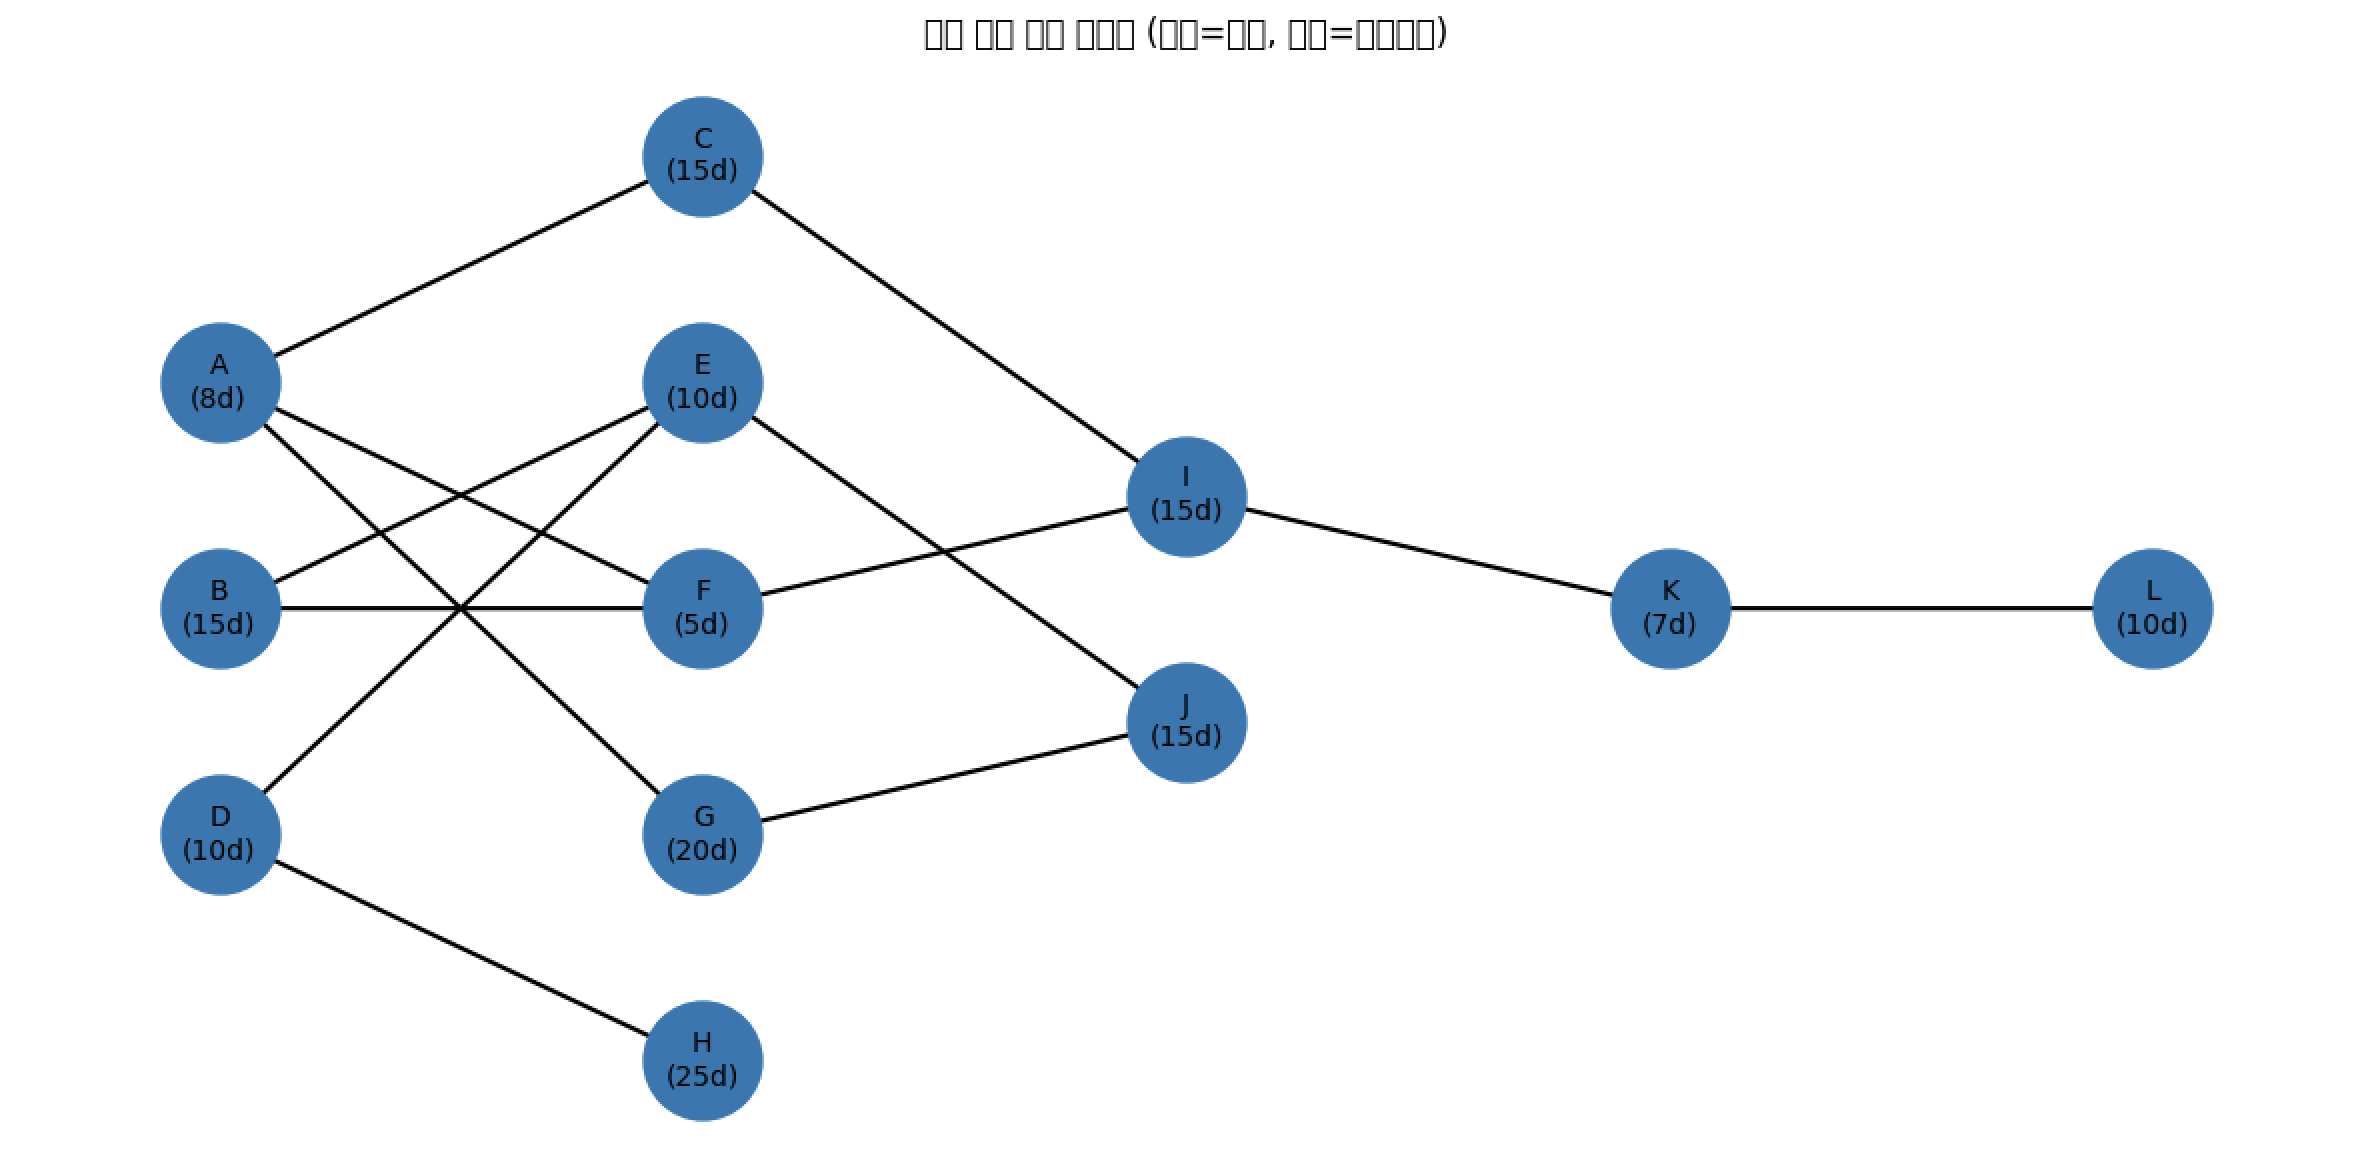
의존관계 네트워크(PDM/AON)
CPM 네트워크
노드와 간선으로 구성된 네트워크
-
CPM 네트워크는 어떤 작업이 필요하고 각각 얼마나 걸리며 각 작업의 선후 관계를 한눈에 볼 수 있도록 나타내어 전체 프로젝트의 최소 소요 기간을 구하는데 사용한다.
-
노드: 작업
-
간선: 작업 사이의 선후 의존 관계
-
TE: 각 작업에 대한 가장 이른 시작일
-
TL: 각 작업에 대한 가장 늦춘 시작일
임계 경로와 여유 시간 계산
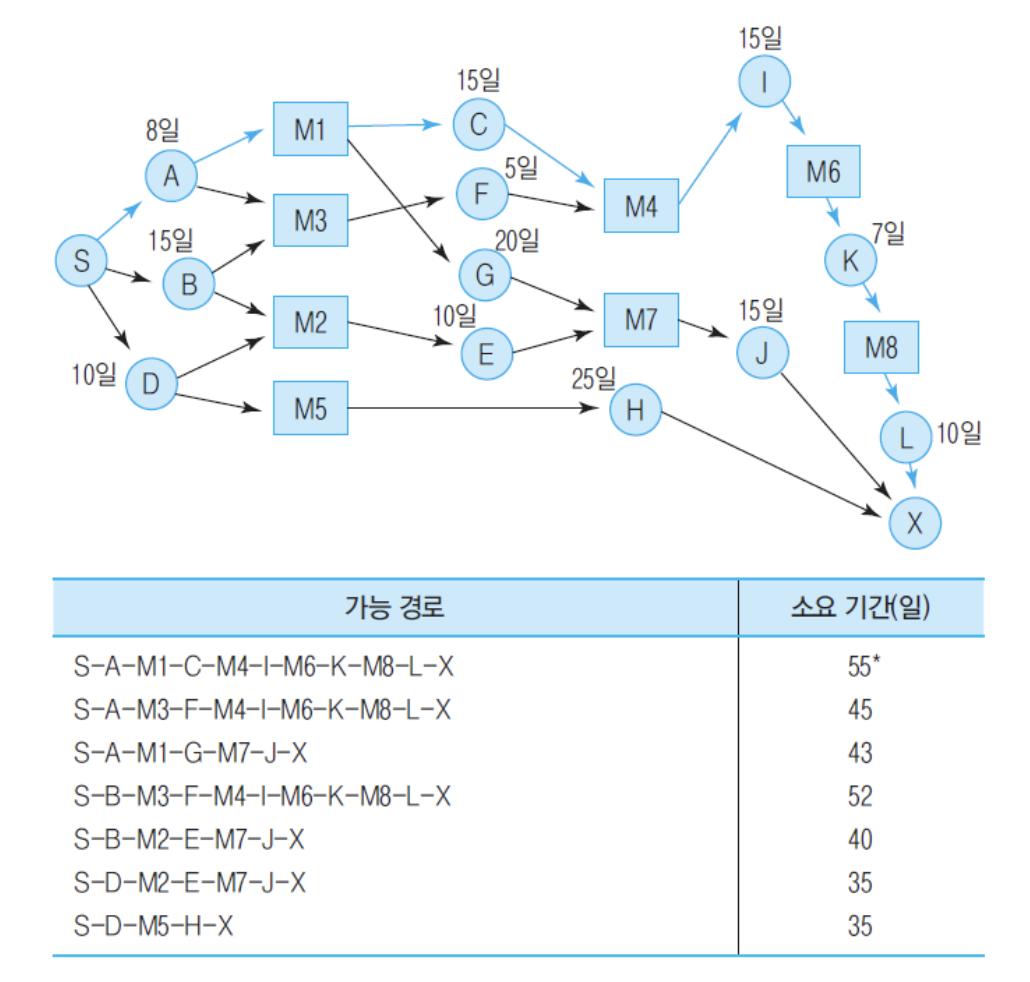
CPM 네트워크와 임계 경로
- 임계 경로 : 가장 소요 기간이 긴 경로 S-A-C-I-K-L-X 작업 : 55일
- 임계 경로 상에 어떤 작업이라도 늦추어진면 전체 프로젝트가 지연된다.
- 여유 시간 TS
- C의 TE (가장 빠른 착수일) : 8일이 지난 다음 날.
- 여기서 15일이 지난 후, 즉 23일이 경과해야지 작업 C를 끝낼 수 있다.
- C의 TL (가장 느린 착수일): 최대경로(55일)에서 C(15), I(15), K(7), L(10)을 뺀 8일
- TS = TL - TE = 8 - 8 = 0
- 여유 시간이 0이므로 C 작업은 임계경로에 있다.
- E의 TE (가장 빠른 착수일) : B가 끝나는 15일 후에 가능
- E의TL (가장 느린 착수일) : 55에서 E(10), J(15)을 뺀 30일
- TS = TL - TE = 30 - 15 = 15
- 여유 시간이 15일이 있으므로 E 작업은 임계경로에 없다.
자원 할당과 간트 차트
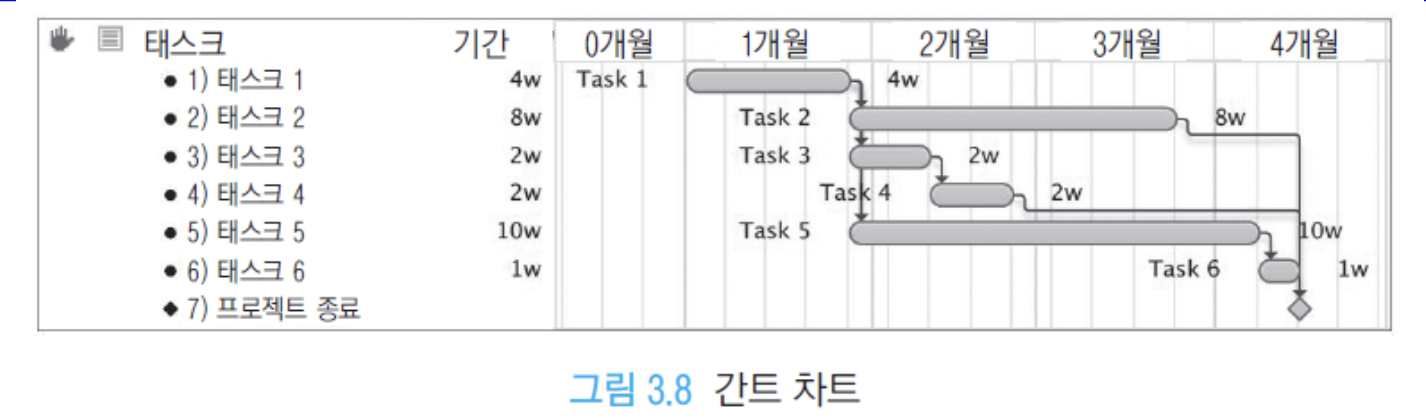
- 간트차트(Gantt chart)로 일정 시각화
- 각 작업에 대한 여유 시간을 구한 후 작업 별로 시작과 종료 기간을 수평 막대로 표현 한 것
- 소프트웨어에 필요한 자원
- 인력: 주어진 작업을 수행할 인원과 투입률
- 장비: 주어진 작업을 수행할 때 필요한 도구나 하드웨어 및 소프트웨어
- 재료: 주어진 작업을 수행할 때 필요한 소모품이나 자료
3 비용 예측 기법
노력/자원/기간 관계
- D = E / M
- D(duration): 기간
- E(effort): 노력
- M(manpower): 인원(자원)
- 3MM = 3사람이 1달 동안 작업한 노력
-
80시간의 노력, 2명을 100% 투입
→ 80시간 / (2명 x 40시간) = 1주
-
80시간의 노력, 1명을 50% 투입
→ 80시간 / (1명 x 20시간) = 4주
- 비용 예측의 중요한 변수 = 투입 엔지니어 인원수 + 작업 기간
비용 예측 기법 종류
- 전문가 판단
- PERT(Program Evaluation and Review Technique)
- A: 낙관적이었을 때의 소요 예측 기간
- B: 보통이였을 때 소요될 시간
- C: 비관적이였을 때의 소요 예측 기간
- 알고리즘식 방법
- 비용 인자와 비용간의 상관 관계를 분석
- COCOMO, 기능점수, COSMIC 기능 점수 모델
3.1 COCOMO-81
- (교수님 코멘트) “중요한 내용입니다. 기능점수(FP) 얘기가 나오기 전 단계로, 비용 예측은 COCOMO-81부터 시작한다고 보면 돼요.”
- COCOMO-81은 소프트웨어 개발 비용(노력/기간)을 추정하기 위해, 개발 소프트웨어의 유형, 팀 특성, 프로젝트/프로세스 특성 등 여러 요인을 고려하고 요인들 간의 수학적 관계를 모델로 만든 것.
- A = 기관의 특징과 SW의 유형
- Size = SW의 규모 (개발될 소프트웨어의 원시코드 라인 수나 기능점수에 해당)
- B = 1 ~ 1.5 (SW 규모에 따른 비용의 증가가 선형적이지 않을 수 있음)
- M = 프로젝트에 영향을 주는 요소
- (요지) Size(규모)와 프로젝트 특성 요인(M)을 넣어 “사람-개월(PM)” 같은 노력 값을 추정
- 강의록 표에서 보이는 것처럼, 공식의 계수/지수값(A, B 등)은 프로젝트 유형별 노력(Effort) 값을 의미한다고 이해하면 됨.
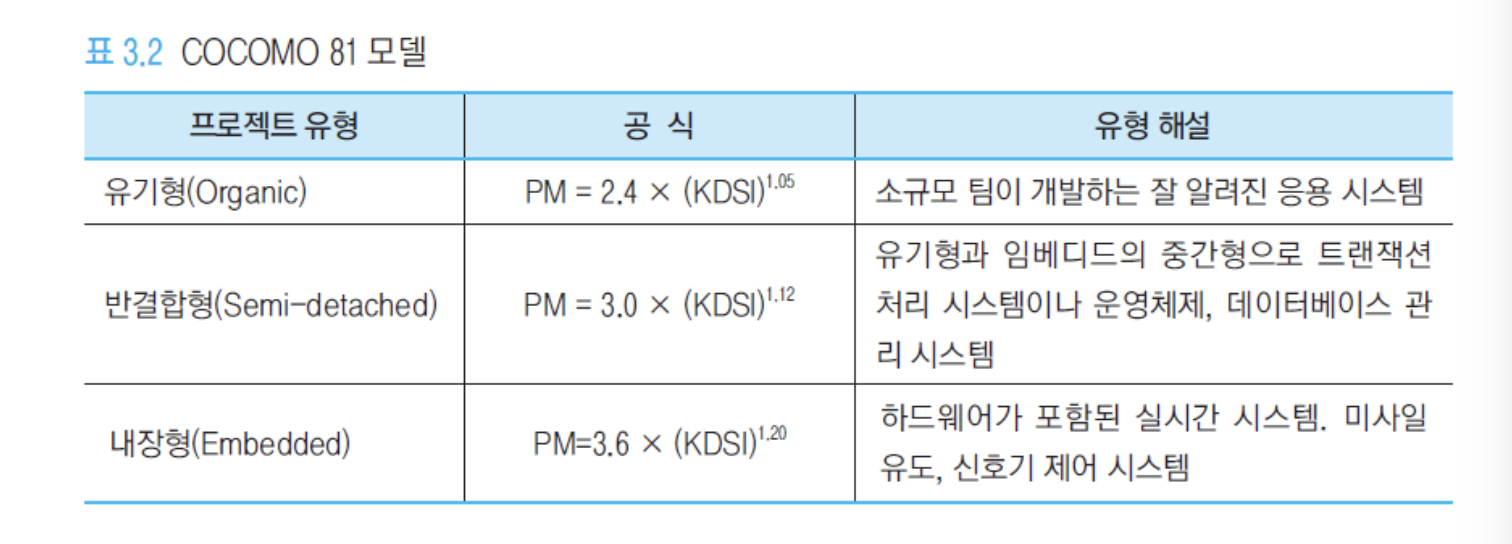
KDSI = Kilo Delivered Source Instruction : 천 단위로 묶은 것
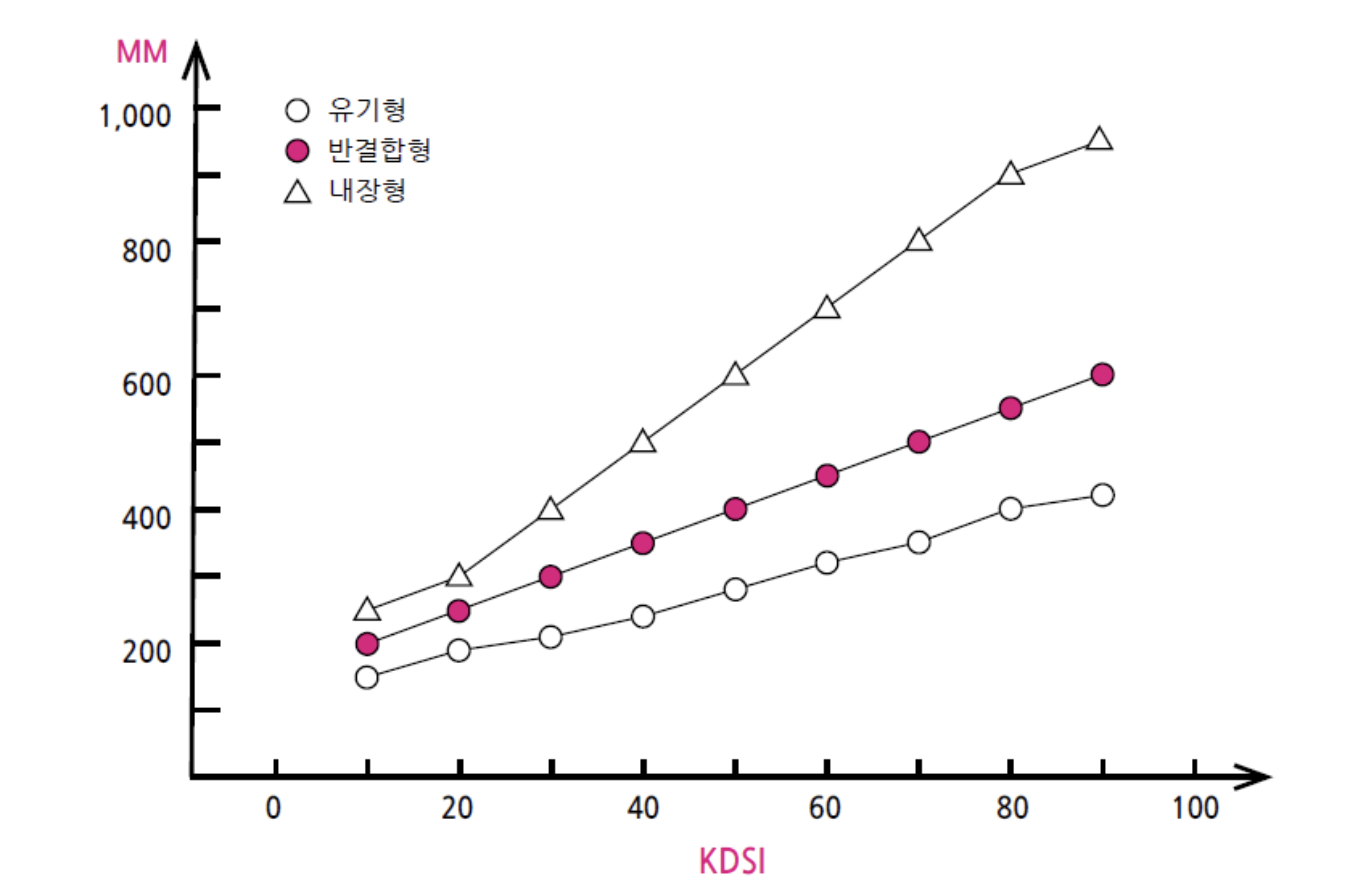
COCOMO-81에 의한 비용 예측
COCOMO 노력 승수
단점
- 초기 단계에서 Size 예측이 어려움
- B, M 값에 영향 주는 요소가 주관적
- 보정(calibration) 필요
- 그러나 모델을 수정할 만큼 충분한 데이터를 수집하는 기관이 드뭄
3.2 COCOMO II (1995)
- 프로젝트 진행 정도에 따라 3가지 모델 제시
- 프로토타입 단계
- 화면/출력(UI)·3세대 언어 컴포넌트 개수로 응용점수(application points) 계산 → 노력 추정
- 초기 설계 단계
- 구조/기능을 자세히 탐구
- 구조 설계 이후 단계
- 시스템에 대한 자세한 이해 기반
-
- : 기초 소요 노력 예측
- : 비용 승수 벡터
OP(Object Points)
- OP = Object + Points
- 여기서 Object는 보통 화면(Screen), 보고서(Report) 같은 “객체”를 의미
추정 과정
- 화면/보고서/3세대 언어 컴포넌트 수 카운트
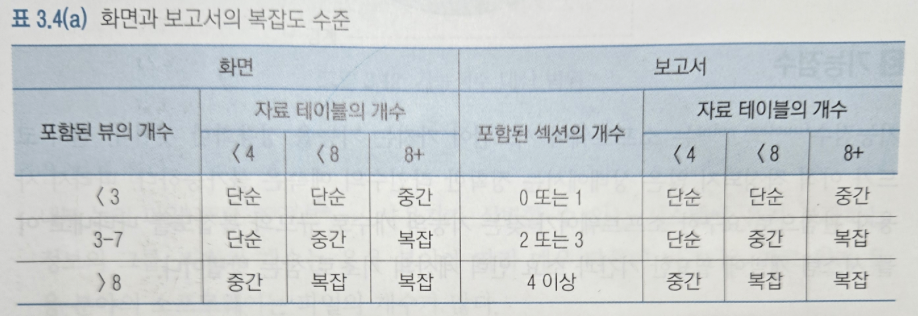
- 화면/보고서 복잡도 수준 결정
-
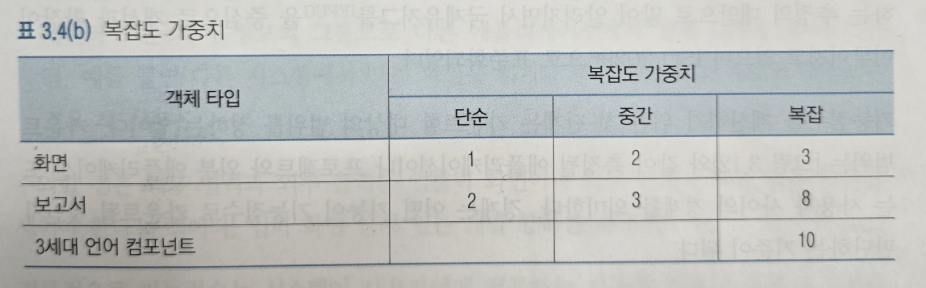
복잡도 가중치 찾기
-
개수×가중치로 객체점수(Object Point) 계산
-
재사용률로 NOP(New Object Point) 계산
-
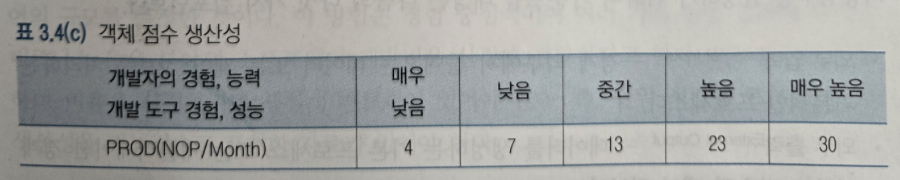
생산성(PROD) 결정
- PM = NOP / PROD 로 최종 PM(Person Month) 산출
COCOMO II를 이용한 노력 예측
- 계획 단계에 시스템의 일부를 프로타이핑할려고 함.
- 4개의 화면, 3개의 보고서
- 3세대 언어 컨포넌트 사용 X
- 각 화면: 뷰 1개, 서버 자료 테이블 1개
- 한 보고서
- 섹션 2개, 자료 테이블 0개
- 나머지 2개 보고서
- 각각 섹션 4개 이상, 각각 4개의 서버 테이블 접근
- 프로토타입의 50%는 이미 존재하는 컴포넌트를 재사용
- 개발 환경은 중간급, 응용 도메인에 대한 경험은 거의 없음
1. 객체 점수(Object Points) 산정
화면(Screen)
- 단순형 4개 × 1점 = 4점
보고서(Report)
- 단순형 1개 × 2점 = 2점
- 복합형 2개 × 8점 = 16점
총 객체 점수
- 4 + 2 + 16 = 22점
2. 신규 객체 점수(NOP) 계산
- 재사용률: 50%
- 계산식: 22 × (1 - 0.5)
- 결과: 11점
3. 생산성(Prod) 산정
조건
- 낮은 개발 경험: 7
- 보통의 도구 성능: 13
평균값
- (7 + 13) / 2 = 10
결과
- Prod = 10
4. 최종 노력(Effort) 추정
공식
- Effort = NOP / Prod
계산
- 11 / 10 = 1.1 MM (Person-Month)
최종 답
- 객체 점수(Object Points): 22점
- 신규 객체 점수(NOP): 11점
- 생산성(Prod): 10
- 최종 노력(Effort): 1.1 MM
3.3 기능 점수(Function Points, FP)
- 정확한 라인수(LOC)는 예측 불가
→ 기능 단위로(입력/출력/질의/파일/인터페이스 개수) 규모를 나타냄<aside> **기능 점수를 산정하기 위하여 카운트할 5가지 컴포넌트** - EI (외부 입력): 경계 외부에서 들어오는 데이터 또는 제어 정보를 처리하는 기본적인 프로세스 - EO (외부 출력): 데이터를 생성하는 기본 프로세스 또는 애플리케이션 경계 외부로 전송된 제어 정보 - EQ (외부 질의): 입력, 출력 조합으로 구성된 기본 프로세스로 데이터 검색을 하게 한다. - ILF (내부 논리 파일): 사용자가 식별할 수 있는 시스템에 유지 보관하는 정보의 그룹. 파일의 개수는 응용 분야에 따라 매우 다른데 비즈니스 자료 처리 응용 분야의 소프트웨어는 파일의 개수가 많다. - ELF (외부 논리 파일): 사용자가 식별할 수 있는 논리적으로 관련된 데이터 또는 제어 정보의 그룹으로 다른 애플리케이션에서 경계 내부로 유지 보관됨. ex) 다른 시스템에서 만든 파일을 읽거나 통신 라인으로 자료를 전달받는 경우 </aside> - FP는 “단위 프로세스(기능)” 관점으로 본다고 이해하면 됨
- 기능 점수 1을 구현하기 위한 LOC(언어별 예시)
- Assembly 324 / C 150 / Pascal 91 / Ada 71 / APL 32
- 총 라인 수 = FP x 원하는 언어의 1점 당 LOC
1) EI / EO / EQ = 트랜잭션(사용자 접점)
- EI (External Input): 외부 입력(사용자가 시스템에 입력하는 것):
- EO (External Output): 외부 출력(시스템이 사용자에게 결과를 제공하는 것 중 처리/가공이 큰 출력)
- EQ (External Query): 외부 조회(사용자 요청에 대한 단순 조회/검색 결과)
교수님 포인트
- EI, EO, EQ는 사용자와의 접점(프론트 쪽 상호작용) 중심이다.
- 이 EI/EO/EQ를 묶어서 트랜잭션 프로세스(Transaction Process)라고 부른다. → 여기서 트랜잭션은 “DB와 관련된 처리”라고 이해하면 됨.
- EI와 EO는 입출력 화면이나 파일 단위의 그룹 항목 개수를 세어야함.
EQ vs EO 차이 (중요)
- 핵심 기준은 “계산/가공이 복잡하냐”
- 단순히 SQL 조회 결과를 보여주는 수준이면 EQ
- 더 복잡한 계산/가공/비즈니스 로직이 들어가면 EO
질문: SQL에서 AVG, COUNT 같은 계산이 있으면 EO냐?
- 교수님 답: 아니다. 보통 AVG/COUNT 정도는 EO로 보지 않고 EQ로 본다.
- EO는 “단순 집계 수준을 넘는 더 복잡한 계산/가공”이 있어야 한다고 보면 됨.
2) ILF / EIF = 데이터(백엔드/논리 경계) (FP 차원의 점수가 더큼)
- ILF (Internal Logical File): 시스템 내부에서 관리되는 파일/테이블(논리 파일)
- 파일 형태일 수도 있고 DB 테이블 형태일 수도 있음
- ILF(내부 테이블/파일)가 많을수록 FP가 커진다
- EIF (External Interface File): 외부 시스템이 관리하는 데이터(내 시스템 입장에서는 외부 데이터)
- 예: 회계 시스템이 인사 시스템과 연동
- 인사 시스템을 내가 직접 관리하지 않으면 회계 시스템 입장에서는 EIF
- 물리적으로 떨어져 있어도 내가 둘 다 관리하면 내 입장에서는 ILF
- 예: 회계 시스템이 인사 시스템과 연동
교수님 포인트(핵심)
- ILF vs EIF의 차이 = “논리적인 경계(관리 책임)가 나뉘어 있냐”
- 물리적으로 멀어도 내가 관리하면 ILF, 내가 관리 안 하면 EIF
- EI/EO/EQ는 사용자 접점(프론트 성격)
- ILF/EIF는 시스템 내부 데이터(백엔드 성격)
- FP 관점에서 보통 ILF/EIF 쪽이 점수 영향(비중)이 더 큰 편이라고 이해하면 됨
- EO vs EQ: EO는 더 많은/복잡한 계산·가공, EQ는 단순 조회
기본 개념
- FP = GFP × PCA
- GFP: 총 기능 점수(Gross Function Point)
- PCA: 처리 복잡도 보정 계수(Processing Complexity Adjustment)
- 기능 점수는 구현 언어에 관계없는 메트릭
- 일률 가중치 적용으로 문제 가능
기능 점수 산정 절차
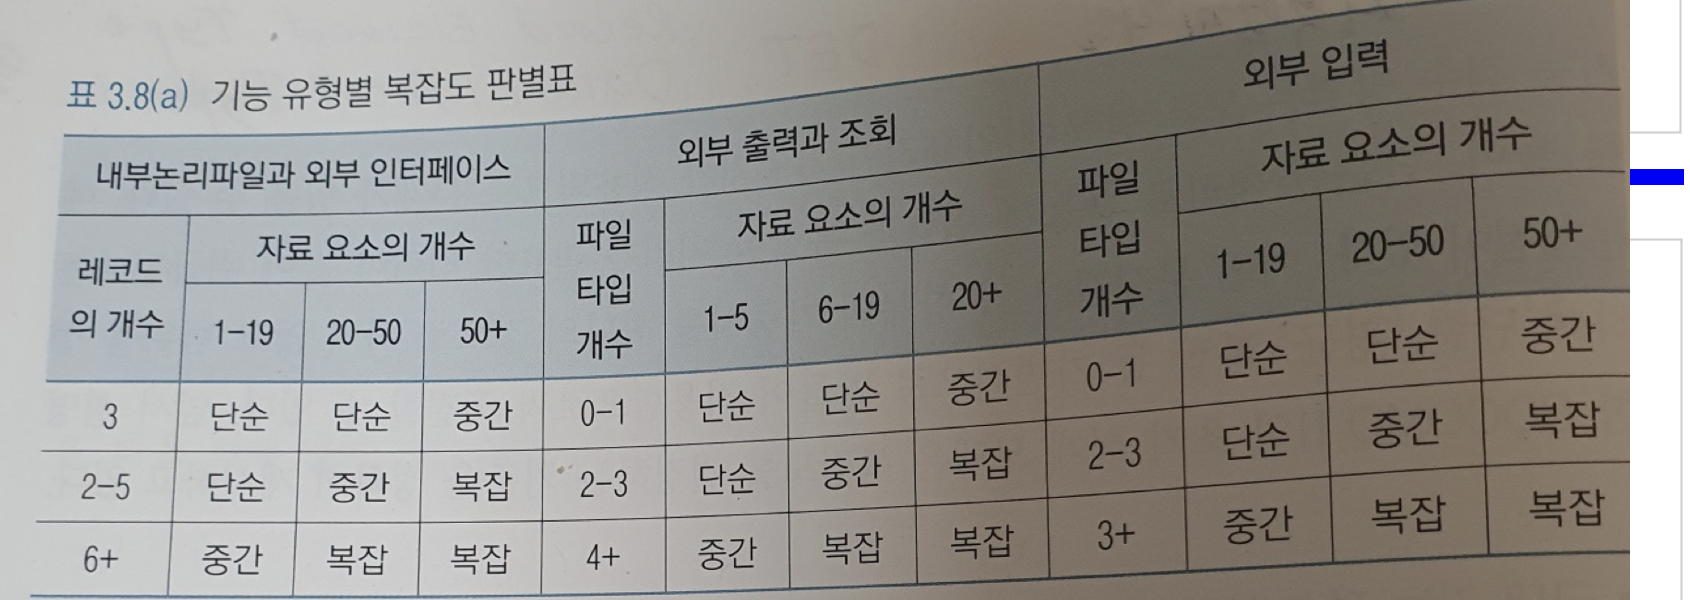
- 5가지 기능 분야 개수 파악
- 복잡도(단순/중간/복잡) 결정
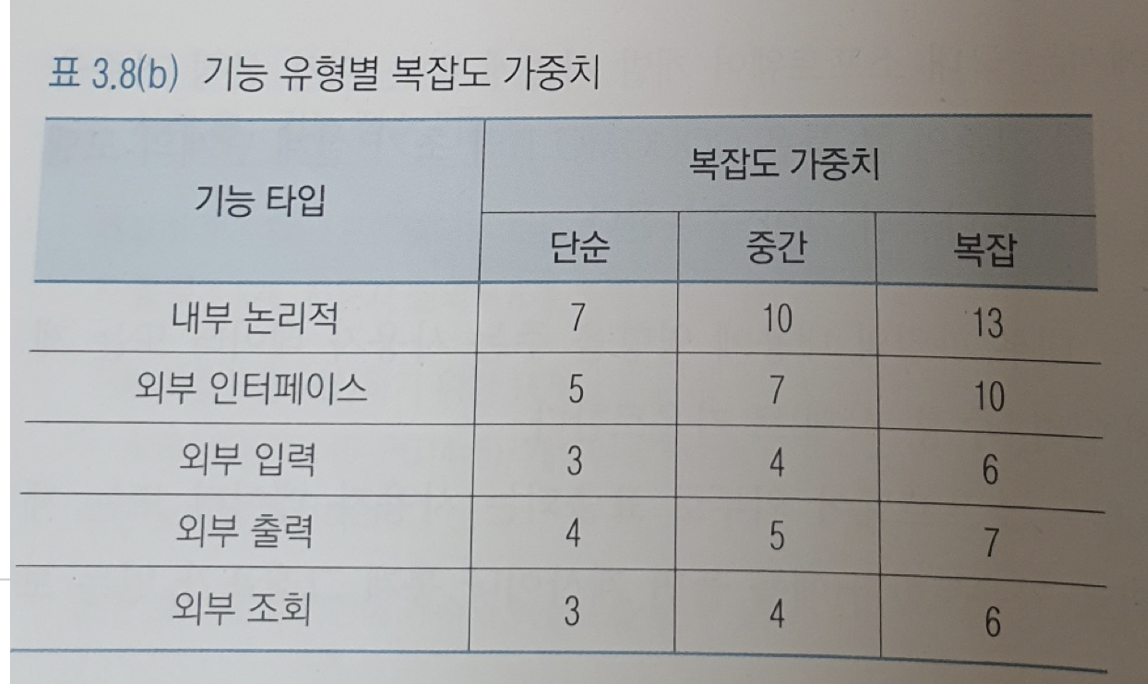
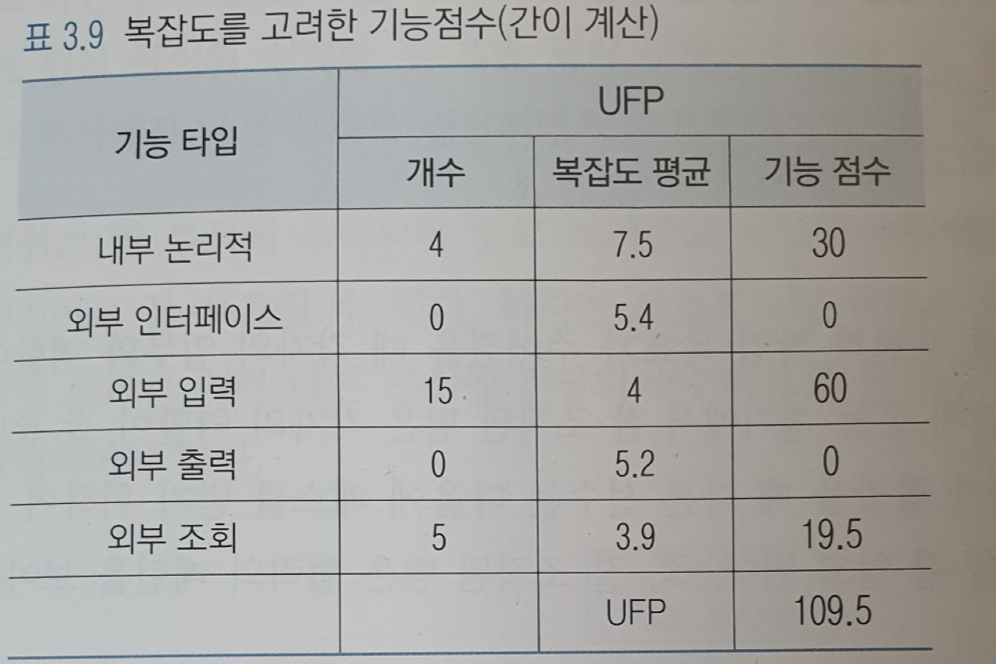
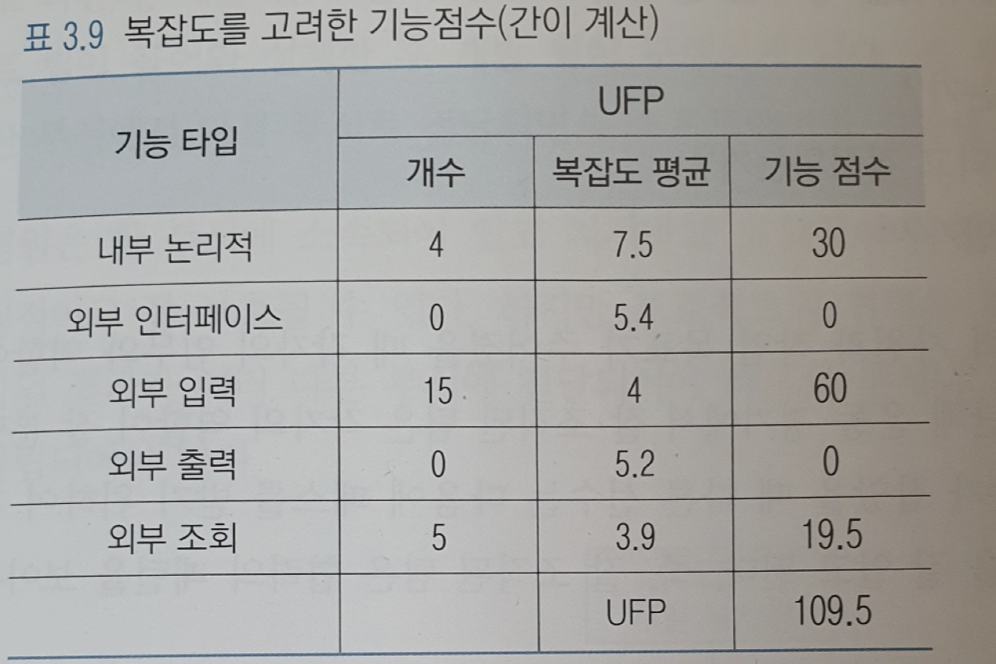
- 개수×가중치로 GFP (=UFP) 산출
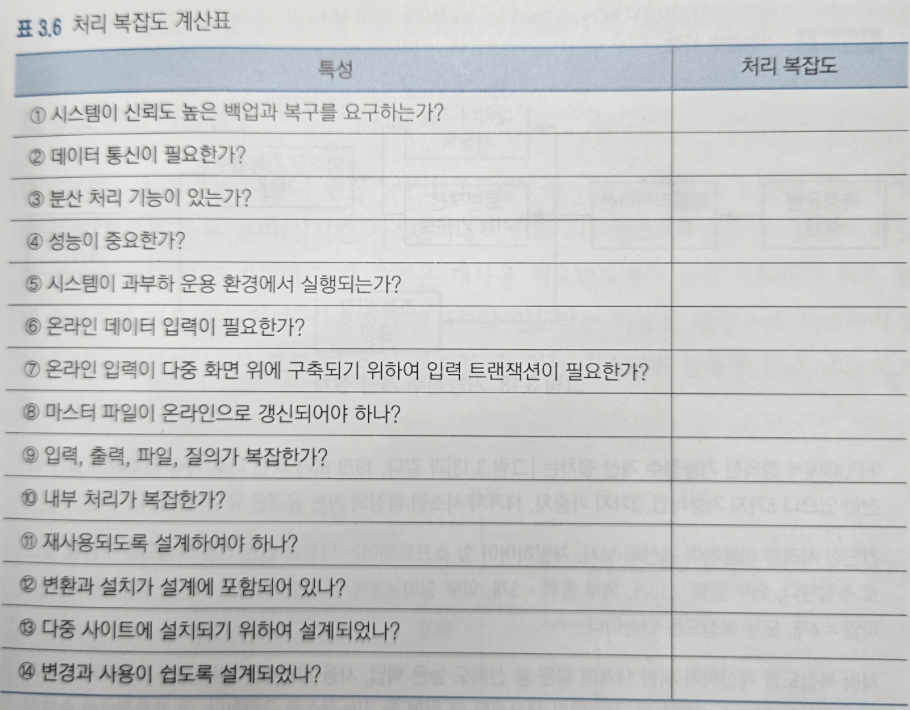
- 14개 질문으로 처리 복잡도 0~5 할당
0: 영향없음 3: 보통 5: 많음
- 식으로 PCA (=TCF)계산
- FP 계산
- FP = GFP × PCA
DET (Data Element Type)
- DET = 필드(field) 개수
- 입력/출력/파일에서 사용되는 의미 있는 데이터 항목(필드)를 센 것
- 일반적으로 DET가 많을수록 더 복잡하다고 본다.
- 예: “주소”를 하나로 받는 게 아니라 우편번호/도로명/상세주소/참고항목처럼 여러 칸으로 입력하면 → DET가 늘어남
FP 복잡도 판단용 카운팅 용어 정리 (사업대가산정)
트랜잭션 프로세스(Transaction Process) 기준: EI / EO / EQ
FTR (File Type Referenced)
- FTR = 해당 트랜잭션(EI/EO/EQ)이 참조하는 ‘데이터 그룹(덩어리)’의 개수
- 쉽게 말해, 한 기능이 처리할 때 관련되는 테이블/파일(또는 논리 데이터 그룹)이 몇 개인지
- 교수님 표현: “상세 그룹의 수 / 그룹 덩어리의 개수”
트랜잭션 프로세스 복잡도는?
- DET(필드 수) + FTR(참조 그룹 수) 조합으로 복잡도(단순/중간/복잡)를 판단한다.
- 정리: FTR은 ‘트랜잭션 프로세스 차원’의 기준
내부 논리 파일(데이터) 기준: ILF / EIF
RET (Record Element Type)
- RET = ILF/EIF 내부의 레코드(논리적 하위 그룹) 개수
- 파일일 수도, 테이블일 수도 있음
- 예: 한 논리 파일 안에 서로 다른 레코드/서브그룹(세부 엔티티 묶음)이 여러 개 있으면 RET 증가
내부 로직(ILF/EIF) 복잡도는?
- DET(필드 수) + RET(레코드/하위그룹 수) 조합으로 복잡도(단순/중간/복잡)를 판단한다.
- 정리: RET는 ‘내부 로직/논리 파일 차원’의 기준
- DET = 필드 수(많을수록 복잡)
- FTR = 트랜잭션(EI/EO/EQ)이 참조하는 그룹/파일 수
- RET = 논리파일(ILF/EIF) 내부의 레코드/하위그룹 수
- 그래서
- 트랜잭션 복잡도: DET + FTR
- 내부 로직(파일) 복잡도: DET + RET
기능점수 사례
- 사용자 입력(EI): 10개
- 사용자 출력(EO): 5개
- 사용자 질의(EQ): 8개
- 자료 파일(ILF): 30개
- 외부 인터페이스(EIF): 4개
- 복잡도: 모두 단순
- 처리복잡도:
- 신뢰도 높은 백업 요구: 5점
- 사용 친근성 매우 높게 요구: 5점
- 나머지 12개 항목: 보통(3점)
- 생산성: 주당 60기능
1.기능 유형별 가중치 적용
복잡도가 모두 단순이므로, 표의 단순 가중치를 사용한다.
- 내부 논리적 파일(ILF): 7
- 외부 인터페이스(EIF): 5
- 외부 입력(EI): 3
- 외부 출력(EO): 4
- 외부 조회(EQ): 3
2. GFP(=UFP) 계산
1) 사용자 입력(EI)
- 10 × 3 = 30
2) 사용자 출력(EO)
- 5 × 4 = 20
3) 사용자 질의(EQ)
- 8 × 3 = 24
4) 자료 파일(ILF)
- 30 × 7 = 210
5) 외부 인터페이스(EIF)
- 4 × 5 = 20
6) GFP(UFP) = 304
3. 처리복잡도(PC) 합 계산
14개 질문에 대한 점수 합을 계산한다.
- 신뢰도 높은 백업 요구: 5점
- 사용 친근성 매우 높음: 5점
- 나머지 12개: 12 × 3 = 36점
- 총 합 = 46
4. PCA(TCF) 계산
PCA = 0.65 + 0.01 × 46
= 0.65 + 0.46
= 1.11
5. 최종 FP 계산
FP = 304 × 1.11 = 337.44
6. 생산성(주당 60기능) 기준 개발 기간 계산
337.44 / 60 = 5.624주
3.4 국내 기능 점수 산정 가이드
- 정보통신연구진흥원 기준 제시(2010)
- 큰 틀은 COCOMO II 초기 설계 모델을 따름
- 외부 입력 / 외부 출력 / 내부 논리 파일(실제 알골리즘) / 외부 인터페이스 파일 / 외부 조회
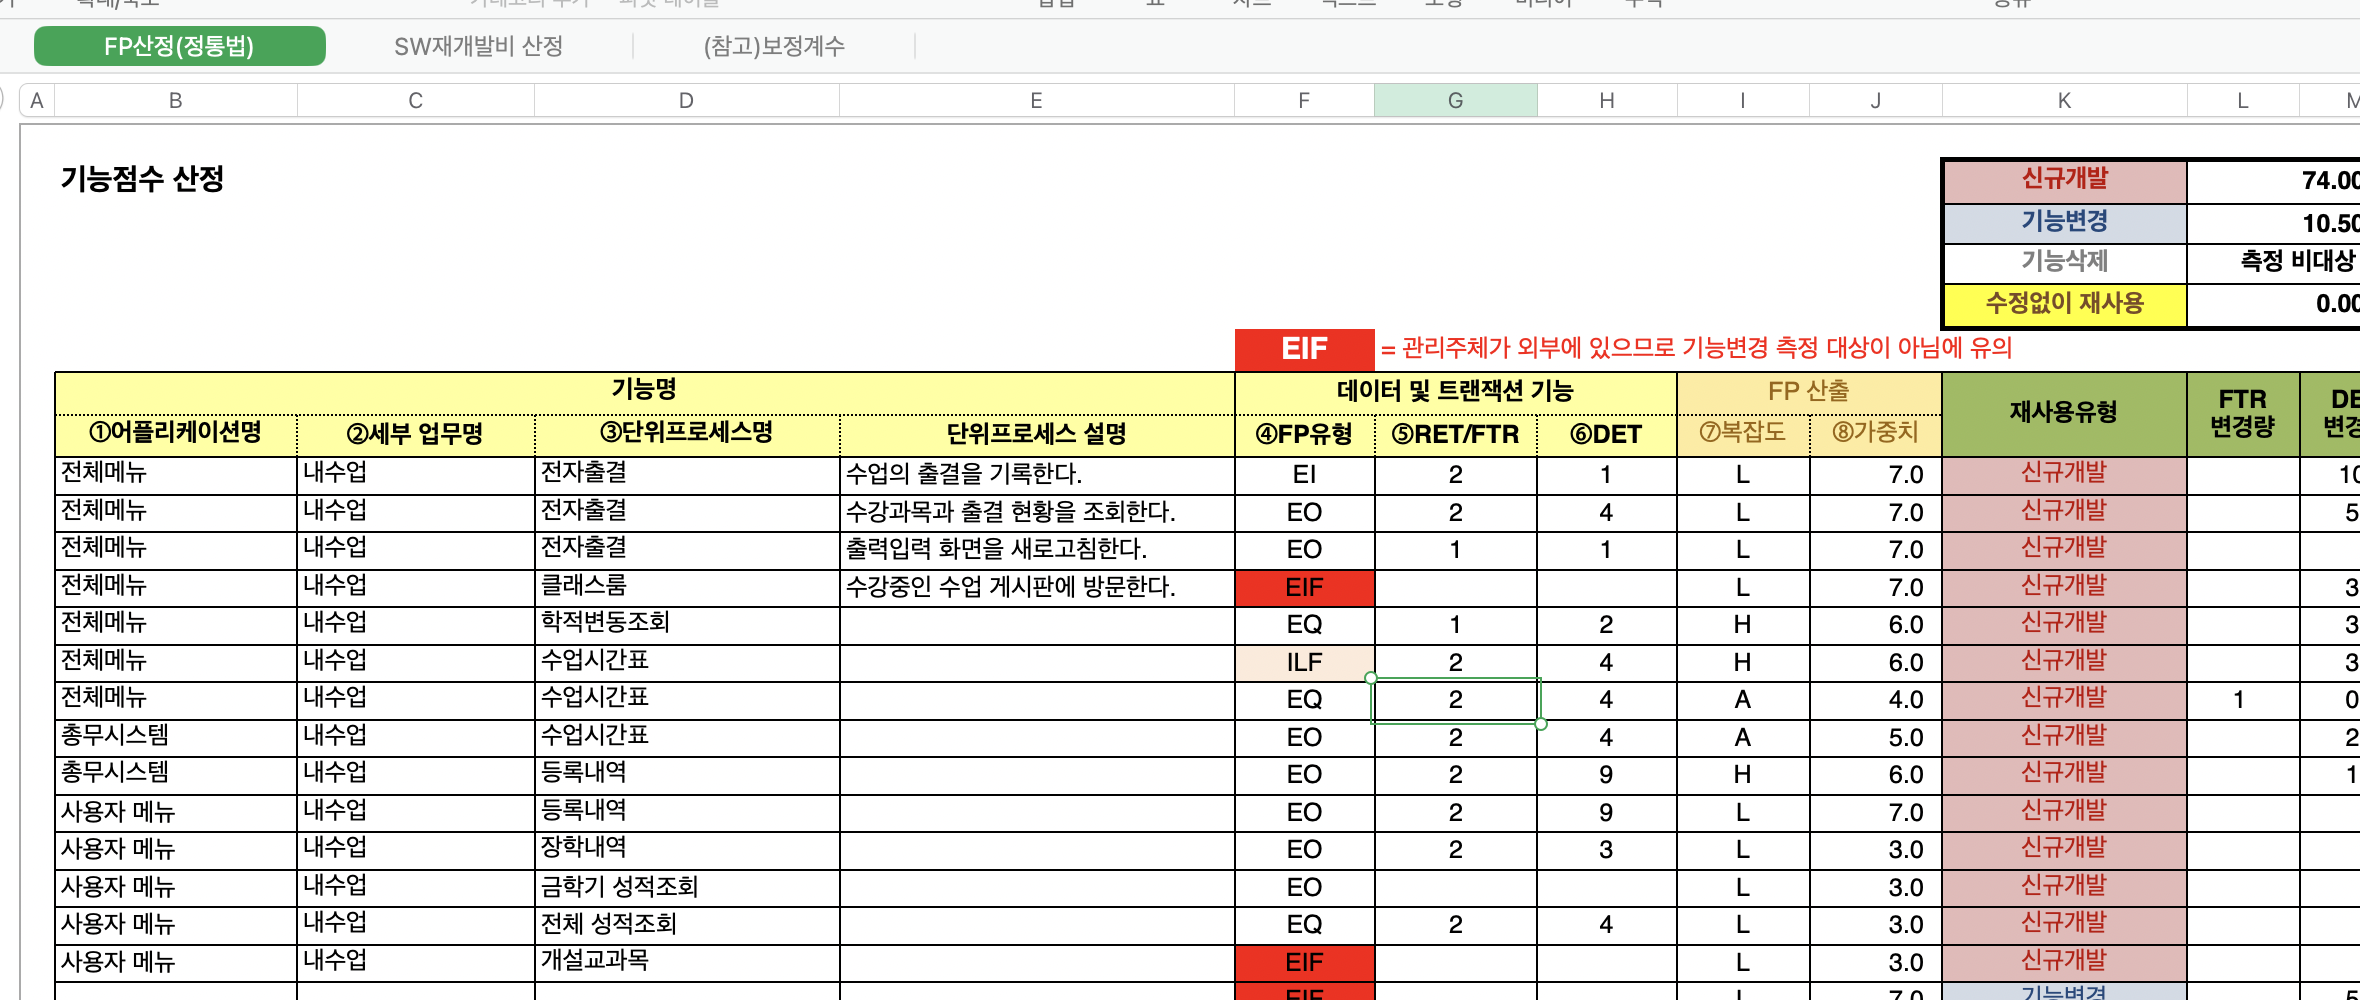
실습 - 정통 산정법
SW개발비 정통 산정법 엑셀 파일을 다운받아서,
엑셀의 매서드 권한을 허용하여 시트를 작성한다.
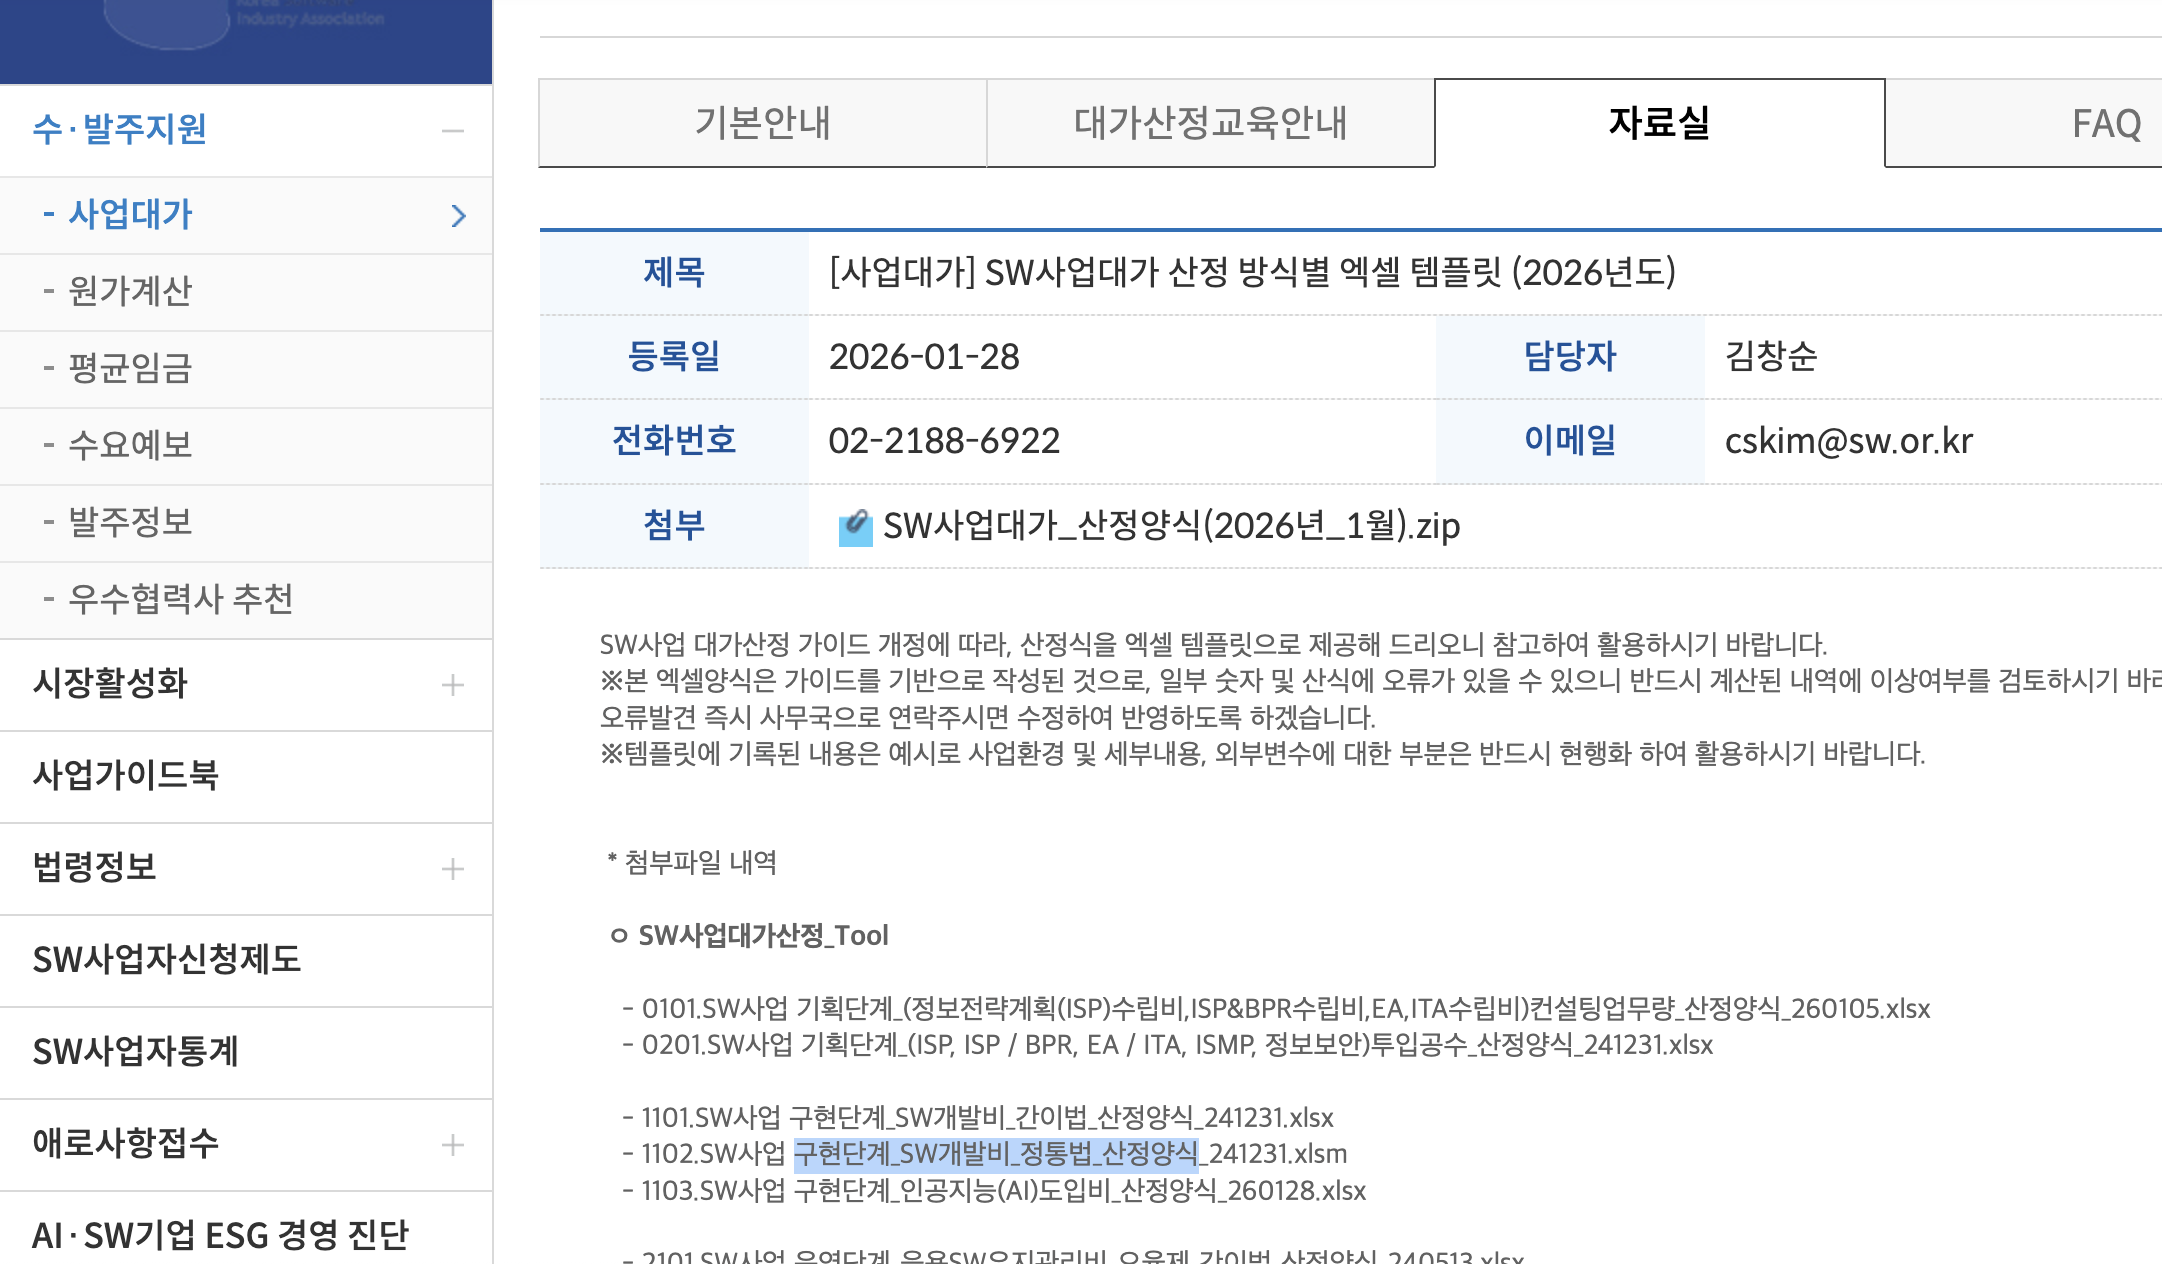
헤이영 캠퍼스의 개발 비용을 산정해 본다.
4 프로젝트 팀 조직
조직 구성의 중요성
- SW 개발 생산성에 큰 영향
- 작업 특성과 팀 구성원 사이 의사교류가 중요
프로젝트 팀 조직 정의 시 답해야 할 질문
- 역할과 책임이 어디에 있는가?
- 어떤 통로로 정보가 전달되고 결정되는가?
- 어떻게 갈등을 해소할 것인가?
4.1 팀 역할 예시
- PM, 시스템 운영자, 시스템 분석가, SW 엔지니어, DB 엔지니어, QA 관리자, 기술지원, HW 엔지니어, 웹 개발자/디자이너
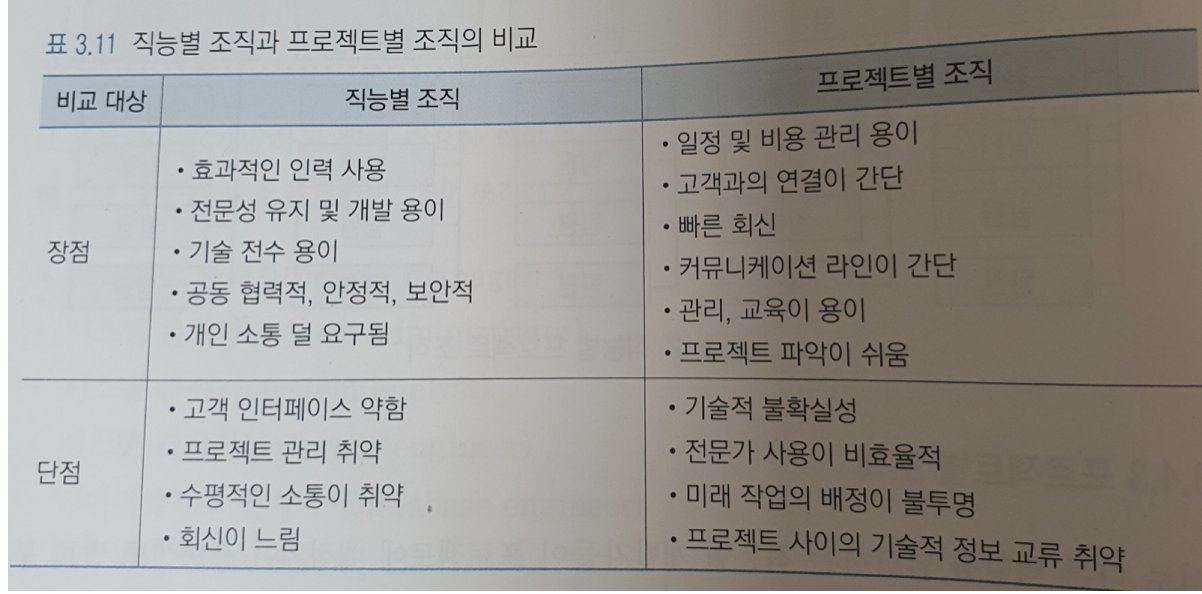
4.2 직능별 조직
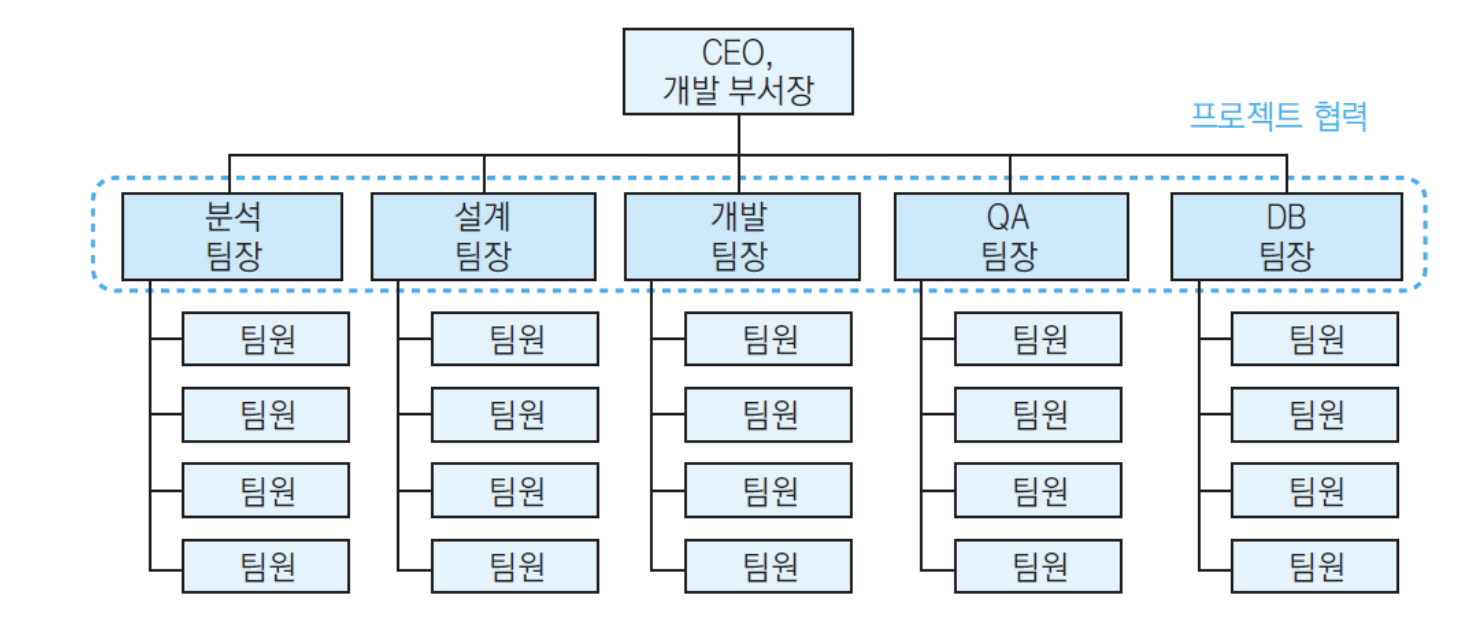
- 서로 다른 부서가 프로젝트의 다른 단계에 들어와 작업
- 팀원은 한 부서 소속, 협력은 부서별로
4.3 프로젝트별 조직
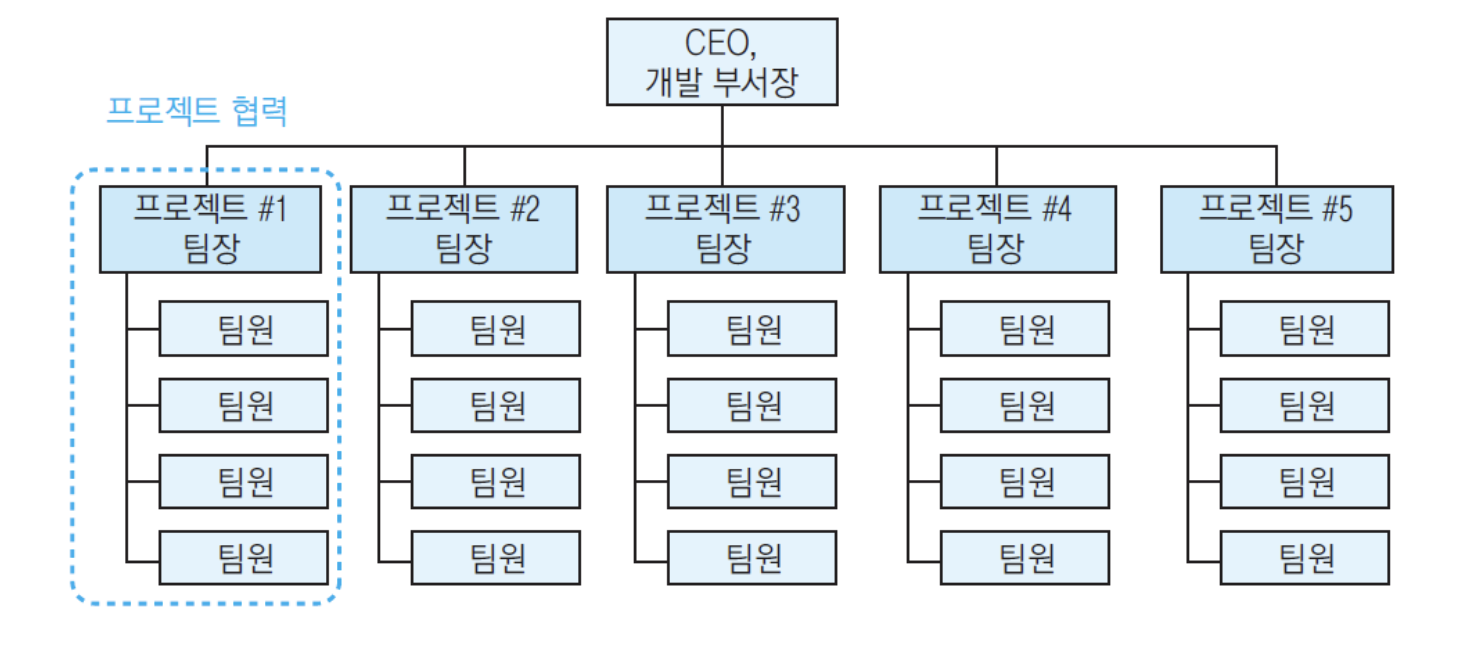
- 직능별 개발자들이 프로젝트에 배정
- 의사 전달 경로 짧음, 인력/진도 관리 수월
4.4 매트릭스 조직
한 사람이 여러 프로젝트 참여 가능
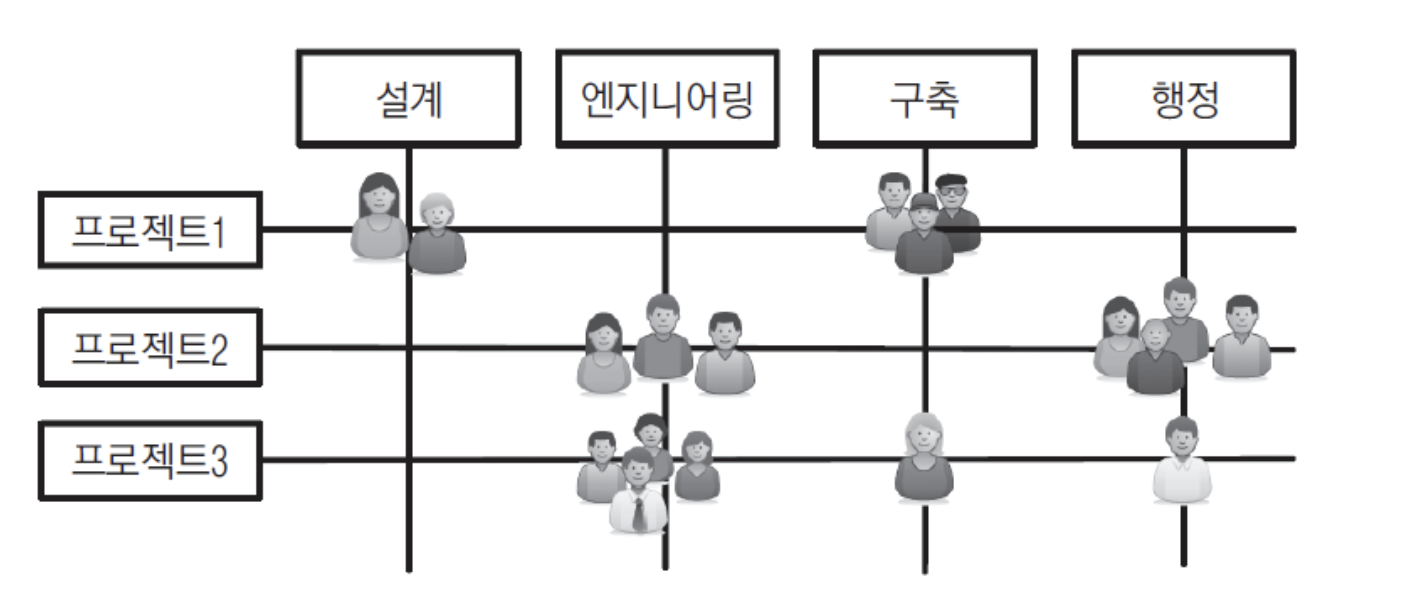
- 직능별 조직 관리자가 프로젝트 책임
- 직능 부서 소속 개발자가 프로젝트 참여
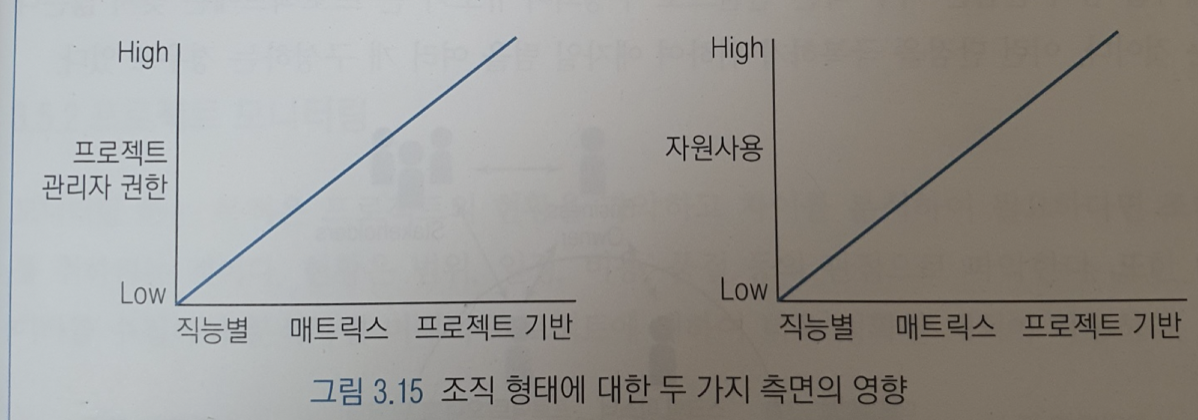
- 강한 매트릭스 :PM의 힘이 강함
- 약한 매트릭스 : 직능별 팀장이 강함
4.5 애자일 조직
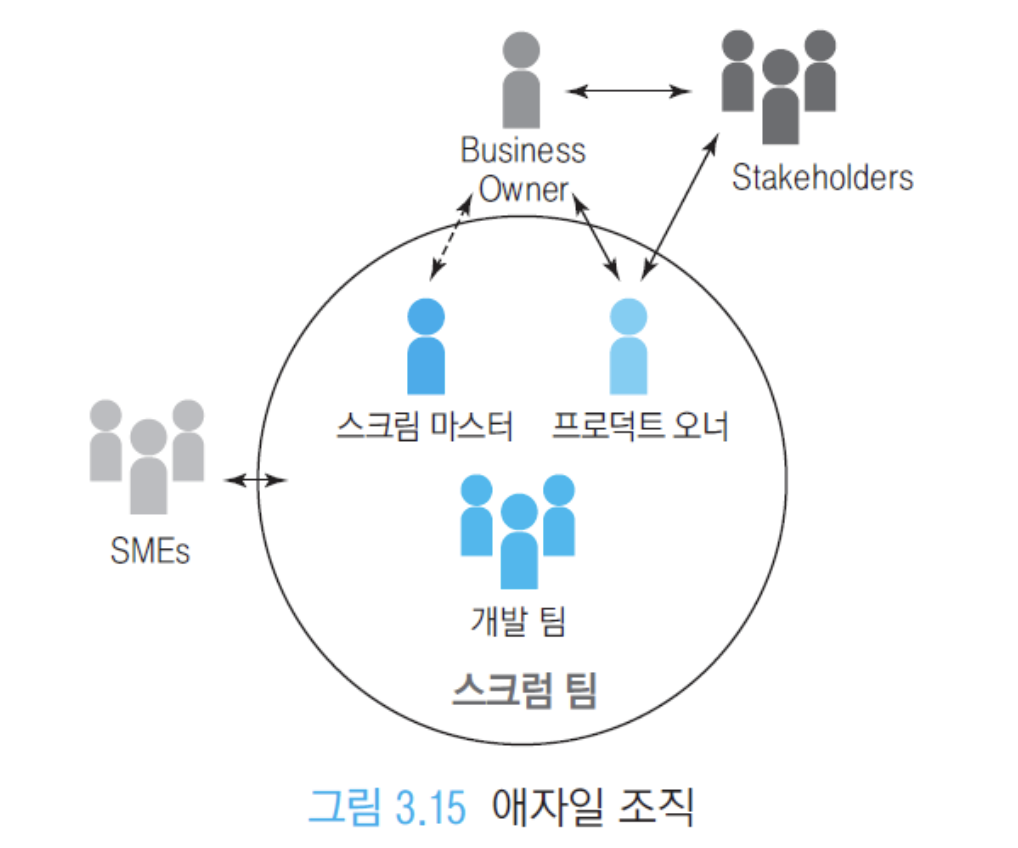
- 5~9명 팀이 밀접 협력
- 결과와 이슈에 대한 오너십을 공유
5 실행과 모니터링
5.1 프로젝트 실행
- 작업 시작 미팅
- 작업 결과 수집
5.2 프로젝트 모니터링
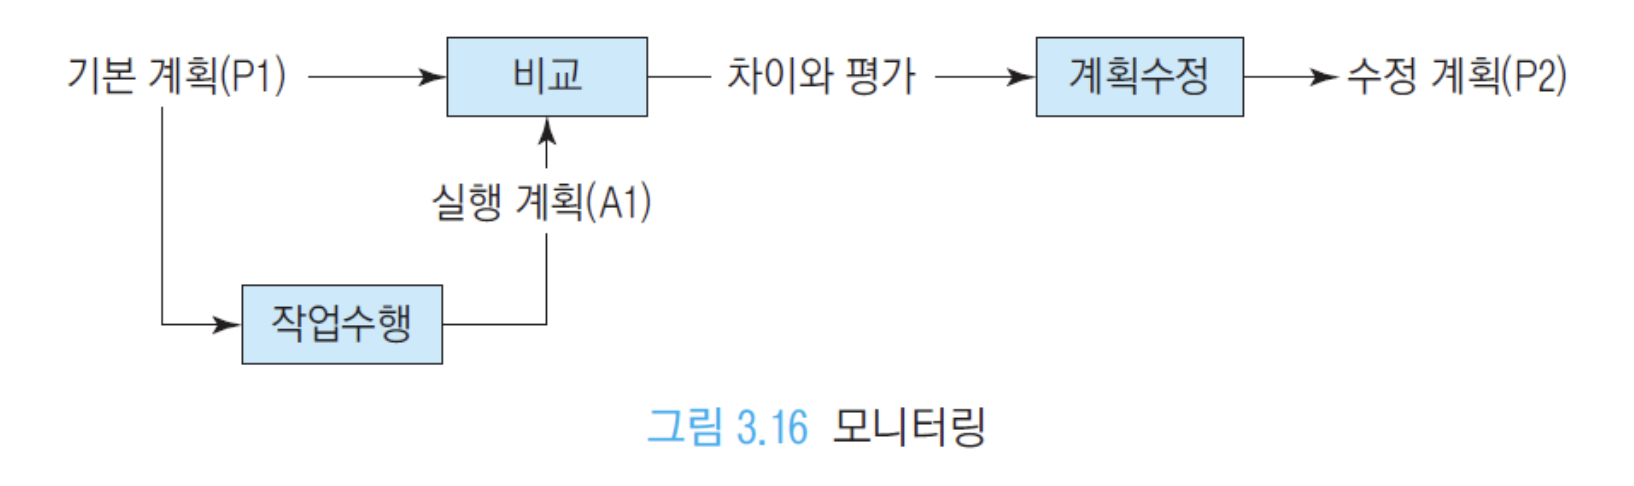
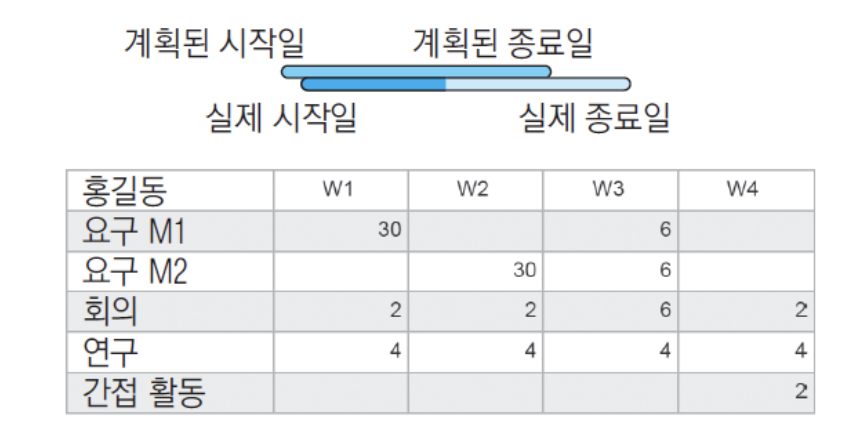
일정 모니터링
주어진 시각에서 계획의 스냅샷을 기초로 실행 값을 비교한다.
어닝 밸류 분석(Earned Value Analysis)
비용과 일정을 통합된 방법으로 모니터링
계획된 노력(비용), 실제 진척도(어닝 벨류), 노력(실제 비용)을 금전적 가치로 측정하여 통합된 모니터링을 제공
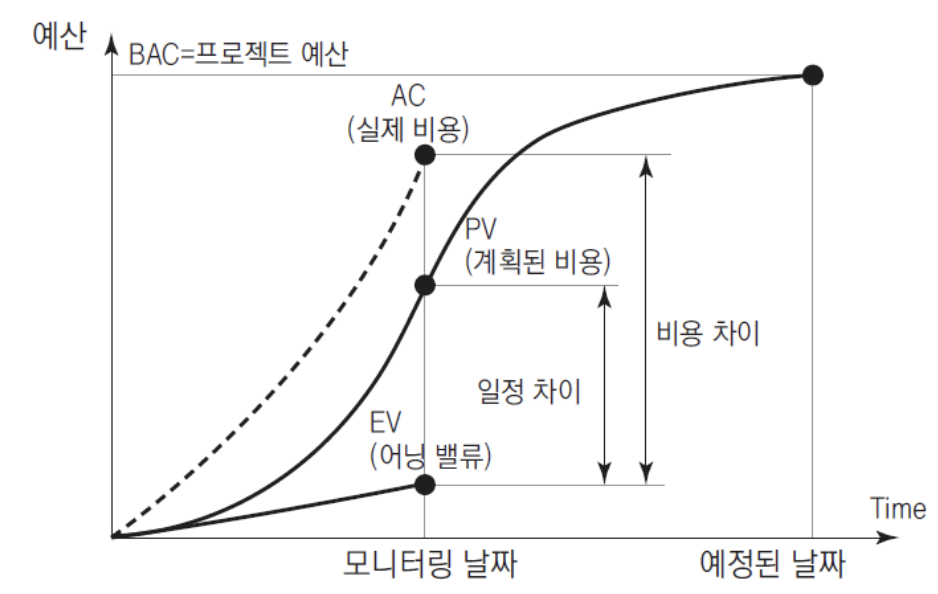
- EV를 사용해서 과제(프로젝트)의 페이스(진척 속도)와 비용 상태를 확인한다.
지표 3가지
AC (Actual Cost)
- 지금까지 실제로 누적된 비용
- 비용 구분
- 직접비: 내가 프로젝트 수행에 직접 쓰는 비용
- 간접비: 프로젝트를 위해 간접적으로 들어가는 비용(세무/회계 등 지원 업무 포함)
PV (Planned Value) = Planned Budgeted Cost
- 계획상 그 시점까지 “원래” 창출했어야 하는 가치(계획 진척분)
- 예시
- 총 기간 6개월, 총 예산 3000만원
- 3개월 시점이라면 계획상 50% 진행이므로
- PV = 1500만원
EV (Earned Value)
- 실제 진척도를 “가치(돈)”로 환산한 것
- 예시(진척률 기반)
- 전체 과제 규모가 FP 100이라고 가정
- 3개월차에 실제로 40%만 완료
- EV = 총 예산 3000만원 × 0.40 = 1200만원
- 3개월 시점
- PV = 1500만원 (원래 이만큼은 했어야 함)
- AC = 1800만원 (실제로는 이만큼 돈이 나감) → 예산 초과(비용이 계획보다 많이 듦)
- EV = 1200만원 (실제로 만든 가치) → 원래 1500만원치(PV)를 만들었어야 하는데 1200만원치(EV)밖에 못 만들어서 진척이 느림(페이스가 늦음)
- PV: “계획대로라면 지금까지 해야 했던 가치”
- EV: “실제로 지금까지 만든 가치(진척도 환산)”
- AC: “실제로 지금까지 쓴 돈” → 이 3개를 비교해서 일정(페이스)과 비용(예산 초과/절감)을 판단한다.
5.3 번다운 차트
기능이 출시되는 속도를 측정하는 것.
스프린트 사이의 속도는 일정하다는 전제가 있다.
EV 등을 통해 판단을 해야 한다.
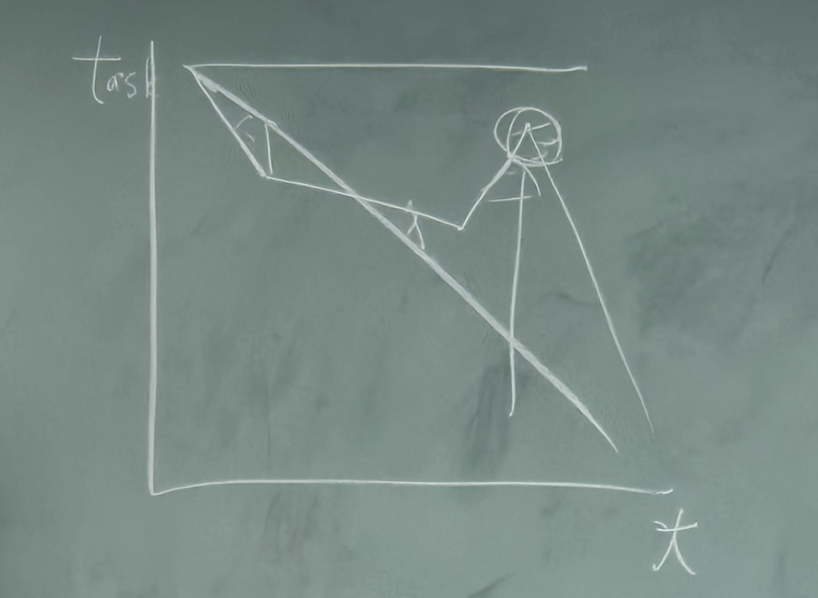
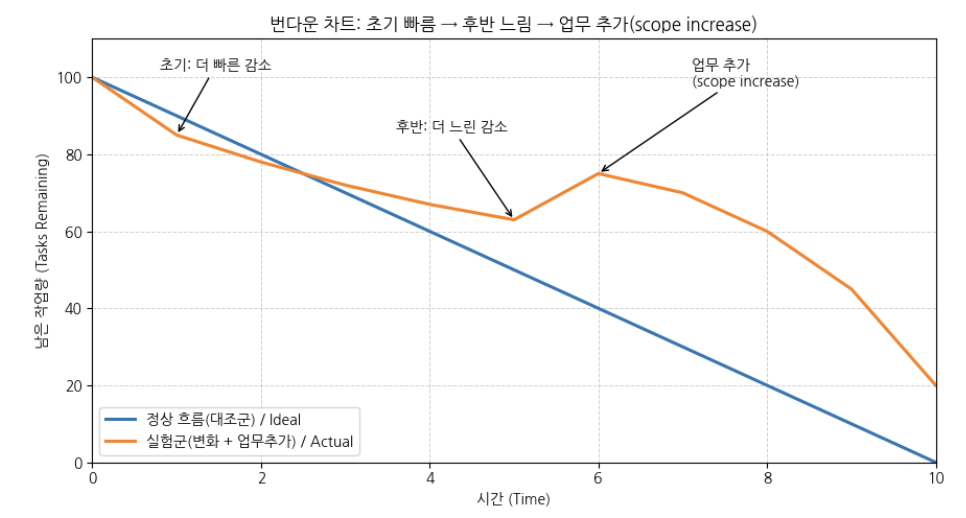
시간이 갈수록 남은 일 task가 줄어야 정상적인건데, 이 때, 오히려 task가 증가하면 말 그대로 일이 추가된것이다.
6 리스크 관리
목적
- 위험이 발생했을 때 영향을 줄이는 것
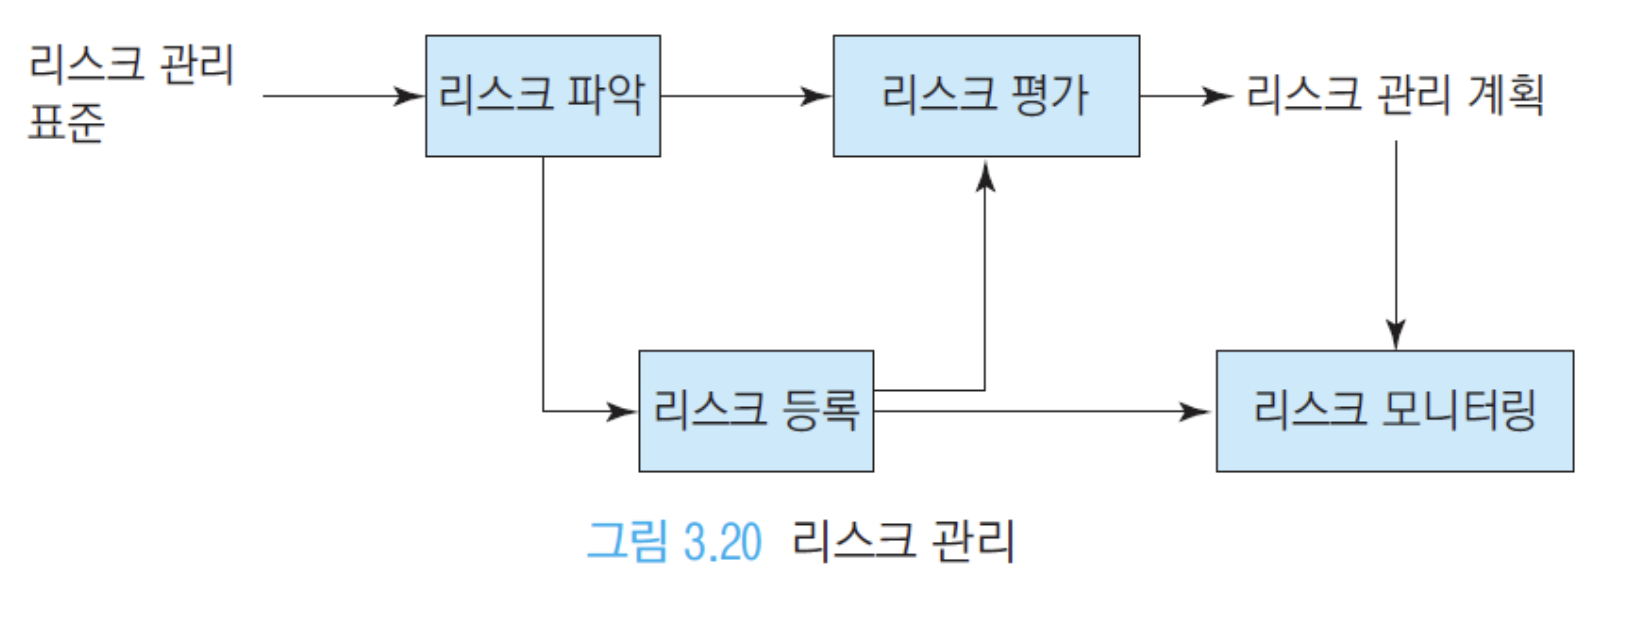
6.1 리스크 파악(찾는 방법)
- 회의
- 문서 분석
- 리스크 분할 구조/체크리스트
리스크 아이템을 분할하여 계층 구조로 그리거나 체크리스트를 만들어 파악한다. - 유추
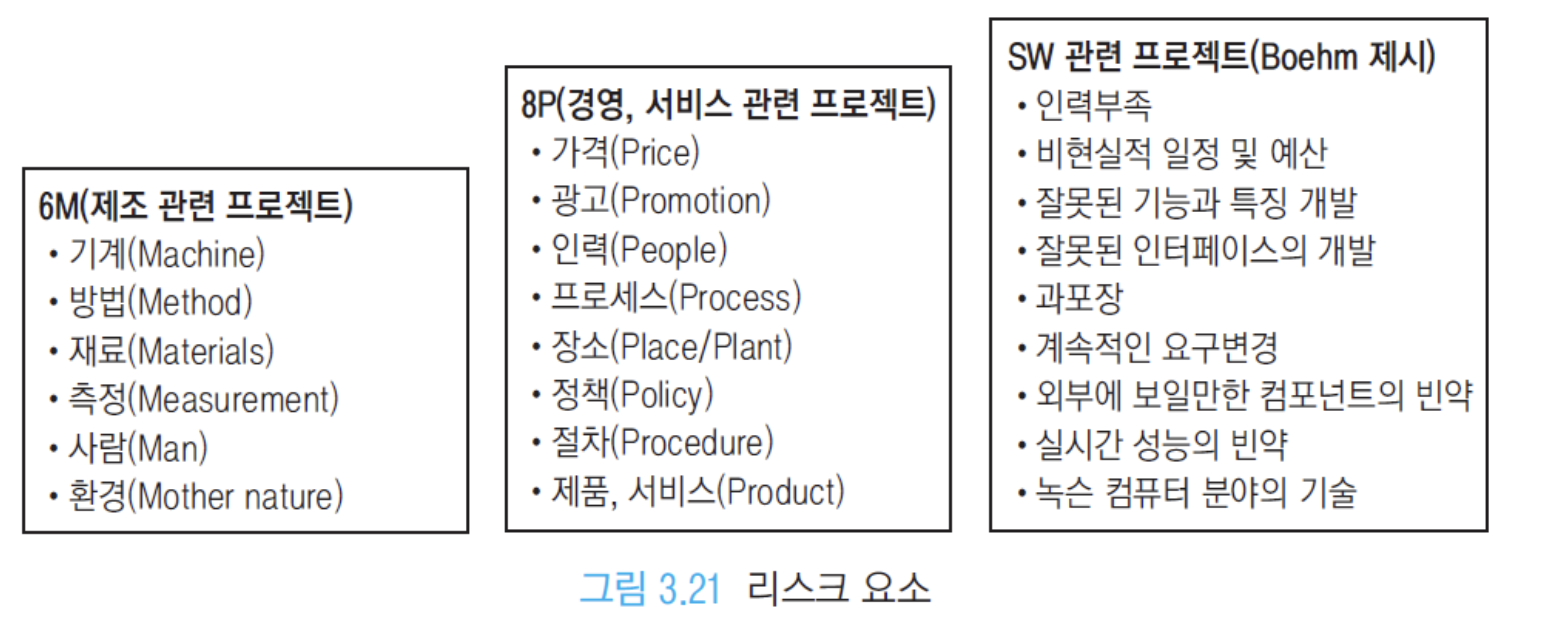
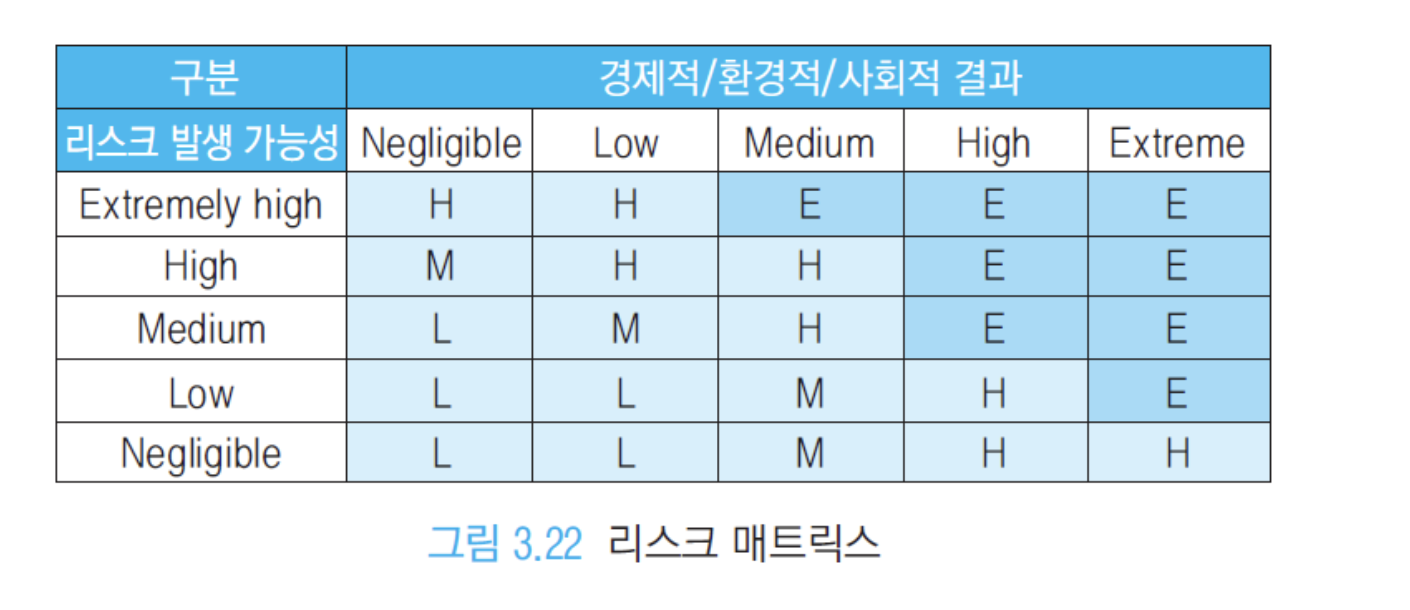
6.2 리스크 평가
- 영향도에 따라 평가하고 우선순위 매김
- 우선순위는 발생 확률 + 발생 시 영향에 좌우
- 정성적 방법: 확률을 모를 때
6.3 리스크 관리
위험 요소를 해소하기 위한 방법을 강구하고 프로젝트 실행하는 동안 이를 적용
- 리스크 회피를 위해 계획 변경
- 책임을 다른 기관에 맡김
- 프로토타이핑
- 유능한 인재 등용
- 3자와 협업
프로젝트 계획서 구성(목차 템플릿)
-
개요
1.1 프로젝트 개요
1.2 프로젝트 산출물
1.3 정의/약어
-
자원 및 일정 예측
2.1 자원(인력/비용)
2.2 일정
-
조직 구성 및 인력 배치
3.1 조직 구성
3.2 직무 기WBS
-
기술관리 방법
5.1 변경 관리
5.2 위험 관리
5.3 비용 및 진도 관리
5.4 문제점 해결 방안
-
표준 및 개발 절차
6.1 개발 방법론
-
검토 회의
7.1 검토회 일정
7.2 검토회 진행 방법
7.3 검토회 후속 조치
-
개발 환경
-
성능 시험 방법
-
문서화
-
유지보수
-
설치/인수
-
참고문헌 및 부록