💡 머신러닝 프로젝트 처음부터 끝까지
머신러닝 작업 단계
- 큰 그림을 보기
- 데이터 구하기
- 데이터로부터 통찰을 얻기 위해 탐색하고 시각화
- 머신러닝 알고리즘을 위해 데이터를 준비
- 모델을 선택하고 훈련시키기
- 모델을 상세하게 조정
- 솔루션 제시
- 시스템을 론칭하고 모니터링하고 유지 보수
👩💻 나는 부동산 회사에 막 고용된 데이터 과학자이며 상사와 회의 중이라고 가정해보자
① 실제 데이터로 작업하기
🧐 머신러닝을 배울 때 실제 데이터로 실험해보는 것이 가장 좋으므로 StatLib 저장소에 있는 주택 가격 데이터셋을 사용해보자!
② 큰 그림 보기
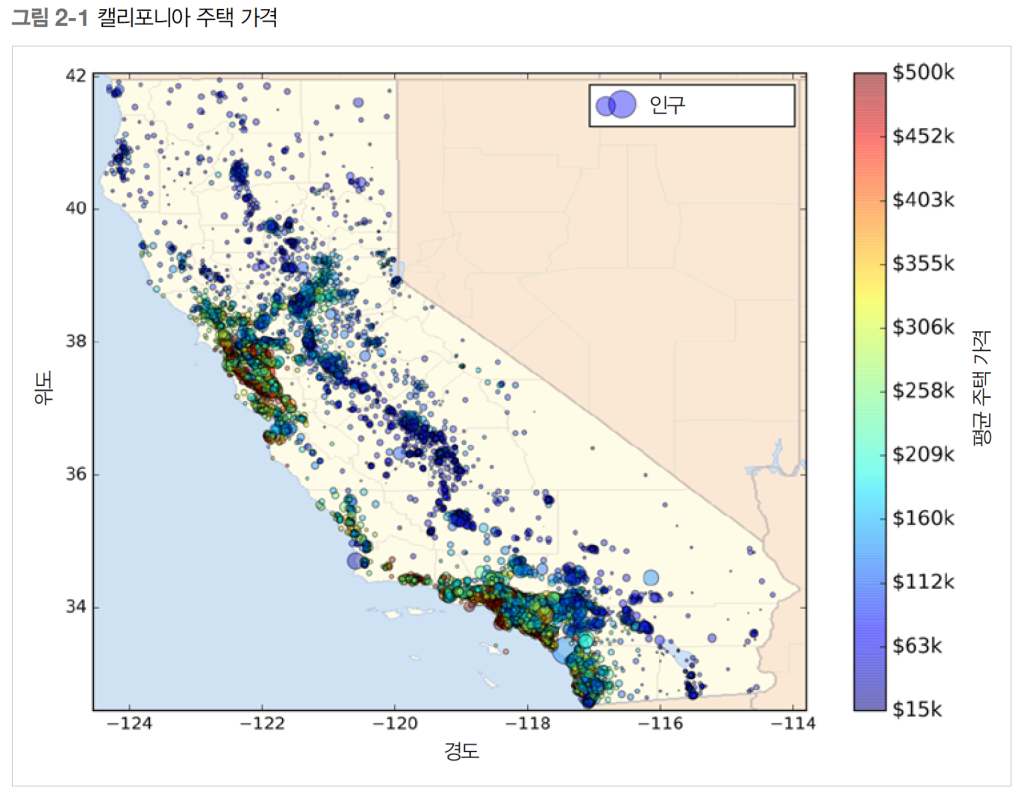
🧐 캘리포니아 인구조사 데이터를 사용해 캘리포니아의 주택 가격 모델을 만들자!
이 데이터는 캘리포니아의 블록 그룹마다 인구, 중간 소득, 중간 주택 가격등을 담고 있다. 이 데이터로 모델을 학습시켜서 다른 측정 데이터가 주어졌을 때 구역의 중간 주택 가격을 예측해야 한다.
②-1단계: 문제 정의하기
목적 파악
🤔 질문1) 회사에서는 이 모델을 어떻게 사용해 어떤 이익을 얻으려고 할까?
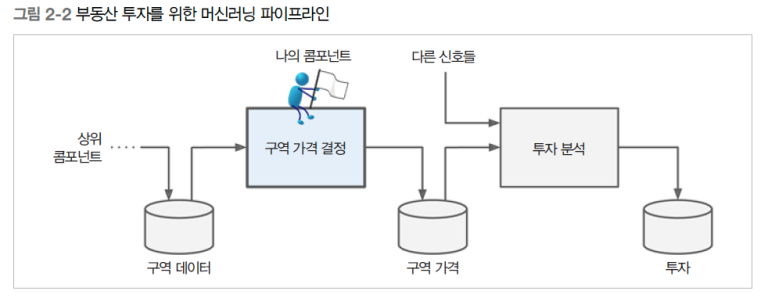
🧐 이 모델의 출력(구역의 중간 주택 가격에 대한 예측)이 여러 가지 다른 신호와 함께 다른 머신러닝 시스템에 입력으로 사용되며 뒤따르는 시스템이 해당 지역에 투자할 가치가 있는지 결정할 예정
파이프라인(pipeline): 데이터 처리 컴포넌트(component)들이 연속되어있는것
🤔 질문2) 현재 솔루션은 어떻게 구성되어 있나?
🧐 현재는 구역 주택 가격을 전문가가 수동으로 추정
그렇다면 구역의 데이터를 기반으로 중간 주택 가격을 예측하는 모델을 훈련시키는 쪽이 유용하다. 이제 시작해보자.
학습 방법 정의
Q1) 지도학습, 비지도학습, 강화학습 중 어떤 방법을 선택할 것인가?
A1) 지도학습 ⇀ 이 데이터는 레이블된 훈련 샘플 (각 샘플이 기대 출력값, 즉 구역의 중간 주택 가격을 가지고 있음) 이 있기 때문
✅ 지도학습 VS 비지도학습 VS 강화학습
- 지도학습: 레이블이 지정된 데이터를 사용 = 정답값이 주어진 데이터 사용
- 비지도학습: 레이블이 지정되지 않은 데이터를 사용 = 정답값이 주어지지 않은 데이터 사용
- 강화학습: 상호작용(주어진 환경에 대해서 어떤 주체가 행동을 취하고 보상)을 통해 학습하는 계산 접근 방식
Q2) 지도 학습이라면 분류인가 회귀인가?
A2) 회귀 ⇀ 값(주택 가격)을 예측해야 하기 때문 (예측에 사용할 특성이 여러 개(구역의 인구, 중간 소득 등)이므로 다변량 회귀)
✅ 분류 VS 회귀
- 분류: 종류를 예측하는 것
- 회귀: 연속된 값을 예측하는 것
Q3) 온라인학습과 배치학습 중 무엇이 효율적인가?
A3) 배치학습 ⇀ 시스템에 들어오는 데이터에 연속적인 흐름이 없고, 빠르게 변하는 데이터에 적응하지 않아도 되고, 데이터가 충분히 작으므로 일반적인 배치학습 진행
✅ 온라인학습 VS 배치학습
- 온라인학습: 시스템이 순차적으로 학습, 연속적으로 데이터를 받고 빠른 변화에 스스로 적응해야 하는 시스템에 적합
- 배치학습: 시스템이 점진적으로 학습할 수 없음
②-2단계: 성능 측정 지표 선택
회귀 문제의 전형적인 성능 지표는 평균 제곱근 오차
(분류의 경우는 정확도)
오차가 커질수록 이 값은 더욱 커지므로 예측에 얼마나 많은 오류가 있는지 가늠 가능
-
평균 제곱근 오차(RMSE, Root Mean Square Error)
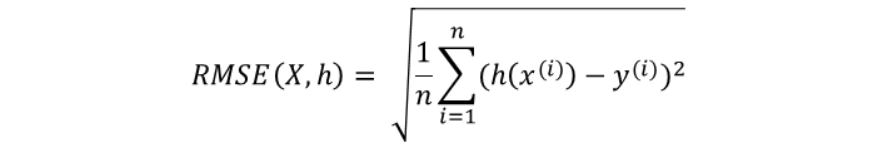
n: 샘플의 개수 | X: 데이터셋에 있는 모든 샘플의 모든 특성값(레이블은 제외)을 포함하는 행렬 | h: 시스템의 예측 함수이자 가설 y: 타켓 값 | X^(i): i번째 샘플(레이블은 제외한)의 전체 특성값의 벡터 | y^(i): i번째 레이블(해당 샘플의 기대 출력값) -
평균 절대 오차(MAE, Mean Absolute Error)
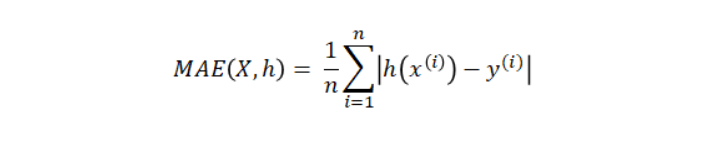
✅ 왜 평균제곱근오차 (RMSE)를 사용하는 것일까?
✔ Norm의 지수가 클수록 큰 값의 원소에 치우치며 작은 값은 무시되는데, 그래서 RMSE가 MAE보다 조금 더 이상치에 민감
✔ 하지만 (종 모양 분포의 양 끝단처럼) 이상치가 매우 드물면 RMSE가 잘 맞아 일반적으로 널리 사용
🧐 RMSE와 MAE 모두 예측값의 벡터와 타깃값의 벡터 사이의 거리를 재는 방법이다. 그렇다면 성능 측정 시 거리 측정 방법은?
✔ 성능 측정 시 거리 측정 방법
Nrom (노름): 벡터의 길이(length) 혹은 크기(magnitude)를 측정하는 방법