Algorithm
알고리즘은 어떤 문제를 해결하기 위해서 일련의 절차를 정의하고, 공식화한 형태로 표현한 일종의 문제 풀이 방법, 해(解)를 의미합니다. 이런 알고리즘은 프로그래밍에서는 input 값을 통해 output 값을 얻기 위한 계산 과정을 의미합니다. 주어진 문제를 해결할 때, 정확하고 효율적으로 결과 값을 얻는 것이 필요하고 그때 바로 알고리즘이 사용됩니다. 문제 해결을 위한 단계들을 체계적으로 명시할 수 있는 상황이라면 그것은 알고리즘으로 충분히 풀어낼 수 있다고 볼 수 있습니다.
어떠한 문제 해법이 알고리즘이라 명시 되려면 일정한 조건들을 반드시 만족해야만 합니다.
횡단보도 옆에 신호등이 있습니다. 현재는 빨간불이지만 5분 뒤에는 초록불로 바뀔 것입니다.
5분이 지나고, 초록불로 바뀐 신호등은 10초 뒤 ‘30’이라는 숫자와 함께 1초에 한 번씩 점등하기 시작합니다.
총 30번을 점등한 신호등은 이어 빨간불로 바뀝니다.
- 입력(Input) : 알고리즘은 출력에 필요한 자료를 입력받을 수 있어야 합니다. 이 상황에서는 제일 먼저 빨간불인 신호등이 초록불이 되려면 5분이라는 시간을 입력 받아야 합니다. 하나 더 알아야 할 것은 신호등은 항상 시간을 입력받아야 알고리즘이 동작하지만 꼭 입력을 받지 않아도 되는 알고리즘도 있습니다. (ex. 원주율(pi)의 1조 번째 자리 수를 구하려는 경우 입력은 없지만 출력은 있다.)
- 출력(Output) : 알고리즘은 실행이 되면 적어도 한 가지 이상의 결과를 반드시 출력해야 합니다. 만약 알고리즘에 출력이 없다면 이 알고리즘은 끝이 났는지, 끝이 나지 않았는지 확인할 길이 없기 때문입니다. 출력은 알고리즘에서 “끝이 났다" 라는 표현이므로 반드시 존재해야 하며, 이는 유한성과도 연관이 있습니다. 이 상황에서 출력은 “초록불로 바뀐다" 입니다.
- 유한성(Finiteness) : 알고리즘은 유한한 명령어를 수행한 후, 유한한 시간 내에 종료해야 합니다. 이는 알고리즘은 실행된 후에는 반드시 종료되어야 한다는 말과도 같습니다. 알고리즘이 무한히 실행이 된다면 무한히 기다려야 할 것이며, 그것은 출력의 기약이 없는 알고리즘일 것입니다. 신호등이 빨간불인 상태에서 초록불로 변하는 과정에 대한 기약이 없다면 그 신호등은 제대로 된 알고리즘으로 동작하는 것이 아닐 것입니다.
- 명확성(Definiteness) : 알고리즘의 각 단계는 단순하고 명확해야 하며, 모호해서는 안 됩니다. 예를 들어 ‘신호등이 몇 분 뒤에 켜집니다’ 와 같이 표현한다면, 명확성이 떨어질 뿐더러 모호한 표현이라고 볼 수 있습니다. ‘신호등이 5분 뒤에 켜집니다‘ 와 같이 명확하게 표현을 해야만 합니다.
- 효율성(Efficiency) : 알고리즘은 가능한 한 효율적이어야 합니다. 모든 과정은 명백하게 실행 가능해야 하며, 실행 가능성이 떨어지는 알고리즘은 효율적이지 못한 알고리즘이라 볼 수 있습니다. 알고리즘은 시간 복잡도와 공간 복잡도를 통해 결정이 되므로, 시간 복잡도와 공간 복잡도가 낮을 수록 효율적인 알고리즘이라 볼 수 있습니다.
알고리즘의 중요성
알고리즘은 프로그래밍 뿐이 아니라 일상생활에서도 다양한 문제를 해결하는 데에 활용할 수 있습니다. 좋은 알고리즘은 절차가 명확하게 표현되어 있고, 효율적이므로 다양한 문제 해결 과정에서 나타나는 불필요한 작업들을 줄여줄 수 있습니다.
그렇지만 알고리즘의 순서가 달라지면 결과 또한 다르게 나타날 수 있다는 것은 주의해야할 점입니다.
수식을 계산하는 방식에는 우위가 있으며 그 우선순위는 대괄호, 지수, 나누기, 곱하기, 더하기 및 빼기 순으로 두는 것이 사칙연산의 기본적인 개념입니다. 이 우위는 수식 내에 다양하게 섞여 있을수록 더욱 중요해집니다.
사칙연산의 알고리즘을 짤 당시 곱셈과 나눗셈, 괄호로 이뤄진 수식을 계산할 때 이런 계산 방식의 우위를 따르면 당연히 괄호 안에 있는 것부터 먼저 연산하도록 알고리즘을 짤 것입니다. 여기서 중요한 것은 그 다음 연산부터입니다.
어떤 연산 순서 규칙을 선택하느냐에 따라 답이 달라지게 됩니다.
정확하지 않은 알고리즘은 정확하지 않은 해(解)를 내놓게 됩니다. 정확하지 않은 답은 혼란을 주고, 프로그래밍 자체에 큰 문제를 야기할 수 있습니다.
알고리즘은 어떻게 해야 잘 풀 수 있을까요?
- 문제를 이해하세요.
대부분의 코딩 테스트에서는 문제의 설명과 입출력예시, 제한사항, 그리고 주의사항 등으로 문제 상황을 제시합니다. 주어진 조건을 토대로 문제가 무엇인지를 이해하는 것부터 시작해야 합니다. - 문제를 어떻게 해결할 수 있을지, 전략을 세워야 합니다.
연습장에 전체적인 그림을 그려가면서 페어와 나눠보세요. 전체적인 흐름을 공유할 수 있습니다.
수도코드를 작성하기 전, 인간의 사고로 문제를 해결할 수 있어야 합니다. 연습장이나 온라인 화이트보드를 사용하여 문제에 대해 논의하고, 해결하세요.
코드를 작성하기 전에 페어와 수도코드를 먼저 작성해주세요! 알고리즘 전략은 잘 짜여진 수도코드에서부터 시작합니다!
막혔던 생각이 페어에게 설명을 하면서 해결되는 경우도 있습니다. - 문제를 코드로 옮겨 보세요.
페어와 논의한 전략을 코드로 옮겨 보세요!
구현한 코드를 페어와 논의해 보고, 구현한 코드의 최적화를 시도해 보세요!
시간 복잡도(Time Complexity)

시간복잡도를 고려한다는 것은?
입력값의 변화에 따라 연산을 실행할 때, 연산 횟수에 비해 시간이 얼마만큼 걸리는가?
효율적인 알고리즘을 구현한다 = 입력값이 커짐에 따라 증가하는 시간의 비율을 최소화한 알고리즘
Big-O 표기법
Big-O(빅-오)
Big-Ω(빅-오메가)
Big-θ(빅-세타)
위 세 가지 표기법은 시간 복잡도를 각각 최악, 최선, 중간(평균)의 경우에 대하여 나타내는 방법입니다. 이 중에서 Big-O 표기법이 가장 자주 사용됩니다. 빅오 표기법은 최악의 경우를 고려하므로, 프로그램이 실행되는 과정에서 소요되는 최악의 시간까지 고려할 수 있기 때문입니다. "최소한 특정 시간 이상이 걸린다" 혹은 "이 정도 시간이 걸린다"를 고려하는 것보다 "이 정도 시간까지 걸릴 수 있다"를 고려해야 그에 맞는 대응이 가능합니다.
결과를 반환하는 데 최선의 경우 1초, 평균적으로 1분, 최악의 경우 1시간이 걸리는 알고리즘을 구현했고, 최선의 경우를 고려한다고 가정하겠습니다. 이 알고리즘을 100번 실행한다면, 최선의 경우 100초가 걸립니다. 만약 실제로 걸린 시간이 1시간을 훌쩍 넘겼다면, 어디에서 문제가 발생한 거지?란 의문이 생길 겁니다. 최선의 경우만 고려하였으니, 어디에서 문제가 발생했는지 알아내기 위해서는 로직의 많은 부분을 파악해야 하므로 문제를 파악하는 데 많은 시간이 필요합니다.
평균값을 기대하는 시간 복잡도를 고려한다면 어떨까요?
알고리즘을 100번 실행할 때 100분의 시간이 소요된다고 생각했는데, 최악의 경우가 몇 개 발생하여 300분이 넘게 걸렸다면 최선의 경우를 고려한 것과 같은 고민을 하게 됩니다.
극단적인 예이지만, 위와 같이 최악의 경우가 발생하지 않기를 바라며 시간을 계산하는 것보다는 최악의 경우도 고려하여 대비하는 것이 바람직합니다. 따라서 다른 표기법보다 Big-O 표기법을 많이 사용합니다.
O(1) : 시간 복잡도가 O(1)인 경우
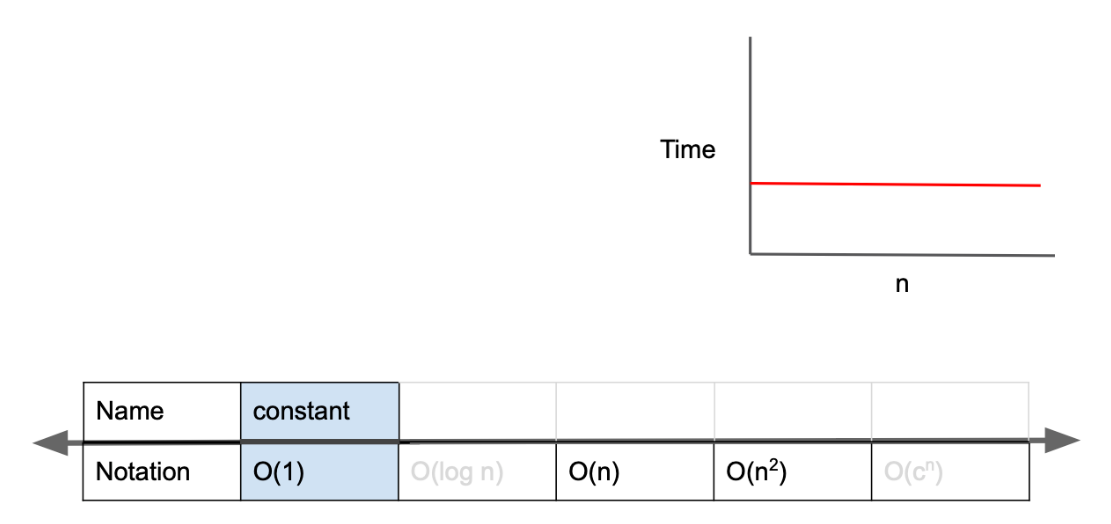
Big-O 표기법은 입력값의 변화에 따라 연산을 실행할 때, 연산 횟수에 비해 시간이 얼마만큼 걸리는가?를 표기하는 방법입니다. O(1)는 constant complexity라고 하며, 입력값이 증가하더라도 시간이 늘어나지 않습니다. 다시 말해 입력값의 크기와 관계없이, 즉시 출력값을 얻어낼 수 있다는 의미입니다. O(1)의 시간 복잡도를 가진 알고리즘을 살펴보겠습니다.
function O_1_algorithm(arr, index) {
	return arr[index];
}

let arr = [1, 2, 3, 4, 5];
let index = 1;
let result = O_1_algorithm(arr, index);
console.log(result); // 2
위 알고리즘에선 입력값의 크기가 아무리 커져도 즉시 출력값을 얻어낼 수 있습니다. 예를 들어 arr의 길이가 100만이라도, 즉시 해당 index에 접근해 값을 반환할 수 있습니다.
O(n) : 시간 복잡도가 O(n)인 경우
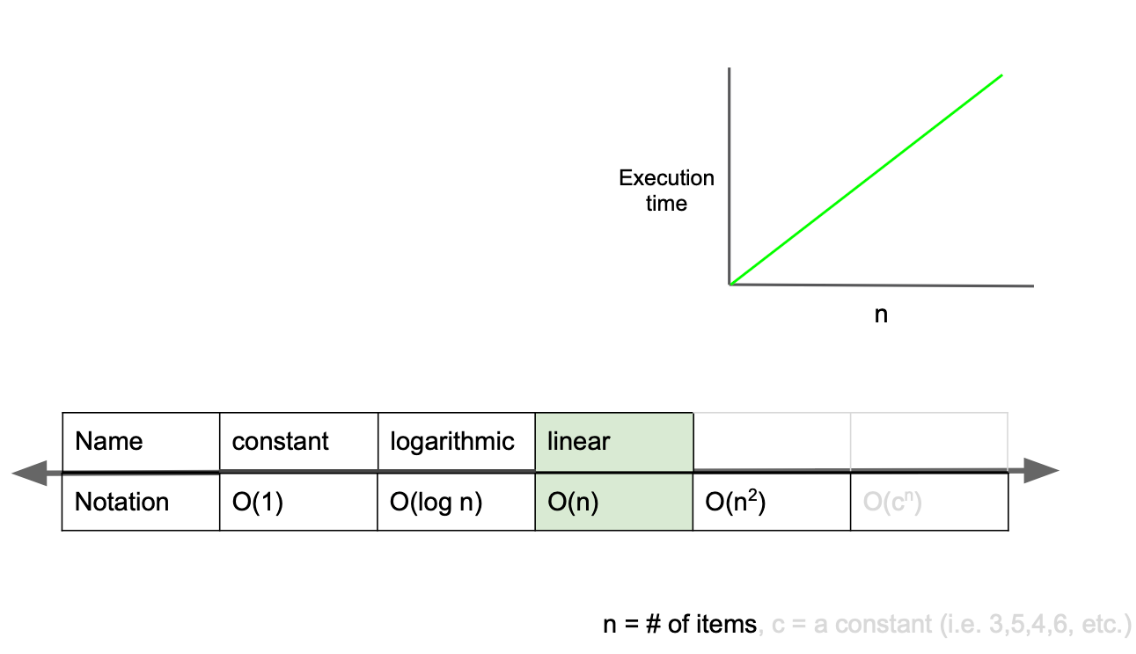
O(n)은 linear complexity라고 부르며, 입력값이 증가함에 따라 시간 또한 같은 비율로 증가하는 것을 의미합니다.
예를 들어 입력값이 1일 때 1초의 시간이 걸리고, 입력값을 100배로 증가시켰을 때 1초의 100배인 100초가 걸리는 알고리즘을 구현했다면, 그 알고리즘은 O(n)의 시간 복잡도를 가진다고 할 수 있습니다.
function O_n_algorithm(n) {
	for (let i = 0; i < n; i++) {
	// do something for 1 second
	}
}

function another_O_n_algorithm(n) {
	for (let i = 0; i < 2n; i++) {
	// do something for 1 second
	}
}
O_n_algorithm 함수에선 입력값(n)이 1 증가할 때마다 코드의 실행 시간이 1초씩 증가합니다. 즉 입력값이 증가함에 따라 같은 비율로 걸리는 시간이 늘어나고 있습니다. 그렇다면 함수 another_O_n_algorithm은 어떨까요? 입력값이 1 증가할 때마다 코드의 실행 시간이 2초씩 증가합니다.
이것을 보고, "아! 그렇다면 이 알고리즘은 O(2n) 이라고 표현하겠구나!" 라고 생각할 수 있습니다. 그러나, 사실 이 알고리즘 또한 Big-O 표기법으로는 O(n)으로 표기합니다. 입력값이 커지면 커질수록 계수(n 앞에 있는 수)의 의미(영향력)가 점점 퇴색되기 때문에, 같은 비율로 증가하고 있다면 2배가 아닌 5배, 10배로 증가하더라도 O(n)으로 표기합니다.
O(log n) : 시간 복잡도가 O(log n)인 경우

O(log n)은 logarithmic complexity라고 부르며 Big-O표기법중 O(1) 다음으로 빠른 시간 복잡도를 가집니다.
자료구조에서 배웠던 BST(Binary Search Tree)를 기억하시나요?
BST에선 원하는 값을 탐색할 때, 노드를 이동할 때마다 경우의 수가 절반으로 줄어듭니다. 이해하기 쉬운 게임으로 비유해 보자면 up & down을 예로 들 수 있습니다.
- 1~100 중 하나의 숫자를 플레이어1이 고른다 (30을 골랐다고 가정합니다).
- 50(가운데) 숫자를 제시하면 50보다 작으므로 down을 외친다.
- 1~50중의 하나의 숫자이므로 또다시 경우의 수를 절반으로 줄이기 위해 25를 제시한다.
- 25보다 크므로 up을 외친다.
- 경우의 수를 계속 절반으로 줄여나가며 정답을 찾는다.
매번 숫자를 제시할 때마다 경우의 수가 절반이 줄어들기 때문에 최악의 경우에도 7번이면 원하는 숫자를 찾아낼 수 있게 됩니다.
BST의 값 탐색도 같은 로직으로 O(log n)의 시간 복잡도를 가진 알고리즘(탐색기법)입니다.
O(n2) : 시간 복잡도가 O(n2)인 경우
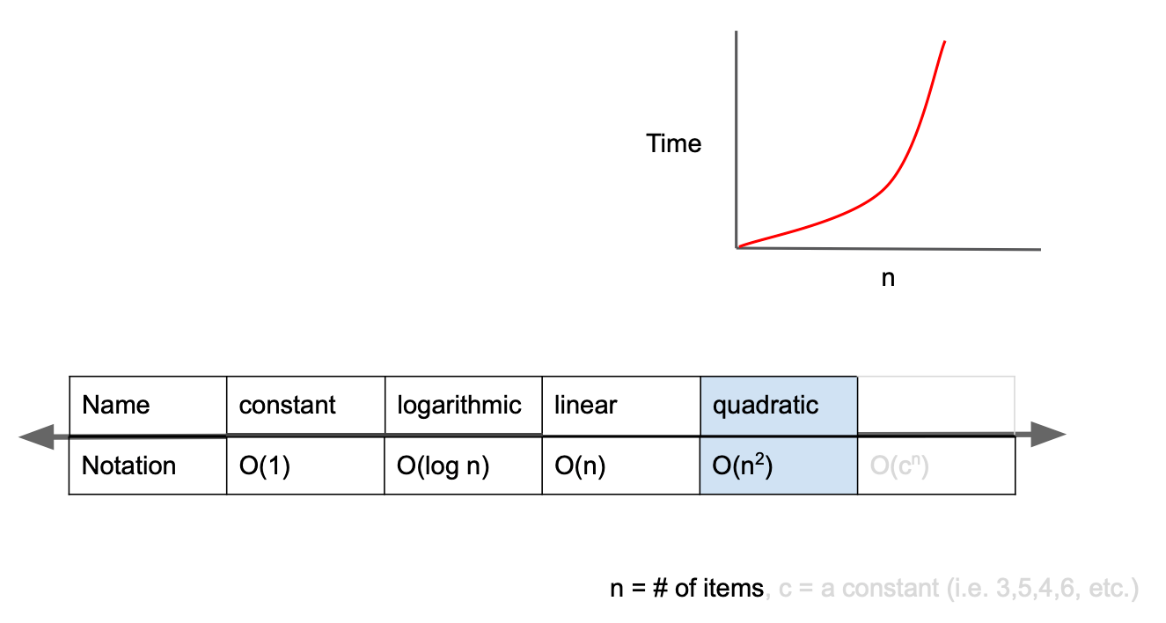
O(n2)은 quadratic complexity라고 부르며, 입력값이 증가함에 따라 시간이 n의 제곱수의 비율로 증가하는 것을 의미합니다.
예를 들어 입력값이 1일 경우 1초가 걸리던 알고리즘에 5라는 값을 주었더니 25초가 걸리게 된다면, 이 알고리즘의 시간 복잡도는 O(n2)라고 표현합니다.
function O_quadratic_algorithm(n) {
	for (let i = 0; i < n; i++) {
		for (let j = 0; j < n; j++) {
		// do something for 1 second
		}
	}
}

function another_O_quadratic_algorithm(n) {
	for (let i = 0; i < n; i++) {
		for (let j = 0; j < n; j++) {
			for (let k = 0; k < n; k++) {
			// do something for 1 second
			}
		}
	}
}
2n, 5n을 모두 O(n)이라고 표현하는 것처럼, n3과 n5도 모두 O(n2)로 표기합니다. n이 커지면 커질수록 지수가 주는 영향력이 점점 퇴색되기 때문에 이렇게 표기합니다.
O(2n) : 시간 복잡도가 O(2n)인 경우
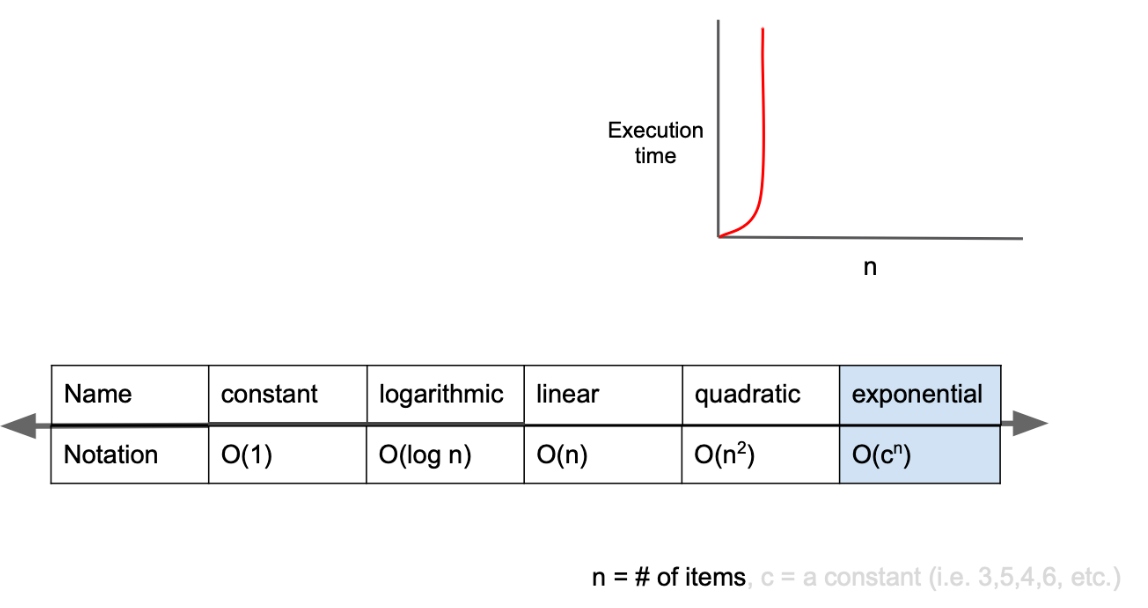
O(2n)은 exponential complexity라고 부르며 Big-O 표기법 중 가장 느린 시간 복잡도를 가집니다.
종이를 42번 접으면 그 두께가 지구에서 달까지의 거리보다 커진다는 이야기를 들어보신 적 있으신가요?
고작 42번 만에 얇은 종이가 그만한 두께를 가질 수 있는 것은, 매번 접힐 때마다 두께가 2배로 늘어나기 때문입니다.
구현한 알고리즘의 시간 복잡도가 O(2n)이라면 다른 접근 방식을 고민해 보는 것이 좋습니다.
function fibonacci(n) {
	if (n <= 1) {
		return 1;
	}
	return fibonacci(n - 1) + fibonacci(n - 2);
}
재귀로 구현하는 피보나치 수열은 O(2n)의 시간 복잡도를 가진 대표적인 알고리즘입니다.
브라우저 개발자 창에서 n을 40으로 두어도 수초가 걸리는 것을 확인할 수 있으며, n이 100 이상이면 평생 결과를 반환받지 못할 수도 있습니다.
데이터 크기에 따른 시간 복잡도
일반적으로 코딩 테스트 문제를 풀 때에는 정확한 값을 제한된 시간 내에 반환하는 프로그램을 작성해야 합니다. 그래서 컴파일러 혹은 컴퓨터의 사양에 따라 차이는 있겠지만, 시간제한과 주어진 데이터 크기 제한에 따른 시간 복잡도를 어림잡아 예측해 보는 것은 중요합니다.
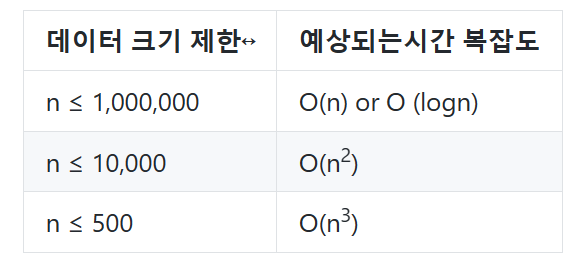
예를 들어 입력으로 주어지는 데이터에는 n만큼의 크기를 가지는 데이터가 있고, n이 1,000,000보다 작은 수일 때 O(n) 혹은 O(nlogn)의 시간 복잡도를 가지도록 예측하여 프로그램을 작성할 수 있습니다. 여기서 n²의 시간 복잡도는 예측할 수가 없기 때문입니다. n²의 시간 복잡도를 예측할 수 없는 이유는 실제 수를 대입해 계산해보면 유추할 수 있습니다. 1,000,000²은 즉시 처리하기에 무리가 있는 숫자입니다. (1,000,000 * 1,000,000 = 1,000,000,000,000(조)) 그렇기 때문에 시간 복잡도를 줄이려고 노력해야 합니다.
그러나 만약 n ≤ 500 으로 입력이 제한된 경우에는 O(n³)의 시간 복잡도를 가질 수 있다고 예측할 수 있습니다. 예측한 대로 O(n³)의 시간 복잡도를 가지는 프로그램을 작성한다면 문제를 금방 풀 수 있다면, 이때는 굳이 시간 복잡도를 O(log n)까지 줄이기 위해 끙끙댈 필요는 없습니다.
즉, 입력 데이터가 클 때는 O(n) 혹은 O(log n)의 시간 복잡도를 만족할 수 있도록 예측해서 문제를 풀어야 합니다. 그러나 주어진 데이터가 작을 때는 시간 복잡도가 크더라도 문제를 풀어내는 것에 집중하세요.
대략적인 데이터 크기에 따른 시간 복잡도는 다음과 같습니다.
공간 복잡도(Space Complexity)
공간 복잡도는 알고리즘이 수행되는 데에 필요한 메모리의 총량을 의미합니다. 즉 프로그램이 필요로 하는 메모리 공간을 산출하는 것을 의미합니다.
프로그램이 요구하는 공간은 고정적인 공간과 함께 가변적인 공간을 함께 요구합니다. 여기서 집중해야 할 부분은 가변적인 공간입니다. 왜냐하면 고정적인 공간은 처리할 데이터의 양에 무관하게 항상 요구되는 공간으로서, 프로그램의 성능에 큰 영향을 주지 않기 때문입니다. 그러나 가변적인 공간은 처리할 데이터의 양에 따라 다르게 요구되는 공간으로서 프로그램의 성능에 큰 영향을 줍니다.
이런 공간 복잡도 계산은 시간 복잡도 계산과 비슷하게 빅 오 (Big-O) 표기법으로 표현합니다. 아래의 가장 간단한 공간복잡도 예시를 보겠습니다.
공간 복잡도 예시
function factorial(n) {
	if(n === 1) {
		return n;
	}
	return n*factorial(n-1);
}
함수 factorial은 재귀함수로 구현되었습니다. 변수 n에 따라 변수 n이 n개가 만들어지게 되며, factorial 함수를 재귀함수로 1까지 호출할 경우 n부터 1까지 스택에 쌓이게 됩니다. 따라서 해당 함수의 공간 복잡도는 O(n)이라 볼 수 있습니다.
공간 복잡도는 얼마나 중요한가요?
보통 때의 공간 복잡도는 시간 복잡도보다 중요성이 떨어집니다. 왜냐하면 시간이 적으면서 메모리까지 지수적으로 증가하는 경우는 거의 없으며 시간 내에 발생하는 메모리 문제들은 보통 알고리즘을 구현할 때 발생하는 문제이기 때문입니다.
보통 시간 복잡도에 맞다면 공간 복잡도도 얼추 통과하기 때문에 알고리즘 구현 시 공간 복잡도에 실패했다면, 보통은 변수를 설정할 때 쓸데없는 공간을 많이 차지하도록 설정했을 경우가 많을 것이니 그것부터 확인해야 합니다.
그러나 때에 따라 공간 복잡도를 중요하게 보는 경우가 있는데, 동적 계획법(Dynamic Programming)과 같은 알고리즘이나 하드웨어 환경이 매우 한정된 경우가 바로 그 경우입니다. 동적 계획법은 알고리즘 자체가 구현 시 메모리를 많이 요구하기 때문에 입력값의 범위가 넓어지면 사용하지 못하는 경우도 많고, 하드웨어 환경이 매우 한정되어 있는 경우(ex. 임베디드, 펌웨어 등)라면 가용 메모리가 제한되어 있기 때문입니다.
Greedy Algorithm
Greedy는 "탐욕스러운, 욕심 많은" 이란 뜻입니다. Greedy Algorithm(탐욕 알고리즘)은 말 그대로 선택의 순간마다 당장 눈앞에 보이는 최적의 상황만을 쫓아 최종적인 해답에 도달하는 방법입니다. 탐욕 알고리즘으로 문제를 해결하는 방법은 다음과 같이 단계적으로 구분할 수 있습니다.
Greedy Algorithm 문제 해결 단계
- 선택 절차(Selection Procedure): 현재 상태에서의 최적의 해답을 선택합니다.
- 적절성 검사(Feasibility Check): 선택된 해가 문제의 조건을 만족하는지 검사합니다.
- 해답 검사(Solution Check): 원래의 문제가 해결되었는지 검사하고, 해결되지 않았다면 선택 절차로 돌아가 위의 과정을 반복합니다.
Greedy Algorithm 적용 예시 1
김코딩은 오늘도 편의점에서 열심히 아르바이트하고 있습니다. 손님으로 온 박해커는 과자와 음료를 하나씩 집어 들었고, 물건 가격은 총 4,040원이 나왔습니다. 박해커는 계산하기 위해 5,000원을 내밀며, 거스름돈은 동전의 개수를 최소한으로 하여 거슬러 달라고 하였습니다.
이때 김코딩은 어떻게 거슬러 주어야 할까요? 탐욕 알고리즘으로 동전의 개수를 헤아리는 일은, 우리가 일반적으로 거스름돈으로 동전을 선택하는 방법과 동일합니다. 거스름돈 960원을 채우기 위해서 먼저, 500원짜리 동전을 한 개 선택합니다. 그다음은 100원짜리 동전을 네 개 선택하고, 그다음엔 50원짜리 동전과 10원짜리 동전을 각각 하나씩 선택할 겁니다. 김코딩의 입장에 탐욕 알고리즘의 문제 해결 과정을 적용하면 다음과 같이 문제를 단계적으로 구분할 수 있습니다.
- 선택 절차 : 거스름돈의 동전 개수를 줄이기 위해 현재 가장 가치가 높은 동전을 우선 선택합니다.
- 적절성 검사 : 1번 과정을 통해 선택된 동전들의 합이 거슬러 줄 금액을 초과하는지 검사합니다. 초과하면 가장 마지막에 선택한 동전을 삭제하고, 1번으로 돌아가 한 단계 작은 동전을 선택합니다.
- 해답 검사 : 선택된 동전들의 합이 거슬러 줄 금액과 일치하는지 검사합니다. 액수가 부족하면 1번 과정부터 다시 반복합니다.
이 과정을 통해 얻은 문제에 대한 해답은 다음과 같습니다.
가장 가치가 높은 동전인 500원 1개를 먼저 거슬러 주고 잔액을 확인한 뒤, 이후 100원 4개, 50원 1개, 10원 1개의 순서대로 거슬러 줍니다.
Greedy Algorithm 적용 예시 2
🥖$3 40g | 🍞$1.5 25g | 🥯$2.5 5g | 🥐 $2 20g
👜 LIMIT 35g
장발장이 빵 가게에서 빵을 훔치려고 합니다. 장발장의 가방은 35g까지의 빵만 담을 수 있고, 빵은 가격이 전부 다르며, 4개의 종류가 각 1개씩 있습니다. 빵은 쪼개어 담을 수 있습니다. 장발장은 최대한 가격이 많이 나가는 빵으로만 채우고 싶습니다.
장발장이 탐욕 알고리즘을 사용한다면 문제는 다음과 같이 간단해집니다.
1. 가방에 넣을 수 있는 물건 중 무게 대비 가장 비싼 물건을 넣습니다.
2. 그다음으로 넣을 수 있는 물건 중 무게 대비 가장 비싼 물건을 넣습니다.
3. 만약, 가방에 다 들어가지 않는다면 쪼개어 넣습니다.
1달러당 무게(반올림)
🥖 13.3g
🍞 16.7g
🥯 2g
🥐 10g
달러당 부피가 가장 작은 빵(무게 대비 가장 비싼 물건)부터 담아야 합니다.
$1당 2g인 🥯 3번 빵(5g) 먼저 가방에 담을 수 있습니다: [남은 가방의 무게: 30g]
$1당 10g인 🥐 4번 빵(20g)을 다음으로 담을 수 있습니다: [남은 가방의 무게: 10g]
$1당 13.3g인 🥖1번 빵(40g)을 다음으로 담을 수 있습니다.
그러나, 40g을 온전히 못 채우기 때문에 쪼개어, 10g만 넣습니다: [남은 가방의 무게: 0g]
= $2.5 + $2 + $0.75 ⇒ 장발장은 최대 $5.25어치의 빵을 훔칠 수 있습니다.
탐욕 알고리즘은 문제를 해결하는 과정에서 매 순간, 최적이라 생각되는 해답(locally optimal solution)을 찾으며, 이를 토대로 최종 문제의 해답(globally optimal solution)에 도달하는 문제 해결 방식입니다.
하지만, 만약 “빵을 쪼갤 수 없는 상황”이라면 마시멜로 실험 결과처럼 Greedy는 최적의 결과를 보장할 수 없습니다. 무게 대비 가장 비싼 물건을 넣는다는 조건을 두고 현재에 최선을 다하게 되면 빈 자리 5g이 남게 되고 결과를 도출하게 되지만, 빈 자리 5g을 채워 더 큰 최댓값을 만들 수 있는 최선의 상황이 있을 수도 있기 때문입니다.
마시멜로 실험이란?
지금 마시멜로를 받겠다고 말하면 1개를 받을 수 있지만, 1분을 기다렸다가 받는다면 2개를 받을 수 있다.
greedy는 "현재"에 최선인 선택을 하기 때문에 마시멜로를 당장 받아내어 1개를 받게 되지만,
전체적으로 보게 되면 1분 뒤에 받는 2개가 최적의 선택이 된다.
따라서, 두 가지의 조건을 만족하는 "특정한 상황" 이 아니면 탐욕 알고리즘은 최적의 해를 보장하지 못합니다. 탐욕 알고리즘을 적용하려면 해결하려는 문제가 다음의 2가지 조건을 성립하여야 합니다.
탐욕 알고리즘의 특징
탐욕적 선택 속성(Greedy Choice Property) : 앞의 선택이 이후의 선택에 영향을 주지 않습니다.
최적 부분 구조(Optimal Substructure) : 문제에 대한 최종 해결 방법은 부분 문제에 대한 최적 문제 해결 방법으로 구성됩니다.
탐욕 알고리즘은 항상 최적의 결과를 도출하는 것은 아니지만, 어느 정도 최적에 근사한 값을 빠르게 도출할 수 있는 장점이 있습니다. 이 장점으로 인해 탐욕 알고리즘은 근사 알고리즘으로 사용할 수 있습니다.
Algorithm 구현
알고리즘 문제를 푼다는 것은, 내가 생각한 문제 해결 과정을 컴퓨팅 사고로 변환하여 코드로 구현한다는 것과 같고, 각 유형은 원하는 의도가 분명하게 있고, 그것을 해결하는 것이 목표라고 했습니다.
- 데이터를 정렬할 수 있는가?
- 데이터를 효율적으로 탐색할 수 있는가?
- 데이터를 조합할 수 있는가? ...etc
이렇게 카테고리를 분류한다고 해도 내가 생각한 로직을 '코드로 구현'한다는 건 전부 공통적인 속성입니다. 이러한 문제 해결을 코드로 풀어낼 때, 정확하고 빠를수록 구현 능력이 좋다고 말합니다. 구현 능력이 좋은 개발자를 선발할 의도로 구현 능력을 직접 평가하기도 합니다. '정해진 시간 안에 빠르게 문제를 해결하는 능력'을 보기 위함입니다. 머리로 이해하고 있어도 코드로 작성하지 않는다면(혹은 시간 부족으로 못 한다면) 정답이 될 수 없기 때문입니다. 본인이 선택한 프로그래밍 언어의 문법을 정확히 알고 있어야 하며, 문제의 조건에 전부 부합하는 코드를 실수 없이 빠르게 작성하는 것을 목표로 두는 것을 구현 문제, 구현 유형이라고 통칭할 수 있습니다.
보통 이러한 문제들은 구현하는 것 자체를 굉장히 까다롭게 만듭니다. 지문을 매우 길게 작성하거나, 까다로운 조건이나 상황을 붙인다거나, 로직은 쉽지만 구현하려는 코드가 굉장히 길어지게 되는 문제들이 대다수입니다. 그렇기 때문에 깊은 집중력과 끈기가 필요합니다.
구현 능력을 보는 대표적인 사례에는 완전 탐색(brute force)과 시뮬레이션(simulation)이 있습니다. 완전 탐색이란 가능한 모든 경우의 수를 전부 확인하여 문제를 푸는 방식을 뜻하고, 시뮬레이션은 문제에서 요구하는 복잡한 구현 요구 사항을 하나도 빠트리지 않고 코드로 옮겨, 마치 시뮬레이션을 하는 것과 동일한 모습을 그립니다.
완전 탐색
모든 문제는 완전 탐색으로 풀 수 있습니다. 이 방법은 굉장히 단순하고 무식하지만 "답이 무조건 있다"는 강력함이 있습니다.
예를 들어, 양의 정수 1부터 100까지의 임의의 요소가 오름차순으로 하나씩 담긴 배열 중, 원하는 값 N을 찾기 위해서는 배열의 첫 요소부터 마지막 요소까지 전부 확인한다면 최대 100번의 탐색 끝에 원하는 값을 찾을 수 있습니다.
그렇지만, 문제 해결할 땐 기본적으로 두 가지 규칙이 붙습니다.
- 첫 번째, 문제를 해결할 수 있는가?
- 두 번째, 효율적으로 동작하는가?
완전 탐색은 첫 번째 규칙을 만족시킬 수 있는 강력한 무기이지만, 두 번째 규칙은 만족할 수 없는 경우가 있습니다.
양의 정수 1부터 100까지의 임의의 요소가 오름차순으로 하나씩 담긴 배열 중, 원하는 값 N을 찾으시오.
단, 시간 복잡도가 O(N)보다 낮아야 합니다.
이러한 문제가 나왔을 때, 최악의 경우 100번을 시도해야 하는 완전 탐색은 두 번째 규칙을 만족할 수 없습니다. 배열을 작은 수에서 큰 수, 혹은 그 반대로 정렬한 후 이분 탐색을 사용하는 방법 등 다른 알고리즘을 사용해야 합니다. 그렇기 때문에, 완전 탐색은 문제를 풀 수 있는 가능한 모든 방법을 고려한 후 효율적으로 동작하는 알고리즘이 완전 탐색밖에 없다고 판단될 때 적용할 수 있습니다.
완전 탐색은 단순히 모든 경우의 수를 탐색하는 모든 경우를 통칭합니다. 완전히 탐색하는 방법에는 Brute Force(조건/반복을 사용하여 해결), 재귀, 순열, DFS/BFS 등 여러 가지가 있습니다. 우리는 그중, Brute Force(무차별 대입)에 대해 예시를 들어보겠습니다.
Brute Force 예시
우리 집에는 세 명의 아이들이 있습니다. 아이들의 식성은 까다로워, 먹기 싫은 음식과 좋아하는 음식을 철저하게 구분합니다. 먹기 싫은 음식이 식탁에 올라왔을 땐 음식 냄새가 난다며 그 주변의 음식까지 전부 먹지 않고, 좋아하는 음식이 올라왔을 땐 해당 음식을 먹어야 합니다. 세 아이의 식성은 이렇습니다.첫째: (싫어하는 음식 - 미역국, 카레) (좋아하는 음식 - 소고기, 된장국, 사과)
둘째: (싫어하는 음식 - 참치, 카레) (좋아하는 음식 - 미역국, 된장국, 바나나)
셋째: (싫어하는 음식 - 소고기) (좋아하는 음식 - 돼지고기, 된장국, 참치)100개의 반찬이 일렬로 랜덤하게 담긴 상이 차려지고, 한 명씩 전부 먹을 수 있다고 할 때, 가장 많이 먹게 되는 아이와 가장 적게 먹게 되는 아이는 누구일까요? (단, 그 주변의 음식은 반찬의 앞, 뒤로 한정합니다.)
이 문제는 단순히 100개의 반찬을 첫째, 둘째, 셋째의 식성에 맞게 하나씩 대입하여 풀 수 있습니다.
for(let i = 0; i < 100; i++) {
  if(첫째 식성) {
    if(싫어하는 음식이 앞뒤로 있는가) {
      그냥 넘어가자;
    }
    좋아하는 음식 카운트;
  }
  if(둘째 식성) {
    if(싫어하는 음식이 앞뒤로 있는가) {
      그냥 넘어가자;
    }
    좋아하는 음식 카운트;
  }
  if(셋째 식성) {
    if(싫어하는 음식이 앞뒤로 있는가) {
      그냥 넘어가자;
    }
    좋아하는 음식 카운트;
  }
}

return 많이 먹은 아이;
각각 몇 가지 음식을 얼마나 먹을 수 있는지 각각 계산한 후, 제일 많이 먹는 아이와 제일 적게 먹는 아이를 파악할 수 있습니다. 문제를 풀 때, 반복문이 아닌 배열을 전부 순회하는 메서드를 사용한다거나 간결한 코드를 위한 문법을 사용한다고 하더라도 배열을 전부 탐색하여 세 명의 값을 도출한다는 것엔 변함이 없습니다.
시뮬레이션
시뮬레이션은 모든 과정과 조건이 제시되어, 그 과정을 거친 결과가 무엇인지 확인하는 유형입니다. 보통 문제에서 설명해 준 로직 그대로 코드로 작성하면 되어서 문제 해결을 떠올리는 것 자체는 쉬울 수 있으나 길고 자세하여 코드로 옮기는 작업이 까다로울 수 있습니다.
시뮬레이션 예시
무엇을 위한 조직인지는 모르겠지만, 비밀스러운 비밀 조직 '시크릿 에이전시'는 소통의 흔적을 남기지 않기 위해 3일에 한 번씩 사라지는 메신저 앱을 사용했습니다. 그러나 내부 스파이의 대화 유출로 인해 대화할 때 조건을 여러 개 붙이기로 했습니다. 해당 조건은 이렇습니다.
캐릭터는 아이디, 닉네임, 소속이 영문으로 담긴 배열로 구분합니다.
소속은 'true', 'false', 'null' 중 하나입니다.
소속이 셋 중 하나가 아니라면 아이디, 닉네임, 소속, 대화 내용의 문자열을 전부 X로 바꿉니다.
아이디와 닉네임은, 길이를 2진수로 바꾼 뒤, 바뀐 숫자를 더합니다.
캐릭터와 대화 내용을 구분할 땐 공백:공백으로 구분합니다: ['Blue', 'Green', 'null'] : hello.
띄어쓰기 포함, 대화 내용이 10글자가 넘을 때, 내용에 .,-+ 이 있다면 삭제합니다.
띄어쓰기 포함, 대화 내용이 10글자가 넘지 않을 때, 내용에 .,-+@#$%^&*?! 이 있다면 삭제합니다.
띄어쓰기를 기준으로 문자열을 반전합니다: 'abc' -> 'cba'
띄어쓰기를 기준으로 소문자와 대문자를 반전합니다: 'Abc' -> 'aBC'
시크릿 에이전시의 바뀌기 전 대화를 받아, 해당 조건들을 전부 수렴하여 수정한 대화를 객체에 키와 값으로 담아 반환하세요. 같은 캐릭터가 두 번 말했다면, 공백을 한 칸 둔 채로 대화 내용에 추가되어야 합니다. 대화는 문자열로 제공되며, 하이픈- 으로 구분됩니다.문자열은 전부 싱글 쿼터로 제공되며, 전체를 감싸는 문자열은 더블 쿼터로 제공됩니다.
예: "['Blue', 'Green', 'null'] : 'hello. im G.' - ['Black', 'red', 'true']: '? what? who are you?'"
예시를 이용하여 순차적으로 작성해 봅시다.
-
"['Blue', 'Green', 'null'] : 'hello. im G.' - ['Black', 'red', 'true']: '? what? who are you?'" 입력값으로 받은 문자열을 각 캐릭터와 대화에 맞게 문자열로 파싱하고, 파싱한 문자열을 상대로 캐릭터와 대화를 구분합니다.
첫 번째 파싱은 - 을 기준으로 ['Blue', 'Green', 'null'] : 'hello. im G.', ['Black', 'red', 'true']: '? what? who are you?' 두 부분으로 나눕니다.
두 번째 파싱은 : 을 기준으로 ['Blue', 'Green', 'null'] 배열과 'hello. im G.' 문자열로 나눕니다. -
배열과 문자열을 사용해, 조건에 맞게 변형합니다.
소속이 셋 중 하나인지 판별합니다.
['Blue', 'Green', 'null'] 아이디와 닉네임의 길이를 2진수로 바꾼 뒤, 숫자를 더합니다: [1, 2, 'null']
'hello. im G.' 10 글자가 넘기 때문에, .,-+@#$%^&* 를 삭제합니다: 'hello im G'
'hello im G' 띄어쓰기를 기준으로 문자열을 반전합니다: 'olleh mi G'
'olleh mi G' 소문자와 대문자를 반전합니다: 'OLLEH MI g' -
변형한 배열과 문자열을 키와 값으로 받아 객체에 넣습니다.
{ "[1, 2, 'null']": 'OLLEH MI g' }
이렇듯, 문제에 대한 이해를 바탕으로 제시하는 조건을 하나도 빠짐없이 처리해야 정답을 받을 수 있습니다. 하나라도 놓친다면 통과할 수 없게 되고, 길어진 코드 때문에 헷갈릴 수도 있으니 주의해야 합니다.
Dynamic Programming
Dynamic Programming(DP, 동적 계획법)은 탐욕 알고리즘(Greedy)과 함께 언급하는 알고리즘으로, 줄임말로 DP라고 하는 이 알고리즘은, 탐욕 알고리즘과 같이 작은 문제에서 출발한다는 점은 같습니다. 그러나, 탐욕 알고리즘이 매 순간 최적의 선택을 찾는 방식이라면, DP는 모든 경우의 수를 조합해 최적의 해법을 찾습니다.
즉, 주어진 문제를 여러 개의 (작은) 하위 문제로 나누어 풀고, 하위 문제들의 해결 방법을 결합하여 최종 문제를 해결합니다. 하위 문제를 계산한 뒤 그 해결책을 저장하고, 나중에 동일한 하위 문제를 만날 경우 저장된 해결책을 적용해 계산 횟수를 줄입니다. 다시 말해, 하나의 문제는 단 한 번만 풀도록 하는 알고리즘이 바로 다이내믹 프로그래밍입니다.
다이내믹 프로그래밍은 다음 두 가지 가정이 만족하는 조건에서 사용할 수 있습니다.
- Overlapping Sub-problems : 큰 문제를 작은 문제로 나눌 수 있고, 이 작은 문제가 중복해서 발견된다.
- Optimal Substructure : 작은 문제에서 구한 정답은 그것을 포함하는 큰 문제에서도 같다. 즉, 작은 문제에서 구한 정답을 큰 문제에서도 사용할 수 있다.
Overlapping Sub-problems
큰 문제로부터 나누어진 작은 문제는 큰 문제를 해결할 때 여러 번 반복해서 사용될 수 있어야 합니다.
이 가정의 대표적인 예시로 피보나치 수열을 들 수 있습니다.
피보나치 수열은 첫째와 둘째 항이 1이며, 그 뒤의 모든 항은 바로 앞 두 항의 합과 같은 수열입니다.
function fib(n) {
	if(n <= 2) {
		return 1;
	};
	return fib(n - 1) + fib(n - 2);
}
// 1, 1, 2, 3, 5, 8...
그림에서 본 것을 토대로, 7번째 피보나치 수 fib(7)을 구하는 과정은 다음과 같습니다.
fib(7) = fib(6) + fib(5)
fib(7) = (fib(5) + fib(4)) + fib(5) // fib(6) = fib(5) + fib(4)
fib(7) = ((fib(4) + fib(3)) + fib(4)) + (fib(4) + fib(3)) // fib(5) = fib(4) + fib(3)
...
피보나치 수열은 위 예시처럼 동일한 계산을 반복적으로 수행해야 합니다.
fib(5) 는 두 번, fib(4) 는 세 번, fib(3) 은 다섯 번의 동일한 계산을 반복합니다.
이렇게, 작은 문제의 결과를 큰 문제를 해결하기 위해 여러 번 반복하여 사용할 수 있을 때, 부분 문제의 반복(Overlapping Sub-problems)이라는 조건을 만족합니다.
그러나 이 조건을 만족하는지 확인하기 전에, 한 가지 주의해야 할 점이 있습니다. 주어진 문제를 단순히 반복 계산하여 해결하는 것이 아니라, 작은 문제의 결과가 큰 문제를 해결하는 데에 여러 번 사용될 수 있어야 합니다.
Optimal Substructure
이 조건에서 말하는 정답은 최적의 해결 방법(Optimal solution)을 의미합니다. 주어진 문제에 대한 최적의 해법을 구할 때, 주어진 문제의 작은 문제들의 최적의 해법(Optimal solution of Sub-problems)을 찾아야 합니다. 그리고 작은 문제들의 최적의 해법을 결합하면, 결국 전체 문제의 최적의 해법(Optimal solution)을 구할 수 있습니다.
이 가정의 대표적인 예시로 최단 경로를 찾는 문제를 들 수 있습니다.
A에서 D로 가는 최단 경로를 찾아야 합니다. 다음과 같이 각 지점이 있고, 한 지점에서 다른 지점으로 갈 수 있는 경로와 해당 경로의 거리는 다음과 같습니다.
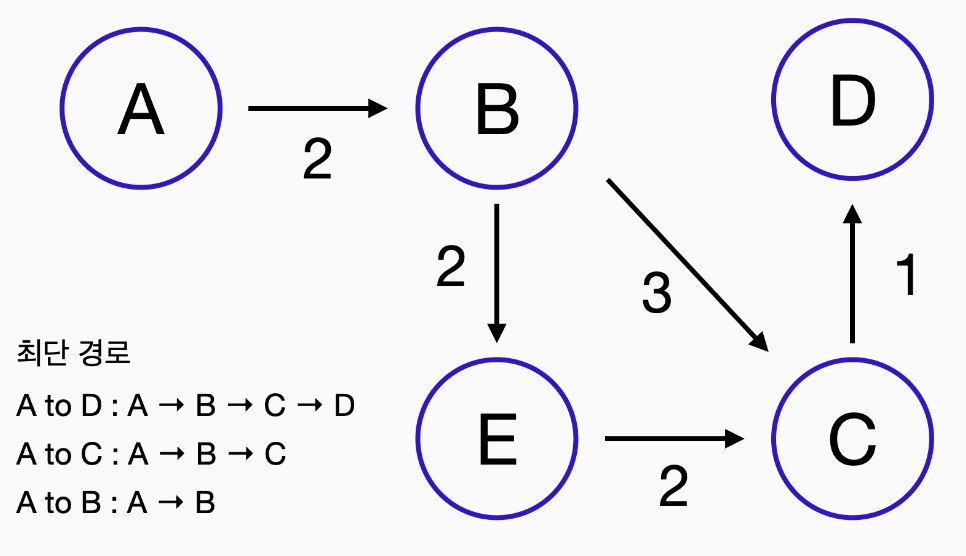
- A → D로 가는 최단 경로 : A → B → C → D
- A → C로 가는 최단 경로 : A → B → C (A → B → E → C 가 아닙니다.)
- A → B로 가는 최단 경로 : A → B
정리해보면 A에서 D로 가는 최단 경로는 그것의 작은 문제인 A에서 C로 가는 최단 경로, 그리고 한 번 더 작은 문제인 A에서 B로 가는 최단 경로의 파악할 수 있습니다. 이렇게 Dynamic Programming을 적용하기 위해서는, 작은 문제의 최적 해법을 결합하여 최종 문제의 최적 해법을 구할 수 있어야 합니다.
순열과 조합
순열
순열(順列, permutation)은 서로 다른 n개의 원소를 가지는 어떤 집합에서 중복 없이 순서에 상관있게 r개의 원소를 선택하거나 혹은 나열하는 것이며, 이는 조합과 마찬가지로 n개의 원소로 이루어진 집합에서 r개의 원소로 이루어진 부분집합을 만드는 것과 같습니다.
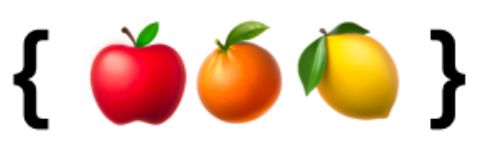
여기 사과와 오렌지, 레몬 총 3개의 원소로 이루어진 집합이 있습니다. 만약에 이 3가지의 과일 중 2가지의 과일을 중복 없이, 이번에는 순서에 상관있게 부분집합을 만든다면 총 몇 개의 부분집합이 나올 수 있을까요?
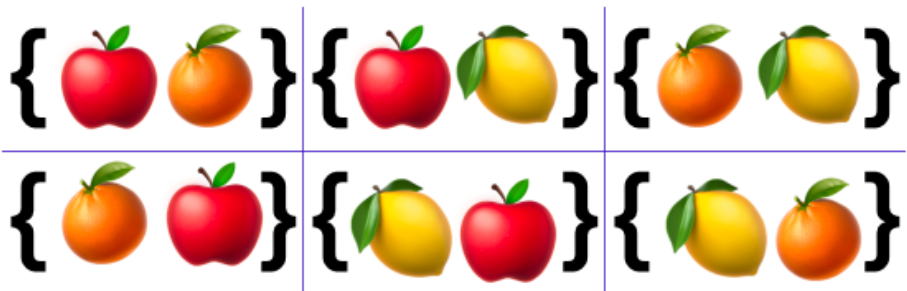
총 6개의 부분집합이 나올 수 있을 것입니다. 왜냐하면 순열은 조합과 달리 순서도 따져서 부분집합을 만들기 때문입니다. 즉 사과가 뒤로 가는 경우와 사과가 앞으로 가는 경우를 다르게 보고 각기 하나의 경우의 수로 치는 것입니다. 그래서 {사과 오렌지} {오렌지 사과}가 다른 집합으로 취급될 수 있는 것입니다.
순열의 식은 이렇게 표현됩니다.
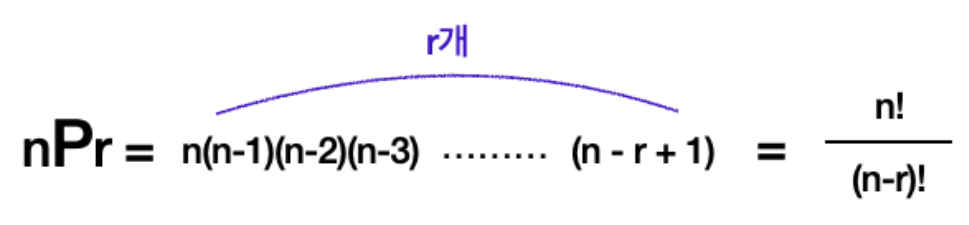
순열은 일반화 과정을 거쳐, Permutation의 약자 P로 표현합니다. 여기서도 n은 원소의 총개수를 의미하고, r은 그중 뽑는 개수를 의미합니다. 여기서 중요한 것은, 순열은 중복을 허용하지 않기 때문에 반드시 R <= N을 만족해야 한다는 것입니다. 한 번 3P2의 값을 식으로 확인해보도록 하겠습니다.
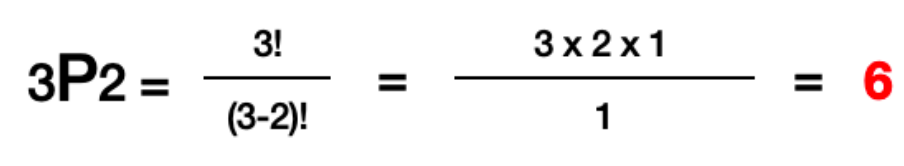
이렇게 식으로 확인해 보았을 때도 6개의 부분조합이 도출됨을 알 수 있었습니다. 이어서 살펴본 조합의 식은 순열의 개념 또한 이용됩니다. 이어서 조합에 대해 알아보도록 하겠습니다.
//문제: 카드 뽑기
//case 1. 순서를 생각하며 3장을 선택할 때의 모든 경우의 수
function permutationLoop() {
	// 순열 요소가 인자로 주어질 경우, 인자 그대로 사용하면 되지만, 인자가 주어지지 않고
	// 문제 안에 포함되어 있을 경우 이런 식으로 직접 적어서 사용합니다.
  let lookup = ['A', 'B', 'C', 'D', 'E'];

  let result = [];

  for (let i = 0; i < lookup.length; i++) {
    for (let j = 0; j < lookup.length; j++) {
      for (let k = 0; k < lookup.length; k++) {
        if(i === j || j === k || k === i) continue;
        result.push([lookup[i], lookup[j], lookup[k]])
      }
    }
  }

  return result;
}

permutationLoop();
조합
조합(組合, combination)은 서로 다른 n개의 원소를 가지는 어떤 집합에서 중복 없이 순서에 상관없게 r개의 원소를 선택하는 것이며, 이는 n개의 원소로 이루어진 집합에서 r개의 원소로 이루어진 부분집합을 만드는 것과 같습니다.
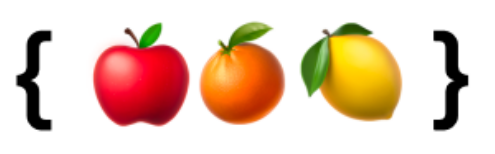
여기 또다시 사과와 오렌지, 레몬 총 3개의 원소로 이루어진 집합이 있습니다. 만약에 이 3가지의 과일 중 2가지의 과일을 중복 없이, 순서에 상관없는 부분집합을 만든다면 총 몇 개의 부분집합이 나올 수 있을까요?
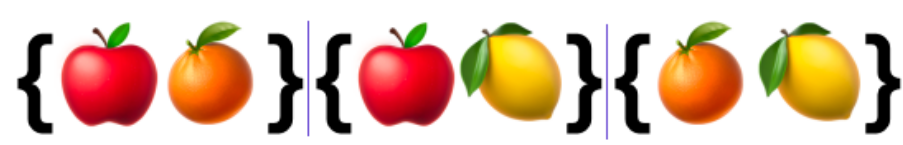
총 3개의 부분집합이 나올 수 있을 것입니다. 왜냐하면 조합은 순서에 상관없이 원소를 선택해 부분집합을 만드는 것이기 때문입니다. 즉 사과가 뒤로 가든, 앞으로 가든 상관 없이 그저 사과 1개와 오렌지 1개가 있으면 하나의 경우의 수로 치는 것입니다.
조합의 식은 이렇게 표현합니다.
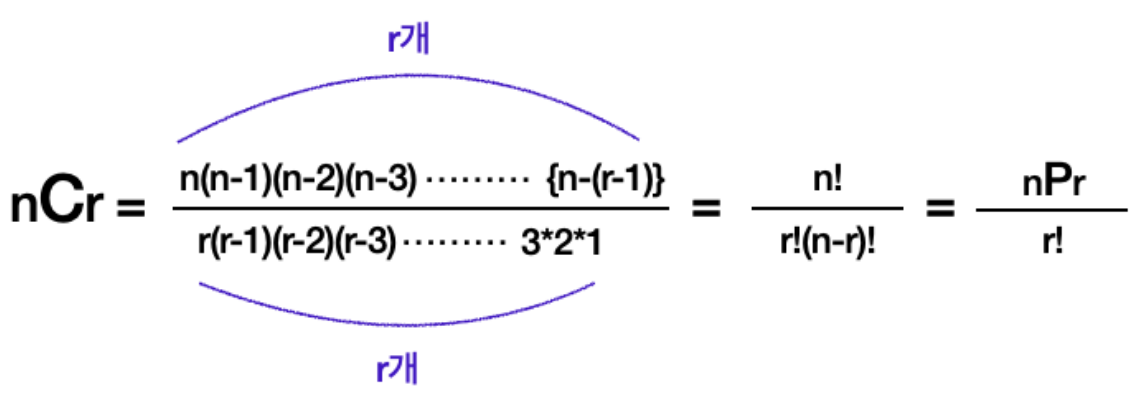
조합은 일반화 과정을 거쳐, Combination의 약자 C로 표현합니다. 여기서 n은 원소의 총개수를 의미하고, r은 그중 뽑는 개수를 의미합니다. 여기서 중요한 것은, 조합 또한 중복을 허용하지 않기 때문에 반드시 R ≤ N을 만족해야 한다는 것입니다. 과일이 3개가 있는데 4개, 5개를 뽑으라는 것처럼, 없는 것들을 뽑으라는 말과 똑같기 때문에 R은 최대 N개까지만 뽑을 수 있습니다. 한 번 3C2의 값을 식으로 확인해보도록 하겠습니다.
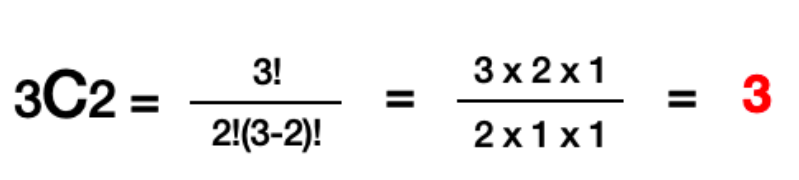
이렇게 식으로 확인해 보았을 때도 3개의 부분조합이 도출됨을 알 수 있었습니다.
function combinationLoop() {
	// 조합 요소가 인자로 주어질 경우, 인자 그대로 사용하면 되지만, 인자가 주어지지 않고
	// 문제 안에 포함되어 있을 경우 이런 식으로 직접 적어서 사용합니다.
  let lookup = ['A', 'B', 'C', 'D', 'E'];
  let result = [];

  console.log(lookup);

  for (let i = 0; i < lookup.length; i++) {
    for (let j = i + 1; j < lookup.length; j++) {
      for (let k = j + 1; k < lookup.length; k++) {
        result.push([lookup[i], lookup[j], lookup[k]]);
      }
    }
  }

  return result;
}

combinationLoop();
GCD, LCM
GCD
최대공약수(Greatest Common Divisor, GCD)는 두 수 이상의 여러 공약수 중 최대인 수를 가리킵니다.
공약수(Common Divisor)
최대공약수의 개념 중 공약수는 두 수 이상의 여러 수 중 공통된 약수를 의미합니다. 여기서 약수(Divisor)는 어떤 수를 나누어떨어지게 하는 수를 의미합니다.
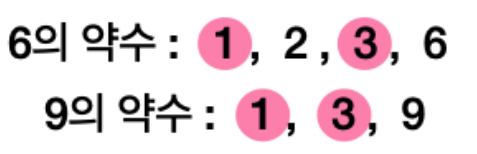
여기 6과 9 두 수가 있습니다. 미리 표기한 것처럼 6의 약수는 1, 2, 3, 6이고 9의 약수는 1, 3, 9입니다. 이 중 공통된 약수는 1, 3으로 공약수라고 표현합니다. 여기서 최대공약수를 찾아보겠습니다.
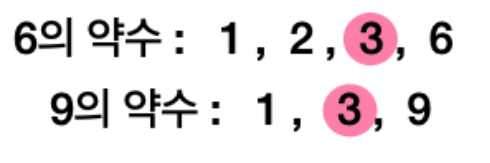
여러 개의 공약수 중 최대인 수가 바로 최대공약수이므로, 6과 9의 최대공약수는 3임을 알 수 있습니다.
LCM
최소공배수(Lowest Common Multiple, LCM)는 두 수 이상의 여러 공배수 중 최소인 수를 가리킵니다.
공배수(Common Multiple)
최소공배수의 개념 중 공배수는 두 수 이상의 여러 수 중 공통된 배수를 의미합니다. 여기서 배수(Multiple)는 하나의 수에 정수를 곱한 수입니다. 반대로 말해서, 배수는 그 수에 의해 나누어 떨어지는 수라고 볼 수 있습니다.
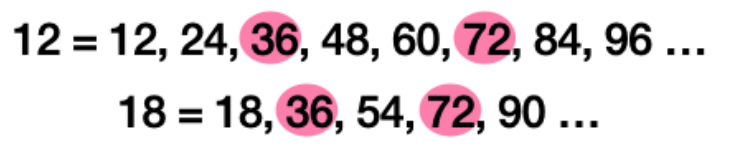
여기 12와 18 두 수가 있습니다. 두 수의 공배수는 이런 식으로 해당 수의 배수를 나열해 겹치는 수를 찾는 방식으로 구할 수 있을 것입니다. 공배수의 경우 배수이기 때문에 무수히 많으므로 가장 큰 공배수는 구할 수 없습니다. 그러므로 최소공배수를 찾아야 하는데, 여기서 최소 공배수는 36임을 알 수 있습니다.
GCD와 LCM을 구하는 방식
구하는 방식에는 여러 방식이 있습니다. 가장 작은 수들의 곱으로 나타내며 구하는 방식과, 공약수로 나누어보며 최대공약수와 최소공배수를 구하는 방법이 있습니다. 그리고 마지막에는 알고리즘 문제에서 가장 많이 쓰이는 유클리드 호제법을 알아보도록 하겠습니다.
가장 작은 수들의 곱으로 나타내며 구하는 법
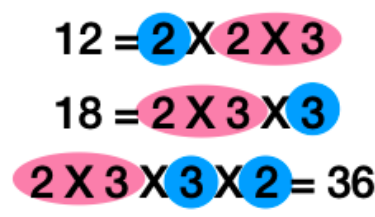
여기 다시 12와 18이 있습니다. 12와 18을 가장 작은 수의 곱으로 나타내봅니다. 여기서 겹치는 부분인 2와 3을 곱한 수인 6이 최대공약수이고, 6을 중심으로 2와 3을 곱해 나오는 수인 36이 최소공배수가 됩니다.
공약수로 나누어보며 구하는 법
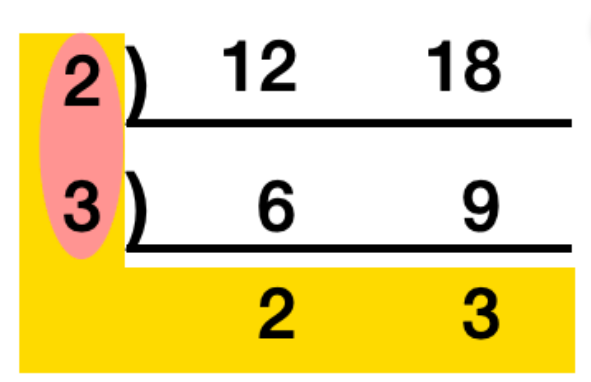
이번에는 공약수로 나누어보며 최대공약수와 최소공배수를 구하는 법을 알아보겠습니다. 우리는 이미 2와 3이 공약수임을 알고 있습니다. 해당 공약수들로 12와 18을 더 이상 나눌 수 없는 수까지 나눕니다. 여기서 나누는 데에 사용된 수인 2와 3을 곱하면 6이 나오고, 이 6은 최대공약수가 됩니다. 그리고 나누는 데에 사용된 수와 더 이상 나눌 수 없는 수들을 곱하게 되면 36이 나오고, 이 수는 최소공배수가 됩니다.
유클리드 호제법
어떤 방식으로 구하는지 알아봤으므로, 이번에는 여러분들이 GCD와 LCM 개념이 쓰이는 문제를 풀 때 가장 많이 쓰이는 유클리드 호제법에 대해 알아보도록 하겠습니다.
유클리드 호제법을 알고 있다면 최대공약수와 최소공배수를 구하는 모든 문제에 일단 적용해보고 시작할 수 있게 됩니다. 유클리드 호제법은 최대공약수와 관련이 깊은 공식입니다. 2개의 자연수 a와 b가 있을 때, a를 b로 나눈 나머지를 r이라 하면 a와 b의 최대공약수는 b와 r의 최대공약수와 같다는 이론입니다. 이러한 성질에 따라 b를 r로 나눈 나머지 r’를 구하고, 다시 r을 r’로 나누는 과정을 반복해, 나머지가 0이 되었을 때 나누는 수가 a와 b의 최대공약수임을 알 수 있게 됩니다.
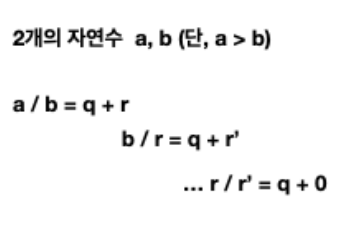
해당 수식을 보며 다시 이해해보도록 하겠습니다. 여기 2개의 자연수 a와 b가 있습니다. 단 a가 b보다 커야 한다는 조건(절대적 조건)이 있습니다.
왜냐하면 유클리드 호제법은 나머지가 0이 될 때까지 반복하는 과정이기 때문에 나누는 수가 양수이면서 정수여야 하기 때문입니다.
이제 a와 b를 나누었을 때 q와 r이 나옵니다. q는 몫(Quotient)을 의미하고, r은 나머지(Rest)를 의미한다고 생각하시면 됩니다. 여기서 다시 b를 r로 나눕니다. 그러면 다시 몫인 q와 나머지인 r’가 나올 것이고 r을 다시 r’와 나누는 과정을 반복하다 보면, 언젠가 나누어 떨어지면서 나머지인 r이 최종적으로 0이 되는 상황이 도출됩니다. 이때 나누는 수인 r’가 바로 최대공약수라는 의미입니다. 이번에는 실제 자연수를 이용해 확인해보도록 하겠습니다.
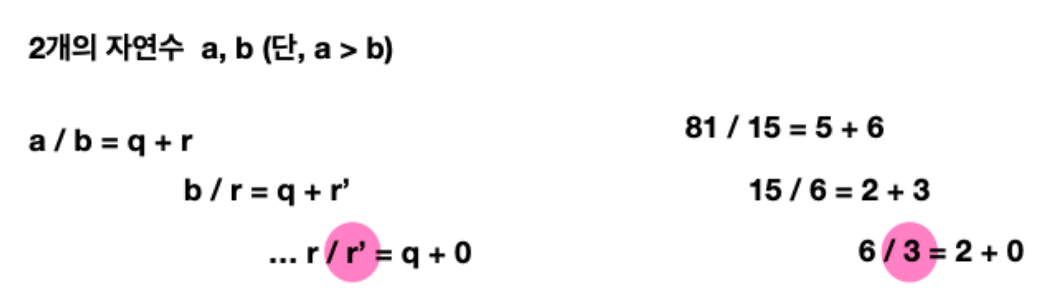
여기 81과 15가 있습니다. 같은 방식으로 쭉 나눴을 때, 마지막 나눗셈에서 나누는 수인 3이 최대공약수임을 확인할 수 있습니다. 이런 식으로 유클리드 호제법을 이용하게 되면 최대공약수를 쉽게 구할 수 있게 되고, 최대공약수를 구할 수 있게 되면 최소공배수는 자연스럽게 구할 수 있게 됩니다.
//유클리드 호제법을 이용해 최대공약수를 구하는 로직
function gcd(a, b){
	while(b !== 0){
		let r = a % b;
		a = b;
		b = r;
	}
	return a;
}

//유클리드 호제법을 이용해 최소공배수를 구하는 로직
function lcm(a, b){
	return a * (b / gcd(a, b));
}
멱집합
집합 {1, 2, 3}의 모든 부분집합은 {}, {1}, {2}, {3}, {1, 2}, {1, 3}, {2, 3}, {1, 2, 3} 으로 나열할 수 있고, 이 부분집합의 총 개수는 8개입니다. 그리고 이 모든 부분집합을 통틀어 멱집합이라고 합니다. 이렇게 어떤 집합이 있을 때, 이 집합의 모든 부분집합을 멱집합 이라고 합니다. 모든 부분집합을 나열하는 방법은 다음과 같이 몇 단계로 구분할 수 있습니다. 부분집합을 나열하는 방법에서 가장 앞 원소(혹은 임의의 집합 원소)가 있는지, 없는지에 따라 단계를 나누는 기준을 결정합니다.
Step A: 1을 제외한 {2, 3}의 부분집합을 나열합니다.
Step B: 2를 제외한 {3}의 부분집합을 나열합니다.
Step C: 3을 제외한 {}의 부분집합을 나열합니다. → {}
Step C: {}의 모든 부분집합에 {3}을 추가한 집합들을 나열합니다. → {3}
Step B: {3}의 모든 부분집합에 {2}를 추가한 집합들을 나열합니다.
Step C: {3}의 모든 부분집합에 {2}를 추가한 집합들을 나열하려면, {}의 모든 부분집합에 {2}를 추가한 집합들을 나열한 다음 {}의 모든 부분집합에 {2, 3}을 추가한 집합들을 나열합니다. → {2}, {2, 3}
Step A: {2, 3}의 모든 부분집합에 {1}을 추가한 집합들을 나열합니다.
Step B: {2, 3}의 모든 부분집합에 {1}을 추가한 집합들을 나열하려면, {3}의 모든 부분집합에 {1}을 추가한 집합들을 나열한 다음 {3}의 모든 부분집합에 {1, 2}를 추가한 집합들을 나열합니다.
Step C: {3}의 모든 부분집합에 {1}을 추가한 집합을 나열하려면, {}의 모든 부분집합에 {1}을 추가한 집합들을 나열한 다음 {}의 모든 부분집합에 {1, 3}을 추가한 집합들을 나열합니다. → {1}, {1, 3}
Step C: {3}의 모든 부분집합에 {1, 2}를 추가한 집합을 나열하려면, {}의 모든 부분집합에 {1, 2}를 추가한 집합들을 나열한 다음 {}의 모든 부분집합에 {1, 2, 3}을 추가한 집합들을 나열합니다. → {1, 2}, {1, 2, 3}
원소가 있는지, 없는지 2가지 경우를 고려하기 때문에 집합의 요소가 n 개일 때 모든 부분집합의 개수는 2n개 입니다. 예를 들어 집합의 원소가 4개라면 모든 부분집합의 개수는 24, 집합의 원소가 5개라면 25가 됩니다. 간단히 {1, 2, 3}의 모든 부분집합을 구하는 단계는 다소 복잡해 보일 수 있습니다. 그러나 이 단계를 자세히 보면, 어디서 많이 본 듯한 패턴이지 않나요?
이 순서는, 트리구조와 비슷한 형태라는 사실을 떠올릴 수 있습니다.
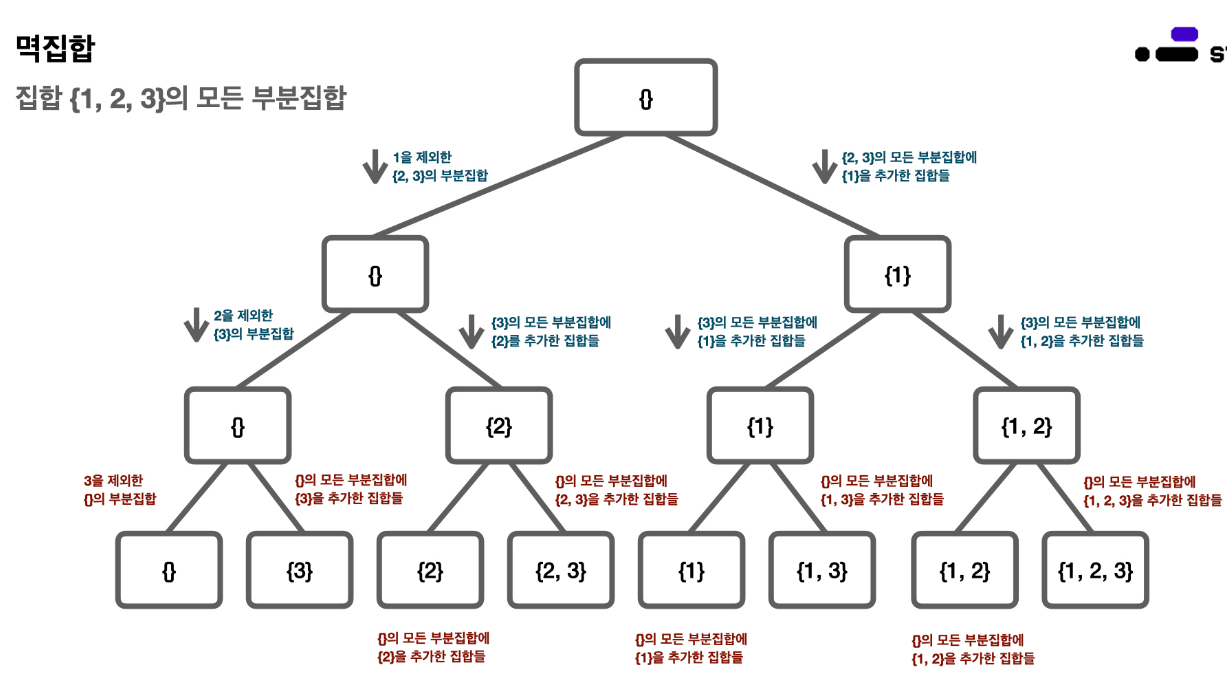
멱집합 문제는 트리 문제가 아닙니다. 그림은 이해를 돕기 위해 사용되었습니다.
멱집합을 구하는 방법에서 각 단계를 유심히 살펴보면, 순환 구조를 띠는 것을 확인할 수 있습니다. 여기서 순환구조는 임의의 원소를 제외하면서 집합을 작은 단위로 줄여나가는 방법입니다. 따라서, 문제를 작은 단위로 줄여나가는 재귀를 응용할 수 있습니다. 예를 들어 PowerSet 이라는 멱집합의 개수를 리턴하는 함수를 작성한다면, PowerSet 함수에서 자기 자신을 호출하며 문제를 더 작은 문제로 문제의 크기를 줄여 해결할 수 있습니다. 문제가 가장 작은 단위로 줄어들고, 함수가 리턴될 때 카운트를 올리는 방식으로 멱집합의 개수를 구할 수 있습니다.
여기까지 알고리즘 문제에서 수학적 개념이 어떻게 응용되고 있는지 예시를 통해 학습했습니다. 이제 이 수학적 개념을 코드로 구현해 볼 차례입니다.
//모든 부분집합을 구하는 멱집합 코드
let inputSet = ['a', 'b', 'c'];

function powerSet (arr) {
	const result = [];

	function recursion (subset, start) {
		result.push(subset);

		for(let i = start; i < arr.length; i++){
			recursion([...subset, arr[i]], i+1);
			//이렇게도 구현할 수 있습니다.
			recursion(subset.concat(arr[i]), i+1);
		}
	}

	recursion([], 0);

	return result;
}

powerSet(inputSet);
정규표현식
정규 표현식이란?
정규표현식(정규식:正規式)은 문자열에서 특정한 규칙에 따른 문자열 집합을 표현하기 위해 사용되는 형식 언어입니다. 정규표현식을 이용한다면 수십 줄이 필요한 코딩 작업을 간단하게 한두 줄로 끝낼 수 있습니다.
정규표현식은 특정한 규칙을 갖는 문자열로 이루어진 표현식이며, 정규표현식에서의 특수 문자는 각각의 고유한 규칙을 갖고 있습니다. 우리는 이러한 규칙들을 조합하여 원하는 패턴을 만들고, 특정 문자열에서 해당 패턴과 대응하는 문자를 찾을 수 있습니다.
정규 표현식 예시
아래의 코드는 사용자가 입력한 이메일이나 휴대전화 번호가 유효한지 확인하고자 할 때 사용하는 정규표현식입니다. 정규표현식을 사용한다면, 한 줄의 코드만으로 이메일이나 휴대전화 번호의 유효성을 검사할 수 있지만, 만약 그렇지 않았다면 같은 결과를 얻기 위해서는 굉장히 긴 코드가 필요했을 것입니다. (아래의 예시 코드가 아직은 낯설겠지만, 하나씩 차근차근 학습합니다.)
이메일 유효성 검사
const email = 'kimcoding@codestates.com';
let result = '올바릅니다.';

// 1. 정규표현식 사용
let regExp = /^[0-9a-zA-Z]([-_.]?[0-9a-zA-Z])*@[0-9a-zA-Z]([-_.]?[0-9a-zA-Z])*.[a-zA-Z]{2,3}$/i;

if(regExp.test(email) === false) result = '올바르지 않습니다.';
result; // '올바르지 않습니다.'

-----------------------------------------------------------------------------

// 2. 정규표현식이 아닌 경우, 이메일 아이디가 영문 소문자인지 확인하는 코드
let idx = email.indexOf('@');
if(idx === -1) result = '영문 소문자가 아닙니다.';

let ID = email.slice(0,idx);

ID.split('').forEach(e => {
	e = e.charCodeAt(0);
	if(e < 97 || e > 122){
	result = '영문 소문자가 아닙니다.';
	}
});

result; // '올바릅니다.'
휴대전화 번호 유효성 검사
let regExp = /^01([0|1|6|7|8|9]?)-?([0-9]{3,4})-?([0-9]{4})$/;정규표현식 사용하기
정규표현식은 두 가지 방법으로 사용할 수 있습니다.
리터럴 패턴
정규표현식 규칙을 슬래시(/)로 감싸 사용합니다. 슬래시 안에 들어온 문자열이 찾고자 하는 문자열이며, 컴퓨터에게 '슬래시 사이에 있는 문자열을 찾고 싶어!'라고 명령을 내리는 것입니다.
let pattern = /c/;
// 'c 를 찾을 거야!' 라고 컴퓨터에게 명령을 내리는 것입니다.
// 찾고 싶은 c를 pattern 이라는 변수에 담아놨기 때문에 이 변수를 이용하여 c 를 찾을 수 있습니다.
생성자 함수 호출 패턴
RegExp 객체의 생성자 함수를 호출하여 사용합니다.
정규식 패턴
정규표현식에 다양한 특수기호를 함께 사용하면 문자열을 다룰 때에 더 많은 옵션을 설정할 수 있습니다.
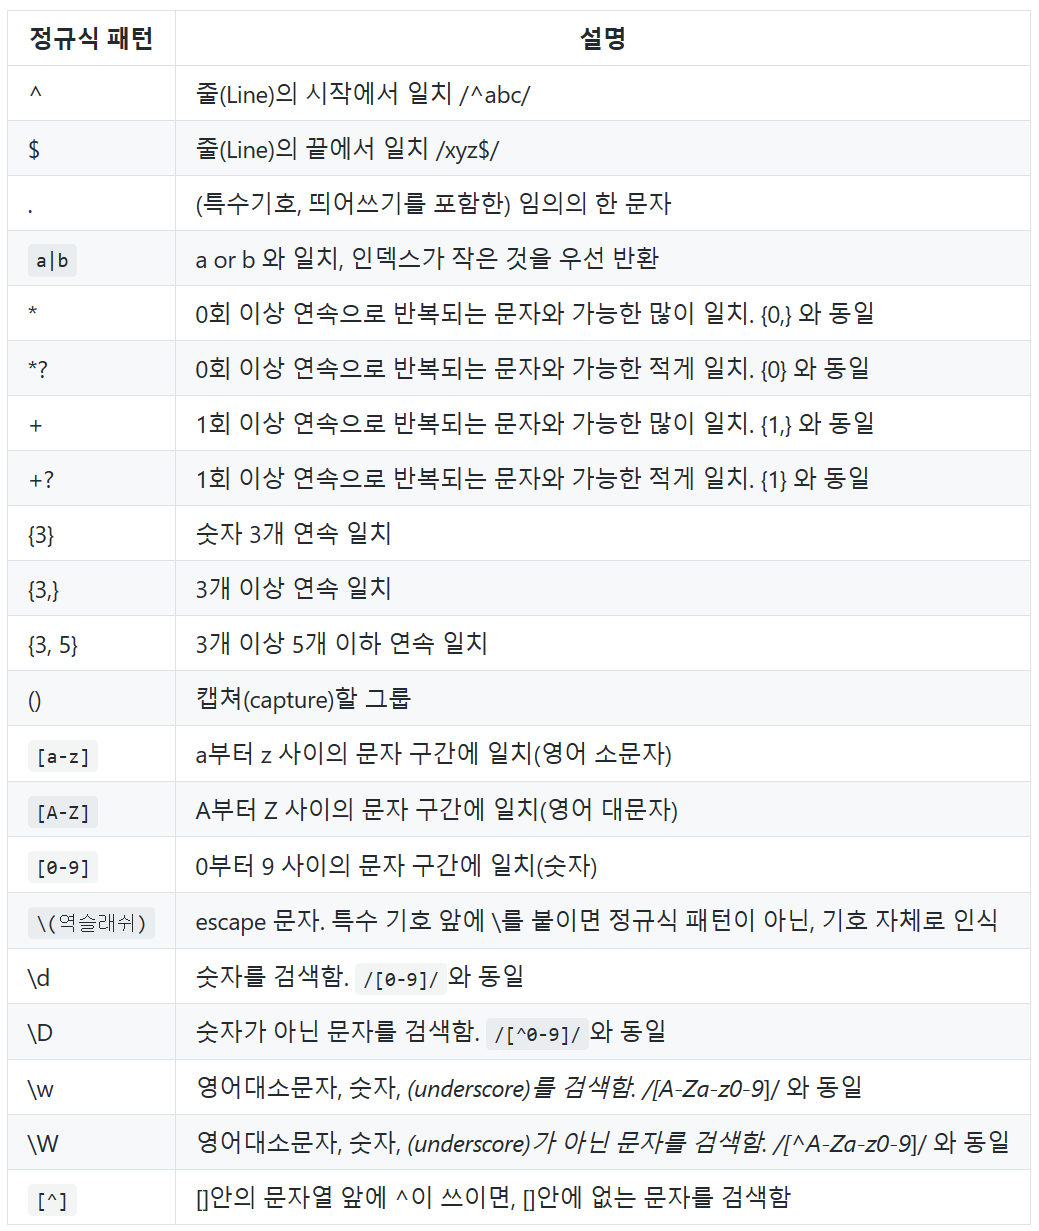
정규표현식을 활용한 알고리즘 예제
알고리즘 문제를 풀 때에도 정규표현식을 유용하게 사용할 수 있습니다. 예시 문제를 통해 정규표현식을 알고리즘 문제에 적용했을 때의 이점을 확인해 볼까요?
문자열 str 이 주어질 때, str의 길이가 5 또는 7이면서 숫자(0~9)로만 구성되어 있는지를 확인해 주는 함수를 작성하세요. 결과는 Boolean으로 리턴됩니다. 예를 들어 str가 c2021이면 false, 20212이면 true를 리턴합니다.
정규표현식을 사용하지 않고 이 문제를 해결하기 위한 코드를 작성한다면, 보통은 조건문을 통해 문자열 str의 길이와 문자의 포함 여부를 확인하는 방식으로 문제 풀이 코드를 작성했을 것입니다. 하지만 정규표현식을 이용하면 이 과정을 아래와 같이 한 줄로 줄일 수 있습니다.
// 정규표현식 사용
function solution(str) {
    return /^\d{5}$|^\d{7}$/.test(str);
}

// 정규표현식 미사용
function solution(str) {
	if(str.length === 5 || str.length === 7) {
		for(let i = 0; i < str.length; i++) {
			if(typeof Number(str[i]) !== 'number') return false;
		}
		return true;
	}
	return false;
}
정규표현식의 실례
정규표현식 내장 메소드
이번에는 내장 메소드에 대해 알아보겠습니다. JavaScript 에서 정규표현식은 객체로서 내장 메소드를 가지고 있으며, String 객체에서도 정규표현식을 사용할 수 있는 내장메소드를 가지고 있습니다. 내장 메소드를 이용하면 어떤 문자열 안에 원하는 정보를 찾거나 특정 패턴에 대응하는 문자열을 검색, 추출, 다른 문자열로 치환할 수 있습니다.
참고자료
참고자료