첫 번째 멘토링
아이디어에 대해 생각하기 이전에 프로젝트 안에 들어가야는 핵심 요소부터 알아봤다.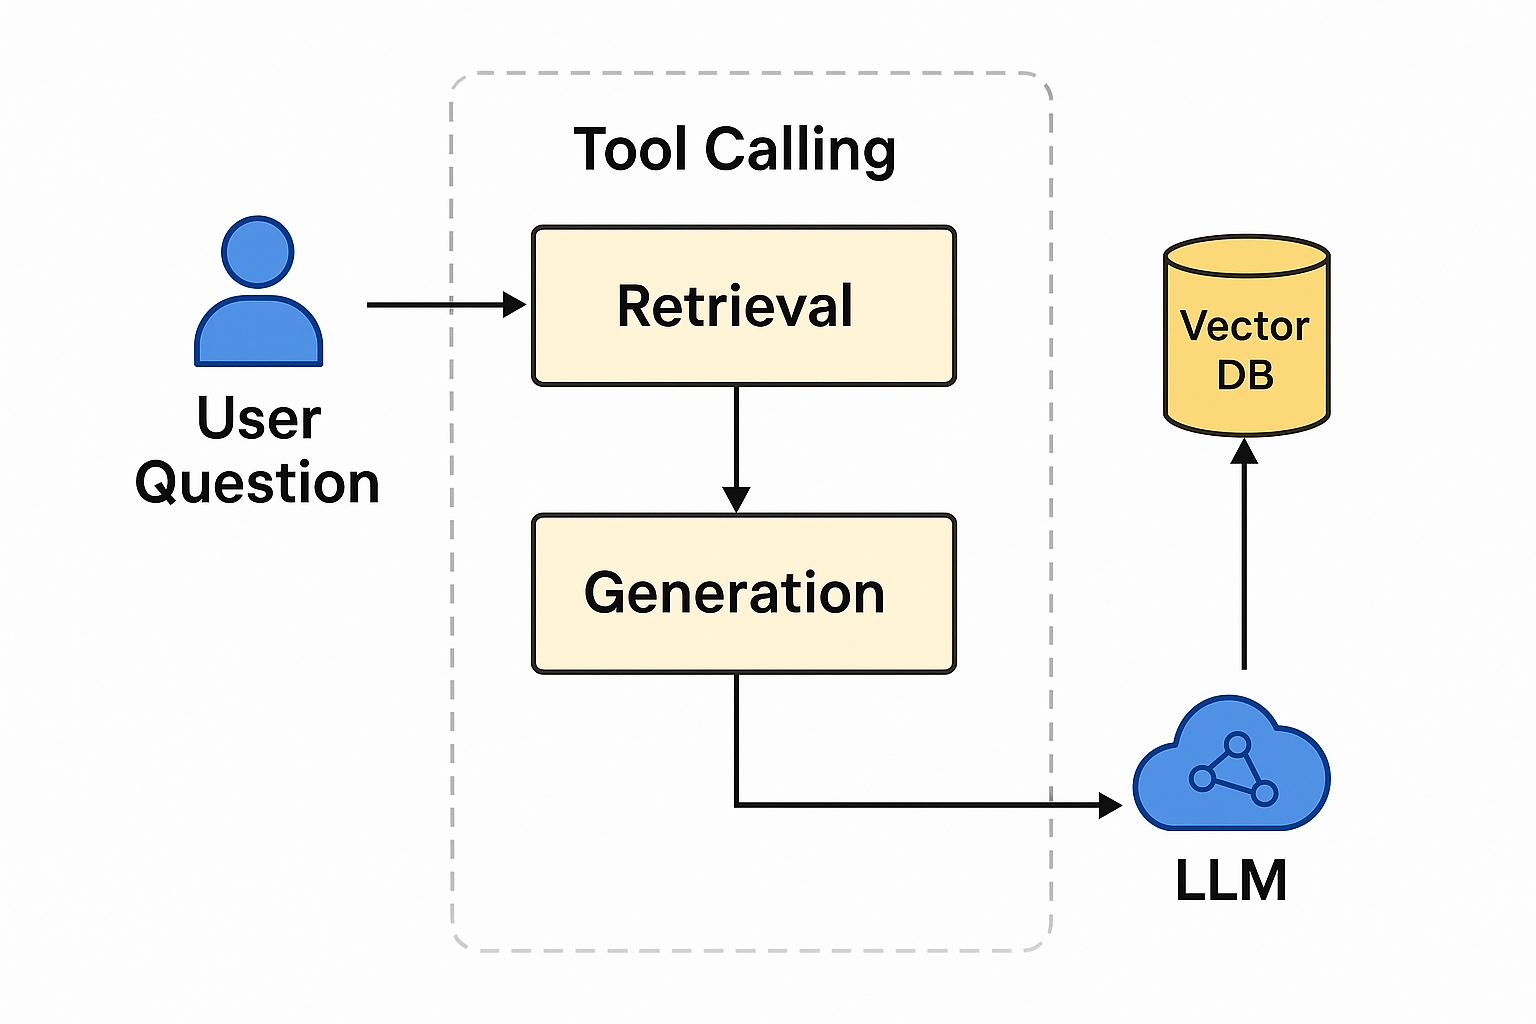
첫번째 멘토링에서는 최근 인공지능 분야에서 핵심적으로 다뤄지는 개념인 RAG(Retrieval-Augmented Generation), Tool Calling, 그리고 Vector DB(Vector Database) 에 대해 배웠다.
이 세 가지 요소는 오늘날 생성형 AI 시스템의 기본 구조를 이루는 중요한 기술로,
AI가 단순히 “대답하는 존재”를 넘어 스스로 필요한 정보를 찾고, 활용하며, 더 정확한 결과를 만들어내는 과정을 가능하게 한다.
RAG
검색 증강 생성(RAG)이란?
https://aws.amazon.com/ko/what-is/retrieval-augmented-generation/
RAG는 단순한 검색(Search) 기술이 아니라, AI가 스스로 ‘정보를 찾아 활용하는 능력’을 부여하는 구조이다. 일반적인 생성형 AI 모델은 학습 시점 이후의 데이터에 접근할 수 없기 때문에, 새로운 정보나 기업 내부 문서를 다루는 데 한계가 있다.
하지만 RAG는 질문을 받아 의미적으로 관련된 문서를 Vector DB에서 검색한 후,
그 결과를 LLM에게 전달해 답변을 생성함으로써 이 문제를 해결한다.
즉, 모델이 “모르는 것을 아는 척하지 않고”, 실제 근거가 있는 정보를 바탕으로 대답할 수 있게 만드는 것이다.
Tool Calling
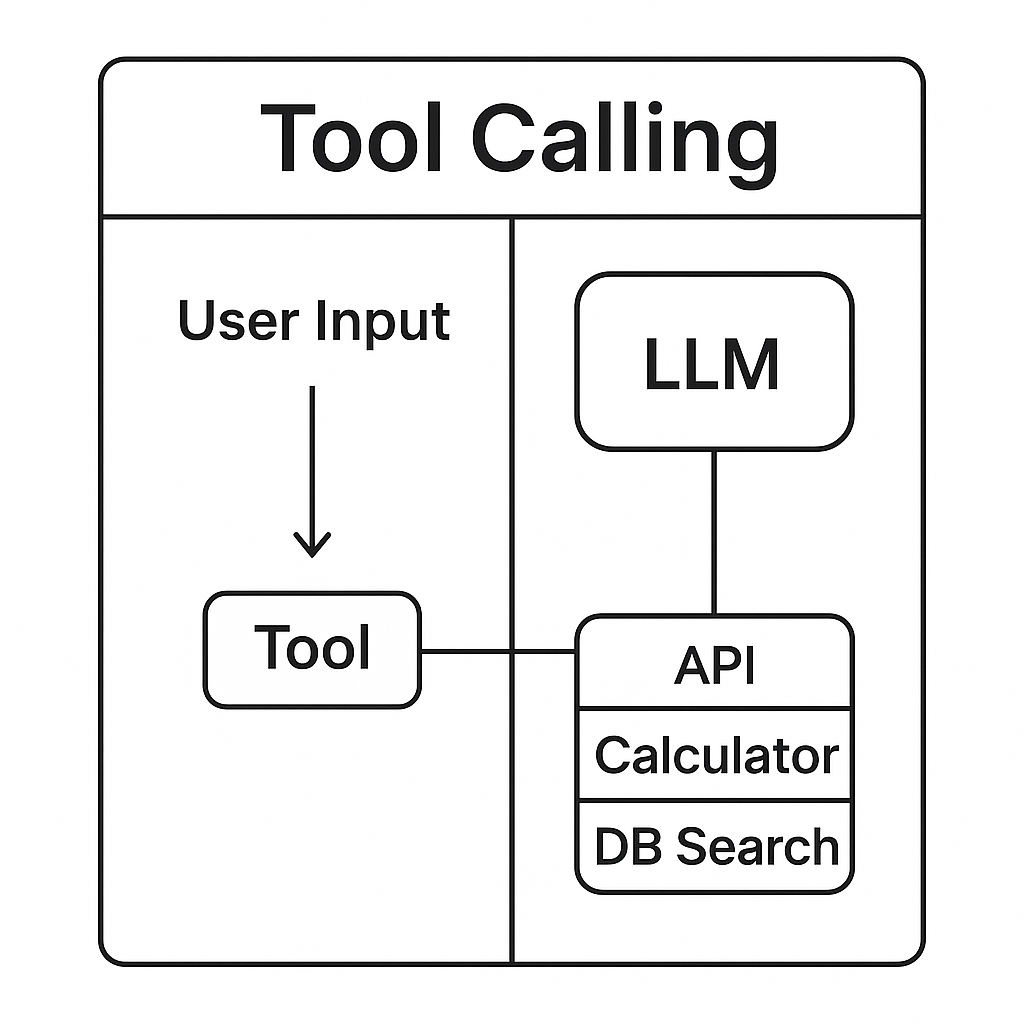
Tool Calling은 AI가 스스로 “검색이 필요하다”라고 판단하면
자동으로 RAG 시스템이나 외부 API를 호출해 결과를 받아오는 기능이다.
VECTOR DB
vector DB 예시
{
  "id": "chunk_0001",
  "document_id": "doc_123",
  "text": "RAG는 외부 지식을 검색해 LLM의 답변 정확도를 높이는 아키텍처이다.",
  "embedding": [
    0.0321, -0.1147, 0.2890, 0.0573, -0.0418, 0.1025, -0.2206, 0.0159
  ],
  "dimension": 8,
  "metadata": {
    "source": "notion",
    "title": "RAG 개요",
    "language": "ko",
    "tags": ["RAG", "VectorDB", "LLM"],
    "created_at": "2025-11-11T09:20:00+09:00",
    "uri": "https://example.org/rag-overview"
  }
}
1️⃣ id 와 document_id
• id: 벡터 데이터베이스 내에서 이 조각(chunk)을 구분하는 고유 식별자입니다.
→ 하나의 문서를 여러 조각으로 나눠 저장하기 때문에, 각 조각마다 고유한 ID가 필요합니다.
• document_id: 이 벡터가 속한 원본 문서의 ID입니다.
→ 예를 들어, 한 문서를 10개 조각으로 나눴다면 document_id는 같고 id는 각각 다릅니다.
2️⃣ text
• 실제 원문 텍스트입니다.
• 이 내용이 벡터로 변환(embedding) 되어, 의미 기반 검색을 가능하게 합니다.
3️⃣ embedding
• embedding 은 문장을 수학적으로 표현한 숫자 벡터입니다.
• 실제로는 보통 384, 768, 1536차원 등 훨씬 길어요.
• 각 숫자는 문장의 의미적 특징을 압축 표현한 값이에요.
• dimension 은 벡터의 차원 수를 명시합니다.
➡️ 예를 들어,
“RAG는 AI 검색 구조다” 와 “LLM이 정보를 검색한다”
이 두 문장은 의미가 비슷하므로, embedding 공간에서 서로 가까운 위치에 저장됩니다.
4️⃣ metadata
• metadata 는 검색된 결과를 더 풍부하게 활용하기 위한 부가 정보입니다.
• source: 데이터의 출처 (예: notion, pdf, github 등)
• title: 문서 제목
• language: 언어 코드
• tags: 주제 분류
• created_at: 데이터가 생성된 시점
• uri: 원문에 접근할 수 있는 링크
➡️ RAG 시스템은 검색된 벡터의 metadata를 이용해
“이 문장은 어디서 왔는지, 어떤 문서의 일부인지”를 함께 보여줄 수 있습니다.
BEDROCK
AWS Bedrock 서비스란?
https://docs.aws.amazon.com/ko_kr/bedrock/latest/userguide/what-is-bedrock.html
https://mozzi-devlog.tistory.com/73
아이디어 회의
- 청각장애인을 대상으로 시각 기반 영어 발음 교정 서비스
- 기존에는 입모양을 기준으로 판별 → 대충 느낌으로
- 소리를 듣지 않아도 발음의 형태, 강세 등을 이해할 수 있도록 시각적 자료(그래프) 및 피드백 제공
- 음성 분석, TTS, 발음 규칙 엔진, LLM 피드백 생성
- 생성형 AI 기술 활용해 개인화된 발음 교정 학습 지원
- 입술 모양 시각화 / blender / 모션캡쳐가 더 낫더라? / 안되면 빼버리는게 좋을듯
- IT 개발자를 위한 로드맵 생성기
- 내가 직접 만든 로드 맵
- 블로그, 깃허브 소스 크롤링
- 학습 관련데이터 시각화
- IT 트랜드 시각화
멘토님 피드백
1. 1번 아이디어(청각장애인을 위한 시각 기반 영어 발음 교정 서비스)
•	흥미롭고 사회적 가치가 높은 주제지만, 기술적 난이도가 높음
•	발음 분석 기법(음소 단위, 강세, 입모양, 리듬 등) 을 다양하게 연구해야 함
•	프로젝트 내에서 1~2명이 발음 분석 기법과 시각화 파트를 집중적으로 담당해야 효율적일 것으로 조언
•	단기간에 완성하기는 어려우므로 PoC(Proof of Concept, 개념 검증) 단계로 범위를 축소해 진행하는 것이 현실적
•	Blender나 모션캡처 등 입술 모양 시각화 기술은 선택적 요소로, 기술 구현이 어렵다면 과감히 제외해도 무방

2.	IT 개발자를 위한 로드맵 생성기
•	이미 비슷한 서비스들이 존재하지만, 기존 서비스의 단점을 보완하거나 시각화를 다양한 방면으로 발전시키는 방향으로 개선할 수 있음.
•	단순히 로드맵을 자동 생성하는 것보다는 다른 방향을 제시해보는 것이 좋을 것 같다.
•	예를 들어, GitHub와 블로그 데이터를 분석해 실제 개발자의 학습 경로를 반영하거나, 최신 기술 스택의 트렌드 시각화 대시보드를 제공하는 방향이 유용할 것이라고 조언하심.