[논문번역] Rich feature hierarchies for accurate object detection and semantic segmentation(2013)
어려운 내용 및 용어 정리
1. mAP (Mean Average Precision)
- 정의: 객체 탐지 알고리즘의 성능을 평가하는 주요 지표로, 평균 정밀도를 의미
- 정밀도(Precision): 탐지한 객체 중 실제로 올바르게 탐지된 객체의 비율.
- 정밀도의 평균(mean): 모든 클래스에 대해 정밀도를 계산한 후 평균을 냄.
2. R-CNN과 OverFeat의 차이
- 슬라이딩 윈도우 방식 (OverFeat):
- 이미지를 격자(grid)로 나누고, 각 창(window)을 순차적으로 검사.
- 모든 위치에서 CNN 계산을 수행하므로, 계산 비용이 큼.
- R-CNN:
- 미리 제안된 영역(region proposals)만 검사.
- 계산 효율성이 높고, 불필요한 영역 탐지를 줄임.
3. SIFT와 HOG
- SIFT (Scale-Invariant Feature Transform) [29]:
- 이미지 내 특징점을 추출하는 방법으로, 크기와 회전 변화에 불변적.
- 객체 탐지와 같은 컴퓨터 비전 작업에 사용.
- HOG (Histogram of Oriented Gradients) [7]:
- 이미지를 작은 영역으로 나누고, 각 영역에서 방향성 정보를 히스토그램으로 표현.
- 얼굴 및 사람 탐지에 자주 사용.
- 한계:
- SIFT와 HOG는 저수준 특징(low-level features)을 활용하며, CNN처럼 학습 기반의 고차원 특징을 사용하지 않아 성능 한계 존재.
4. ImageNet과 PASCAL VOC의 차이
- ImageNet:
- 이미지 분류(Image Classification)에 중점을 둔 대규모 데이터셋.
- 객체의 위치 정보(경계 상자)는 제공되지 않음.
- PASCAL VOC:
- 객체 탐지(Object Detection) 및 의미적 분할(Semantic Segmentation) 과제를 포함.
- 모든 객체의 경계 상자와 클래스 레이블이 포함된 포괄적 주석 데이터셋.
5. R-CNN의 주요 성과
- OverFeat과 비교:
- OverFeat은 슬라이딩 윈도우 방식을 사용하며, 모든 위치에서 CNN을 실행.
- R-CNN은 region proposals만 탐지하므로 더 효율적.
- 결과:
- ILSVRC 2013에서 R-CNN은 31.4% mAP를 달성하며 OverFeat의 24.3%를 크게 앞섬.
6. Bounding-Box Regression
- 정의: 객체 탐지 결과에서 경계 상자(localization)의 위치를 더욱 정확히 조정하기 위한 회귀 모델.
- R-CNN: pool5 특징을 사용하여 제안된 region의 경계 상자를 개선.
- 효과: PASCAL VOC 2012에서 mAP를 약 3~4 포인트 향상.
7. Semantic Segmentation
- 정의: 이미지 내의 각 픽셀을 특정 클래스(배경 포함)로 분류하는 작업.
- 객체 탐지보다 더 정밀한 수준에서 장면을 분석.
- R-CNN 적용:
- region proposals 기반 분류(classification)를 활용해 PASCAL VOC 분할 과제에 적용.
- CNN 특징을 활용한 세 가지 전략:
- Full: 지역의 직사각형 창 전체에서 CNN 특징 계산.
- Fg (Foreground): 전경 마스크만 사용해 특징 계산.
- Full+Fg: Full과 Fg 특징 결합.
- 결과: Full+Fg가 평균 세분화 정확도 47.9%로 가장 우수.
8. Supervised Pre-training and Fine-tuning
- 지도 학습 사전 훈련 (Supervised Pre-training):
- 데이터가 풍부한 보조 작업(예: ImageNet 분류)에서 CNN을 학습.
- 도메인 특화 미세 조정 (Domain-Specific Fine-tuning):
- 데이터가 부족한 목표 작업(예: 객체 탐지)에 네트워크를 조정.
- 효과:
- 미세 조정을 통해 PASCAL VOC 2012에서 성능이 8%p 증가 (mAP 54.2% 달성).
9. Region Proposals
- 정의: 객체 탐지에서 검사할 후보 영역을 생성하는 단계.
- Selective Search:
- 색상, 크기, 텍스처 등의 정보를 기반으로 비슷한 영역을 병합해 후보 영역 생성.
- R-CNN에서는 Selective Search를 사용해 효율적으로 제안된 영역만 CNN으로 처리.
- Selective Search:
10. Hard Negative Mining
- 정의: 탐지기가 잘못 분류한 부정적 예제(negative examples)를 반복적으로 학습해 성능을 향상시키는 방법.
- R-CNN 활용:
- val 데이터셋의 5000개 이미지에서 부정적 예제를 추출하여 SVM 훈련에 사용.
Abstract
객체 탐지(Object detection) 성능은 대표적인 PASCAL VOC 데이터셋에서 측정한 결과, 지난 몇 년간 정체 상태에 머물러 있었습니다. 현재 가장 높은 성능을 보이는 방법들은 복잡한 앙상블 시스템(ensemble systems)으로, 이들은 보통 다중 저수준 이미지 특징(low-level image features)과 고수준 문맥 정보(high-level context)를 결합하여 동작합니다. 이러한 방법은 구조가 복잡하고 구현이 어려운 한계가 있습니다.
본 논문에서는 간단하면서도 확장 가능한(scalable) 탐지 알고리즘을 제안합니다. 제안된 방법은 VOC 2012 데이터셋에서 이전 최고 성능 대비 30% 이상의 평균 정밀도(mean Average Precision, mAP) 향상을 달성하였으며, 최종적으로 53.3%의 mAP를 기록했습니다. 이는 PASCAL VOC 데이터셋에서 매우 큰 성능 향상입니다.
핵심 아이디어
우리의 접근법은 다음 두 가지 주요 통찰을 기반으로 합니다:
- 고용량 CNN(Convolutional Neural Networks)을 하향식(bottom-up) 방식으로 생성된 영역 제안(region proposals)에 적용함으로써, 객체를 로컬라이즈(localize)하고 분할(segment)할 수 있다는 점.
CNN은 이미지의 중요한 특징을 효과적으로 학습하며, 이를 영역 제안에 적용하면 정확한 객체 탐지가 가능합니다. - 레이블이 지정된 훈련 데이터(labelled training data)가 제한적인 경우, 보조 작업(auxiliary task)에 대해 지도 학습(pre-training)을 먼저 수행한 뒤, 도메인 특화 미세 조정(domain-specific fine-tuning)을 적용하면 성능을 크게 개선할 수 있다는 점.
즉, 일반적인 데이터를 이용해 모델을 먼저 훈련(pre-train)시키고, 이후 특정 데이터셋에 맞춰 미세 조정하면 데이터 부족 문제를 해결할 수 있습니다.
방법 명칭 및 성능 비교
우리는 영역 제안(region proposals)을 CNN과 결합하므로, 이 방법을 R-CNN (Regions with CNN features)이라고 명명했습니다. R-CNN은 객체 탐지의 정확도를 크게 향상시킵니다.
R-CNN은 최근 제안된 OverFeat이라는 슬라이딩 윈도우(sliding-window) 기반 탐지기와 비교되었습니다. OverFeat은 비슷한 CNN 구조를 사용하지만, R-CNN은 200개 클래스의 ILSVRC2013 탐지 데이터셋에서 OverFeat을 큰 폭으로 능가했습니다. 이는 R-CNN의 효율성과 성능을 입증하는 결과입니다.
공개 소스 코드
우리의 완전한 시스템은 재현 가능하며, 소스 코드는 Berkeley 웹사이트에서 공개되어 있습니다. 연구자와 개발자는 이를 통해 우리의 방법을 재현하거나 확장할 수 있습니다.
1. Introduction
특징(features)은 중요합니다. 지난 10년 동안 다양한 시각적 인식 과제(visual recognition tasks)에서 이루어진 진전은 주로 SIFT (Scale-Invariant Feature Transform) [29]와 HOG (Histogram of Oriented Gradients) [7] 같은 특징들을 사용하는 데 기반을 두었습니다. 하지만 대표적인 시각적 인식 과제인 PASCAL VOC 객체 탐지(PASCAL VOC object detection) [15]에서의 성능을 살펴보면, 2010년부터 2012년 사이에 발전이 매우 느렸으며, 성능 향상은 성공적인 방법의 사소한 변형(minor variants)이나 복잡한 앙상블 시스템(ensemble systems) 구축을 통해서만 이루어졌습니다.
SIFT와 HOG는 블록 단위 방향 히스토그램(blockwise orientation histograms)으로, 이는 원숭이의 시각 경로에서 첫 번째 피질 영역인 V1의 복합 세포(complex cells)와 대략적으로 연관 지을 수 있습니다. 그러나 우리는 인식(recognition)이 시각 경로의 여러 단계를 거쳐 이루어진다는 것을 알고 있으며, 이는 계층적(hierarchical) 구조가 필요할 가능성을 시사합니다. Fukushima의 "Neocognitron" [19]은 생물학적으로 영감을 받은 계층적이고 이동 불변적인(shift-invariant) 패턴 인식 모델로, 이러한 과정에 대한 초기 시도였습니다. 그러나 Neocognitron은 지도 학습(supervised training) 알고리즘이 없다는 한계가 있었습니다.
이 문제를 해결하기 위해, Rumelhart et al. [33]은 역전파(backpropagation)를 통한 확률적 경사 하강법(stochastic gradient descent)이 합성곱 신경망(CNNs, Convolutional Neural Networks)을 훈련시키는 데 효과적임을 보여주었으며, LeCun et al. [26]은 Neocognitron을 확장한 CNN을 성공적으로 훈련했습니다.
CNN은 1990년대에 널리 사용되었으나(e.g., [27]), 이후 서포트 벡터 머신(SVM)이 인기를 얻으면서 주목받지 못했습니다. 그러나 2012년, Krizhevsky et al. [25]은 ImageNet 대규모 시각적 인식 챌린지(ILSVRC, ImageNet Large Scale Visual Recognition Challenge) [9, 10]에서 상당히 높은 이미지 분류 정확도를 보여주며 CNN에 대한 관심을 되살렸습니다. 이들의 성공은 1.2백만 개의 레이블이 지정된 이미지로 큰 CNN을 훈련시키고, LeCun의 CNN에 몇 가지 기법을 추가(Max(x, 0)으로 구성된 비선형 활성화 함수와 드롭아웃(dropout) 정규화를 도입)한 결과였습니다.

Figure1 . R-CNN: CNN 특징을 활용한 영역 기반 탐지
본 시스템은 (1) 입력 이미지를 받아, (2) 약 2000개의 하향식 region proposals(후보 영역)를 추출하고, (3) 대규모 합성곱 신경망(CNN)을 사용해 각 proposal의 특징을 계산한 다음, (4) 클래스별 선형 SVM으로 각 영역을 분류합니다. R-CNN은 PASCAL VOC 2010에서 평균 정밀도(mAP) 53.7%를 달성했습니다.
CNN 성능 일반화에 대한 논의
ImageNet 성과의 중요성은 ILSVRC 2012 워크숍에서 활발히 논의되었습니다. 논의의 핵심은 다음으로 요약됩니다: ImageNet에서의 CNN 분류 성능이 PASCAL VOC Challenge에서의 객체 탐지 성능으로 일반화될 수 있는가?
이 질문에 답하기 위해, 우리는 이미지 분류(image classification)와 객체 탐지(object detection) 간의 격차를 메우는 연구를 진행했습니다. 본 논문은 CNN이 단순한 HOG 기반 특징으로 구축된 시스템과 비교했을 때, PASCAL VOC에서 획기적으로 높은 객체 탐지 성능을 보여줄 수 있음을 처음으로 증명합니다.
이 결과를 얻기 위해, 우리는 다음 두 가지 문제에 집중했습니다:
1. 깊은 신경망(deep network)을 사용하여 객체를 정확히 로컬라이즈(localize)하는 문제.
2. 주석이 달린 데이터(annotated data)가 적은 상황에서, 고용량 모델(high-capacity model)을 훈련시키는 문제.
Region Proposals과 CNN의 결합
기존 탐지 방법과 달리, 탐지는 이미지 내의 객체를 로컬라이즈하는 것을 요구합니다. 한 가지 접근법은 이 문제를 회귀 문제(regression problem)로 정의하는 것입니다. 하지만, Szegedy et al. [38]의 연구(우리의 연구와 동시에 진행됨)에 따르면, 이 전략은 실제로 효과적이지 않을 수 있습니다. 그들은 VOC 2007에서 30.5%의 mAP를 기록한 반면, 우리의 방법은 58.5%의 mAP를 달성했습니다. 또 다른 접근법은 슬라이딩 윈도우(sliding-window) 탐지기를 구축하는 것입니다. CNN은 최소 20년 동안 얼굴(face) [32, 40]이나 보행자(pedestrian) [35]와 같은 제한된 객체 범주에서 슬라이딩 윈도우 방식으로 사용되었습니다. 하지만, 이러한 CNN은 높은 공간 해상도(spatial resolution)를 유지하기 위해 보통 두 개의 합성곱(convolutional) 및 풀링(pooling) 계층만 사용합니다.
우리는 슬라이딩 윈도우 접근법을 고려했지만, 우리 네트워크의 높은 계층 유닛은 매우 큰 수용 영역(receptive field, 195×195 픽셀)과 보폭(stride, 32×32 픽셀)을 가지므로, 슬라이딩 윈도우 접근법에서 정확한 로컬라이제이션(localization)은 기술적 과제로 남습니다. 대신, 우리는 "영역을 사용한 인식(recognition using regions)" 패러다임 [21]을 채택했습니다. 이는 객체 탐지 [39]와 의미적 분할(semantic segmentation) [5]에서 성공적인 것으로 입증된 접근법입니다.
R-CNN의 구성
테스트 단계에서, 우리의 방법은 입력 이미지에 대해 약 2000개의 범주 독립적인(region category-independent) 지역 제안(region proposals)을 생성합니다. 그런 다음, 각 지역에서 고정 길이의 특징 벡터(fixed-length feature vector)를 CNN을 사용해 추출하고, 이를 범주별 선형 SVM(linear SVMs)으로 분류합니다. 우리는 단순한 기법인 어파인 이미지 왜곡(affine image warping)을 사용해, 각 지역 제안의 모양과 관계없이 고정 크기의 CNN 입력을 계산합니다. 그림 1은 우리의 방법 개요와 일부 결과를 강조합니다. 우리의 시스템은 지역 제안(region proposals)과 CNN을 결합하므로, 이 방법을 R-CNN (Regions with CNN features)이라고 명명했습니다.
2. Object Detection with R-CNN
우리의 객체 탐지 시스템은 세 가지 모듈로 구성됩니다.
첫 번째 모듈은 범주 독립적인(category-independent) region proposals를 생성합니다. 이 proposal들은 탐지기(detector)가 사용할 수 있는 후보 탐지 집합을 정의합니다.
두 번째 모듈은 대규모 합성곱 신경망(CNN)으로, 각 region proposal에서 고정 길이의 특징 벡터(feature vector)를 추출합니다.
세 번째 모듈은 클래스별 선형 SVM(linear SVMs) 집합입니다.
이 섹션에서는 각 모듈에 대한 설계 결정을 설명하고, 테스트 단계의 사용 방법을 기술하며, 파라미터 학습 방법과 PASCAL VOC 2010-12 및 ILSVRC2013에서의 탐지 결과를 보여줍니다.
2.1. 모듈 설계
Region Proposals
최근 연구들은 범주 독립적인 region proposals를 생성하는 다양한 방법들을 제안하고 있습니다. 예로는 다음과 같은 방법이 있습니다:
- Objectness [1]
- Selective Search [39]
- Category-independent object proposals [14]
- Constrained Parametric Min-Cuts (CPMC) [5]
- Multi-scale Combinatorial Grouping [3]
- Ciresan et al. [6]: 이들은 region proposals의 특수 사례인 정규 간격 사각형 영역에 CNN을 적용하여 유사 분열 세포(mitotic cells)를 탐지합니다.
R-CNN은 특정 region proposal 방법에 종속적이지 않지만, 기존 탐지 연구와의 통제된 비교를 위해 Selective Search를 사용합니다 (예: [39, 41]).
Figure2 VOC 2007 train 데이터에서 변형된(warped) 훈련 샘플
이 예시에는 다양한 Region Proposal 생성 방법이 포함됩니다. 예를 들어, objectness [1], selective search [39], 카테고리와 상관없이 객체를 제안하는 방법 [14], CPMC(제약된 매개변수 최소 절단) [5], 다중 스케일 조합 그룹화 [3], 그리고 Cireşan 등 [6]이 사용한 방법이 있습니다. Cireşan 등은 CNN을 이용해 일정 간격으로 나뉜 사각형 영역에서 분열 세포를 탐지했는데, 이는 Region Proposal의 특별한 사례입니다.
R-CNN은 특정 Region Proposal 방법에 얽매이지 않지만, 이전 탐지 연구(예: [39, 41])와 공정하게 비교하기 위해 selective search를 사용했습니다.
warped는 Region Proposal을 CNN에 입력하기 위해 고정 크기(227×227)로 변형한 결과를 의미. CNN은 고정된 크기의 입력을 요구하므로, 각 Region Proposal을 동일한 크기로 변환해야 함.
이 과정에서 Affine Transformation(선형 변환)이나 Interpolation 기법을 사용해 Region Proposal의 크기를 고정 크기로 변형.
Feature Extraction
우리는 Caffe [24] 구현을 사용하여, Krizhevsky et al. [25]이 제안한 CNN에서 각 region proposal로부터 4096차원의 특징 벡터(feature vector)를 추출합니다. 특징은 평균값이 제거된 227×227 RGB 이미지를 CNN에 입력하고 5개의 합성곱 계층(convolutional layers)과 2개의 완전 연결 계층(fully connected layers)을 거쳐 전방 전파(forward propagation)함으로써 계산됩니다. 네트워크 아키텍처에 대한 자세한 내용은 [24, 25]를 참고하십시오.
CNN 아키텍처는 고정된 227×227 픽셀 크기의 입력을 필요로 하므로, region proposal 데이터를 변환해야 합니다. 임의 모양의 region proposal을 변환하는 다양한 방법 중, 우리는 가장 단순한 방법을 채택했습니다.
후보 영역의 크기나 종횡비와 관계없이, tight bounding box(최소한의 경계 상자)에 있는 모든 픽셀을 필요한 크기로 왜곡(warping)합니다. 왜곡 전에, 경계 상자를 팽창(dilate)하여 왜곡된 이미지 크기에서 원래 상자 주위에 정확히 16픽셀(p=16)의 컨텍스트가 포함되도록 설정합니다.
Figure 2는 왜곡된 학습 영역 샘플을 보여줍니다. 왜곡 방법의 대안은 Appendix A에 설명되어 있습니다.
2.2. Test-time Detection
테스트 단계
테스트 단계에서 우리는 테스트 이미지에서 Selective Search를 실행하여 약 2000개의 region proposals를 추출합니다.
각 proposal은 왜곡(warp)되고 CNN에 전방 전파되어 특징(feature)을 계산합니다.
그런 다음, 각 클래스에 대해, 추출된 각 특징 벡터를 해당 클래스에 대해 학습된 SVM으로 점수화합니다.
이미지에서 점수가 매겨진 모든 region에 대해, 우리는 Intersection-over-Union (IoU)이 학습된 임계값보다 큰 상위 점수 region과 겹치는 region을 거부하는 탐욕적 비최대 억제(greedy non-maximum suppression)를 적용합니다.
실행 시간 분석
R-CNN의 효율성은 다음 두 가지 속성에서 비롯됩니다:
1. 모든 CNN 파라미터는 모든 범주에 걸쳐 공유됩니다.
2. CNN이 계산한 특징 벡터는 공간 피라미드(spatial pyramids)와 같은 기존 방법에 비해 저차원(low-dimensional)입니다.
예를 들어, UVA 탐지 시스템 [39]에서 사용된 특징은 360,000차원이지만, 우리의 특징은 4096차원으로, 두 자릿수 차이의 감소를 보입니다.
이러한 공유로 인해 region proposals 및 특징 계산에 소요되는 시간은 모든 클래스에 대해 공통적으로 사용되므로 효율성이 증가합니다:
- GPU에서 1장의 이미지당 13초.
- CPU에서 1장의 이미지당 53초.
클래스별 계산은 특징과 SVM 가중치 간의 내적(dot product) 및 비최대 억제뿐입니다.
실제로, 모든 내적은 행렬-행렬 곱셈(matrix-matrix product)으로 처리됩니다.
특징 행렬은 보통 2000×4096 크기이며, SVM 가중치 행렬은 4096×N 크기입니다 (N은 클래스의 수).
이 분석은 R-CNN이 해싱(hashing) 같은 근사 기법 없이 수천 개의 객체 클래스로 확장될 수 있음을 보여줍니다.
예를 들어, 10만 개의 클래스가 있다고 해도, 결과 행렬 곱셈은 최신 멀티코어 CPU에서 10초밖에 걸리지 않습니다.
반면, UVA 시스템은 고차원 특징 때문에 134GB 메모리가 필요하며, 같은 작업에서 두 자릿수 느립니다.
R-CNN과 기존 방법 비교
- Dean et al. [8]의 연구에서는 DPM(deformable part models)과 해싱을 사용해 확장 가능한 탐지를 구현했습니다.
하지만 이들은 VOC 2007에서 mAP 16%, 이미지당 5분의 실행 시간을 보고했습니다. - 우리의 방법은 동일한 10,000개의 탐지기를 CPU에서 1분 안에 실행할 수 있으며, 근사 기법을 사용하지 않으므로 mAP 59%를 유지합니다.
2.3. Training
Supervised Pre-training
우리는 CNN을 대규모 보조 데이터셋(auxiliary dataset)인 ILSVRC2012 분류 데이터셋(classification dataset)에서 지도 학습(pre-training) 방식으로 사전 훈련했습니다. 이 데이터셋에는 이미지 레벨 주석(image-level annotations)만 있으며, 경계 상자(bounding box) 레이블은 포함되어 있지 않습니다.
사전 훈련은 오픈 소스 Caffe CNN 라이브러리 [24]를 사용하여 수행되었습니다. 간단히 요약하자면, 우리의 CNN은 Krizhevsky et al. [25]의 성능과 거의 동일한 수준을 달성했으며, ILSVRC2012 분류 검증(validation) 세트에서 top-1 오차율이 2.2% 더 높게 나타났습니다.
이 차이는 훈련 과정의 단순화 때문입니다.
Domain-specific Fine-tuning
CNN을 새로운 과제(탐지)와 새로운 도메인(왜곡된 proposal 창)에 적응시키기 위해, 우리는 CNN의 파라미터를 왜곡된 region proposals만 사용하여 확률적 경사 하강법(SGD)으로 추가 훈련을 진행했습니다.
ImageNet에 특화된 1000-way 분류 계층을 무작위 초기화된 (N+1)-way 분류 계층으로 대체한 것을 제외하고는 CNN 아키텍처를 변경하지 않았습니다.
여기서 N은 객체 클래스의 수이며, 1은 배경 클래스(background)를 위한 것입니다.
- VOC에서는 N = 20
- ILSVRC2013에서는 N = 200
Positive와 Negative 예제 정의
- Positive 예제: ground-truth 박스와 IoU >= 0.5를 갖는 region proposal.
- Negative 예제: 나머지 region proposals.
SGD 훈련은 0.001의 학습률(사전 훈련 학습률의 1/10)로 시작하여, 초기화 값을 손상시키지 않으면서도 미세 조정(fine-tuning)이 진행되도록 설정했습니다.
각 SGD 반복(iteration)에서, 모든 클래스에 대해 32개의 positive 윈도우와 96개의 배경 윈도우를 균일하게 샘플링하여 크기 128의 미니 배치(mini-batch)를 구성합니다.
Positive 윈도우는 배경 윈도우에 비해 극히 드물기 때문에, 샘플링이 positive 윈도우에 편향되도록 설정했습니다.
Object Category Classifiers
예를 들어, 자동차를 탐지하는 이진 분류기를 학습한다고 가정합니다:
- Positive 예제: 자동차를 완전히 포함하는 영역.
- Negative 예제: 자동차와 관련 없는 배경 영역.
그러나 자동차와 부분적으로만 겹치는 영역은 어떻게 레이블링할까요?
이를 해결하기 위해, 우리는 IoU 겹침에 대한 임계값을 설정했습니다.
- IoU가 임계값보다 낮으면 Negative 예제로 정의.
- 이 임계값(0.3)은 검증 세트를 사용한 그리드 탐색(grid search)을 통해 선택되었습니다.
- 임계값을 0.5로 설정하면 mAP가 5포인트 감소.
- 임계값을 0으로 설정하면 mAP가 4포인트 감소.
Positive 예제는 각 클래스에 대해 ground-truth bounding box로 정의됩니다.
SVM 학습
모든 특징이 추출되고 학습 레이블이 적용되면, 각 클래스에 대해 하나의 선형 SVM(linear SVM)을 최적화합니다.
훈련 데이터가 메모리에 전부 적재될 수 없기 때문에, 우리는 hard negative mining [17, 37] 방법을 채택했습니다.
이 방법은 빠르게 수렴하며, 실제로 모든 이미지를 한 번만 통과해도 mAP가 증가하지 않는 것을 확인했습니다.
Appendix B 관련 논의
- 미세 조정(fine-tuning)과 SVM 학습에서 Positive와 Negative 예제를 정의하는 방식의 차이를 논의합니다.
- 최종 softmax 계층의 출력을 사용하는 대신 SVM을 학습하는 데 따르는 장단점(trade-offs)도 검토합니다.
2.4. Results on PASCAL VOC 2010-12
PASCAL VOC의 최적 관행(best practices) [15]을 따라, 우리는 VOC 2007 데이터셋(섹션 3.2)에서 모든 설계 결정과 하이퍼파라미터를 검증했습니다.
VOC 2010-12 데이터셋에서 최종 결과를 얻기 위해, 우리는 CNN을 VOC 2012 train 데이터에서 미세 조정(fine-tuning)하고, VOC 2012 trainval 데이터에서 탐지 SVM을 최적화했습니다.
각 주요 알고리즘 변형(경계 상자 회귀 적용 여부)에 대해 테스트 결과를 평가 서버(evaluation server)에 한 번씩만 제출했습니다.
PASCAL VOC 2010 결과
Table 1은 VOC 2010 데이터셋에 대한 전체 결과를 보여줍니다.
우리는 SegDPM [18]을 포함한 네 가지 강력한 기준선(baseline) 방법과 비교했으며, SegDPM은 DPM 탐지기와 의미적 분할 시스템의 출력 [4]을 결합하고, 추가적인 탐지기 간 문맥(inter-detector context) 및 이미지 분류기 재점수화를(rescoring) 사용합니다.
우리 방법과 가장 관련성이 높은 비교는 Uijlings et al. [39]의 UVA 시스템입니다.
두 시스템 모두 동일한 region proposal 알고리즘을 사용합니다.
UVA 시스템은 지역을 분류하기 위해 다음을 수행합니다:
1. 4-레벨 공간 피라미드(spatial pyramid)를 구축.
2. 촘촘히 샘플링된 SIFT, Extended Opponent SIFT, RGB SIFT 기술자를 4000개 단어로 구성된 코드북(codebook)으로 벡터 양자화(vector quantization).
3. 히스토그램 교차 커널 SVM(histogram intersection kernel SVM)으로 분류 수행.
이들의 다중 특징 및 비선형 커널 SVM 접근법과 비교했을 때, 우리는 mAP 35.1%에서 53.7%로 큰 성능 향상을 달성했으며, 또한 훨씬 더 빠른 속도(섹션 2.2)로 동작합니다.
우리 방법은 VOC 2011/12 테스트 세트에서도 53.3% mAP로 유사한 성능을 보여주었습니다.
2.5. Results on ILSVRC2013 Detection
우리는 200개 클래스의 ILSVRC2013 탐지 데이터셋에서 R-CNN을 실행했습니다.
PASCAL VOC에서 사용한 것과 동일한 시스템 하이퍼파라미터를 사용했습니다.
테스트 결과는 경계 상자 회귀 여부에 따라 두 번만 평가 서버에 제출했습니다.
ILSVRC2013 결과
Figure 3은 R-CNN을 ILSVRC 2013 경쟁 결과 및 대회 이후의 OverFeat 결과 [34]와 비교합니다.
- R-CNN은 31.4% mAP를 달성하여 OverFeat의 24.3%를 큰 폭으로 앞질렀습니다.
- 클래스별 AP 분포에 대한 이해를 돕기 위해, 박스 플롯(box plots)도 제시되었으며, 논문의 마지막 Table 8에 클래스별 AP 결과가 제공됩니다.
대부분의 경쟁 제출(OverFeat, NEC-MU, UvA Euvision, Toronto A, UIUC-IFP)은 CNN을 사용했으며, 이는 객체 탐지에서 CNN을 적용하는 방식에 상당한 미묘한 차이가 있음을 나타냅니다.
이러한 차이는 결과에 크게 영향을 미쳤습니다.
섹션 4에서는 ILSVRC2013 탐지 데이터셋에 대한 개요를 제공하고, R-CNN을 실행할 때의 선택 사항에 대해 자세히 설명합니다.
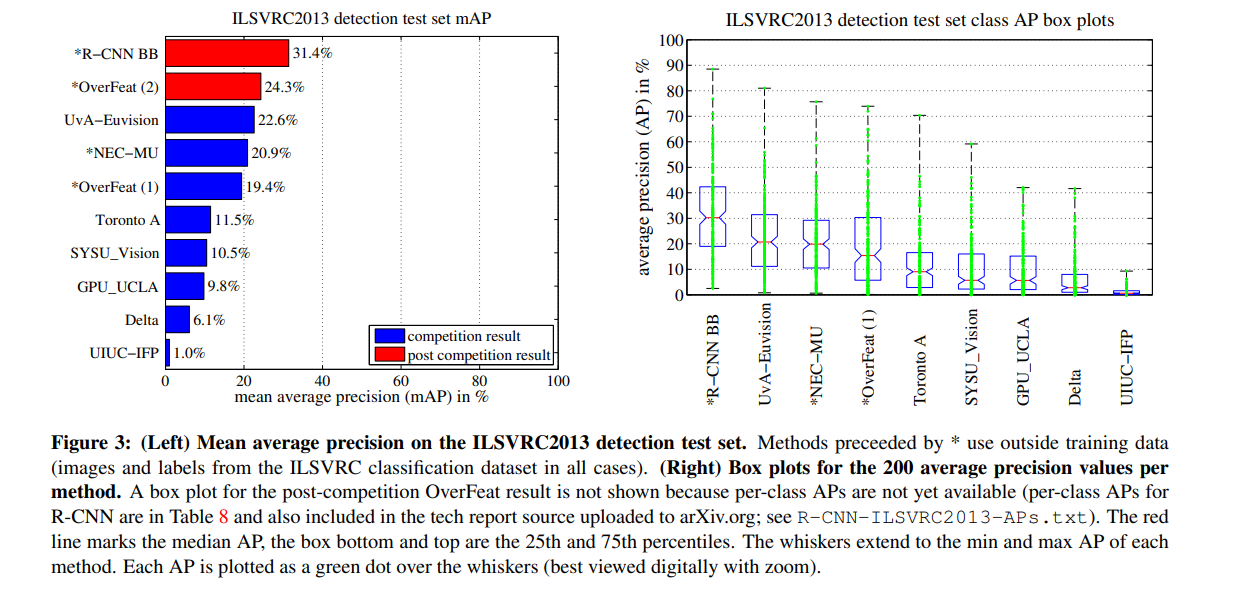
Figure3 왼쪽은 ILSVRC2013 탐지 테스트 세트에서의 평균 정밀도(mean average precision, mAP)를 보여준다. '*' 표시가 붙은 방법은 ILSVRC 분류 데이터셋의 이미지와 라벨과 같은 외부 훈련 데이터를 사용했다.
오른쪽은 각 방법에 대해 200개 클래스의 평균 정밀도(AP) 값에 대한 박스 플롯을 나타낸다. 경쟁 이후의 OverFeat 결과는 클래스별 AP 값이 아직 제공되지 않아 표시되지 않았다. R-CNN의 클래스별 AP는 Table 8에 있으며, 기술 보고서 소스는 arXiv.org에 업로드되었다. 자세한 내용은 R-CNN-ILSVRC2013-APs.txt를 참조할 수 있다.
빨간 선은 중앙값(median AP)을 나타내며, 박스의 아래와 위는 각각 25번째와 75번째 백분위수를 의미한다. Whiskers는 각 방법의 최소 및 최대 AP를 나타내며, 녹색 점은 Whiskers 위에 표시된 각 AP 값이다. 이 박스 플롯은 디지털 확대를 통해 보는 것이 가장 효과적이다.
이 그림은 ILSVRC2013 탐지 데이터셋에서 다양한 방법(R-CNN, OverFeat 등)의 성능을 비교하며, 왼쪽 그래프는 mAP 값을 정리하여 비교하고, 오른쪽 박스 플롯은 200개 클래스의 AP 분포와 성능 변동성을 시각적으로 보여준다.
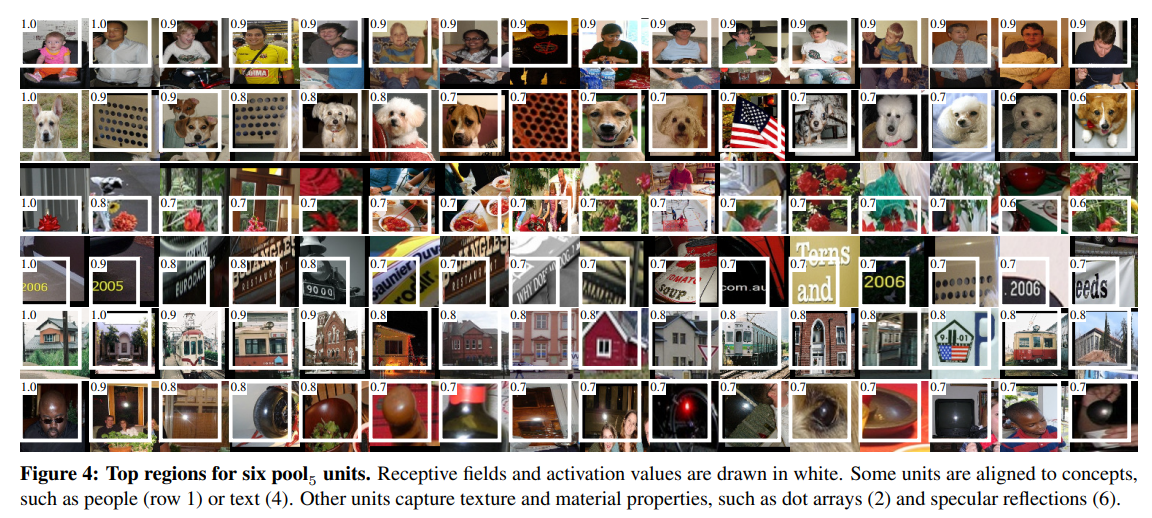
Figure4 여섯 개의 pool₅ 유닛에서 활성화된 주요 영역
흰색으로 표시된 부분은 각 유닛이 반응한 영역(수용 영역)과 활성화 값(얼마나 강하게 반응했는지)을 보여줍니다.
일부 유닛은 사람 얼굴(1행)이나 텍스트(4행) 같은 특정 개념에 반응하며, 다른 유닛은 점 배열(2행)이나 빛의 반사(6행)처럼 질감이나 물질의 특성을 감지합니다.
이 그림은 CNN이 입력 이미지를 분석할 때, 특정 유닛이 어떤 특징에 주로 반응하는지 쉽게 이해할 수 있도록 만들어졌습니다.
3. Visualization, Ablation, and Modes of Error
3.1. Visualizing Learned Features
첫 번째 계층 필터(first-layer filters)는 직접 시각화할 수 있으며 이해하기 쉽습니다 [25].
이 필터는 방향성 있는 경계선과 반대 색(opponent colors)을 포착합니다. 하지만, 이후 계층(layer)을 이해하는 것은 더 어렵습니다.
Zeiler와 Fergus는 [42]에서 디컨볼루션(deconvolutional) 접근법을 통해 시각적으로 매력적인 방법을 제안했습니다.
우리는 네트워크가 학습한 내용을 직접적으로 보여주는 비매개(non-parametric) 방법을 제안합니다. 이는 단순하면서도 보완적인 접근법입니다.
주요 아이디어
특정 유닛(feature)을 선택해, 이를 마치 독립적인 객체 탐지기처럼 사용하는 것입니다.
- 활성화(activation)를 대규모 held-out region proposals(약 1000만 개)에 대해 계산합니다.
- 가장 높은 활성화에서 가장 낮은 활성화 순으로 proposals를 정렬합니다.
- 비최대 억제(non-maximum suppression)를 수행한 뒤, 최고 점수 영역(top-scoring regions)을 시각화합니다.
이 방법은 선택된 유닛이 어떤 입력에 대해 반응하는지를 명확히 보여줍니다.
평균값을 사용하지 않음으로써 다양한 시각적 패턴(visual modes)과 해당 유닛이 계산한 불변성(invariances)을 파악할 수 있습니다.
Pool5 계층 유닛 시각화
우리는 네트워크의 다섯 번째이자 마지막 합성곱 계층의 맥스 풀링(max pooling) 출력인 pool5 계층에서 유닛을 시각화합니다.
- Pool5 특징 맵의 크기: 6 × 6 × 256 = 9216 차원.
- 각 pool5 유닛의 수용 영역(receptive field): 입력 이미지(227 × 227 픽셀)에서 195 × 195 픽셀.
중앙의 pool5 유닛은 거의 전역적(global)인 시야를 가지지만, 가장자리에 있는 유닛은 더 작은 지원 영역(clipped support)을 가집니다.
Figure 4의 각 행은 VOC 2007 trainval에서 미세 조정된 CNN의 pool5 유닛 중 하나에 대한 상위 16개의 활성화를 보여줍니다.
- 256개의 기능적으로 고유한 유닛 중 6개를 시각화했으며(Appendix D에 추가 시각화 포함), 네트워크가 학습한 대표적인 샘플을 보여줍니다.
- 예:
- 두 번째 행: 개의 얼굴과 점 배열에 반응.
- 세 번째 행: 빨간색 덩어리를 탐지.
- 다른 유닛은 인간의 얼굴, 텍스트, 창이 있는 삼각형 구조 등의 추상적 패턴을 탐지.
네트워크는 소수의 클래스 맞춤형 특징(class-tuned features)과 함께 형태, 텍스처, 색상, 재질 속성에 대한 분산 표현(distributed representation)을 결합하는 표현을 학습하는 것으로 보입니다.
이후 계층인 fc6는 이러한 풍부한 특징의 다양한 조합을 모델링할 수 있는 능력을 가집니다.
3.2. Ablation Studies
계층별 성능 분석(미세 조정 없이)
탐지 성능에 중요한 계층을 이해하기 위해, 우리는 VOC 2007 데이터셋에서 CNN의 마지막 세 계층에 대한 성능을 분석했습니다.
- pool5: 섹션 3.1에서 간단히 설명.
- fc6: Pool5와 완전 연결되며, 4096 × 9216 가중치 행렬로 특징을 계산.
- fc7: fc6의 출력에 대해 4096 × 4096 가중치 행렬을 곱한 최종 계층.
결과 분석
- Table 2 (Rows 1-3): 미세 조정 없이 ImageNet 사전 훈련만 수행한 CNN.
- fc7 특징은 fc6 특징보다 일반화 성능이 떨어짐.
- fc7와 fc6 모두 제거해도 pool5 특징만으로도 높은 성능 유지.
- CNN의 대부분의 표현 능력은 합성곱 계층에서 기인하며, 밀집 연결 계층은 상대적으로 덜 중요한 것으로 나타남.
- pool5만 사용하면, HOG와 유사하게 임의 크기의 이미지에 대한 밀집 특징 맵(dense feature map)을 생성하는 가능성을 열어줌.
계층별 성능 분석(미세 조정 적용)
- Table 2 (Rows 4-6): VOC 2007 trainval에서 미세 조정한 결과.
- mAP가 8.0%p 증가하여 54.2% mAP 달성.
- fc6와 fc7에서의 성능 향상이 pool5보다 더 큼.
- pool5 특징은 ImageNet에서 학습된 일반화된 특징을 나타내며, 대부분의 성능 향상은 해당 특징 위에서 학습된 도메인 특화 비선형 분류기에서 기인.
최근 특징 학습 방법과의 비교
PASCAL VOC 탐지에서는 상대적으로 적은 특징 학습 방법이 시도되었습니다.
우리는 변형 가능한 부분 모델(DPM)을 기반으로 한 두 가지 최근 접근법을 비교 대상으로 포함합니다:
1. DPM ST [28]: HOG 특징에 "스케치 토큰(sketch token)" 확률 히스토그램 추가.
- 스케치 토큰: 이미지 패치 중심을 통과하는 윤곽선의 확률 분포.
- DPM HSC [31]: HOG를 희소 코딩 히스토그램(HSC)으로 대체.
- 희소 코드: 학습된 7 × 7 픽셀 원자(dictionary)를 사용하여 각 픽셀에서 계산.
R-CNN과 DPM 비교
- Table 2 (Rows 8-10): 모든 R-CNN 변형이 세 가지 DPM 기준선을 압도적으로 능가.
- 최신 DPM(HOG 기반)과 비교:
- R-CNN: 54.2% mAP
- DPM: 33.7% mAP (상대적 성능 향상: 61%)
- 스케치 토큰(HOG + sketch tokens) 및 HSC는 각각 HOG만 사용하는 경우보다 2.5, 4 mAP 포인트 향상.
- 하지만 두 방법 모두 오픈 소스 DPM 구현보다 낮은 성능을 보임.
3.3. Network Architectures
이 논문의 대부분의 결과는 Krizhevsky et al. [25]의 네트워크 아키텍처를 사용합니다.
그러나 우리는 아키텍처 선택이 R-CNN 탐지 성능에 큰 영향을 미친다는 것을 발견했습니다.
Table 3은 Simonyan과 Zisserman [43]이 제안한 16-layer deep network를 사용해 VOC 2007 테스트 세트에서 수행한 결과를 보여줍니다.
이 네트워크는 최근 ILSVRC 2014 분류 챌린지에서 높은 성능을 기록한 모델 중 하나로, 다음과 같은 특징이 있습니다:
- 13개의 3 × 3 합성곱 계층(convolutional layers).
- 5개의 맥스 풀링 계층(max pooling layers).
- 3개의 완전 연결 계층(fully-connected layers).
우리는 이 네트워크를 "O-Net" (OxfordNet)이라 부르며, 기존의 "T-Net" (TorontoNet)과 비교했습니다.
O-Net 적용
- 우리는 Caffe Model Zoo에서 VGG ILSVRC 16-layer 모델의 공개된 사전 훈련된 가중치를 다운로드했습니다.
- 이후 T-Net에서와 동일한 프로토콜로 네트워크를 미세 조정했습니다.
- 차이점: GPU 메모리 제한으로 인해 더 작은 미니배치(24개 예제)를 사용.
결과
- O-Net을 사용한 R-CNN은 T-Net을 사용한 R-CNN보다 성능이 크게 향상되었습니다.
- mAP: 58.5% → 66.0%.
- 단점:
- O-Net의 forward pass는 T-Net보다 약 7배 더 긴 시간이 소요됨.
3.4. Detection Error Analysis
우리는 Hoiem et al. [23]의 훌륭한 탐지 분석 도구를 사용해, 방법의 오류 유형(error modes)을 분석하고, 미세 조정이 이를 어떻게 변경했는지 확인했으며, 우리의 오류 유형과 DPM을 비교했습니다.
주요 논의
- 분석 도구에 대한 자세한 설명은 논문의 범위를 초과하며, 독자는 [23]을 참조하여 세부 사항(예: 정규화된 AP(normalized AP))을 이해하는 것을 권장합니다.
- 분석은 관련된 플롯과 함께하는 것이 가장 효과적이므로, Figure 5 및 Figure 6 캡션에서 논의 내용을 제공합니다.
3.5. Bounding-box Regression
오류 분석을 기반으로, 우리는 로컬라이제이션 오류(localization errors)를 줄이기 위한 간단한 방법을 구현했습니다.
- 이 방법은 DPM에서 사용된 bounding-box regression [17]에서 영감을 받았습니다.
- 우리는 선형 회귀 모델(linear regression model)을 훈련하여, selective search region proposal의 pool5 특징을 기반으로 새로운 탐지 창(detection window)을 예측했습니다.
- Appendix C에 자세한 내용을 기술했습니다.
결과
- Table 1, Table 2, Figure 5에 따르면, 이 간단한 접근법은 많은 수의 잘못된 로컬라이제이션 오류를 수정하며, mAP를 3~4 포인트 향상시켰습니다.
3.6. Qualitative Results
ILSVRC2013에 대한 정성적 탐지 결과는 논문의 마지막에 있는 Figure 8 및 Figure 9에 제시되었습니다.
- 각 이미지는 val2 세트에서 무작위로 샘플링되었으며, 정밀도(precision)가 0.5 이상인 모든 탐지 결과를 포함합니다.
- 이러한 결과는 편집되지 않았으며, 탐지기가 실제로 작동하는 모습을 현실적으로 보여줍니다.
또한, Figure 10 및 Figure 11에서는 편집된 정성적 결과를 제시합니다.
- 각 이미지는 흥미롭거나, 놀랍거나, 재미있는 결과를 포함하고 있기 때문에 선택되었습니다.
- 여기서도 정밀도 0.5 이상인 모든 탐지 결과가 표시됩니다.
4. The ILSVRC2013 Detection Dataset
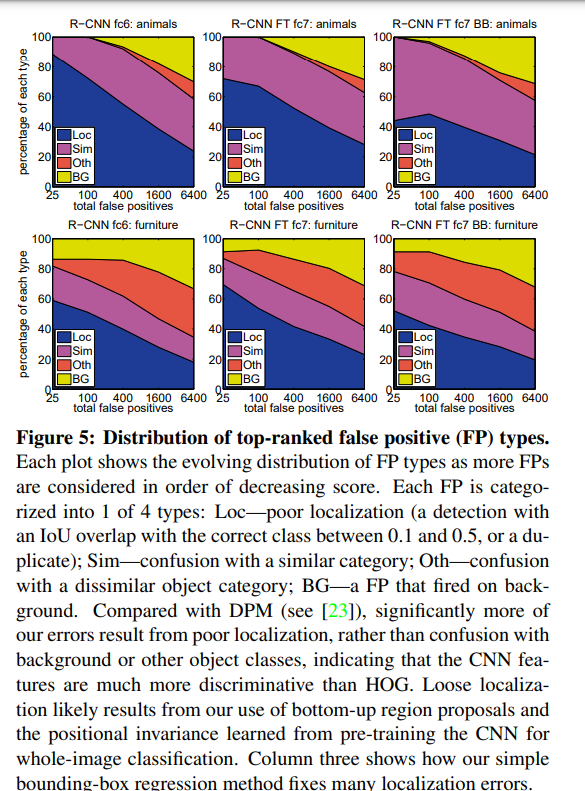
Figure5 False Positive(FP) 유형 분포
이 그림은 R-CNN이 틀리게 탐지한 경우(FP)가 어떻게 분포되어 있는지를 보여줍니다. FP는 4가지 유형으로 나뉩니다:
Loc: 위치를 잘못 잡은 경우 (탐지한 상자와 정답 상자의 겹치는 정도가 적거나 중복으로 탐지된 경우).
Sim: 비슷한 카테고리와 헷갈린 경우.
Oth: 완전히 다른 객체 카테고리와 헷갈린 경우.
BG: 객체가 아닌 배경에서 FP가 발생한 경우.
DPM(Deformable Part Model)과 비교했을 때, R-CNN의 오류는 대부분 위치를 잘못 잡는 Loc 유형에서 발생하며, 배경(BG)이나 다른 객체(Oth)와의 혼동은 적습니다. 이는 R-CNN의 CNN 특징이 HOG보다 더 구별력이 뛰어나다는 것을 보여줍니다.
위치 오류(Loc)가 많은 이유는 R-CNN이 사용하는 region proposal 방식과 CNN이 학습한 위치 불변성 때문일 가능성이 높습니다.
세 번째 열의 그래프는 bounding-box regression(상자 위치 보정)이 이러한 위치 오류를 많이 줄여주는 것을 보여줍니다.
4.1. Dataset Overview
ILSVRC2013 탐지 데이터셋은 train, val, test 세 가지로 나뉩니다.
- train: 395,918장
- val: 20,121장
- test: 40,152장
데이터 분포
- val과 test는 동일한 이미지 분포에서 추출되었으며, PASCAL VOC 이미지와 유사한 복잡성을 가짐.
- 예: 객체 수, 배경 혼잡도, 포즈 다양성 등.
- val과 test는 포괄적 주석(exhaustively annotated)으로, 각 이미지의 모든 객체(200개 클래스)가 경계 상자로 레이블링됨.
- train:
- ILSVRC2013 분류 데이터셋에서 추출된 이미지로 더 다양한 복잡성을 가짐.
- 중심에 단일 객체가 포함된 이미지가 많음.
- 주석이 포괄적이지 않음.
부정적인 이미지
각 클래스는 해당 클래스와 관련된 객체가 포함되지 않은 부정적 이미지(negative images) 세트를 추가로 가짐.
이 부정적 이미지는 수작업으로 검증되었으나, 본 연구에서는 사용되지 않았음.
4.2. Region Proposals
우리는 PASCAL에서 사용한 동일한 region proposal 접근 방식을 따랐습니다.
- Selective Search [39]를 "fast mode"로 실행.
- train 이미지는 사용하지 않았으며, val1, val2, test에서만 적용.
이미지 크기 문제 해결
Selective Search는 스케일 불변(scale-invariant)하지 않으므로, 이미지 해상도에 따라 생성된 영역의 수가 달라짐.
- 해결: 모든 이미지를 폭 500픽셀로 고정 크기 조정 후 Selective Search 실행.
결과
- val: 이미지당 평균 2403개 region proposals, 91.6% recall (IoU ≥ 0.5).
- PASCAL VOC(98%)보다 낮은 성능으로, region proposal 단계의 개선 여지가 있음.
4.3. Training Data
훈련 데이터는 다음으로 구성:
1. val1에서 Selective Search와 ground-truth 경계 상자.
2. 각 클래스에 대해 train에서 최대 N개의 ground-truth 경계 상자(N < 전체 개수일 경우 모두 사용).
- 결과 데이터셋: val1+trainN.
훈련 데이터는 다음 세 가지에 사용됨:
1. CNN 미세 조정(fine-tuning):
- val1+trainN에서 50,000번 SGD 반복.
- NVIDIA Tesla K20에서 13시간 소요(Caffe 사용).
- 탐지기 SVM 훈련:
- val1+trainN의 모든 ground-truth 박스를 해당 클래스의 positive 예제로 사용.
- Hard Negative Mining:
- val1의 5000개 랜덤 샘플 이미지에서 수행.
- 전체 val1에서 수행 시 mAP가 0.5%p 증가하지만 훈련 시간 2배 소요.
- Bounding-box 회귀기:
- val1에서 훈련.
4.4. Validation and Evaluation
최종 테스트 제출 전, val2를 사용해 다음을 검증:
- 데이터 사용 선택.
- 미세 조정과 bounding-box 회귀 효과.
모든 하이퍼파라미터는 PASCAL에서 사용한 값을 유지.
평가 서버 제출
- Bounding-box 회귀 없이 결과 제출.
- Bounding-box 회귀 적용 후 결과 제출.
SVM과 bounding-box 회귀기 훈련에는 확장된 val+train1k 데이터셋 사용.
4.5. Ablation Study
Table 4는 다양한 훈련 데이터 크기, 미세 조정, bounding-box 회귀의 영향을 보여줌.
주요 결과
- mAP (val2)가 test mAP와 밀접히 일치해 신뢰 가능.
- 훈련 데이터 확장:
- val1 → val1+trainN 확장 시 성능 증가:
- N=500 또는 N=1000의 성능 차이는 미미.
- val1 → val1+trainN 확장 시 성능 증가:
- 미세 조정:
- val1만 사용: mAP 26.5%.
- val1+train1k 확장 시: mAP 29.7%.
- Bounding-box 회귀:
- 결과를 31.0% mAP로 개선.
- PASCAL보다 상대적 성능 향상은 적음.
4.6. Relationship to OverFeat
R-CNN과 OverFeat의 관계는 다음과 같음:
- OverFeat은 R-CNN의 특수 사례로 간주 가능:
- Selective Search를 다중 스케일 피라미드로 대체.
- 클래스별 bounding-box 회귀기를 단일 회귀기로 대체.
- OverFeat의 속도:
- 2초/이미지로 R-CNN보다 약 9배 빠름 [34].
- 속도는 슬라이딩 윈도우가 이미지 레벨에서 왜곡되지 않기 때문.
- 공유 계산(shared computation)이 가능하며, 이는 전체 네트워크를 합성곱 방식으로 실행하여 구현됨.
R-CNN의 속도 개선은 다양한 방식으로 가능하며, 이는 미래 과제로 남음.
5. Semantic Segmentation
Region classification은 semantic segmentation에서 표준 기법으로, 이를 통해 R-CNN을 PASCAL VOC 분할 챌린지(segmentation challenge)에 쉽게 적용할 수 있습니다.
우리는 현재 최고의 성능을 가진 O2P ("second-order pooling") 시스템 [4]와 직접 비교를 위해 그들의 오픈 소스 프레임워크를 사용했습니다.
- O2P는 다음을 활용합니다:
- CPMC를 사용해 이미지당 150개의 region proposals 생성.
- 각 region의 품질을 클래스별로 서포트 벡터 회귀(SVR)를 사용해 예측.
- 높은 성능은 CPMC 지역의 품질과 다양한 특징(SIFT, LBP)의 강력한 2차 풀링(second-order pooling)에 기인.
또한, Farabet et al. [16]은 다중 스케일 픽셀 단위 CNN 분류기를 사용하여 여러 장면 레이블링 데이터셋에서 좋은 결과를 보였습니다.
데이터셋 확장
우리는 [2, 4]를 따라 Hariharan et al. [22]이 제공한 추가 주석을 포함하여 PASCAL 분할 훈련 세트를 확장했습니다.
디자인 결정과 하이퍼파라미터는 VOC 2011 검증 세트에서 교차 검증되었습니다.
최종 테스트 결과는 단 한 번 평가되었습니다.
CNN Features for Segmentation
우리는 CPMC 지역에 대해 특징을 계산하는 세 가지 전략을 평가했습니다.
모든 전략은 지역 주위의 직사각형 창을 227×227 픽셀로 왜곡(warp)하는 것으로 시작합니다.
전략
- Full: 지역의 모양을 무시하고 왜곡된 창에서 CNN 특징을 직접 계산 (탐지에서 사용한 방식과 동일).
- 단점: 비직사각형 형태의 지역 정보를 무시함.
- Fg (Foreground): 지역의 전경 마스크에 대해서만 CNN 특징 계산.
- 배경을 평균 입력으로 대체해, 평균값 제거 후 배경 영역이 0이 되도록 설정.
- Full+Fg: Full과 Fg 특징을 단순히 결합.
- 실험 결과, 두 특징의 상호 보완성이 입증됨.
VOC 2011 결과
Table 5는 VOC 2011 검증 세트에서 O2P와 비교한 결과를 요약합니다.
- Fc6 특징은 항상 Fc7 특징보다 우수하며, 논의는 Fc6에 초점을 맞춤.
- Fg 전략은 Full보다 약간 더 우수하며, 이는 마스크된 지역 모양이 강한 신호를 제공한다는 직관과 일치.
- Full+Fg 전략은 평균 정확도 47.9%로 가장 우수한 결과를 달성:
- O2P를 소폭 상회.
- Full 특징이 제공하는 문맥적 정보가 Fg 특징과 결합될 때 높은 성능을 보임.
효율성
- Full+Fg 특징 기반 20개의 SVR 훈련:
- 단일 코어에서 1시간 소요.
- O2P 특징 기반 훈련보다 10배 이상 빠름.
VOC 2011 테스트 세트 결과
Table 6은 VOC 2011 테스트 세트에서 가장 우수한 방법(Fc6, Full+Fg)을 두 강력한 기준선과 비교한 결과를 보여줍니다.
- 21개 카테고리 중 11개에서 최고 세분화 정확도를 달성.
- 평균 세분화 정확도: 47.9%, O2P와 비슷한 수준.
- 추가적인 미세 조정을 통해 더 나은 성능을 달성할 가능성 있음.
6. Conclusion
최근 몇 년간 객체 탐지 성능은 정체 상태에 있었습니다.
가장 성능이 우수한 시스템은 저수준 이미지 특징과 고수준 문맥 정보(객체 탐지기, 장면 분류기)를 결합한 복잡한 앙상블로 구성되었습니다.
주요 기여
본 논문은 단순하고 확장 가능한 객체 탐지 알고리즘을 제안하며, PASCAL VOC 2012에서 이전 최고 성능 대비 30% 상대적 향상을 달성했습니다.
- 핵심 아이디어 1:
- 하이 캡터시티 합성곱 신경망(CNN)을 하향식 region proposals에 적용하여 객체를 로컬라이즈 및 세분화.
- 핵심 아이디어 2:
- 라벨링된 훈련 데이터가 부족할 때 대규모 CNN 훈련을 위한 새로운 패러다임 제안.
- 지도 학습(pre-training): 데이터가 풍부한 보조 작업(이미지 분류)을 사용해 사전 훈련.
- 도메인 특화 미세 조정(fine-tuning): 데이터가 부족한 목표 작업(탐지)을 위해 네트워크 조정.
결론
- 지도 사전 훈련/도메인 특화 미세 조정 패러다임은 데이터가 부족한 다양한 비전 문제에서 효과적일 것으로 추정됩니다.
- 본 연구는 전통적인 컴퓨터 비전 도구(region proposals)와 딥 러닝(CNN)의 결합이 자연스럽고 불가피한 협력임을 보여줍니다.
(Acknowledgments 이하 생략)
