1. 배열
1.1. 배열의 개념과 특성
배열은 같은 자료형의 데이터를 연속된 메모리 공간에 젖아하는 구조이다.
각 데이터는 배열의 시작 주소를 기준으로 일정한 간격으로 배치되면 인덱스를 통해 빠르게 접근할 수 있다.
배열의 핵심적인 특징은 다음과 같다.
- 자료형이 같은 데이터만 저장 가능하다.
- 배열의 크기는 선언 할 때 정해지며 이후 변경할 수 없다.
- 데이터 접근 속도가 매우 빠르다(O(1)).
1.2. 배열의 메모리 관리
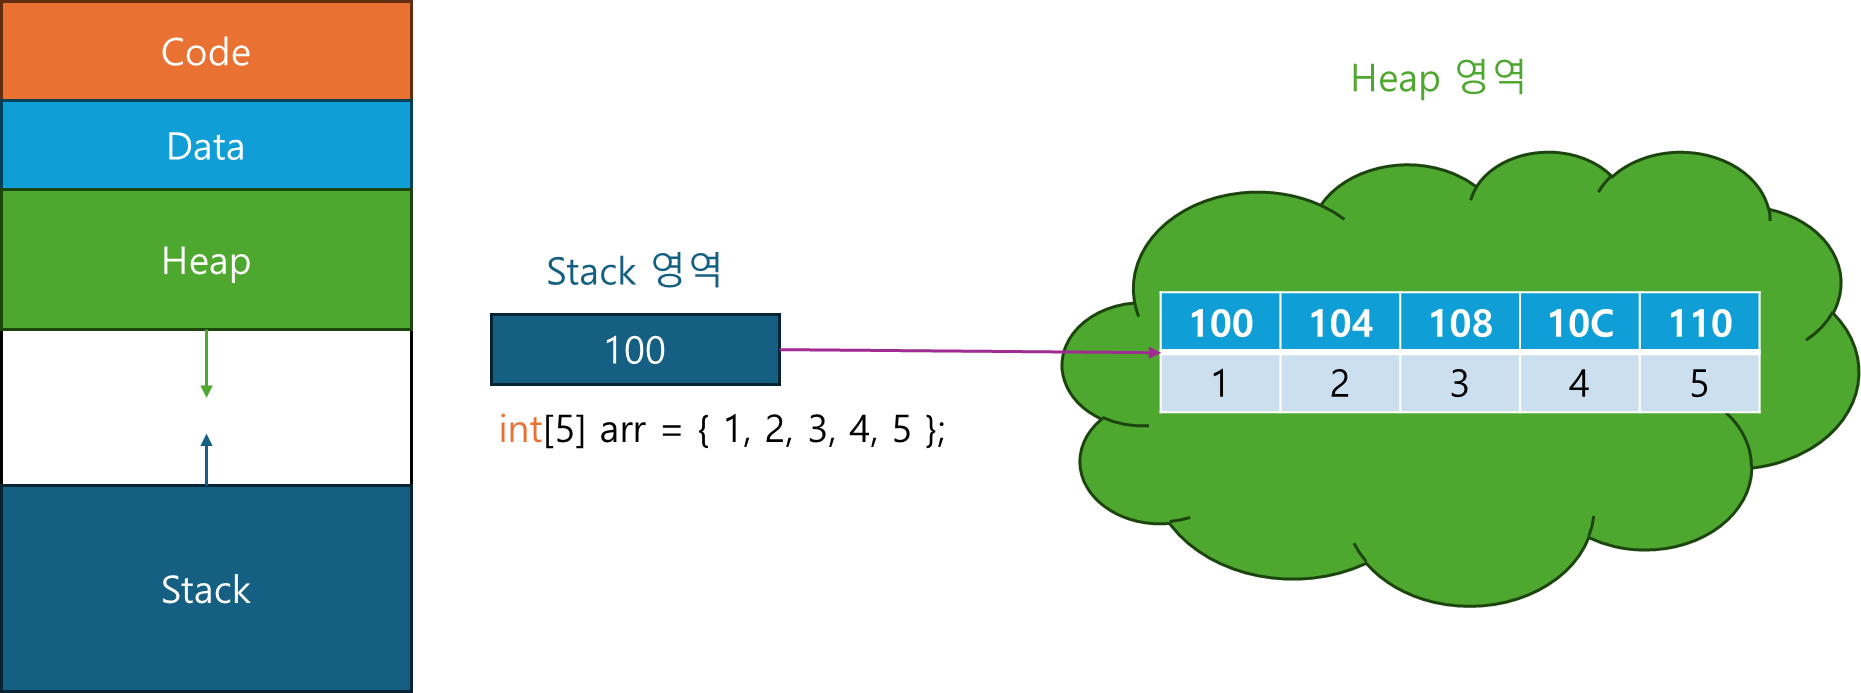
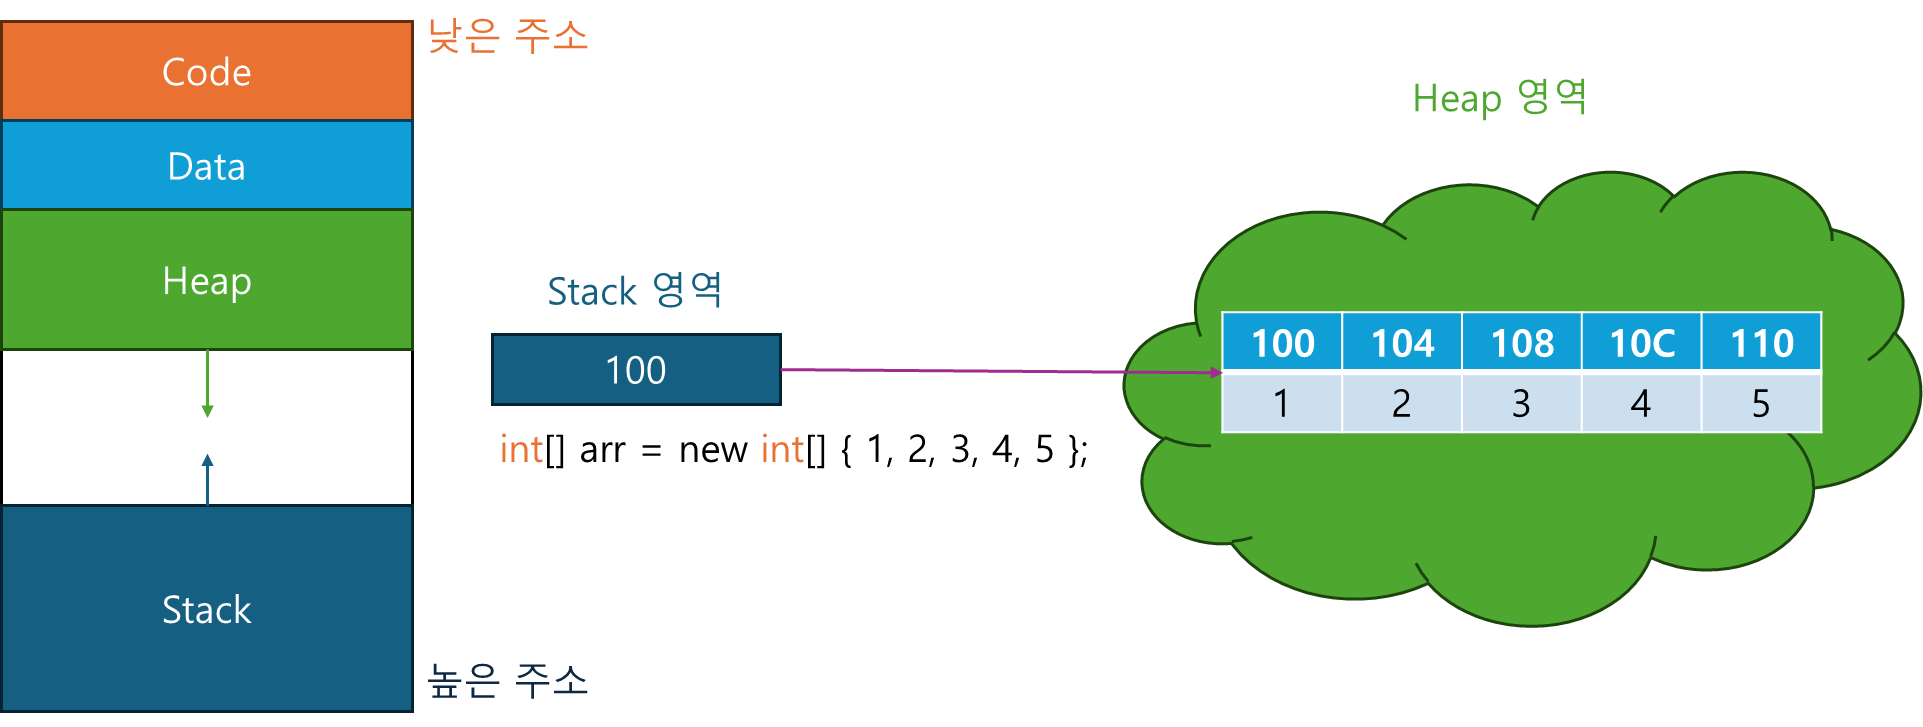
Java에서 배열은 기본 자료형 변수(int, float 등)와 달리 new연산자를 사용하고 Stack에는 배열의 시작 주소만을 담으며, 데이터는 Heap 영역에 저장된다.
메서드가 종료되면 Stack에 있는 주소값은 삭제되지만, Heap 영역의 배열 데이터는 바로 삭제 되지 않는다.
Java는 이런 경우 Garbage Collector(GC)가 자동으로 처리하며, GC는 배열을 참조하는 변수가 없어지면 메모리를 자동으로 회수하여 메모리 누수를 방지한다.
1.3. 배열의 접근과 동작 원리
배열의 첫 번째 인덱스는 0이고 마지막은 배열의 길이(length) - 1이다.
int[] arr = { 1, 2, 3, 4, 5 }
//            0, 1, 2, 3, 4
이 왜 0부터 시작하는 지는 배열의 요소에 접근하는 공식을 통해 알 수 있다.
요소의 주소 = (시작 주소) + (자료형의 크기) * 인덱스배열은 위의 공식을 이용해 요소에 접근하는데 0이 아닌 인덱스부터 시작한다면 매 접근마다 0과 시작 주소의 차이 만큼을 더하거나 빼야하기 때문이다.
1.4. 배열의 활용 예시
- 데이터 그룹 관리: 학생의 점수나 회원 아이디처럼 같은 형식의 여러 데이터를 효율적으로 관리할 수 있다.
- 버퍼 구현: 스트리밍을 위한 데이터 처리나 입출력 버퍼 등 연속된 데이터를 관리하는 데 효과적이다.
- 자료구조의 구현: 스택(Stack), 큐(Queue), 힙(Heap), 해시 테이블(Hash Table) 등은 내부적으로 배열을 활용하며, 연결 리스트를 활용하더라도 효율성을 위해 배열을 접목 시킨 경우가 많다.
2. 다차원 배열(Multi-Dimensional Array)
2.1. 다차원 배열의 개념
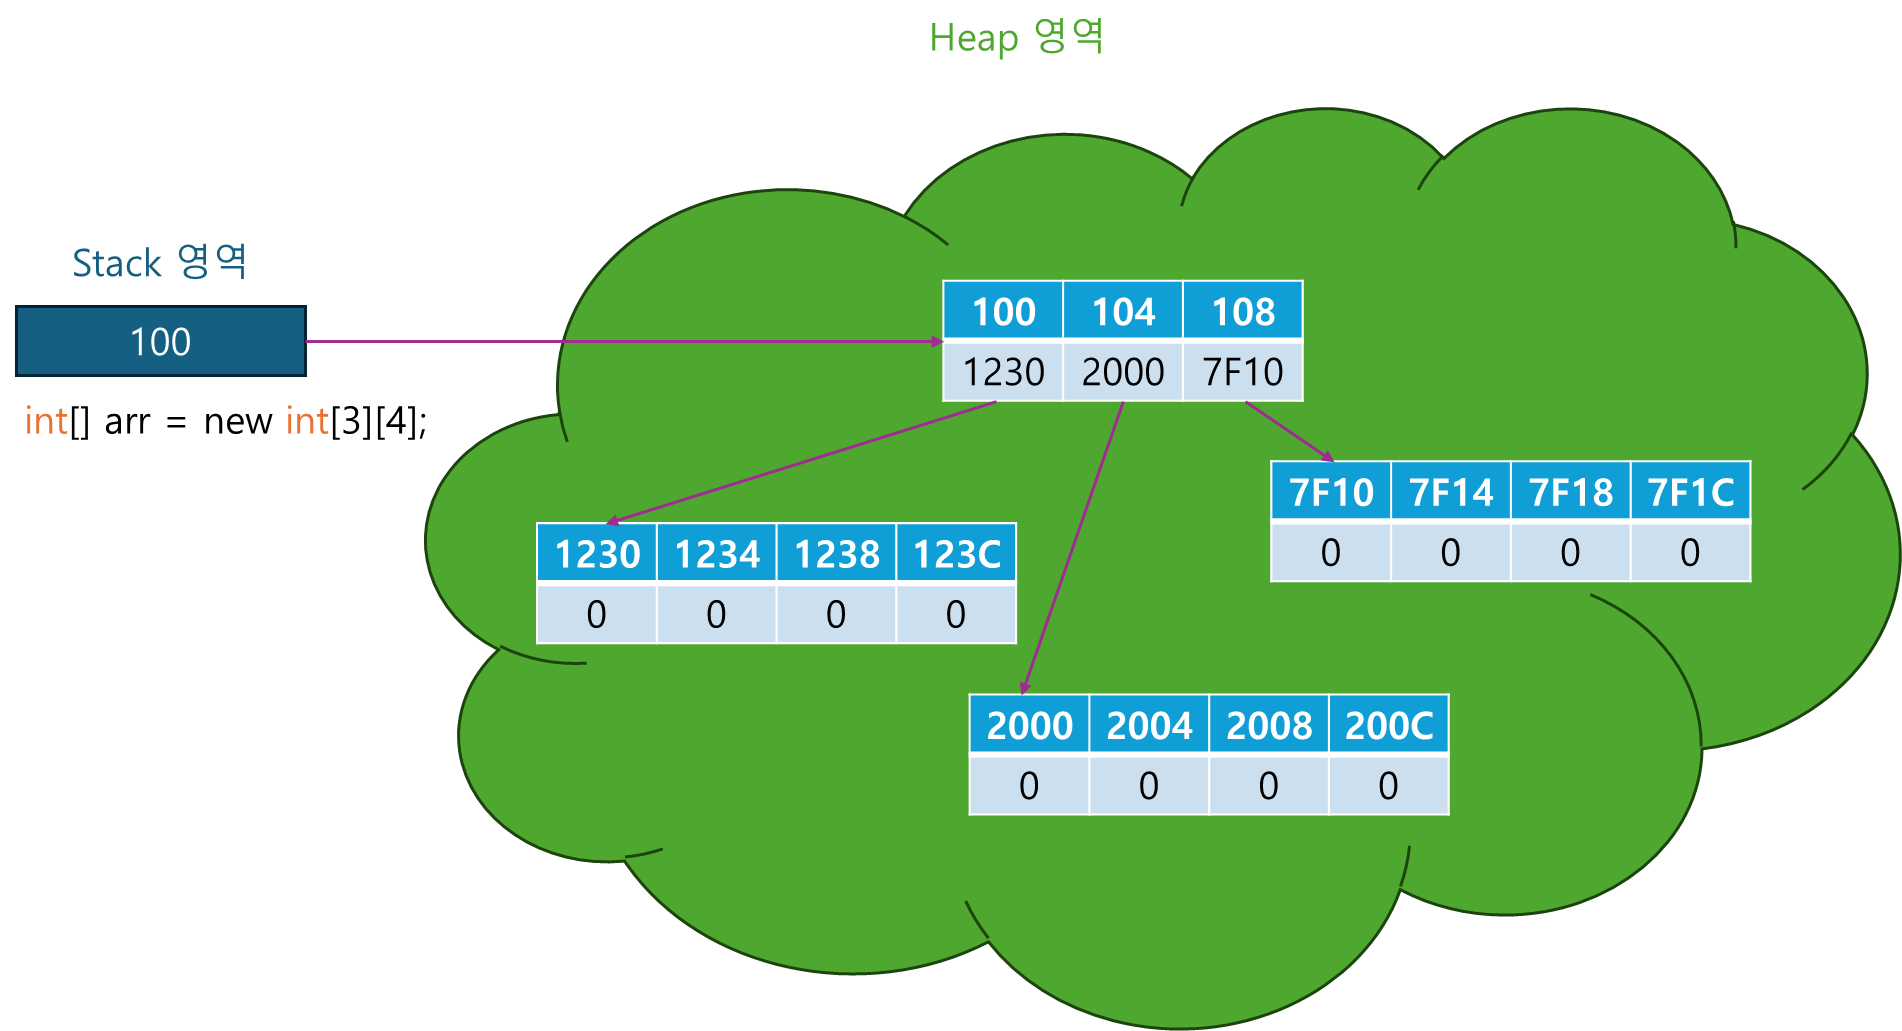
Java에서 다차원 배열은 실제로는 배열의 배열(Nested Array) 형태로 구현된다.
예를 들어 2차원 배열은 다음과 같이 선언된다.
int[][] arr = new int[3][4];이 때 메모리 구조는 아래와 같다.
2.2. 가변 배열(Jagged Array)
Java의 배열은 배열의 배열로 구현되는 특징으로 인해 배열은 각각 다른 길이로 배열을 생성할 수 있다.
int[][] jagged = new int[3][];
jagged[0] = new int[2];
jagged[1] = new int[3];
jagged[2] = new int[1];
이처럼 행마다 다른 크기의 배열을 가지는 형태를 가변 배열이라 부르며, 메모리를 효율적으로 사용할 때 유리하다.
1. 배열의 정렬
3.1. 정렬의 필요성
정렬은 데이터를 일정한 규칙(크기순 등)으로 배열하는 작업이다.
정렬된 배열은 검색이나 데이터 처리를 더 빠르게 할 수 있다.
3.2. 정렬 알고리즘의 종류와 특징
- 직관적으로 떠올릴 수 있지만 느린 정렬 (O(n²))
- 버블 정렬(Bubble Sort)
- 선택 정렬(Selection Sort)
- 삽입 정렬(Insertion Sort)
- 효율적인 정렬 알고리즘 (O(n log₂ n))
- 퀵 정렬(Quick Sort): 피벗을 기준으로 분할하여 정렬
- 병합 정렬(Merge Sort): 데이터를 분할하고 병합하는 방식
- 힙 정렬(Heap Sort): 반 정렬 되는 특성을 가지는 힙(Heap)을 사용해 정렬
자바에서 제공하는 기본 정렬은 내부적으로 퀵 정렬과 병합 정렬을 혼합한 방식을 사용한다고 한다.
4. 배열의 복사
4.1. 얕은 복사(Shallow Copy)
얕은 복사는 배열의 참조 값(시작 주소)를 복사하여 동일한 배열을 참조하게 하는 방식이다.
int[] a = { 1, 2, 3 };
int[] b = a;
b[0] = 100; // a[0]도 함께 변경됨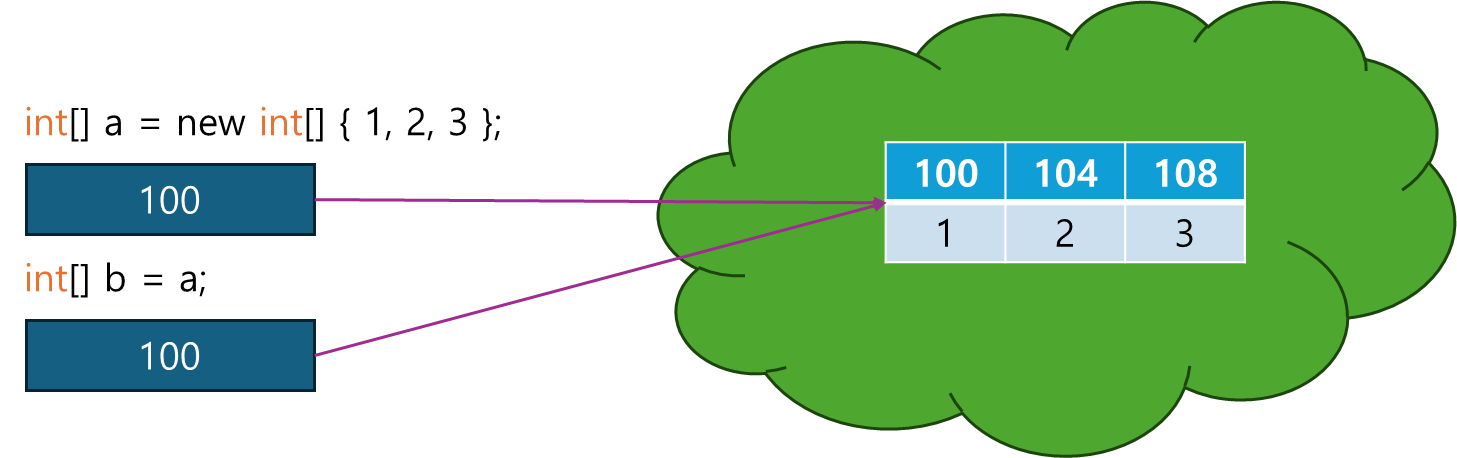
4.2. 깊은 복사(Deep Copy)
깊은 복사는 배열의 데이터 값을 직접 복사하여 완전히 독립된 배열을 만드는 방식이다.
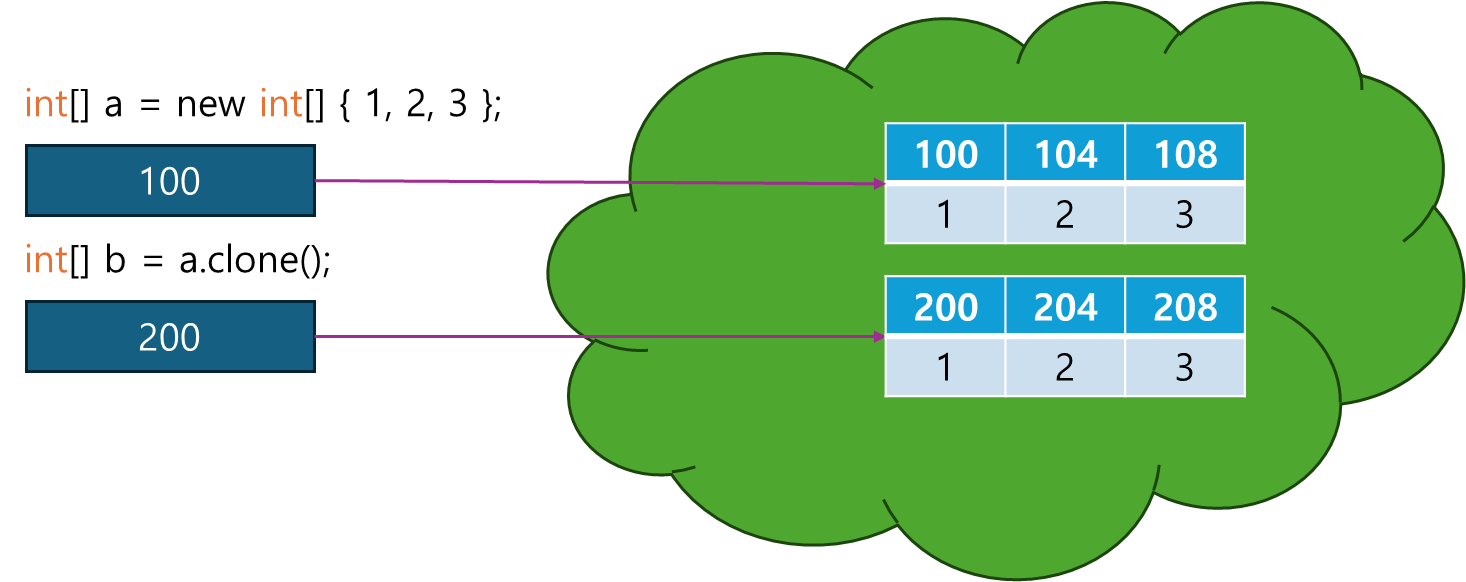
깊은 복사를 위한 방법:
array.clone()사용
int[] a = {1, 2, 3};
int[] b = a.clone();System.arraycopy()사용
int[] a = {1, 2, 3};
int[] b = new int[a.length];
System.arraycopy(a, 0, b, 0, a.length);Arrays.copyOf()사용
int[] a = {1, 2, 3};
int[] b = Arrays.copyOf(a, a.length);
자바에서 제공하는 메서드는 성능적으로 최적화 되어 있어 직접 반복문으로 복사하는 것 보다 효율적이다.
5. 배열의 장단점과 사용 시 주의점
-
장점:
- 빠른 접근 속도(O(1))
- 구현이 간단하여 프로그래밍 편의성이 높음
- 메모리 공간의 연속성으로 인해 성능 최적화가 가능함
-
단점:
- 배열의 크기를 처음에 선언하고 고정되기 때문에 데이터의 추가가 불편함
- 연속된 메모리 공간에 있기 때문에 삭제가 불편함
- 선언한 공간의 크기에 따라 메모리 낭비가 발생할 가능성 존재
- 다양한 자료형의 데이터 저장 불가능
- 범위 (
0-length - 1)를 벗어날 가능성이 존재함
배열을 사용할 때에는 목적과 특성을 잘 고려하여 선택하고, 필요한 경우 컬렉션(ArrayList, LinkedList 등)을 사용하는 것이 좋을 수 있다.
참고) 컬렉션의 경우도 미리 저장될 자료의 크기를 알 수 있다면 Capacity를 지정해주는 것이 좋을 수 있다.
