어느새 회사를 다니기 시작한지 3개월차에 접어들었습니다. 적응할새도 없이 주어지는 업무를 닥치는대로 해결해나가다 보니 어느새 시간이 이렇게 흘렀네요... 시간이 정말 빨리 지나가는 것 같습니다 ㅎㅎ;
짧은 기간이지만, 생각보다 많은 일을 했더라구요! 그냥 잊어버리기엔 너무나 아까운 제자산들이기에 블로그에 간단하게나마 기록해두고자 합니다.
오늘은 API 응답 지연 문제를 식별하고, 이를 해결해나간 과정에 대해 얘기해보려합니다.
문제 상황
저희 회사는 약 500대 선박의 네트워크 현황을 실시간으로 모니터링/관리하는 서비스를 운영하고 있습니다
선박은 위성 네트워크를 사용하는데 이 위성 네트워크는 비용이 엄청날 뿐만 아니라, 선박에 설치된 위성장비의 위치, 각도, 인접한 국가의 위성 네트워크 정책, ... 등에 따라 네트워크 연결이 지연되기도, 아예 중단되기도 합니다. 이런 장애상황을 적절히 핸들링하기 위해, 각 선박에 설치된 기기로부터 5분 주기로 메트릭을 수집해 메인 서버에 저장한 후, 이를 시각화하고 있었습니다.
아래는 실제 코드와 유사한 코드입니다.
            SELECT
                ...
            FROM vessels AS v
            LEFT JOIN (
                SELECT *, ROW_NUMBER() OVER (PARTITION BY vessel_id ORDER BY timestamp DESC) AS rn
                    FROM vessel_position vpt
                    WHERE vpt.timestamp >= NOW() - INTERVAL :minutes MINUTE
                ) AS vp
                ON v.imo = vp.vessel_id
			...
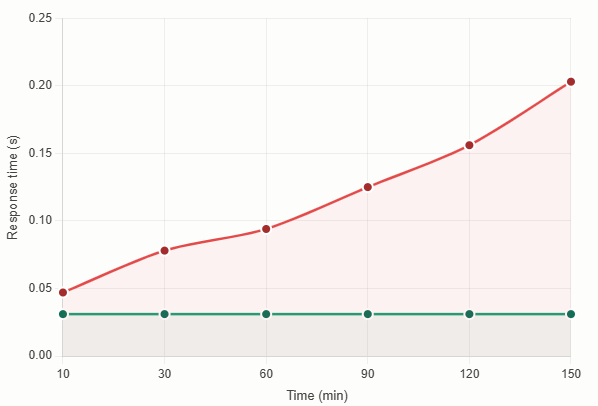
쿼리는 선박의 자식 테이블 vessel_position에서 일정 구간내의 레코드를 수집해 선박의 온라인/오프라인 여부 판단과 데이터 사용추이를 파악하고 있었습니다. 쿼리 시간도 평균 약 0.047로 준수한 성능을 냈었습니다.
하지만 WHERE vpt.timestamp >= NOW() - INTERVAL :minutes MINUTE 의 minutes이 늘어나자 응답시간이 이와 비례해 느려지는 문제를 확인했습니다.
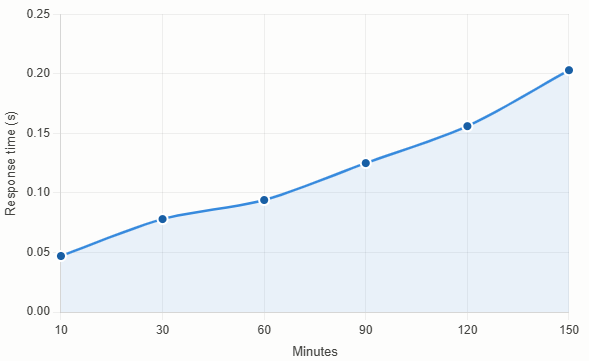
쿼리 응답시간이 느려지는 문제는 DB 커넥션 풀 고갈로 서버 장애를 초래할 수 있는 위험한 문제인 동시에, 사용자 경험을 저해하는 요소이기에 문제를 조속히 개선해야 했습니다.
쿼리 분석
가장 먼저 확인해본건, EXPLAIN 명령을 통해 실행계획을 확인하는 것이였습니다.

위 결과에서 볼 수 있듯이, 쿼리는 Index Range Scan을 통해 처리가 되고 있었고, :minutes의 범위에 따라 쿼리 실행시긴이 변동되고 있었습니다.
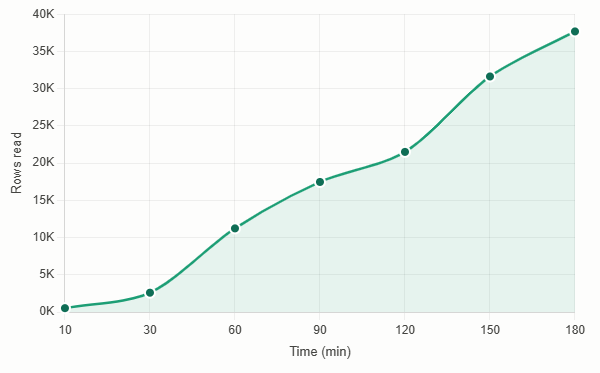
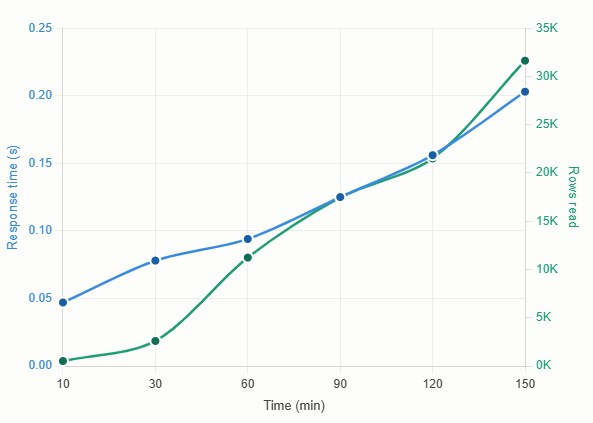
시간에 따른 읽은 행 수와 응답시간이 깊은 상관관계를 가진단 판단에 따라, Index Range Scan의 범위를 줄이는 것이 해당 쿼리의 성능을 개선하는데 중요한 요인이라 판단했습니다.
해결 : 쿼리의 역할을 어플리케이션으로 분리하기
기존 쿼리는 WHERE vpt.timestamp >= NOW() - INTERVAL :minutes MINUTE 조건으로 주어진 시간 구간 내의 레코드를 모두 읽어온 뒤, ROW_NUMBER() OVER (PARTITION BY vessel_id ORDER BY timestamp DESC)로 선박별 최신행을 추출하는 방식이었습니다. 이 구조에서는 :minutes 파라미터가 커질수록 Index Range Scan의 탐색 범위가 선형적으로 증가하고, 윈도우 함수의 정렬 비용까지 더해져 응답시간이 비례적으로 느려질 수밖에 없었습니다.
문제의 본질을 다시 살펴보면, 실제로 필요한 정보는 "각 선박의 가장 최근 통신 시각"뿐이었습니다. 그 시각을 현재 시간과 비교하여 구간 이내이면 Online, 초과하면 Offline로 판단하는 것이 비즈니스 로직의 전부였죠. 즉, 시간 구간 내의 모든 레코드를 스캔할 필요가 없었고, 선박당 단 하나의 최신 타임스탬프만 있으면 충분했습니다.
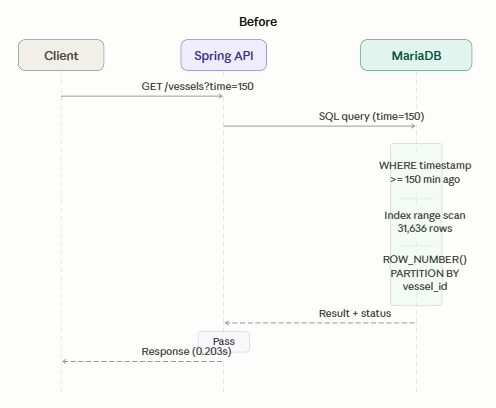
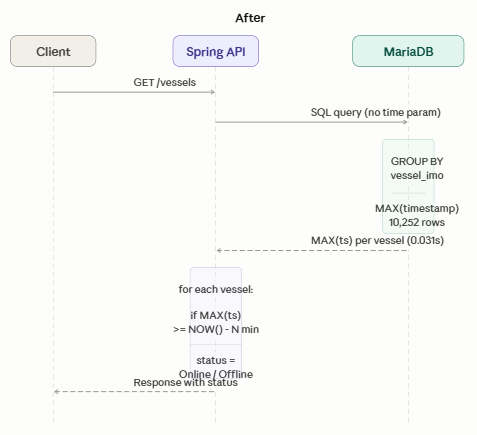
이 판단을 근거로 쿼리와 애플리케이션의 책임을 분리했습니다.
            SELECT
                ...
            FROM vesselinfo AS v
            LEFT JOIN (
                    SELECT vp1.vessel_imo AS imo, MAX(vp1.timestamp) AS max_ts
                    FROM vessel_position AS vp1
                    GROUP BY vp1.vessel_imo
                    ) AS vpt
                ON v.imo = vpt.imo
            ...
변경된 쿼리는 GROUP BY vessel_imo와 집계 함수 MAX(timestamp)를 사용하여 선박당 최신 타임스탬프 하나만을 반환합니다. 이전의 WHERE 절에 의한 시간 범위 필터링이 제거되었으므로 :minutes 파라미터에 의존하지 않으며, MariaDB 옵티마이저는 이 패턴을 Index Loose Scan으로 처리하게 됐고, 스캔 행 수가 :minutes에 따라 517~37,686행까지 변동되던 것이 10,252행으로 고정되었습니다.
    public Boolean isAvailable(final LocalDateTime currentTime, final Long hours) {
        if (lastConnectedAt == null) {
            return false;
        }

        return lastConnectedAt.isAfter(currentTime.minusHours(hours));
    }
선박의 시간 비교 로직을 애플리케이션 레벨로 옮겨, DB가 반환한 lastConnectedAt(= MAX(timestamp))과 현재 시각을 비교하는 단순한 연산으로 Online/Offline을 판별하도록 구성했습니다.
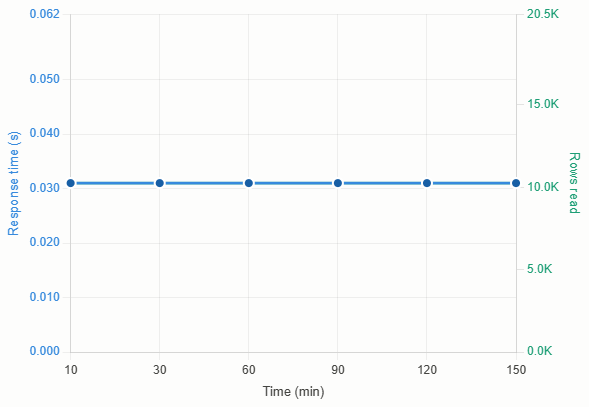
결과적으로 위 그래프와 같이, 결정적인 응답시간을 받을 수 있게 개선됐습니다.
이전과 비교
결과적으로 쿼리 응답시간은 0.047s~0.203s에서 0.031s로 고정되어, 최대 약 85%의 성능 개선을 달성했습니다. 더 중요한 것은 시간 파라미터의 크기와 무관하게 응답시간이 일정하다는 점으로, HikariCP 커넥션 풀 고갈 위험을 원천적으로 제거하고 서비스의 응답시간 예측 가능성을 확보할 수 있었습니다.
마이 필링
쿼리와 비즈니스 코드의 관계에 대해 다시 돌아보게 되는 계기였습니다. SQL이 강력하다는 이유로 비즈니스 판단 로직까지 쿼리에 욱여넣다 보면, 이번 사례처럼 DB가 불필요한 일까지 떠안게 되는 경우가 생깁니다. "DB는 데이터를 효율적으로 읽어오는 데 집중하고, 판단은 애플리케이션이 한다" — 당연한 분리 원칙인데 실무에서 놓치기 쉬운 지점이었습니다.
근데, 클로드코드가 진짜 미친거 같습니다. 그래프 그리는데 탁월할 뿐만아니라, 내가 원하는 그림을 설명하면 이에 맞춰서 잘 그려줍니다 ㄷㄷ
