MySQL의 격리 수준이 Repeatable Read면 Phantom Read 문제가 발생해야될 것 같은데, 방지해준다고 한다.
해당 이유와 InnoDB에서 발생하는 동시성 문제를 해결하며 해결 방안에 대해 다뤄보겠다.
이번 딥다이브는 필자가 자주 사용하고, 익숙한 MySQL + InnoDB 기준으로 진행한다.
1. 격리수준
MySQL InnoDB의 격리수준은 Repeatale Read이다.
Repeatale Read 격리수준은 Dirty-Read와 Non-Repeatable Read가 발생하지 않음을 보장하지만 Phantom Read 문제가 발생할 수 있다.
이 격리수준을 다루기 전, 앞서 말한 3가지 문제점들에 대해 간략하게 다뤄보겠다.
-
Dirty-Read (다른 트랜잭션의 커밋 이전 데이터 읽기)
말 그대로 더러운 읽기이다. 다른 트랜잭션의 커밋 이전의 데이터를 읽어올 수 있기 때문에 들숙날숙한 정보 조회 문제가 발생한다. 대부분의 DBMS들은 이 Dirty-Read 문제 해결을 보장한다. -
Non-Repeatable Read (트랜잭션 내 데이터의 값 변경이 발생한다.)
tx1에서 A=10을 읽었다. 그 도중 tx2에서 A=10을 동일하게 읽고 A+=10 처리 후 commit했다. tx1에서 다시 A를 읽어오면 A=20을 읽게 된다. -
Phantom Read (트랜잭션 내 데이터가 생성이 반영된다.)
tx1에서 목록 조회로 2개의 값을 얻었다. tx2도 동일하게 조회한 후 값을 1개 추가하고 commit했다. tx1에서 다시 목록 조회를 하면 값이 1개 추가되어 3이 조회된다.
2. 격리 수준이 Repeatable Read이지만 Phantom Read는 거의? 안생겨요
읽으면서 모순인데? 싶을 수 있다.
앞서 Repeatable Read 격리 수준에서는 Phantom Read가 발생한다고 했는데, 왜 MySQL에는 안생긴다고 하는걸까? 그 이유는 MySQL의 InnoDB의 작동 방식에 있다.
InnoDB는 MVCC(Multi-Version Concurrency Control)를 통해 동시성을 관리한다.
MVCC는 데이터베이스에서 동시성을 관리하는 메커니즘으로 Undo Log를 통해 이전 데이터 버전을 관리한다.
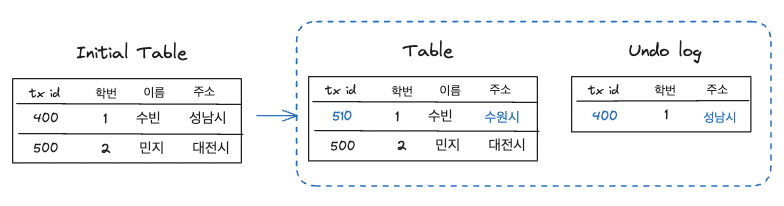
따라서 InnoDB의 트랜잭션은 미리 읽은 Undo Log 공간 내에서 처리가 이뤄지기 때문에 row 추가로 영향받는 Phantom Read 문제는 발생하지 않는다.
3. 근데 거의? 안생긴다는건 뭐에요?
앞서 MVVC 방식을 통해 Undo Log내에서 처리가 이뤄진다고 했는데 어떻게 Phantom Read가 발생할 수 있는 것일까?
앞서 MVCC로 스냅샷 안에서 읽기 때문에 팬텀이 안 생긴다고 했다. 그런데 여기엔 슬쩍 숨겨둔 전제가 하나 있다. "Undo Log에서 읽는 건 일반 SELECT뿐"이라는 것
[세션 A] BEGIN; SELECT * FROM t WHERE amount > 10000;      -- 2건 (여기서 스냅샷 고정)
[세션 B] INSERT INTO t VALUES (..., 20000); COMMIT;        -- 새 행 커밋
[세션 A] SELECT * FROM t WHERE amount > 10000;             -- 여전히 2건 (스냅샷이 숨김)
[세션 A] SELECT * FROM t WHERE amount > 10000 FOR UPDATE;  -- 3건! 새 행 등장 = 팬텀
FOR UPDATE 연산을 위해 데이터베이스에 물리적 조회가 발생하는 순간 Undo Log를 조회하는 것이 아닌 데이터베이스를 새롭게 조회하게 되므로 팬텀 리드 문제가 발생한다.
즉 MySQL의 "거의 안 생긴다"는 두 읽기 모드를 한 트랜잭션에 섞을 때 깨질 수 있다는 뜻이다.
4. 그럼 어떻게 막아요?
팬텀이 "빈 공간에 새 row가 INSERT되는 것" 때문이라면, 그 빈 공간을 미리 잠가버리면 된다. InnoDB는 바로 이 일을 하는 락을 갖고 있다.
-
Record Lock: 인덱스 레코드(행) 하나를 잠근다.
-
Gap Lock: 레코드와 레코드 사이의 빈 공간을 잠근다. 행을 잠그는 게 아니라 그 구간에 INSERT 하는 걸 막는다.
-
Next-Key Lock: Record Lock + Gap Lock. (이전 레코드, 현재 레코드] 범위를 통째로 잠근다. InnoDB가 범위 스캔에서 기본으로 쓰는 잠금 단위다.
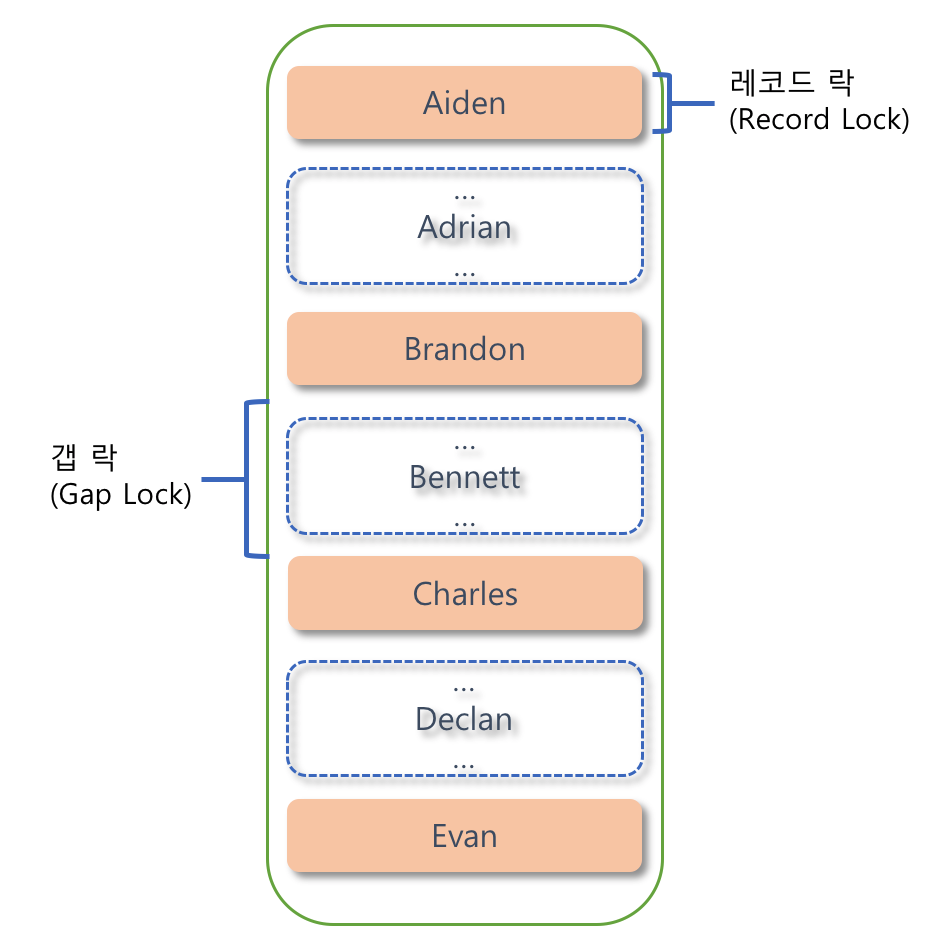
팬텀의 정체가 "범위로의 INSERT"였으니, 범인을 잡는 건 Gap Lock이다. 그리고 이 잠금은 SELECT ... FOR UPDATE로 발동한다. 아까 그 예시를, 이번엔 처음부터 FOR UPDATE로 바꿔보자.
[세션 A] BEGIN; SELECT * FROM t WHERE amount > 10000 FOR UPDATE;  -- 범위 전체에 Next-Key Lock
[세션 B] INSERT INTO t VALUES (..., 20000);                       -- 갭락에 걸려 '대기'
[세션 A] SELECT * FROM t WHERE amount > 10000 FOR UPDATE;         -- 그대로 2건
[세션 A] COMMIT;                                                  -- 이제서야 세션 B의 INSERT가 진행
세션 B의 INSERT는 세션 A가 잡은 갭락 때문에 세션 A가 커밋할 때까지 대기한다. 끼어들 틈 자체가 사라지니 팬텀이 발생할 수 없다.
즉 팬텀을 반드시 막아야 한다면 첫 읽기부터 일관되게 FOR UPDATE로 범위를 잠그면 된다. (중간에 끼워넣으면 늦는다. 갭락은 거는 순간부터 INSERT를 막는 거라 타이밍이 중요하다.)
5. 그래서 JPA에서는 어떻게 써요?
결론부터. JPA에서 FOR UPDATE를 걸려면 읽는 메서드에 명시적으로 @Lock을 붙여 줘야 한다.
public interface StockRepository extends JpaRepository<Stock, Long> {

    // PESSIMISTIC_WRITE → InnoDB에서 SELECT ... FOR UPDATE 로 나간다
    @Lock(LockModeType.PESSIMISTIC_WRITE)
    @Query("select s from Stock s where s.id = :id")
    Optional<Stock> findByIdForUpdate(@Param("id") Long id);
}
@Transactional
public void reserve(Long stockId) {
Stock stock = stockRepository.findByIdForUpdate(stockId) // 여기서 FOR UPDATE 발동
.orElseThrow(() -> new IllegalStateException("재고 없음"));
stock.decrease(1); // 더티 체킹으로 트랜잭션 커밋 시 UPDATE
}기본 findById는 일반 SELECT로 나간다. 앞 절에서 봤듯이 첫 읽기가 범위를 잠그지 않으면 그 사이 INSERT나 변경이 끼어들 여지가 있다. 그래서 동시성 보호가 필요한 흐름이라면 진입 시점부터 findByIdForUpdate 같은 잠금 메서드로 읽는 편이 안전하다. "트랜잭션 안에서 읽었으니 안전하겠지"라고 생각하기 쉽지만, 꼭 그렇지는 않다.
여기에 알아두면 좋은 위험이 둘 더 있다.
락 보유 시간 = 트랜잭션 시간
잡은 락은 메서드가 끝나(=커밋되)기 전까지 유지된다. 그래서 락을 쥔 트랜잭션 안에서 외부 API 호출이나 무거운 계산 같은 느린 작업을 하면, 그동안 다른 트랜잭션이 대기하게 된다.
innodb_lock_wait_timeout(기본 50초)을 넘기면 대기하던 쪽이 에러로 끝나고, 서로 물리면 데드락으로 한쪽이 롤백될 수 있다. 가능하면 느린 작업은 락 범위 밖으로 빼고, 락을 쥔 트랜잭션은 짧게 가져가는 게 좋다.
영속성 컨텍스트(1차 캐시)
JPA는 DB의 MVCC 위에 1차 캐시가 한 겹 더 있다. findByIdForUpdate로 가져온 엔티티는 영속 상태로 캐시에 올라가서, 같은 트랜잭션에서 같은 ID를 findById로 다시 읽으면 DB를 거치지 않고 캐시 것을 돌려주는 경우가 많다. "다시 조회했는데 왜 값이 그대로지?"의 원인이 보통 이거다.
DB를 다시 읽어야 한다면 entityManager.refresh()로 강제할 수 있다. (다만 락을 쥐고 있는 동안엔 남이 못 바꾸니, 대개는 신경 쓸 일이 없다.)
정리하면, JPA에서 동시성을 지킬 때는 대략 이렇게 가져가면 무난하다.
- 진입 시점부터
@Lock(LockModeType.PESSIMISTIC_WRITE)메서드로 읽기 (일반 findById는 잠그지 않는다). - 락을 쥔 트랜잭션은 짧게, 느린 작업은 가급적 락 범위 밖으로
- 1차 캐시 때문에 재조회가 최신이 아닐 수 있다는 점 염두에 두기
격리수준은 깔려 있는 기본 방어선에 가깝고, 그 위에서 벌어지는 동시성은 결국 락을 어디서부터 얼마나 거느냐에 따라 달라지는 경우가 많다.
