들어가며
안녕하세요. 대전 구즉동 청소년 문화의 집에서 사용 중인 체크인 서비스를 개발하고 있는 오혜민입니다.
이 서비스는 기관 방문자가 시설을 이용하기 전 체크인을 진행하는 데 사용됩니다. 서비스를 운영하는 과정에서 서버에 장애가 발생하거나 네트워크 연결이 불안정해지면서 체크인 과정이 중단되는 문제가 발생했습니다.
이 글에서는 서비스의 가용성을 높이기 위해 클라이언트에서 체크인 데이터를 어떻게 관리했고, 서버가 복구된 뒤 다시 동기화하는 구조를 어떻게 설계했는지와 그 과정에서 마주친 문제들을 기록해보려고 합니다.
고가용성이란?
서버나 네트워크 같은 IT 시스템이 중단 없이 오랜 기간 동안 지속적으로 정상 운영되는 성질
고가용성은 보통 서버 이중화, 로드 밸런싱, 장애 조치처럼 서버나 인프라 영역에서 많이 다루는 개념입니다.
물론 클라이언트에서 서버 자체의 장애를 해결하는 데에는 한계가 있습니다. 하지만 서버에 문제가 생기더라도 사용자가 체크인을 할 수 있는 구조로 만들 수는 없을까 하는 생각이 들었습니다.
그래서 서버가 정상적으로 동작하지 않는 동안에는 클라이언트가 체크인 데이터를 임시로 저장한 후 서버가 복구되면 다시 데이터를 반영하는 방식으로 서비스의 가용성을 보완해보기로 했습니다.
왜 클라이언트에서까지 가용성을 고민했을까?
서비스 초기에는 서버를 AWS 환경에서 운영했습니다. 하지만 운영 기간이 길어지면서 서버 비용 부담이 생겨서 직접 홈서버를 구축해 운영하는 방식으로 인프라를 변경했습니다.
하지만 처음 관리해보는 서버 환경이다 보니 네트워크 연결이나 전원, 배터리 등 여러 부분에서 예상하지 못한 문제가 발생했고 서버 환경도 안정적이지 않았습니다.
물론 가장 먼저 해야 할 일은 서버와 인프라 자체를 안정화하는 것이었습니다.
서버 측에서도 이중화나 장애 대응 방법을 고민하고 있었지만, 기존 구조를 다시 설계하고 실제 환경에 적용하기까지는 시간이 필요했습니다.
실제 운영 중 서버에 문제가 발생하면 체크인을 수기로 전환해야 했고, 그 과정에서 방문자의 체크인 시간이 지체되었습니다. 그리고 서버를 안정화하더라도 불안정한 네트워크 연결 등의 다른 문제로도 체크인이 불가한 상황이 생길 수도 있었습니다.
그래서 서버를 안정적으로 설계하는 것과는 별개로 서버에 문제가 생기더라도 서비스는 최대한 계속 동작할 수 있도록 클라이언트에서도 대응할 방법을 고민하게 되었습니다.
기존 구조에서는 어디에서 문제가 생겼을까?
기존 체크인 과정에서는 가장 먼저 사용자의 이름을 입력받고, 서버에 사용자 존재 여부를 확인하는 API를 요청합니다. 기존 회원이라면 방문 목적과 동행인 수를 입력받아 체크인을 진행하고, 처음 방문한 사용자라면 전화번호, 생년월일, 거주지 등의 정보를 추가로 입력받은 뒤 체크인을 진행하는 구조였습니다.
문제는 이 과정이 시작부터 서버의 응답에 의존하고 있다는 점이었습니다.
서버에 장애가 발생하거나 네트워크 연결이 끊기면 첫 번째 단계인 사용자 확인 API부터 요청할 수 없었고, 이후 과정으로 넘어갈 방법도 없었습니다.
서버가 내려가면 어떻게 체크인을 할까?
여기서 가장 먼저 해결해야 했던 건 기존 회원인지 신규 회원인지 확인하는 과정이었습니다. 서버가 내려가면 이 판단 자체를 할 수 없었기 때문입니다.
그래서 먼저 서버의 상태를 확인할 수 있도록 Health Check API를 구현했습니다.
{
  "db": "UP",
  "status": "UP"
}
서버와 DB가 모두 정상이라면 기존과 동일한 체크인 플로우를 그대로 사용합니다. 반대로 둘 중 하나라도 DOWN이거나 Health Check 요청 자체가 실패한 경우엔 사용자 확인 API를 호출하지 않고, 바로 오프라인 체크인 플로우로 전환하도록 했습니다. 오프라인 상태에서는 현재 사용자가 기존 회원인지 신규 회원인지 확인할 수 없기 때문에, 회원가입 화면처럼 체크인에 필요한 정보를 모두 입력받도록 구성했습니다.
이때 입력받은 데이터는 바로 서버로 전송하지 않고 클라이언트에 임시로 저장한 뒤 서버가 다시 정상 상태로 돌아오면 저장해둔 데이터를 서버로 전송하고 이때 기존 회원인지 신규 회원인지 확인한 뒤 최종적으로 체크인 데이터를 반영하도록 설계했습니다.
그래서 장애가 발생한 동안에는 회원 여부를 판단하지 않고 서버가 다시 살아나면 데이터를 전송할 때 확인하도록 했습니다. 이렇게 하면 서버가 잠시 다운되거나 네트워크가 불안정해도 사용자는 체크인을 할 수 있었습니다.
데이터를 어디에 저장할까?
처음에 바로 떠오른 건 로컬 스토리지였습니다. 구현하기도 단순하고 자주 사용했기에 로컬 스토리지에 저장하려고 했지만 현재 서비스에서는 체크인 데이터 하나만 저장하는 것이 아니라 서버로 전송되지 않은 요청 여러 개를 관리해야 했고, 각 요청마다 상태도 함께 관리할 필요가 있었습니다.
interface PendingCheckIn {
  clientRecordId: string;
  payload: CheckInRequest;

  status: "pending" | "syncing" | "failed";

  attemptCount: number;
  lastError?: string;

  createdAt: string;
}
물론 객체 형태의 데이터도 JSON.stringify()를 사용하면 로컬 스토리지에 저장할 수 있었지만 이번에는 여러 개의 요청을 계속 추가하고 수정해야 했고, 각 요청의 상태에 따라 데이터를 관리할 필요도 있었습니다. 또한 로컬 스토리지는 동기적으로 동작하기 때문에 이번 구조에 사용하기에는 적합하지 않다고 생각했습니다.
반면 IndexedDB는 비동기적으로 데이터를 다룰 수 있고 객체 형태의 구조화된 데이터도 그대로 저장할 수 있었습니다. 그래서 이번 구조에는 IndexedDB가 더 적합하다고 판단했습니다.
저장한 데이터를 언제 실제 서버에 요청할까?
임시로 IndexedDB에 데이터를 저장하더라도 결국 서버가 다시 정상 상태로 돌아오면 저장해둔 데이터를 실제 서버에 전송해야 합니다. 이때 가장 중요한 건 서버가 언제 다시 정상 상태로 돌아왔는지 판단하는 것이었습니다.
앞서 구현한 Health Check API를 활용하여 서버와 DB의 상태를 주기적으로 확인했고, 둘 다 UP 상태가 된 시점을 서버가 다시 정상적으로 요청을 처리할 수 있는 상태라고 판단했습니다.
그 시점에 IndexedDB에 저장되어 있던 데이터를 가져와 실제 서버로 전송하도록 했습니다.
전송할 땐 pending 상태의 데이터를 가져와 요청을 시작하면 syncing 상태로 변경합니다. 정상적으로 처리된 데이터는 IndexedDB에서 제거하고, 요청에 실패한 경우에는 그대로 남겨 이후 재시도할 수 있도록 했습니다.
재시도하면서 생긴 문제
처음에는 요청에 실패하면 다시 보내면 된다고 생각했지만, 클라이언트에서 요청에 실패했다고 판단했다고 해서 서버에서도 실제 처리가 실패한 것은 아닐 수도 있었습니다.
예를 들어 클라이언트가 체크인 요청을 보낸 뒤 서버에서는 정상적으로 데이터를 저장했지만, 응답이 클라이언트에 도착하기 전에 연결에 문제가 생길 수 있습니다. 이런 경우 서버에는 이미 체크인 데이터가 저장되어 있지만 클라이언트는 정상적인 응답을 받지 못했기 때문에 요청에 실패했다고 판단합니다.
이 상태에서 같은 데이터를 다시 전송하면 하나의 체크인이 두 번 저장될 수 있습니다.
처음에는 서버에서 기존 체크인 데이터의 값을 비교해 중복 요청을 막는 방법을 생각했습니다. 같은 사용자에게 동일한 날짜와 시간의 기록이 이미 존재한다면 새로운 데이터를 저장하지 않는 방식입니다.
하지만 실제 운영 데이터를 확인해보니 같은 사용자가 짧은 시간 안에 다른 목적으로 시설을 이용하면서 새로운 체크인 기록이 추가되는 경우가 있었습니다. 방문 목적까지 함께 비교하는 방법도 생각했지만, 실제 데이터에는 이름, 시간, 방문 목적까지 같은 기록이 존재할 수 있어 체크인 데이터 자체만으로 하나의 요청을 유일하게 구분하기 어려웠습니다.
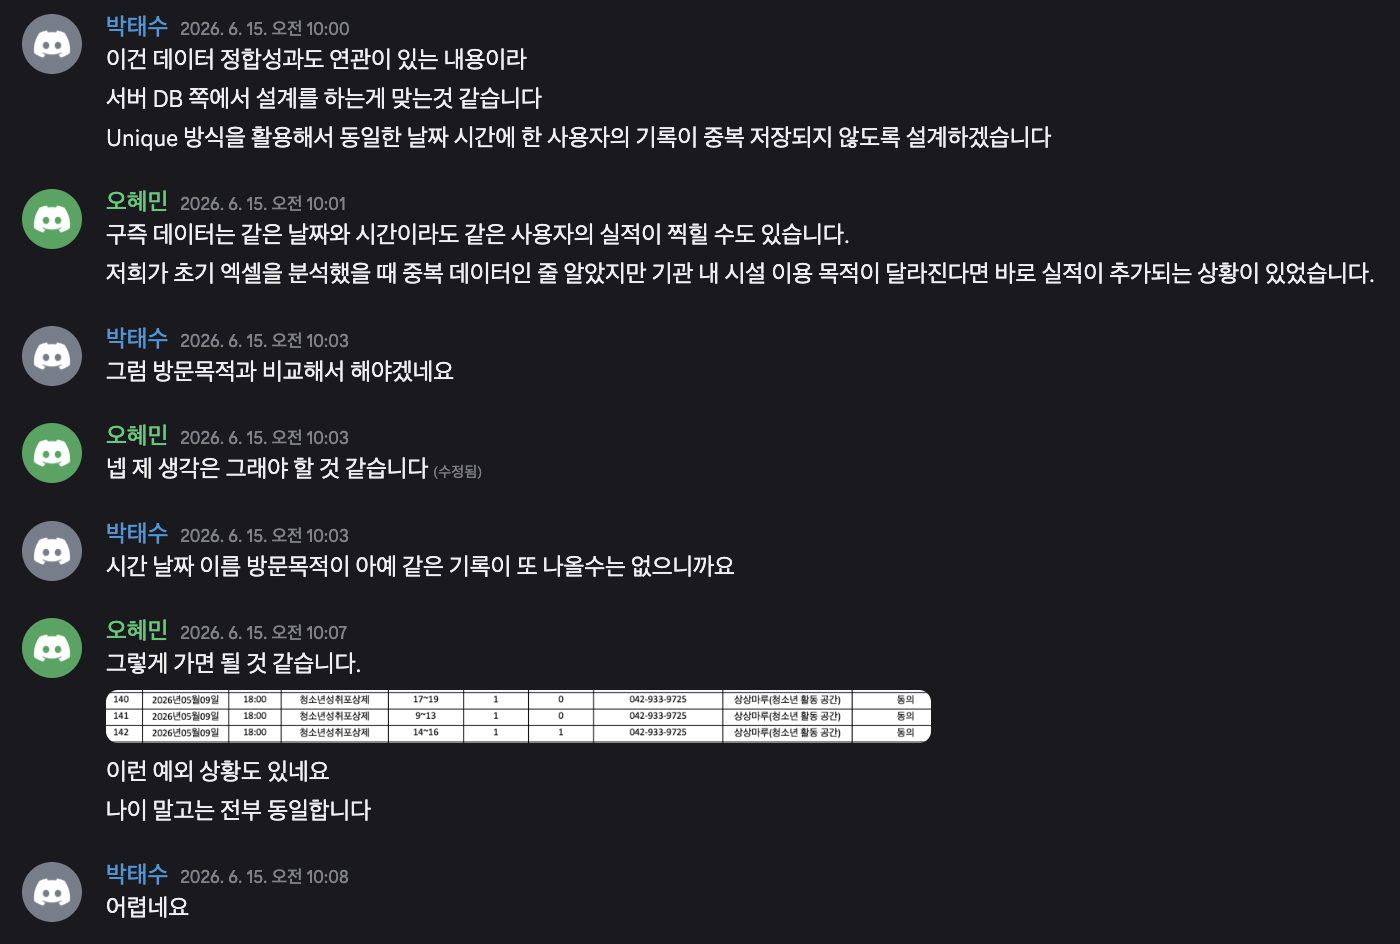
결국 기존 데이터에서 중복을 구분할 값을 찾기보다는 요청이 만들어질 때 각 요청에 고유한 값을 직접 부여하는 방식으로 방향을 바꿨습니다.
이를 위해 체크인 데이터를 처음 생성할 때 클라이언트에서 clientRecordId를 함께 생성합니다.
clientRecordId: string;재시도가 발생하더라도 새로운 clientRecordId를 만들지 않고 처음 생성한 값을 그대로 사용합니다.
서버에서는 이 값을 기준으로 이미 처리한 요청인지 확인하고, 동일한 clientRecordId가 다시 들어온 경우에는 새로운 체크인 데이터로 저장하지 않습니다.
결과적으로 클라이언트가 같은 요청을 여러 번 보내더라도 실제 체크인 데이터는 한 번만 반영되도록 만들었습니다.
동기화 도중 다시 실패한다면?
중복 요청 문제를 해결한 뒤에는 동기화 과정 자체가 다시 실패하는 경우도 고려해야 했습니다.
Health Check에서는 서버가 정상 상태였더라도 여러 건의 데이터를 동기화하는 도중 다시 서버에 문제가 생길 수 있습니다. 특정 체크인 데이터 자체를 처리하는 과정에서 오류가 발생할 가능성도 있었습니다.
그래서 IndexedDB에 저장된 요청마다 현재 동기화 상태를 함께 관리하도록 했습니다.
status: "pending" | "syncing" | "failed";처음 저장된 데이터는 pending 상태로 두고, 실제 서버로 전송하기 시작하면 syncing으로 변경합니다. 요청이 정상적으로 처리되면 해당 데이터는 IndexedDB에서 제거하고, 처리 중 오류가 발생하면 failed 상태로 변경합니다.
실패한 요청을 바로 삭제하지 않은 이유는 이후 다시 동기화를 시도하기 위해서였습니다.
이때 단순히 실패 여부만 저장하는 것이 아니라 몇 번의 시도가 있었는지 확인할 수 있도록 attemptCount를 함께 관리하고, 마지막으로 발생한 오류는 lastError에 기록합니다.
attemptCount: number;
lastError?: string;
이를 통해 어떤 요청이 계속해서 동기화에 실패하고 있는지 확인할 수 있고, 오류가 발생하더라도 데이터를 잃지 않은 채 다시 동기화를 시도할 수 있습니다.
결과적으로 하나의 체크인 데이터는 다음과 같은 상태를 거치게 됩니다.
pending → syncing → 성공 시 삭제
또는
pending → syncing → failed → 다시 동기화 시도
처음에는 서버가 복구되면 저장된 데이터를 다시 보내는 정도로 생각했지만, 실제로는 서버가 살아났는지 확인하는 것뿐만 아니라 재시도, 중복 요청, 동기화 실패까지 함께 고려해야 했습니다.
정리하며
돌아보면 이번 작업을 통해 세 가지를 다시 생각하게 됐습니다.
첫째, 서버가 멈췄다고 서비스까지 멈출 필요는 없었습니다.
서버 자체의 장애를 클라이언트에서 해결할 수는 없지만, 서버가 잠시 사용할 수 없다고 해서 사용자의 체크인까지 함께 멈출 필요는 없었습니다. 체크인 데이터는 먼저 받아두고, 서버가 복구된 뒤 반영하는 방식으로 둘 사이를 분리할 수 있었습니다.
둘째, 지금 판단할 수 없는 건 나중으로 미뤄도 됐습니다.
기존에는 체크인을 시작할 때 기존 회원인지 신규 회원인지 바로 판단해야 했습니다. 하지만 서버가 내려간 상황에서는 그 판단을 억지로 할 필요가 없었습니다. 필요한 정보를 먼저 받고, 서버가 다시 살아난 뒤 회원 여부를 확인하도록 시점을 미루면서 오프라인에서도 체크인을 이어갈 수 있었습니다.
셋째, 데이터를 저장하는 것보다 다시 보내는 과정이 더 어려웠습니다.
처음에는 IndexedDB에 데이터를 저장해두고 서버가 복구되면 다시 보내면 끝이라고 생각했지만 실제로는 서버가 언제 다시 살아났는지, 같은 요청이 중복으로 저장되지는 않는지, 동기화 도중 다시 실패하면 어떻게 처리할지까지 함께 고려해야 했습니다.
이번 작업을 하면서 오프라인 대응은 잠시 데이터를 저장해두는 문제가 아니라, 저장된 데이터를 언제, 어떤 기준으로, 얼마나 안전하게 다시 서버에 반영할 것인지까지 함께 설계해야 하는 문제라는 걸 알게 됐습니다.
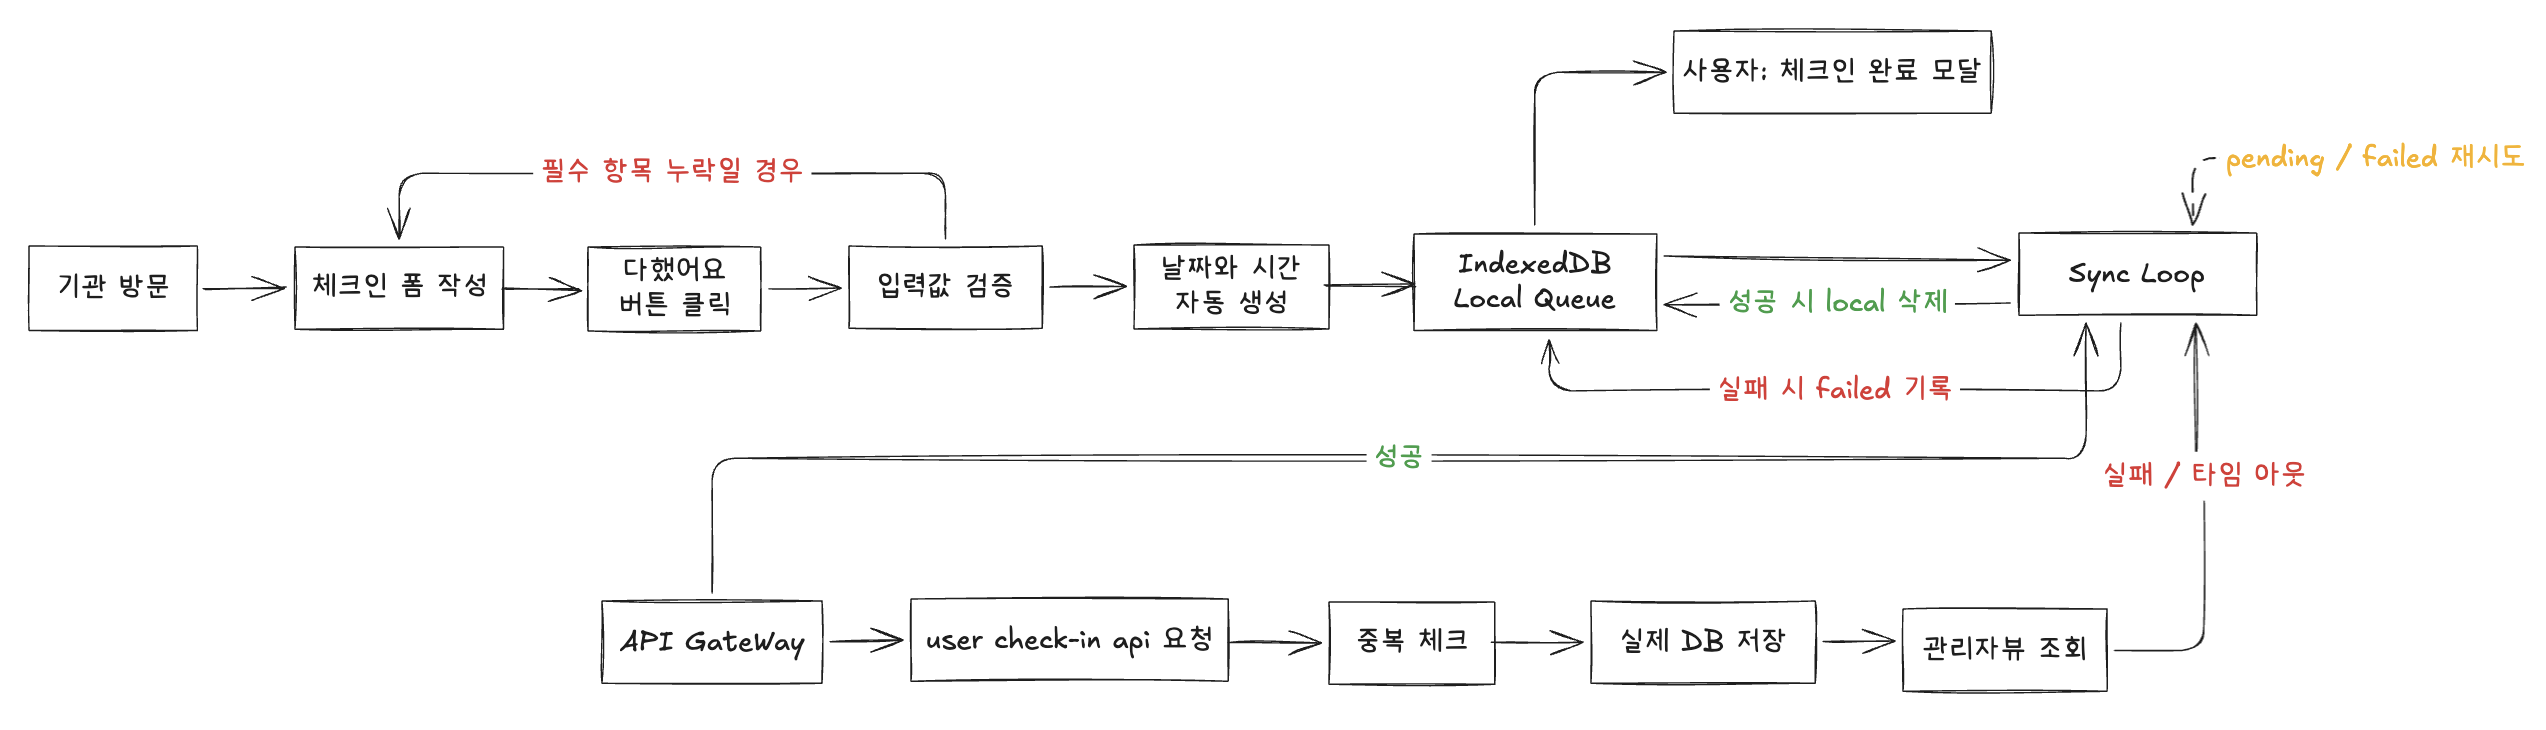 최종 다이어그램
여담
이 기능을 구축한 뒤 실제 운영 중 인터넷 연결이 끊기는 일이 있었습니다.
기관에서는 평소와 달리 이름만 입력하는 화면이 사라지고 다른 입력 화면이 나타난다는 연락이 왔습니다. 처음에는 오류가 발생한 줄 알았지만 확인해보니 서버 문제가 아니라 기관의 인터넷 연결 자체가 끊어진 상태였습니다.
다행히 페이지를 새로고침하지 않은 상태였기 때문에 이미 열려 있던 체크인 화면은 그대로 사용할 수 있었고, Health Check API 요청이 실패하면서 자동으로 오프라인 플로우로 전환되고 있었습니다. 확인해보니 인터넷이 끊겨 있던 시간 동안 들어온 체크인 요청들도 IndexedDB에 정상적으로 저장되어 있었습니다.
이후 인터넷 연결이 복구되면서 저장되어 있던 데이터도 다시 서버에 반영됐고, 기관에서도 별도의 수기 작성 없이 그대로 운영을 이어갈 수 있었습니다.
기능이 정상적으로 동작하는 것뿐만 아니라, 장애 상황에서 어떤 화면이 나타나고 어떻게 동작하는지 실제 운영하는 사람도 알고 있어야 한다는 점을 다시 생각하게 됐습니다.
설계할 당시에는 여러 장애 상황을 가정하면서 만든 기능이었는데, 실제 운영 중 문제가 발생했을 때 오프라인 플로우와 재동기화가 의도한 대로 동작하는 걸 직접 확인할 수 있었습니다. 실제 운영에서 설계한 구조가 문제를 막아주는 걸 보니 꽤 뿌듯했습니다.