대용량 쿼리와 엑셀 다운로드
대량의 쿼리를 조회해서 엑셀 다운로드를 하려면 어떻게 해야할까?
테스트 해보자.
테스트 데이터
https://github.com/datacharmer/test_db
2844047건이 있는 salaries 테이블을 사용할거다.
<select id="getSalaries" resultType="map">
  select *
  from salaries
  order by to_date
</select>
Apache Poi, Mybatis
https://poi.apache.org/components/spreadsheet/index.html
POI라이브러리에는 여러가지 Workbook이 있다.
HSSF / XSSF / SXSSF 이렇게 있는데, 대용량에 쓸만한건 스트림을 사용하는 SXSSF이다.
SXSSF는 임시파일(xml형식)을 사용하기때문에 OOM의 압박에서 벗어날 수 있다.
public class FileController {
    @GetMapping("/select")
    public void select(HttpServletResponse response) throws IOException {

        long start = System.currentTimeMillis();
        //마이바티스 핸들러(아래에 코드 있음)
        ExcelResultHandler excelResultHandler = new ExcelResultHandler();
        salariesMapper.getSalaries(excelResultHandler);

        int handleCnt = excelResultHandler.getHandleCnt(); //모든 로우 읽었는지 확인
        log.debug("handlecnt :{}", handleCnt);

        //파일 보내기
        response.setHeader("Content-Disposition", "attachment; filename=hello.xlsx");
        response.setContentType("application/vnd.openxmlformats-officedocument.spreadsheetml.sheet");
        excelResultHandler.saveFile(response.getOutputStream());

        long end = System.currentTimeMillis();
        log.debug("time : {}", (end - start));
    }
}
엄청 큰 쿼리 결과를 메모리에 가지고 있으면 역시 OOM이 발생할 수 있기때문에 마이바티스에서도 뭔가 해주겠다.
//마이바티스 result핸들러
class ExcelResultHandler implements ResultHandler<Map<String, Object>> {
    private SXSSFWorkbook workbook;
    private SXSSFSheet sheet;
    private int rowCnt;
    private int sheetCnt = 0;
    private int handleCnt = 0;
    public ExcelResultHandler() {
        workbook = new SXSSFWorkbook(1000);

        rowCnt = 0;
    }

    @Override
    public void handleResult(ResultContext<? extends Map<String, Object>> resultContext) {
        handleCnt++;
        Map<String, Object> resultMap = resultContext.getResultObject();
        if (rowCnt % 1048575 == 0) {
            rowCnt = 0;
            sheet = workbook.createSheet("sheet" + sheetCnt++);
        }

        SXSSFRow row = sheet.createRow(rowCnt++);

        row.createCell(0).setCellValue(String.valueOf(resultMap.get("emp_no")));
        row.createCell(1).setCellValue(String.valueOf(resultMap.get("salary")));
        row.createCell(2).setCellValue((java.sql.Date) resultMap.get("from_date"));
        row.createCell(3).setCellValue((java.sql.Date) resultMap.get("to_date"));

    }

    public void saveFile(OutputStream stream) throws IOException {

        workbook.write(stream);
        stream.close();
        workbook.close();
    }

    public int getHandleCnt() {
        return handleCnt;
    }
}
마이바티스의 ResultHandler를 구현한 클래스를 하나 만들었다.
handleResult()는 하나의 로우마다 실행되는 함수다. 즉 로우를 읽을때마다 엑셀에 추가하는것이다.
엑셀의 최대 로우는 1048575개인데 데이터셋은 이를 넘기때문에 이와 관련된 코드도 넣어놨다.
mybatis fetchSize 사용하기
mybatis에는 fetchSize를 사용해 읽어오는 데이터 개수를 지정할 수 있다.
페이징 처리해서 불러오는것도 가능하겠지만 테스트니깐 간편하게 가려한다.
fetchSize x
일단 fetchSize없이 실행한 결과다.
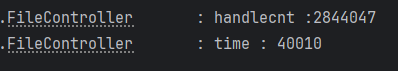
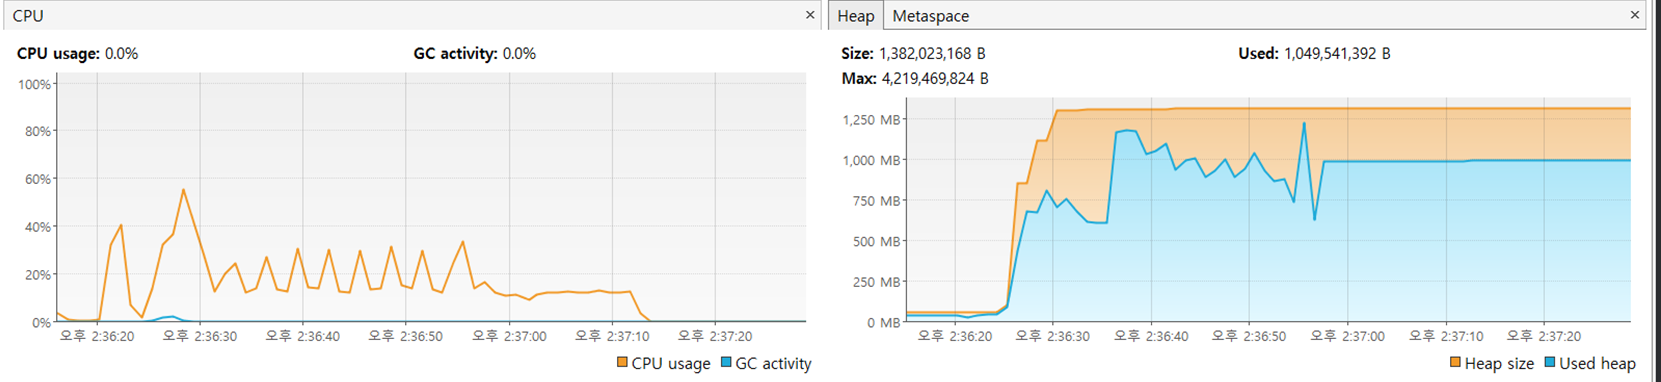
40010밀리초 소요되었다
메모리도 1000메가 넘게 후루룩짭짭 하신다.
fetchSize = 10000
통 크게 fetchSize를 10000으로 변경해보면
<select id="getSalaries" resultType="map" fetchSize="10000">
  select *
  from salaries
  order by to_date
</select>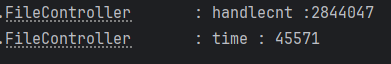
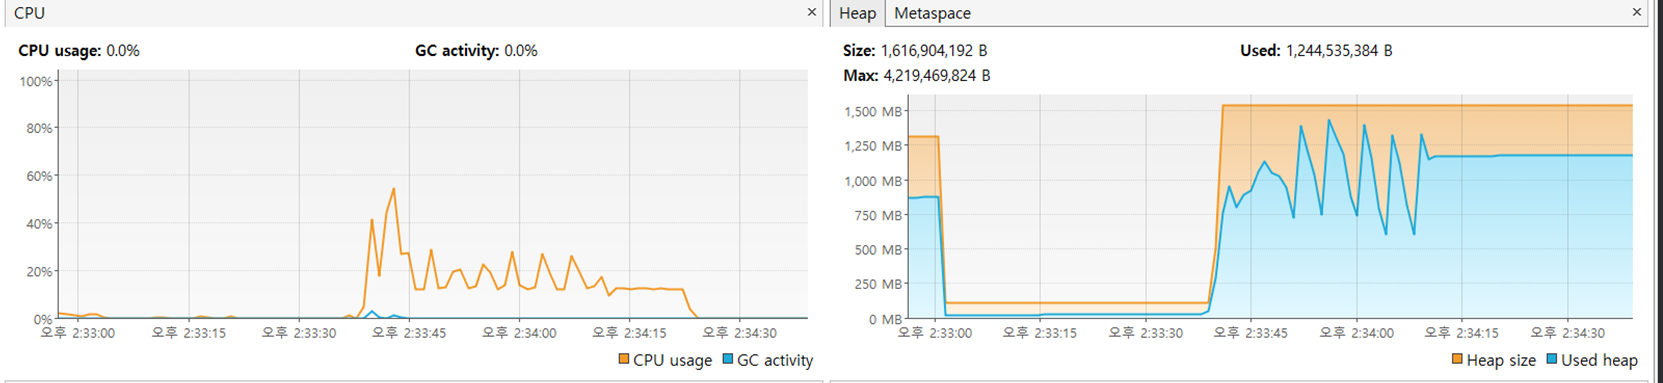
45571 밀리초다. 메모리도 크게 차이나진 않는다.
fetchSize 된건가?
이상해서 값을 찍어봤다.
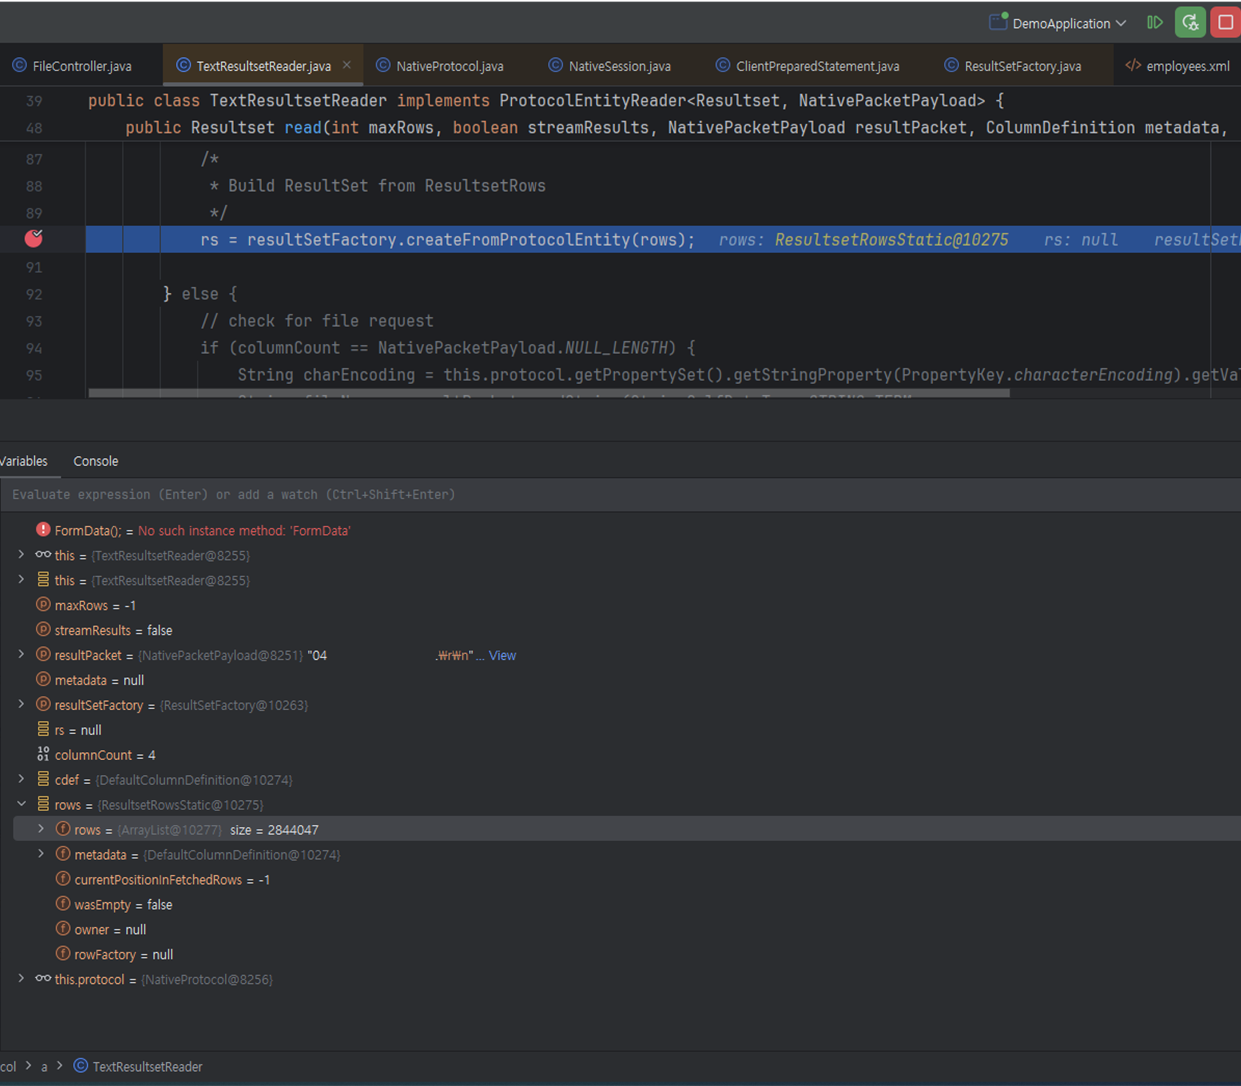
쿼리 결과를 타고 타고 들어가다보면 rows가 2844047 즉, 전체 쿼리를 조회했다는것을 볼 수 있다.
fetchSize가 안된 이유
원인은 mysql jdbc 공식 문서에서 찾을 수 있었다.
https://dev.mysql.com/doc/connector-j/en/connector-j-reference-implementation-notes.html
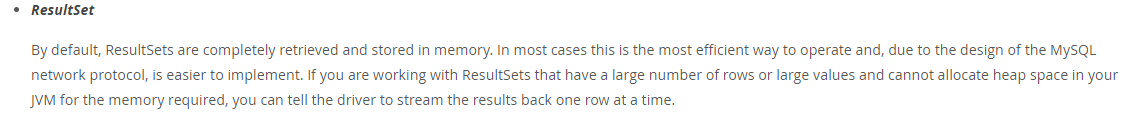
resultset부분을 보면 기본적으로 모든 내용을 저장한다고 적혀있다.
드라이버 자체에서 그래버리는데 백날 마이바티스에서 설정하나 마나였던거다.
문서에서는 두가지 방법을 제시하는데, 좀 더 간단해보이는 커서 기반 스트리밍을 사용하는 useCursorFetch를 사용해보려한다.
적용
db 프로퍼티에 useCursorFetch=true를 추가해준다.
# 기존
spring.datasource.url=jdbc:log4jdbc:mysql://localhost:3310/employees?useSSL=false&useUnicode=true&serverTimezone=Asia/Seoul

# 수정
spring.datasource.url=jdbc:log4jdbc:mysql://localhost:3310/employees?useCursorFetch=true&useSSL=false&useUnicode=true&serverTimezone=Asia/Seoul
실행해보면
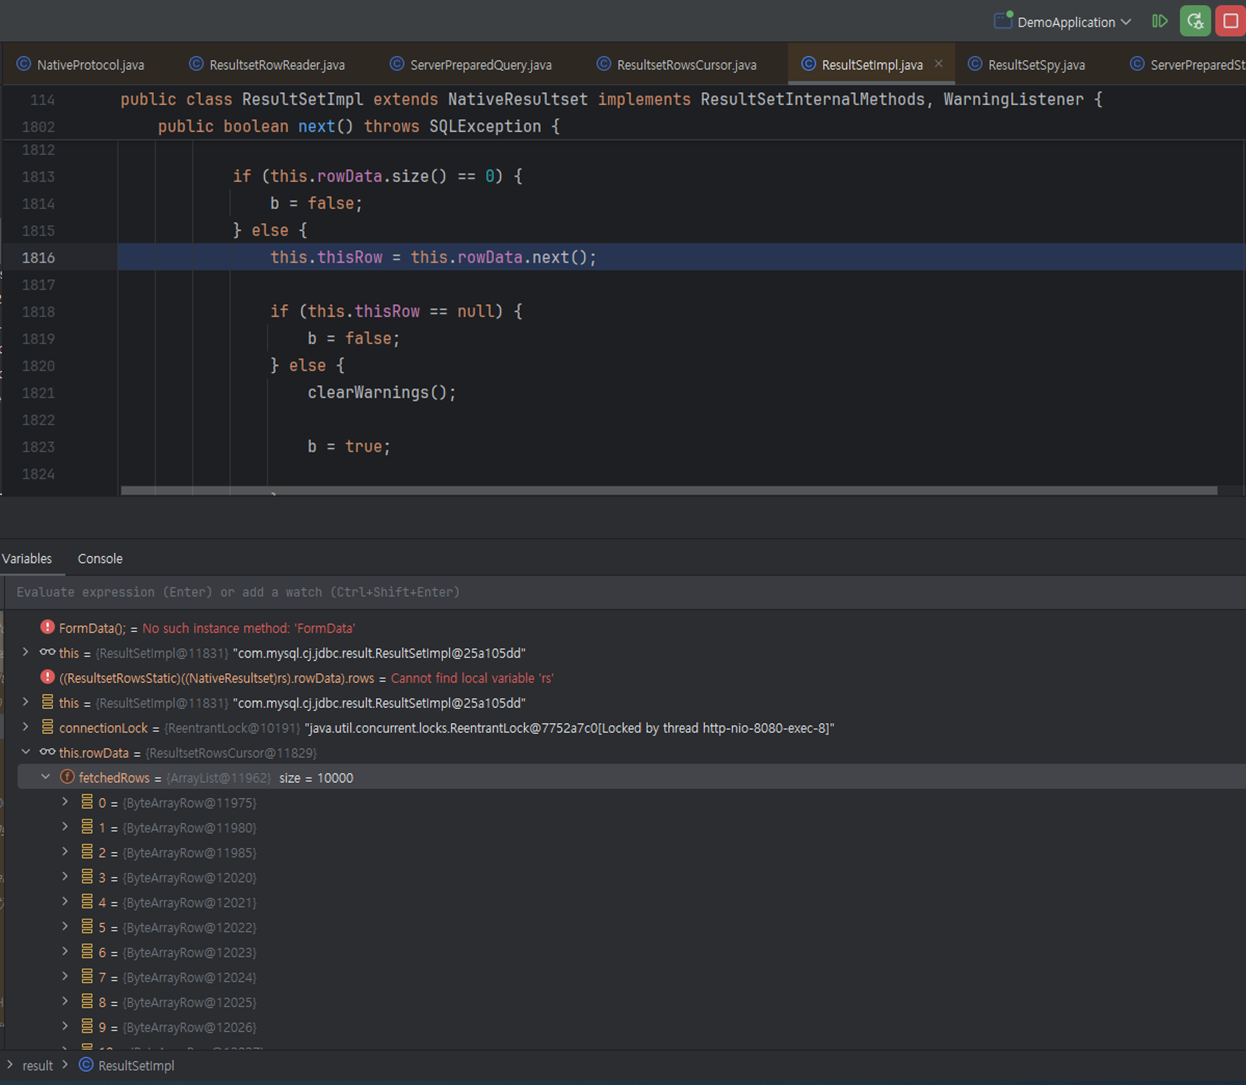
값이 들어있는 클래스도 다르고, fetchSize로 지정해둔 10000이 찍히는걸 볼 수 있다.
fetchSize는 잘 적용되는거같으니 한번 테스트해보자
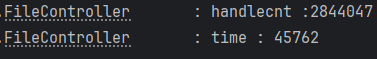
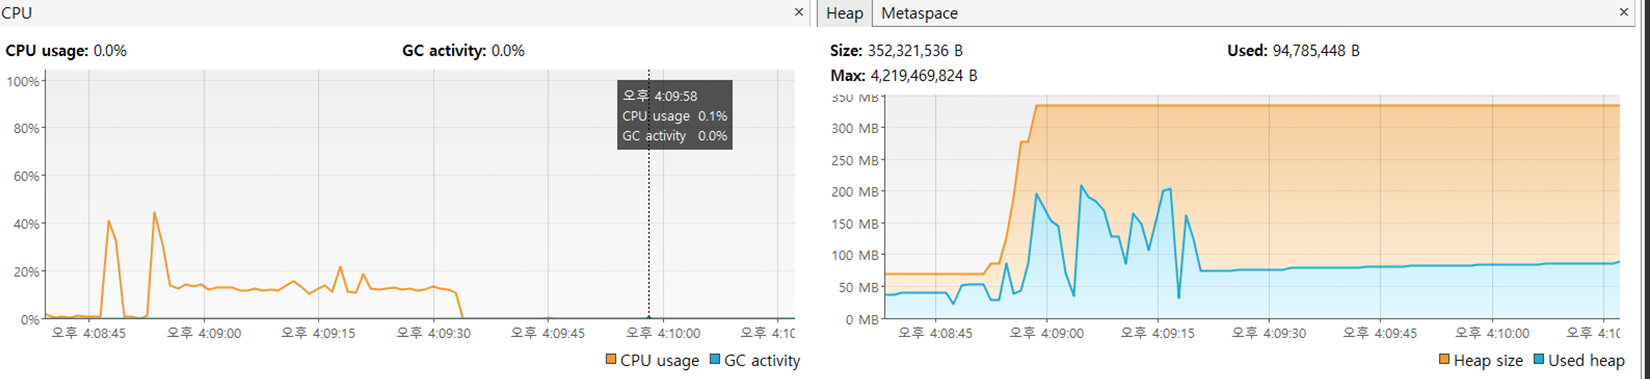
엥 아까랑 비슷하게 나온다. 의미 없는거였나?
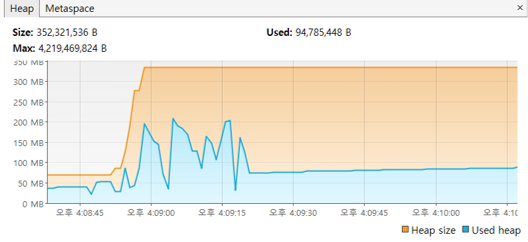
물론 아니다. 자세히 보면 시간은 비슷해도 사용하는 메모리는 1/10 수준이다.
다만 시간이 조금 아쉬운데 이거는 fetch가 잘 안된걸까?
fetchSize를 10으로 해서 돌려보면
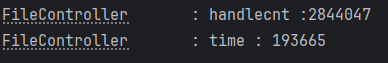
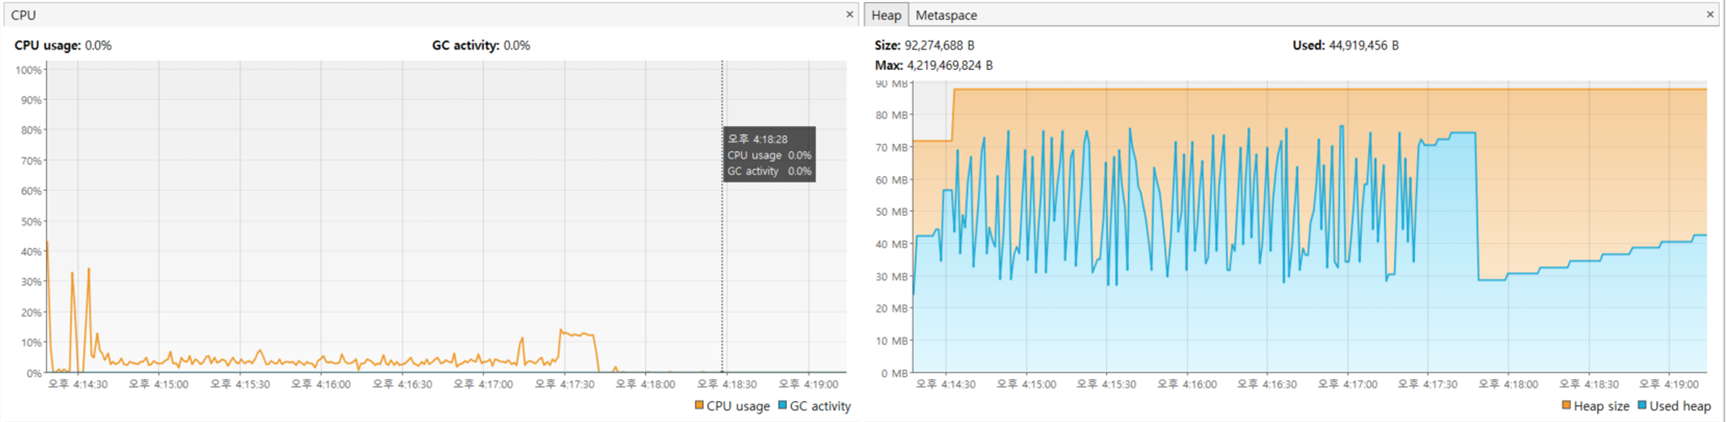
4배나 더 긴 시간이 나와버린다.
물론 그만큼 메모리는 훨씬 덜 차지한다.
그래도 너무 오래걸려서 쓸 수는 없을거같다.
최적의 값은 실제 서버에서 테스트하면서 찾아갈 수 밖에 없을거같다.
