1. 오늘의 한 줄 요약
GROUP BY와 윈도우 함수의 차이를 이해하고, 여러 테이블을 JOIN하여 필요한 데이터를 하나의 결과로 조회하는 방법을 학습했다.
오늘은 어제 배운 집계 함수에서 한 단계 더 나아가 그룹별 집계, 순위 계산, 계층별 집계를 실습했다. 이후 정규화를 간단히 살펴보고 관계형 데이터베이스의 핵심인 JOIN을 배웠다.
2. 배운 내용
핵심 개념
GROUP BY와 HAVING
GROUP BY는 특정 컬럼의 값이 같은 행을 하나의 그룹으로 묶어 집계할 때 사용한다.
SELECT USER_ID,
       SUM(PRICE * AMOUNT) AS TOTAL
FROM BUY_TBL
GROUP BY USER_ID;
사용자별 총구매액이 100 이상인 사용자만 조회하려면 HAVING을 사용한다.
SELECT USER_ID,
       SUM(PRICE * AMOUNT) AS TOTAL
FROM BUY_TBL
GROUP BY USER_ID
HAVING SUM(PRICE * AMOUNT) >= 100;WHERE는 그룹화하기 전의 행에 조건을 적용한다.HAVING은GROUP BY로 만들어진 집계 결과에 조건을 적용한다.
표준 SQL에서는 GROUP BY를 사용했을 때 일반 컬럼을 SELECT절에 작성하려면 해당 컬럼도 GROUP BY에 포함해야 한다.
MariaDB 설정에 따라 그룹화하지 않은 컬럼도 조회될 수 있지만, 어떤 행의 값이 선택될지 보장할 수 없으므로 의존하면 안 된다.
WITH ROLLUP
WITH ROLLUP은 그룹별 결과뿐만 아니라 중간 합계와 전체 합계까지 함께 반환한다.
SELECT GROUP_NAME,
       NUM,
       SUM(PRICE * AMOUNT) AS TOTAL
FROM BUY_TBL
GROUP BY GROUP_NAME, NUM WITH ROLLUP;GROUP_NAME과 NUM으로 집계하면 다음 단계의 결과를 한 번에 얻을 수 있다.
- 그룹명과 상품별 합계
- 그룹명별 중간 합계
- 전체 합계
ROLLUP으로 생성된 소계와 총계 행에서는 그룹 컬럼이 NULL로 표시될 수 있다.
윈도우 함수
일반 집계 함수는 여러 행을 하나의 행으로 줄이지만, 윈도우 함수는 기존 행을 유지하면서 집계 결과나 순위를 추가한다.
SELECT EMP_NAME,
       SALARY,
       DEPT_ID,
       AVG(SALARY) OVER (
           PARTITION BY DEPT_ID
       ) AS DAVG
FROM EMPLOYEE;
각 사원 행을 그대로 유지하면서 해당 사원이 소속된 부서의 평균 급여가 함께 출력된다.
순위 함수
SELECT EMP_NAME,
       SALARY,
       RANK() OVER (
           ORDER BY SALARY DESC
       ) AS 급여순위
FROM EMPLOYEE;
부서마다 급여 순위를 따로 계산하려면 PARTITION BY를 추가한다.
SELECT EMP_NAME,
       DEPT_ID,
       SALARY,
       RANK() OVER (
           PARTITION BY DEPT_ID
           ORDER BY SALARY DESC
       ) AS 부서급여순위
FROM EMPLOYEE;
순위 함수의 차이는 다음과 같다.
| 함수 | 동점자 처리 |
|---|---|
RANK() | 같은 순위를 부여하고 다음 순위를 건너뛴다. |
DENSE_RANK() | 같은 순위를 부여하지만 다음 순위를 건너뛰지 않는다. |
ROW_NUMBER() | 동점이어도 각 행에 서로 다른 번호를 부여한다. |
ROW_NUMBER()의 순서를 확실하게 만들려면 동점일 때 사용할 추가 정렬 조건을 작성하는 것이 좋다.
ROW_NUMBER() OVER (
    ORDER BY SALARY DESC, EMP_NO ASC
)
정규화
정규화는 중복 데이터를 줄이고 데이터의 삽입·수정·삭제 과정에서 발생할 수 있는 이상 현상을 방지하기 위해 테이블을 분리하는 과정이다.
- 제1정규형: 컬럼에는 하나의 원자값만 저장한다.
- 제2정규형: 복합키를 사용한다면 일반 컬럼은 복합키 전체에 의존해야 한다.
- 제3정규형: 기본키가 아닌 컬럼끼리 의존하지 않도록 분리한다.
예를 들어 과정 테이블에 교재1, 교재2, 교재3 컬럼을 계속 추가하면 반복되는 컬럼이 생긴다. 이를 과정 테이블과 과정별 교재 테이블로 나누면 새로운 교재가 추가돼도 테이블 구조를 변경하지 않아도 된다.
또한 개념적으로 N:M인 관계는 실제 테이블을 설계할 때 중간 테이블을 만들어 1:N, N:1 관계로 풀어야 한다.
JOIN
JOIN은 둘 이상의 테이블을 관계에 따라 연결하여 하나의 결과 집합을 만드는 문법이다.
SELECT E.EMP_NAME,
       D.DEPT_NAME
FROM EMPLOYEE E
JOIN DEPARTMENT D
  ON E.DEPT_ID = D.DEPT_ID;
ON과 USING
ON은 서로 다른 이름의 컬럼이나 비교 조건을 자유롭게 작성할 수 있다.
SELECT E.EMP_NAME,
       D.DEPT_NAME
FROM EMPLOYEE E
JOIN DEPARTMENT D
ON E.DEPT_ID = D.DEPT_ID;USING은 두 테이블에서 연결할 컬럼 이름이 같을 때 사용할 수 있다.
SELECT EMP_NAME,
       DEPT_NAME
FROM EMPLOYEE
JOIN DEPARTMENT USING (DEPT_ID);
여러 테이블도 연속으로 연결할 수 있다.
SELECT E.EMP_NAME,
       J.JOB_TITLE,
       D.DEPT_NAME,
       L.LOC_DESCRIBE,
       C.COUNTRY_NAME
FROM JOB J
JOIN EMPLOYEE E
  ON J.JOB_ID = E.JOB_ID
JOIN DEPARTMENT D
  ON D.DEPT_ID = E.DEPT_ID
JOIN LOCATION L
  ON L.LOCATION_ID = D.LOC_ID
JOIN COUNTRY C
  ON C.COUNTRY_ID = L.COUNTRY_ID;
비등가 조인
조인 조건에는 반드시 =만 사용해야 하는 것은 아니다.
SELECT E.EMP_NAME,
       E.SALARY,
       S.SLEVEL
FROM EMPLOYEE E
JOIN SAL_GRADE S
  ON E.SALARY BETWEEN S.LOWEST AND S.HIGHEST;
급여 등급처럼 직접 연결된 외래키가 없어도 값의 범위를 이용하여 조인할 수 있다.
OUTER JOIN
부서를 배정받지 않은 사원까지 조회하려면 LEFT JOIN을 사용한다.
SELECT E.EMP_NAME,
       D.DEPT_NAME
FROM EMPLOYEE E
LEFT JOIN DEPARTMENT D
  ON E.DEPT_ID = D.DEPT_ID
WHERE D.DEPT_ID IS NULL;
SELF JOIN
사원과 사수의 정보처럼 하나의 테이블을 자기 자신과 연결할 수도 있다.
SELECT E.EMP_NAME AS 사원이름,
       M.EMP_NAME AS 사수이름
FROM EMPLOYEE E
LEFT JOIN EMPLOYEE M
  ON E.MGR_ID = M.EMP_NO;
새롭게 알게 된 점
- 윈도우 함수는 집계 결과를 구하면서도 원래 행을 유지한다.
PARTITION BY를 사용하면 부서별로 윈도우를 나눌 수 있다.- 조인 조건에는
=뿐만 아니라BETWEEN등의 조건도 사용할 수 있다. LEFT JOIN을 사용하면 상대 테이블에 연결된 데이터가 없는 행도 조회할 수 있다.WITH ROLLUP을 사용하면 세부 집계, 중간 합계, 전체 합계를 한 번에 구할 수 있다.
헷갈렸던 점
GROUP BY와 윈도우 함수가 모두 그룹별 평균이나 순위를 계산할 수 있어서 차이가 헷갈렸다.
정리하면 GROUP BY는 여러 행을 그룹별 결과 하나로 줄이고, 윈도우 함수는 기존 행을 유지하면서 각 행 옆에 계산 결과를 추가한다.
3. 실습 / 적용
직접 해본 것
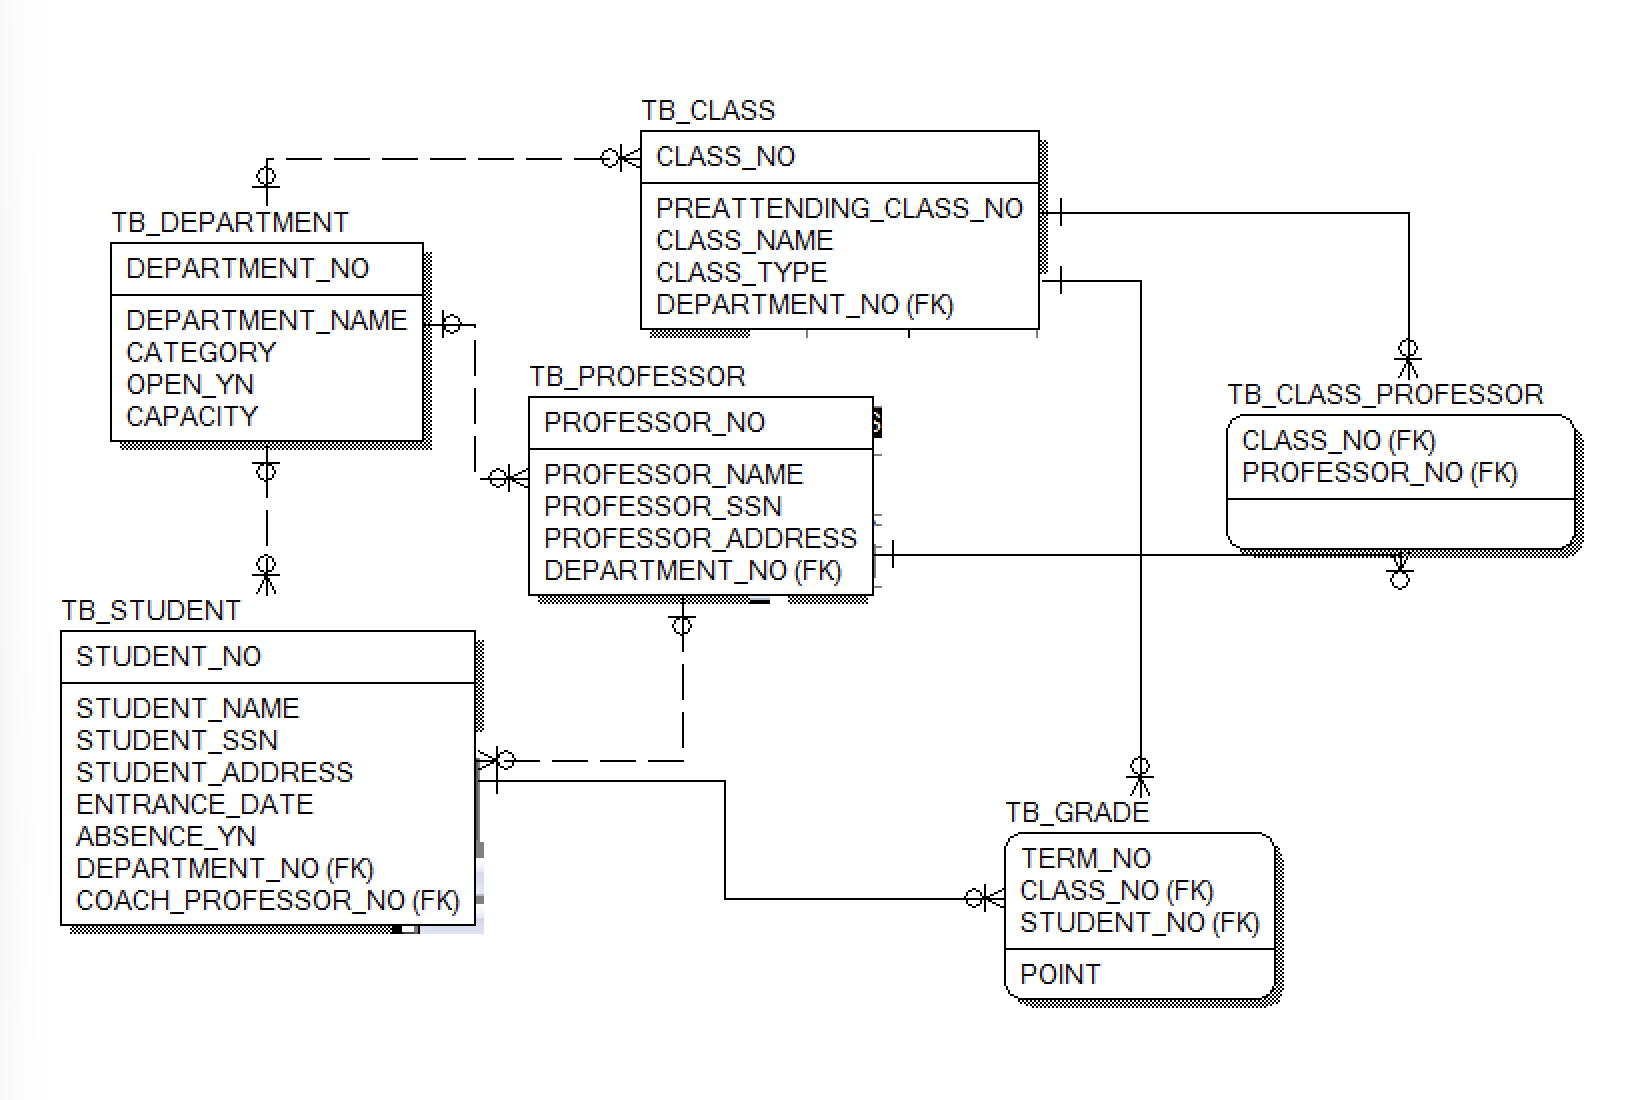
10번. 학과별 학생 수 구하기
SELECT DEPARTMENT_NO AS 학과번호,
       COUNT(*) AS `학생수(명)`
FROM TB_STUDENT
GROUP BY DEPARTMENT_NO;
12번. 학생의 연도별 평점 구하기
SELECT SUBSTRING(TERM_NO, 1, 4) AS 년도,
       ROUND(AVG(POINT), 1) AS `년도 별 평점`
FROM TB_GRADE
WHERE STUDENT_NO = 'A112113'
GROUP BY SUBSTRING(TERM_NO, 1, 4)
ORDER BY 년도;
13번. 학과별 휴학생 수 구하기
SELECT DEPARTMENT_NO AS 학과코드명,
       COUNT(
           CASE
               WHEN ABSENCE_YN = 'Y' THEN 1
           END
       ) AS `휴학생 수`
FROM TB_STUDENT
GROUP BY DEPARTMENT_NO;
CASE 조건을 만족하지 않으면 NULL이 반환되고, COUNT()가 NULL을 제외하기 때문에 휴학생만 집계된다.
14번. 동명이인 학생 찾기
처음에는 학생 테이블을 자기 자신과 조인했지만, 이름별 인원수를 구하는 문제이므로 GROUP BY와 HAVING만 사용하는 편이 더 단순했다.
SELECT STUDENT_NAME AS 동일이름,
       COUNT(*) AS `동명인 수`
FROM TB_STUDENT
GROUP BY STUDENT_NAME
HAVING COUNT(*) >= 2
ORDER BY STUDENT_NAME;
셀프 조인은 같은 이름이 세 명 이상일 때 조합이 중복되어 실제 사람 수보다 큰 값이 나올 수 있다.
15번. 연도·학기별 평점과 누적 평점 구하기
SELECT SUBSTRING(TERM_NO, 1, 4) AS 년도,
       SUBSTRING(TERM_NO, 5, 2) AS 학기,
       ROUND(AVG(POINT), 1) AS 평점
FROM TB_GRADE
WHERE STUDENT_NO = 'A112113'
GROUP BY
    SUBSTRING(TERM_NO, 1, 4),
    SUBSTRING(TERM_NO, 5, 2)
WITH ROLLUP;
WITH ROLLUP으로 다음 결과를 한 번에 구할 수 있었다.
- 연도·학기별 평점
- 연도별 누적 평점
- 전체 학기 총평점
결과
그룹화와 조인을 사용해 여러 테이블에 나누어 저장된 데이터를 하나의 조회 결과로 만들 수 있었다.
특히 윈도우 함수는 일반 집계 함수와 달리 사원별 행을 유지한 상태에서 부서 평균이나 순위를 보여줄 수 있다는 점이 인상적이었다.
4. 문제와 해결
막힌 부분
구매 이력이 있는 회원의 정보를 조회하는 과정에서 다음과 같이 조인 조건을 작성했다.
JOIN BUY_TBL B
  ON B.USER_ID <> U.USER_ID
이 조건은 같은 사용자가 아니라 서로 다른 사용자를 연결한다. 따라서 구매자와 관계없는 다른 회원 정보가 대량으로 결합되는 잘못된 결과가 만들어진다.
해결 방법
구매 내역의 사용자와 회원 테이블의 사용자를 연결하려면 동등 비교를 사용해야 한다.
SELECT U.USER_ID,
       U.NAME,
       B.PROD_NAME,
       U.ADDR,
       CONCAT(U.MOBILE1, '-', U.MOBILE2) AS 연락처
FROM USER_TBL U
JOIN BUY_TBL B
  ON B.USER_ID = U.USER_ID;
구매 이력의 존재 여부만 확인하려면 EXISTS를 사용할 수도 있다.
SELECT U.USER_ID,
       U.NAME,
       U.ADDR
FROM USER_TBL U
WHERE EXISTS (
    SELECT 1
    FROM BUY_TBL B
    WHERE B.USER_ID = U.USER_ID
);JOIN은 구매 상품까지 함께 조회할 때 사용하고, EXISTS는 구매 이력이 존재하는지만 확인할 때 적합하다.
5. 다음에 할 일
- 서브쿼리와 상관 서브쿼리 구조 이해하기
-
JOIN과EXISTS로 같은 문제를 풀어 결과 차이 확인하기 -
RANK(),DENSE_RANK(),ROW_NUMBER()의 동점자 처리 비교하기 -
ROLLUP으로 생성된 소계와 총계 행을 알아보기 쉽게 표시하기
공식 문서: MariaDB 윈도우 함수, RANK 함수, JOIN 문법, SELECT·GROUP BY 문법