문제이해
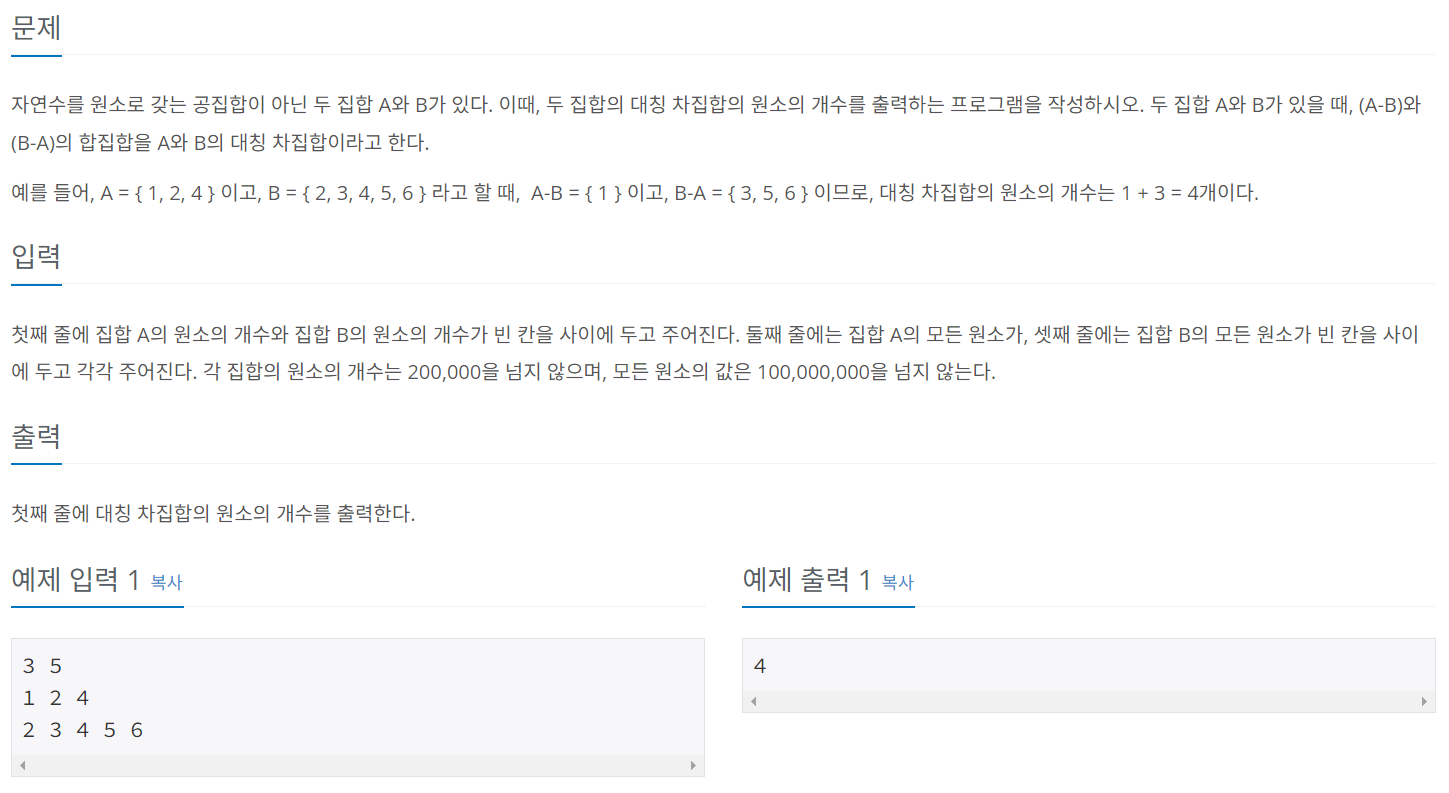
- 이 문제는 두 원소의 갯수를 차례로 입력받고, 입력으로 주어진 원소에서 대칭차집합의 갯수를 구하는 원소입니다.
입력
- 입력으로 집합의 원소의 갯수 N과 M이 주어집니다.
- 이후, 각각 N개의 원소, M개의 원소가 두줄의 입력으로 주어집니다.
출력
- 두 집합의 대칭차집합의 원소의 갯수를 구하면 됩니다.
문제접근
- 단일원소를 처리하므로, HashSet을 선언하여 이용해주었습니다.
입력 값 파싱
- 입력을 위해 BufferedReader를 이용했습니다.
- 값을 토큰단위로 분리해 주기 위해, StringTokenizer를 이용해주었습니다.
StringTokenizer 주의
StringTokenizer 선언과 이용법
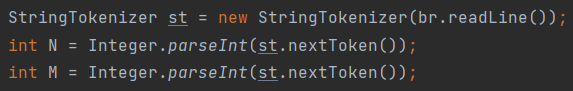
StringTokenizer은 한번에 한줄의 문자열을 토큰화 하므로, 각 입력라인을 별도로 읽고 처리해야 합니다.
그러므로, 입력을 받을 때 마다 새로운 StringTokeizer를 생성해 주어야 합니다.
세 라인으로 이루어져있고, 공백기준으로 분리하여 set에 넣어주어야 합니다.
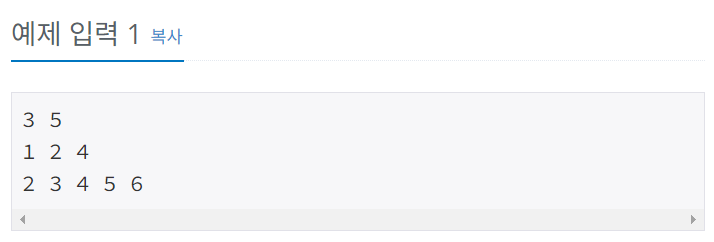
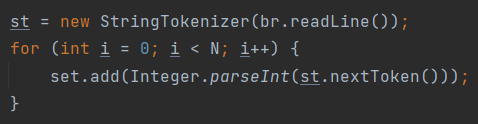
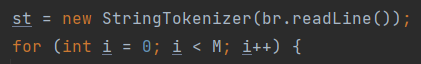
세 라인이 주어지고, 각각의 라인에 해당하는 StringTokenizer선언은 아래와 같이 해주었습니다.
차집합을 위한 조건문
간단한 if-else문으로 중복되는 원소를 처리해주면 됩니다.
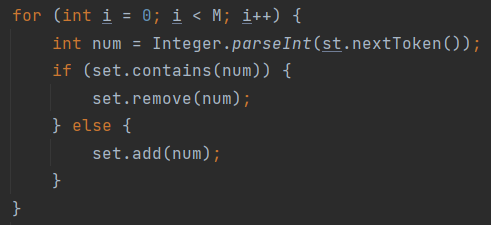
중복되는 요소는 set에서 remove하고, 중복되지 않는 요소는 add해주면 됩니다.
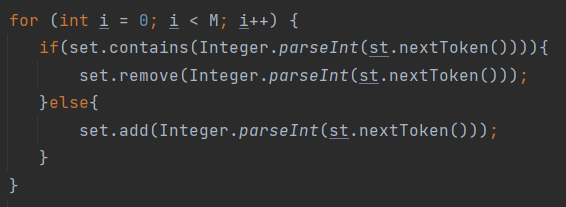
여기서 중요한건, StringTokenizer를 선언 한 이후에, st.nextToken()을 여러번 써버리면 오류가 납니다.
예를들어 입력라인에 1 2 3 4 가 들어왔다고 해봅시다. 그렇게 되면 for 문에서 1, if문에서 2, else문에서 3을 가져오게 됩니다.
아래처럼 쓴다면 위와 같은 이유로 에러가 납니다.
code
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.IOException;
import java.util.*;

public class Main {
    public static void main(String[] args) throws IOException {
        BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
        StringTokenizer st = new StringTokenizer(br.readLine());
        int N = Integer.parseInt(st.nextToken());
        int M = Integer.parseInt(st.nextToken());
        HashSet<Integer> set = new HashSet<>();

        st = new StringTokenizer(br.readLine());
        for (int i = 0; i < N; i++) {
            set.add(Integer.parseInt(st.nextToken()));
        }

        st = new StringTokenizer(br.readLine());
        for (int i = 0; i < M; i++) {
            int num = Integer.parseInt(st.nextToken());
            if (set.contains(num)) {
                set.remove(num);
            } else {
                set.add(num);
            }
        }
           System.out.println(set.size());

    }

}