문제이해
뭐야 왜 50점줘요
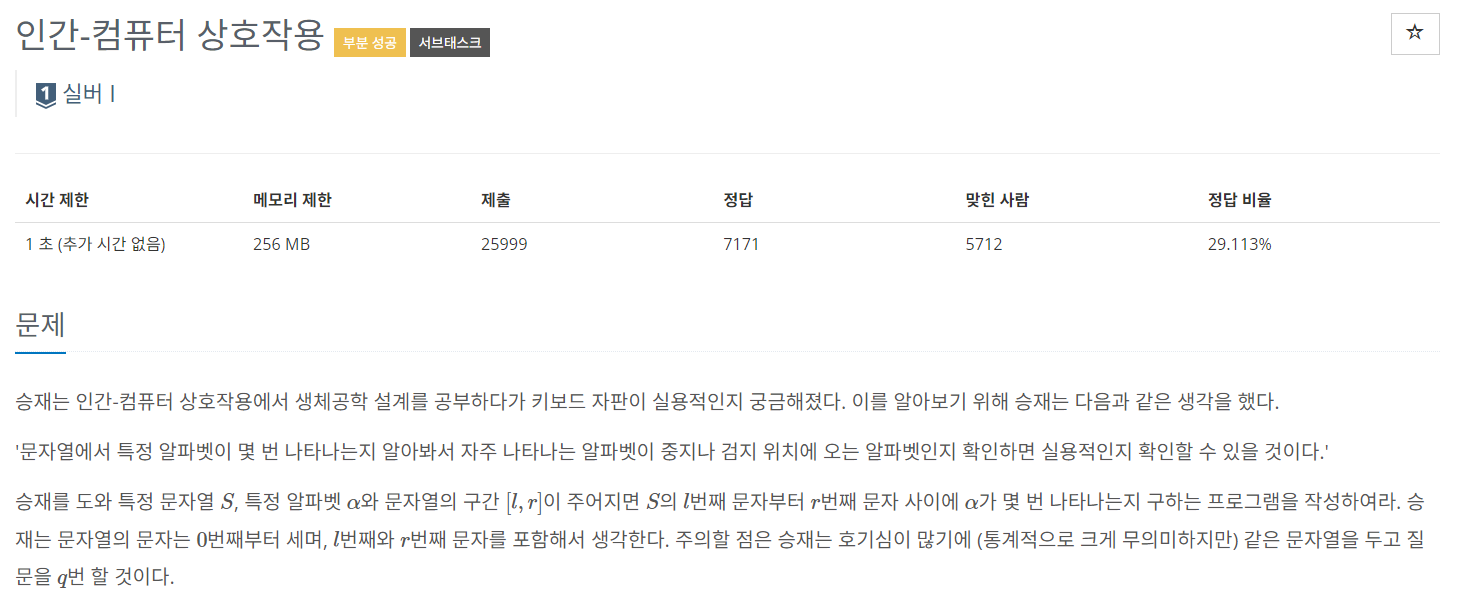
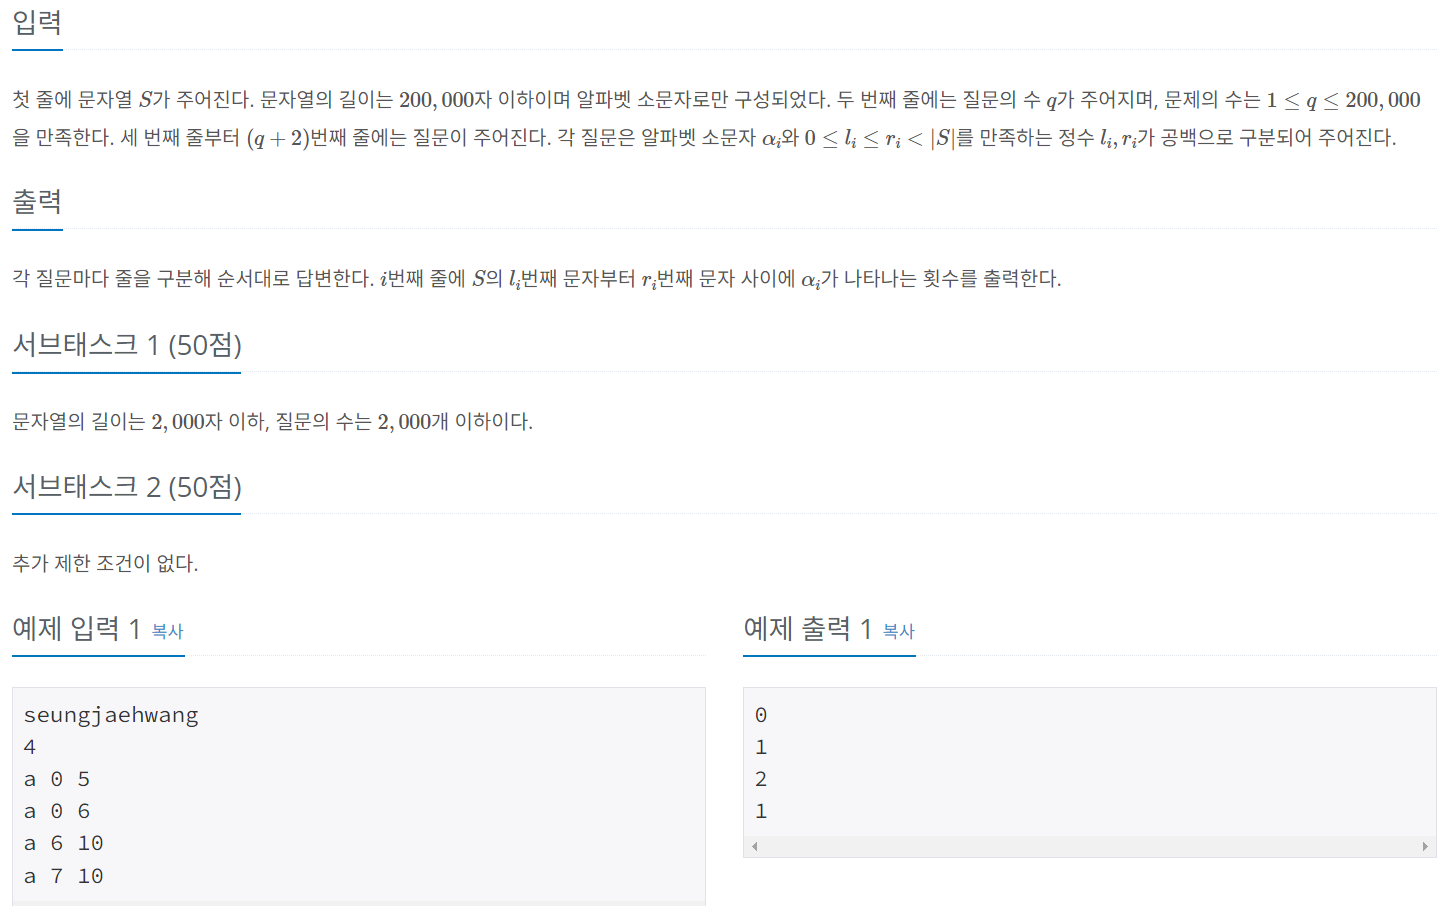
이 문제는 문자열을 입력받고, 문자열의 특정 인덱스 l과 r 사이에서, 특정 알파벳이 출현되는 빈도를 구하여 케이스 별로 출력하는 문제입니다.
이때, 문자열의 문자는 0번째부터 세며, l번째와 r번째 문자를 포함해서 생각합니다.
이 문제는 서브테스크가 존재합니다.
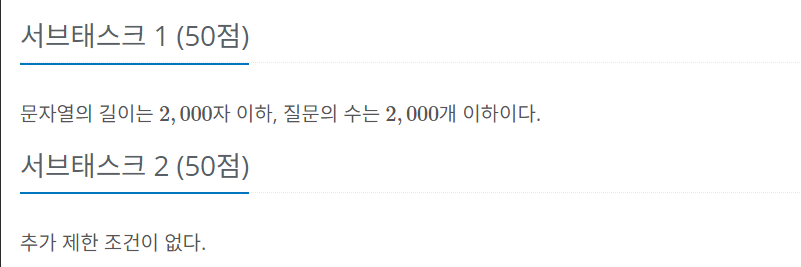
일반적으로 문자열을 입력받은 후, 각 질문마다 문자열을 처음부터 끝까지 순회하여 특정 문자의 개수를 세는 방식으로 문제를 풀면, 최악의 경우 문자열의 길이가 2000자이고 질문의 수가 2000개일 때, 시간 제한인 1초 내에 문제를 해결할 수 없습니다.
위의 조건을 해결하지 못하면 50점만 받는 문제입니다.
문제풀이( 3가지 sol )
- 입력받은 문자열을 char배열로 받아 각각을 비교하여 카운트해주는 방법(50점)
code
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.IOException;
import java.util.StringTokenizer;

public class Main {
    static char[] arr;

    public static void main(String[] args) throws IOException {
        BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
        StringTokenizer st;

        String input = br.readLine();
        arr = input.toCharArray();

        int n = Integer.parseInt(br.readLine());
        StringBuilder sb = new StringBuilder();

        for (int i = 0; i < n; i++) {
            st = new StringTokenizer(br.readLine());
            char find = st.nextToken().charAt(0);
            int firstIdx = Integer.parseInt(st.nextToken());
            int lastIdx = Integer.parseInt(st.nextToken());

            int count = solution(find, firstIdx, lastIdx);
            sb.append(count).append("\n");
        }

        System.out.println(sb);
    }

// 같은 경우에 count++
    private static int solution(char find, int firstIdx, int lastIdx) {
        int count = 0;
        for (int i = firstIdx; i <= lastIdx; i++) {
            if (arr[i] == find) {
                count++;
            }
        }
        return count;
    }
}
위의 코드는 문자열의 길이가 길어지고, 쿼리의 수가 많아지면 모든 문자열을 탐색하며 카운트 하기 때문에 제한된 실행시간인 1초 내에 들 수 없습니다.
- 서브테스크 고려했으나 시간초과(50점)
서치해보니 구간합으로 구하면 된다고 해서 열심히 풀었는데 자꾸 50점 줌 ..
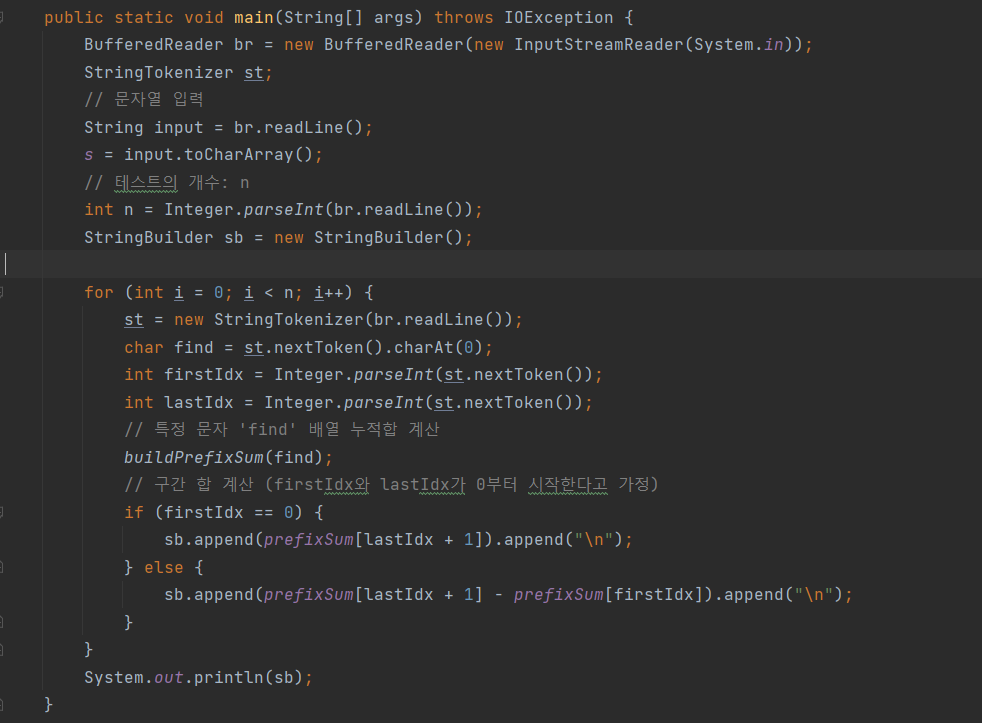
처음엔 다음과 같이 로직을 생각해주고 코드를 작성했습니다.
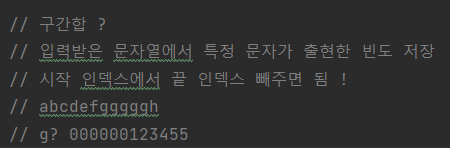
main
prefixSum
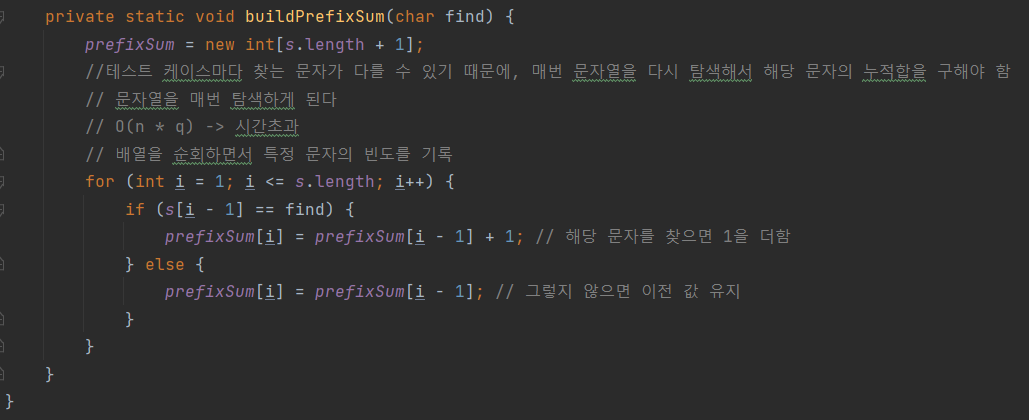
prefixSum을 main에서 미리 계산해 두고 한 번만 사용해야 속도 향상에 의미가 있지만, 테스트 케이스마다 찾는 문자가 달라지기 때문에, 각 테스트마다 문자열을 처음부터 다시 탐색하게 되어 시간을 단축할 수 없는 코드입니다.
만약 찾는 문자가 하나로 고정되어 있다면 의미있는 방법입니다.
이걸 해결하려면, 모든 알파벳(a - z)에 대한 빈도를 한번만 구해놓고, 찾으려는 테스트 문자 별로 값을 참조하여 사용하면 됩니다.
- 모든 알파벳에 대한 빈도를 미리 구해두고, 해당 값을 참조하는 방식(100점)
다음과 같이 26개의 행을 가진 2차원 배열을 선언해 모든 알파벳 소문자가 문자열에 출현한 빈도를 계산하여 해당 인덱스에 저장해주면 됩니다.
prefixSum = new int[26][length + 1];
이 방법을 사용하면, test케이스 별로 알파벳이 달라져도 이미 저장된 값을 꺼내와 쓰면 되기 때문에 추가적인 탐색은 필요하지 않습니다.
전체 시간 복잡도는 O(n) (문자열을 순회하며 알파벳 빈도를 계산) + O(q) (쿼리 처리)입니다.
code
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.IOException;
import java.util.StringTokenizer;

public class Main {
    static int[][] prefixSum;
    static char[] s;

    public static void main(String[] args) throws IOException {
        BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
        StringTokenizer st;
        String input = br.readLine();
        s = input.toCharArray();
        int length = s.length;

        prefixSum = new int[26][length + 1];
        // 문자열을 순회하면서 각 문자의 빈도 누적합을 계산
        //O(n)
        for (int i = 1; i <= length; i++) {
            int currentCharIndex = s[i - 1] - 'a'; // 현재 문자의 알파벳 인덱스 계산
            for (int j = 0; j < 26; j++) {
                prefixSum[j][i] = prefixSum[j][i - 1];
            }
            // 현재 문자의 빈도 추가
            prefixSum[currentCharIndex][i]++;
        }
        int n = Integer.parseInt(br.readLine());
        StringBuilder sb = new StringBuilder();

        // 각 테스트 케이스 처리
        // O(q)
        for (int i = 0; i < n; i++) {
            st = new StringTokenizer(br.readLine());
            char find = st.nextToken().charAt(0);
            int firstIdx = Integer.parseInt(st.nextToken());
            int lastIdx = Integer.parseInt(st.nextToken());
            int charIndex = find - 'a';
            int result = prefixSum[charIndex][lastIdx + 1] - prefixSum[charIndex][firstIdx];
            sb.append(result).append("\n");
        }
        // 총 시간복잡도 : O(n+q)
        System.out.print(sb.toString());
    }
}