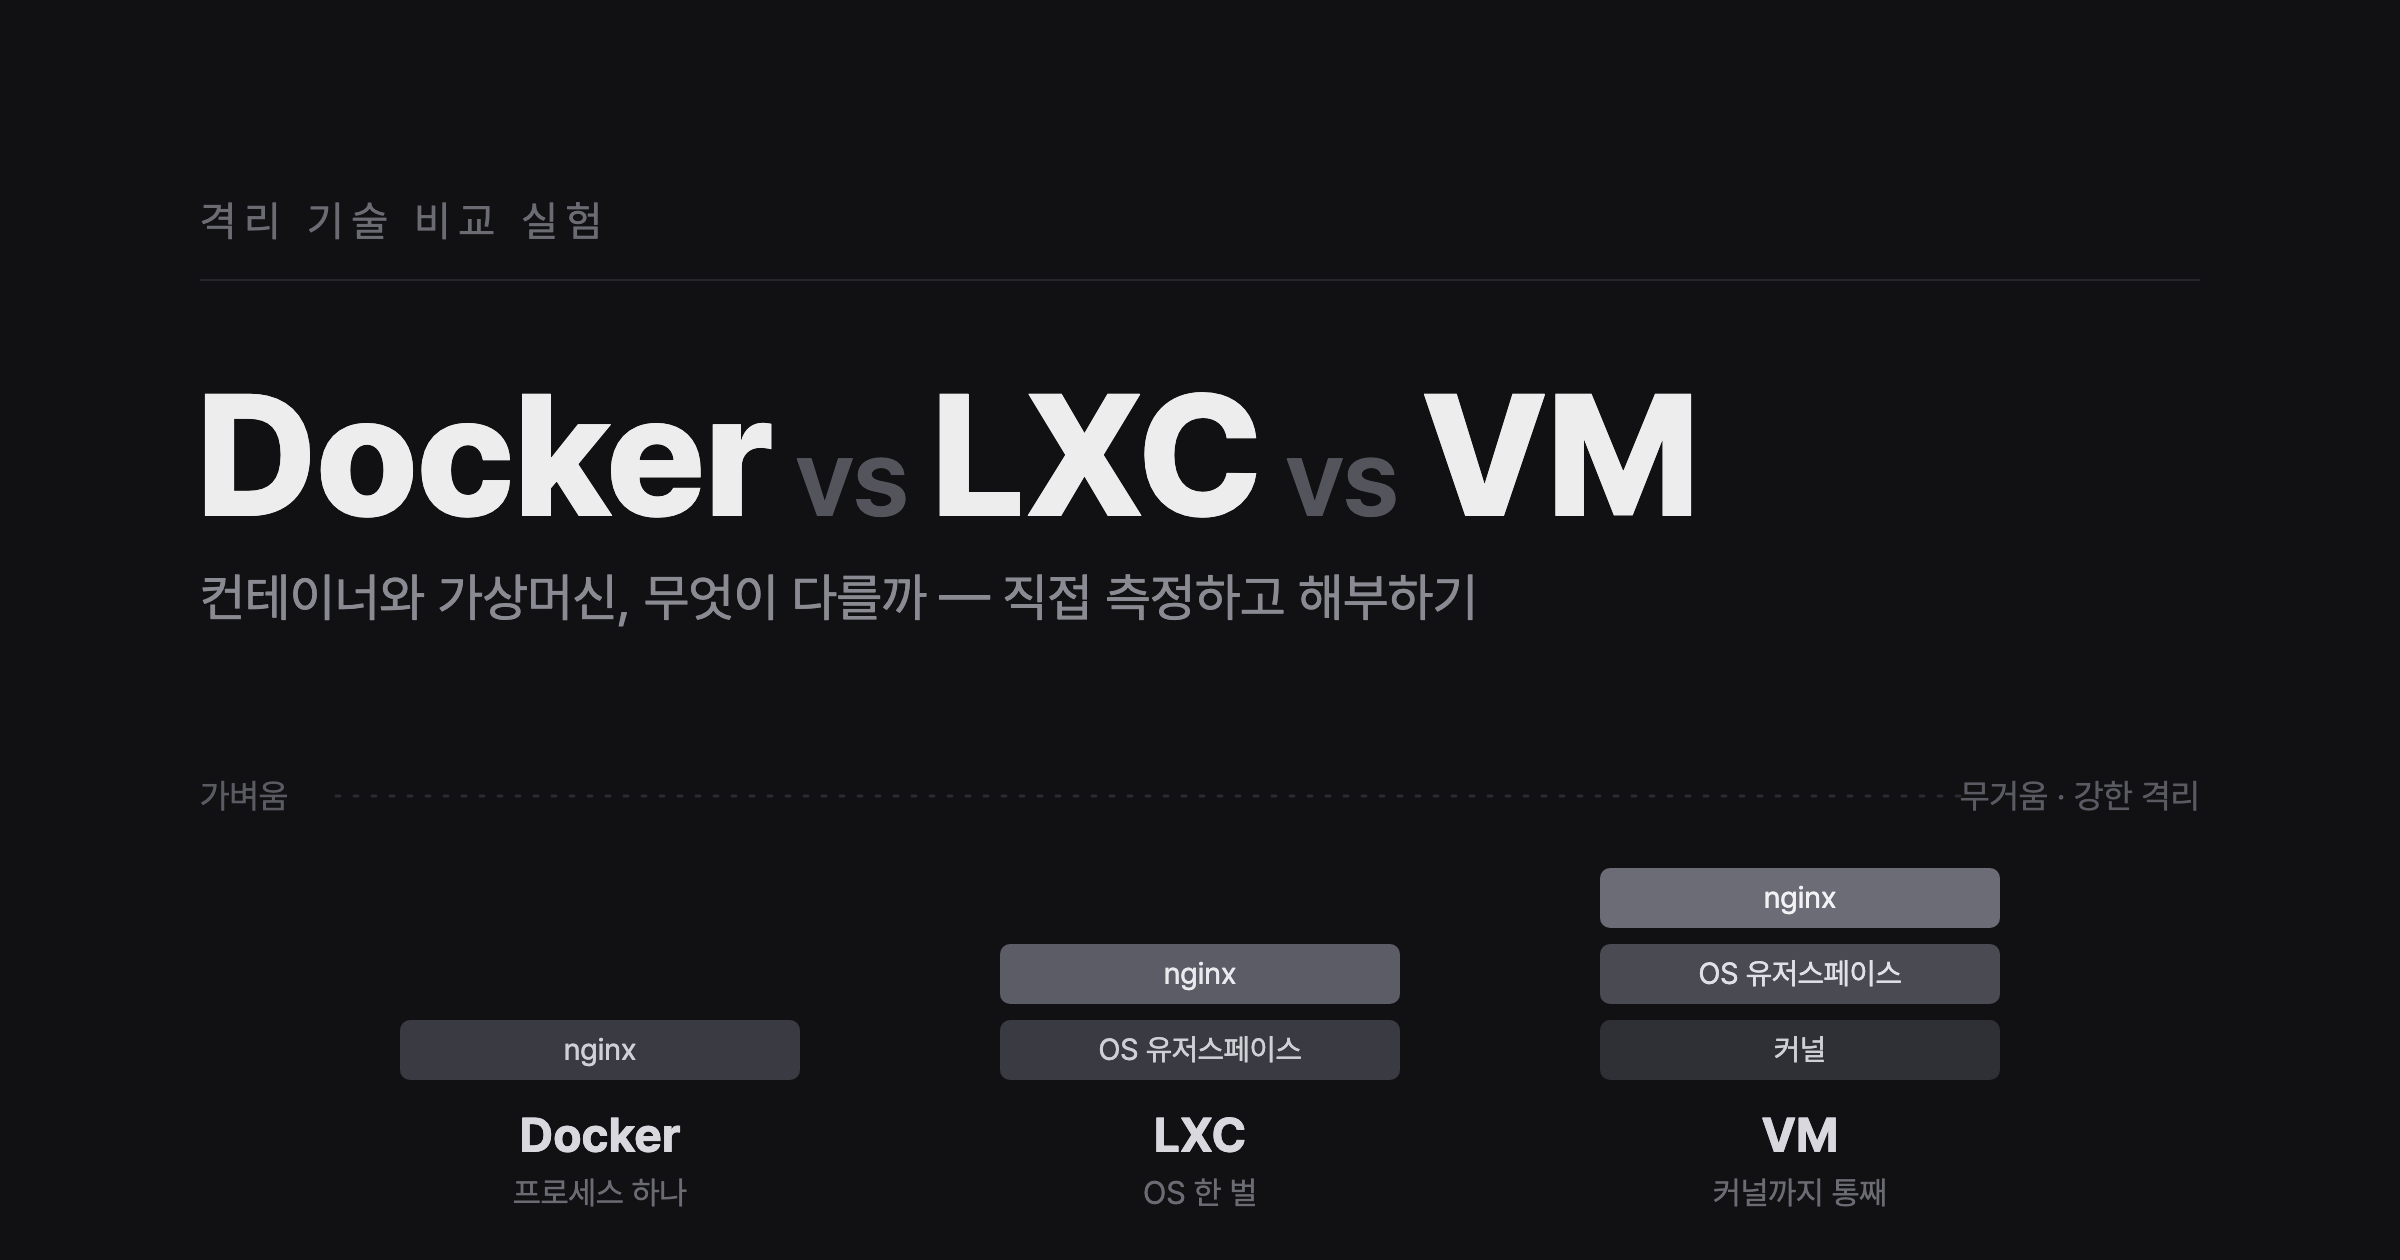
환경 구축에 이어 실습을 통해 실제 리소스 사용 및 격리 수준을 측정하는 문서입니다.
측정 원칙: 세 tier를 같은 잣대·같은 범위로 잽니다.
3-1. 메모리
- RSS (Resident Set Size) — 프로세스가 지금 RAM에 올린 메모리. 공유 부분도 각자 세서 여러 개 더하면 부풀려짐.
psRSS 합산 — nginx master+worker RSS를 다 더한 값. 워커 공유분을 중복 계산 → 과대- 페이지 캐시 — 파일 읽을 때 커널이 RAM에 임시 저장. 앱 실사용 아니며 언제든 버림. apt 후 부풀어 보임.
- cgroup
memory.current— cgroup 총 메모리. 페이지 캐시 포함anon(익명 메모리) 채택 — 파일과 무관한 힙/스택. 캐시 제외 → 진짜 실사용- PSS (Proportional Set Size) — 공유 메모리를 나눠서 셈. RSS 중복 보정. 정밀 측정용.
측정 명령
# (a) ps RSS 합산 — 프로세스 RSS를 전부 더함
ps -o rss= -C nginx | awk '{s+=$1} END{print s" KB"}'                       # VM(host)
lxc exec lxc-nginx -- sh -c "ps -o rss= -C nginx | awk '{s+=\$1} END{print s\" KB\"}'"  # LXC
docker stats --no-stream --format '{{.MemUsage}}' docker-nginx              # Docker(cgroup)

# (b) anon — 캐시 제외 익명 메모리 (정본)
docker exec docker-nginx awk '/^anon /{printf "%.1f MB\n",$2/1048576}' /sys/fs/cgroup/memory.stat
lxc exec lxc-nginx     -- awk '/^anon /{printf "%.1f MB\n",$2/1048576}' /sys/fs/cgroup/memory.stat        # 컨테이너 전체
lxc exec lxc-nginx     -- awk '/^anon /{printf "%.1f MB\n",$2/1048576}' /sys/fs/cgroup/system.slice/nginx.service/memory.stat  # nginx만
awk '/^anon /{printf "%.1f MB\n",$2/1048576}' /sys/fs/cgroup/system.slice/nginx.service/memory.stat        # VM nginx만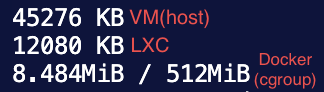
(a) ps RSS 합산 - 프로세스 RSS를 전부 더함
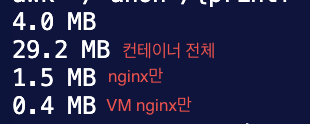
(b) anon - 캐시 제외 익명 메모리 (정본)
왜 anon으로 갔나
| 잣대 | VM | LXC | 문제 |
|---|---|---|---|
ps RSS 합산 | 45,276 KB | 12,080 KB | 공유 라이브러리를 워커 수만큼 중복 계산 → 과대 |
cgroup memory.current | — | 374 MiB | 페이지 캐시(apt 설치 잔여) 포함 → 과대 |
**anon** | 0.4 MB | 1.5 MB | 캐시·파일 기반 메모리 제외한 앱 실사용 → 채택 |
LXC 하나만 봐도 memory.current 374 MiB → anon 1.5 MB.
차이 372 MiB가 전부 페이지 캐시였습니다.
잣대를 바꾸자 수백 배 차이가 사라졌습니다.
3-1-1. 서비스 단위
| tier | nginx anon |
|---|---|
| VM | 0.4 MB |
| LXC | 1.5 MB |
| Docker | 4.0 MB |
→ 모두 5 MB 미만. nginx 서비스 자체는 격리 기술과 무관하게 가볍습니다.
3-1-2. 인스턴스 단위
| tier | 메모리 | 담는 범위 |
|---|---|---|
| Docker 컨테이너 | 4.0 MB | 앱 프로세스만 |
| LXC 컨테이너 | 29.2 MB | OS 유저스페이스 통째 (systemd·journald·… + nginx) |
| VM(게스트) | ~1.6 GB † | 커널 + OS + 상주 서비스(ClamAV·Teleport 등) |
† VM 값은
free -h의 게스트 전체used로, ClamAV(~1GB)·Teleport 등 팀 관리 SW가 대부분입니다.VM 고유 비용이 아니며, 다른 두 tier와 범위가 다릅니다.
3-2. 디스크
docker image inspect nginx:latest --format '{{.Size}}' | awk '{print $1/1024/1024" MB"}'  # Docker 이미지
lxc exec lxc-nginx -- du -sxh /                                                            # LXC rootfs
df -h /                                                                                     # VM 전체 디스크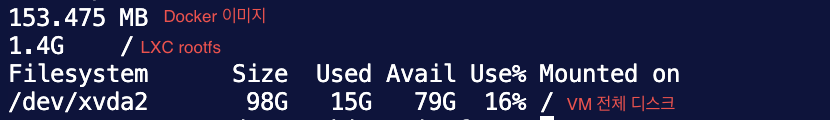
| tier | 디스크 | 범위 |
|---|---|---|
| Docker 이미지 | 153 MB | 앱 이미지(overlayfs 읽기전용 레이어, 공유) |
| LXC rootfs | 1.4 GB | OS 유저스페이스 rootfs |
| VM 디스크 | 15 GB used / 98 GB | 전체 OS 설치 (커널·부트·상주 SW 포함) |
앱 이미지 < OS rootfs << 전체 OS 설치.
3-3. IP 할당
ip -br addr show enX0                                                       # VM
docker inspect -f '{{range .NetworkSettings.Networks}}{{.IPAddress}}{{end}}' docker-nginx  # Docker
lxc list lxc-nginx -c n4 --format csv                                       # LXC
| tier | IP | 방식 |
|---|---|---|
| VM | 192.168.20.14/24 | LAN 대역 직속 (호스트↔LAN 간 NAT 없음) |
| Docker | 172.17.0.2 | 호스트 내부 docker0 브리지, NAT 뒤 |
| LXC | 10.189.17.131 | 호스트 내부 lxdbr0 브리지, NAT 뒤 (macvlan이면 LAN 직접도 가능) |
셋 다 사설 IP(192.168.x·172.16.x·10.x 전부 사설).
차이는 공인/사설이 아니라 어느 네트워크 + NAT 유무.
VM은 LAN 직속이라 다른 LAN 호스트가 바로 도달, 컨테이너는 호스트 내부 가상망이라 밖에서 오려면 포트 포워딩(-p/proxy)이 필요.
3-4. 프로세스 가시성 (호스트에서 컨테이너 nginx가 보이나)
ps -eo pid,user,args | grep -i '[n]ginx' # 호스트에서 3종 nginx가 다 보이는지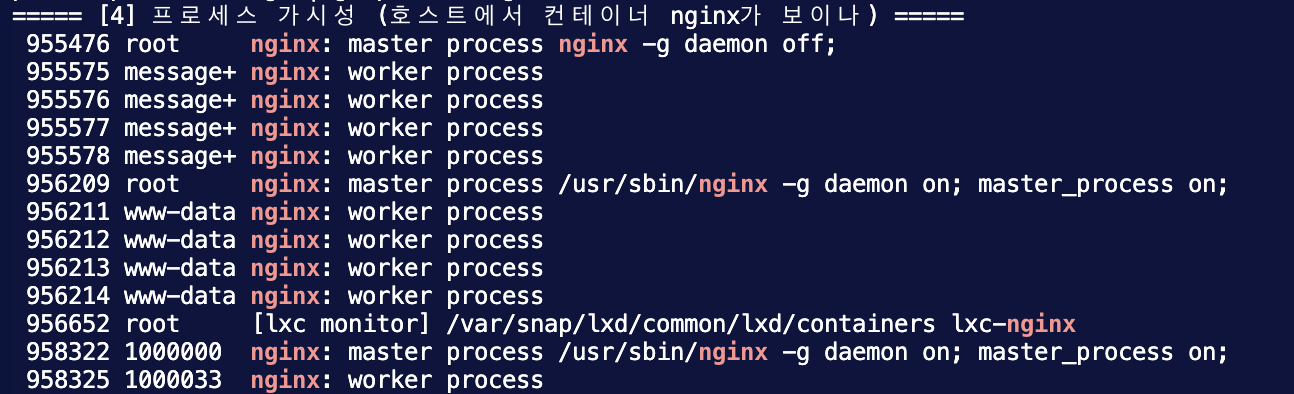
-
호스트
ps하나에 Docker·LXC nginx 워커까지 전부 노출 — 커널 공유라 컨테이너 프로세스도 결국 호스트 프로세스입니다. -
uid로 드러난 보안 격리 차이
- Docker: master uid 0(root) → 컨테이너 root = 호스트 root (기본 user namespace 미사용)
- LXC(LXD): master uid 1000000, worker 1000033 → user namespace 리매핑, 컨테이너 root = 호스트 비특권 유저
- → LXD 기본 unprivileged(안전), Docker 기본 root.
-
VM은 하이퍼바이저에서 단일 프로세스로만 보이고 내부는 불투명합니다.
ps의 uid 숫자는 어디서 오나:USER 칸은 uid를 이름으로 바뀔 것(이름 없으면 숫자). root=uid 0.
워커의
www-data=uid 33(호스트 nginx),message+=uid 101(Docker 이미지의 nginx 유저가 호스트 uid 101에 매핑 → 호스트에선 messagebus라 잘려 표시).LXC의
1000000·
1000033은 LXD user namespace 오프셋: LXD가/etc/subuid에 컨테이너용 대역을 1000000부터 예약→
컨테이너 uid N = 호스트 (1000000 + N).그래서 컨테이너 root(0)→1000000, www-data(33)→1000033.
LXC vs LXD
LXC = 커널 기능(namespace+cgroup)으로 시스템 컨테이너를 만드는 원조 저수준 기술·도구(
lxc-create등)입니다.LXD = 그 위에 얹은 관리 데몬(Canonical): REST API·친화적 CLI·이미지·스냅샷·네트워크 관리.
함정: LXD의 CLI 명령이
lxc(예:lxc launch) — 우리가 쓴 게 LXD.tier 이름은 LXC(기술)지만 실제 도구는 LXD. (2023년 커뮤니티 Incus로 포크; 이 서버는 LXD snap 사용.)
3-5. 파일시스템 격리
docker inspect -f 'graphdriver={{.GraphDriver.Name}}' docker-nginx   # Docker
lxc exec lxc-nginx -- findmnt -no FSTYPE,SOURCE /                    # LXC
findmnt -no FSTYPE,SOURCE /                                          # VM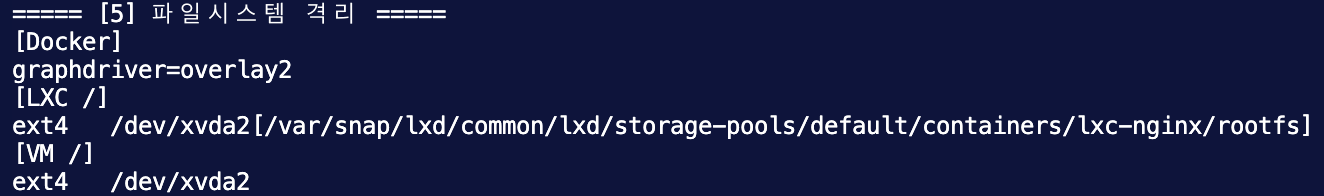
| tier | 마운트 | 방식 |
|---|---|---|
| Docker | overlay2 | overlayfs union (이미지 레이어 + copy-on-write) |
| LXC | ext4 /dev/xvda2[…/containers/lxc-nginx/rootfs] | 호스트 디스크의 디렉터리 rootfs (dir 백엔드) |
| VM | ext4 /dev/xvda2 | 전용 블록 디바이스 |
overlay2: 진짜 디스크가 아니라 이미지 레이어들을 겹쳐 만든 union 파일시스템입니다.
읽기전용 이미지 + 쓰기 레이어를 포갠 거.
LXC 대괄호 안에 lxc-nginx/rootfs 경로가 있으면 LXC입니다.
-
/dev/xvda2 = 호스트랑 같은 디스크
-
[...rootfs] = 그 디스크 안의 특정 폴더가 컨테이너의 /로 마운트됐다는 뜻
-
→ 즉 LXC의 루트는 호스트 디스크에 있는 폴더 하나.
별도 디스크가 아니라 "너는 이 폴더만 /로 봐" 하고 시야를 자른 것입니다(mnt namespace).
VM은 대괄호 없이 통짜 /dev/xvda2 = 호스트(=이 VM 게스트) 자신의 루트입니다.
전용 블록 디바이스를 통째로 자기 /로 쓰는 것이죠.
격리 강도
Docker/LXC(호스트 디스크 위에 얹힘) < VM(자기 디스크).
특히 LXC는 호스트 파일시스템의 서브트리라, 호스트에서 그 폴더(/var/snap/lxd/.../lxc-nginx/rootfs) 열면 컨테이너 안 파일이 그대로 보임.
3-6. 포트 노출 / NAT
ss -tlnp | grep -E ':80|:8080|:8081'    # 누가 각 포트를 잡고 있나
iptables -t nat -S | grep 8080          # Docker의 DNAT 규칙
| tier | 리스너 | 메커니즘 |
|---|---|---|
| VM | nginx가 0.0.0.0:80 직접 | 직접 bind, NAT 없음 |
| Docker | docker-proxy가 0.0.0.0:8080 | iptables DNAT + docker-proxy |
| LXC | lxd가 *:8081 | LXD proxy device (유저스페이스 포워드 → 컨테이너 127.0.0.1:80) |
docker NAT 규칙: -A DOCKER ! -i docker0 --dport 8080 -j DNAT --to-destination 172.17.0.2:80
→ VM은 직접 bind, 컨테이너는 NAT/proxy 경유. (LXC가 LAN IP면 VM처럼 직접 bind 가능)
쉽게 설명하기
VM — nginx가 직접 문을 잡는다.
- VM은 자기 IP를 가진 독립 건물입니다.
nginx가 그 건물 80호 문을 직접 열고 앉아 있습니다.
손님이 VM_IP:80 두드리면 곧장 nginx가 받습니다. 중간 다리 0개.- LISTEN 0.0.0.0:80 users:(("nginx",...)) ← 문 지키는 게 nginx 본인
Docker — 커널이 택배를 재배송한다 (DNAT + 안내원)
Docker 컨테이너 nginx는 건물 안쪽 사설 주소(
172.17.0.2:80)에 숨어 있어서, 밖에선 그 주소로 못 옵니다.
그래서 -p 8080:80으로 이런 규칙을 심었습니다: "정문 8080으로 온 손님은 → 안쪽 172.17.0.2:80으로 보내라"
이게 DNAT(커널이 패킷 목적지를 바꿔치기하는 택배 재배송):-A DOCKER ! -i docker0 --dport 8080 -j DNAT --to-destination 172.17.0.2:80거기에 docker-proxy라는 안내원 프로세스도 8080 앞에 서 있습니다(로컬 접속·백업용).
그래서 문지기가 nginx가 아니라 docker-proxy로 보입니다
LXC — lxd가 직접 받아서 넘긴다 (응용 프록시)
- LXC 컨테이너 nginx도 사설망(
10.189.17.131:80)에 갇혀 있습니다.
그래서 우리는 이렇게 노출했습니다:lxc config device add lxc-nginx web proxy listen=tcp:0.0.0.0:8081 connect=tcp:127.0.0.1:80
이건 커널 NAT가 아니라 lxd 프로세스 자신이 안내원이 되는 방식입니다.- lxd가 8081 앞에 서 있다가 오는 손님을 컨테이너 안 80으로 넘겨줘: LISTEN *:8081 users:(("lxd",...)) ← 문지기가 lxd
3-7. 장애 영향 범위
안전장치: 각 스트레스 5~10초 자동 종료, cgroup 상한(CPU 1 / RAM 512MiB) 확인, 매 단계 이웃·호스트 점검.
상한 확인:
mem_limit=536870912B(512MiB),cpu(nano)=1000000000(1.0 CPU).
3-7-1. CPU 폭주
docker exec -d docker-nginx sh -c 'for i in 1 2 3 4; do timeout 5 yes >/dev/null & done'
sleep 2
docker stats --no-stream --format '{{.Name}}: cpu={{.CPUPerc}}' docker-nginx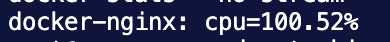
결과:
-
docker cpu = 100.52%— 컨테이너 안 4코어 스핀 시도가 1코어(≈100%)에 캡.
호스트 4코어 중 3개는 자유. -
이웃 VM:80 / LXC:8081 = 200 유지. 5초 후 자동 종료(
cpu=0%).
주의: 호스트
load average는 0.00으로 안 움직였습니다.
"부하 없음"이 아니라
(1) load는 1분 평균이라 5초 버스트에 둔감.
(2) cgroup이 초과분을 throttle(재움)해 실행 대기열에 안 잡힘.진짜 증거는 CPU가 100.52%에 캡된 것 + 이웃 200.
결론: cpu.max가 폭주를 1코어로 봉쇄. 나머지 코어·이웃 무사.
3-7-2. Memory 폭주
echo "===== 메모리 폭주 봉쇄 (docker-nginx 상한 512MiB) ====="
mem(){ docker exec docker-nginx cat /sys/fs/cgroup/memory.current 2>/dev/null | awk '{printf "%.0fMiB",$1/1048576}'; }
nb(){ echo "VM:$(curl -s -o /dev/null -w %{http_code} localhost:80) LXC:$(curl -s -o /dev/null -w %{http_code} localhost:8081)"; }

echo "[전 ] 컨테이너 mem=$(mem)  이웃 $(nb)  호스트여유=$(free -m|awk '/Mem/{print $7}')MiB"
docker exec -d docker-nginx sh -c 'timeout 15 tail /dev/zero'          # 메모리 폭주 주입
peak=0; for i in $(seq 1 30); do m=$(docker exec docker-nginx cat /sys/fs/cgroup/memory.current 2>/dev/null); [ -n "$m" ] && [ "$m" -gt "$peak" ] 2>/dev/null && peak=$m; sleep 0.15; done
echo "[중 ] 피크 mem=$(awk "BEGIN{printf \"%.0fMiB\",$peak/1048576}")  <- 512MiB 한계서 봉쇄됨"
echo "[OOM] $(dmesg | grep 'Memory cgroup out of memory' | tail -1)"
echo "[후 ] 컨테이너 $(docker ps --filter name=docker-nginx --format '{{.Status}}'), mem=$(mem)  이웃 $(nb)  호스트여유=$(free -m|awk '/Mem/{print $7}')MiB"
메모리 폭주 봉쇄 — 관측 결과
512MiB 상한의 Docker 컨테이너에서 무한 메모리 폭주(tail /dev/zero)를 주입하고, cgroup이 이를 봉쇄하는 과정을 관측했습니다.
[전 ] mem=4MiB          이웃 200/200   호스트여유 2017MiB
[중 ] 피크 mem=512MiB    ← 한계선에서 딱 멈춤
[OOM] Killed process (tail) anon-rss:519040kB   ← 커널이 사살
[후 ] 컨테이너 Up 45h, mem=4MiB   이웃 200/200   호스트여유 1958MiB
결과 해석
-
피크 512MiB — cgroup
memory.max가 폭주를 상한에 정확히 가뒀다는 증거. -
anon-rss:519040kB≈ 507MiB — tail이 한계 직전까지 자라다 잘림. 숫자가 딱 맞아떨어짐. -
Killed process 1050799 (tail)— 죽은 건 폭주범 tail 하나뿐. nginx는Up 45 hours로 생존. -
이웃 VM·LXC 200 유지 — 폭주 전후로 그대로.
호스트 여유가 2017 → 1958 MiB로 ~59MiB 줄었지만, 폭주가 새어나간 게 아니라 ClamAV·페이지 캐시 등 정상 잔변동입니다.
512MiB가 유출됐다면 여유가 그만큼 급감했어야 합니다. → 호스트는 사실상 그대로 = 봉쇄 성공.
결론: 폭발 반경이 컨테이너 cgroup 안에 갇혔습니다(Memory cgroup out of memory).
nginx·호스트·이웃 전부 무사합니다.
3-7-3. VM 파트 — 커널 격리 (Mac 일회용 VM)
환경: Mac(Apple Silicon) +
multipassUbuntu 24.04 VM (1 CPU / 512M).
팀 서버(x86 Xen)와 환경은 다르나 격리 원리는 동일 → 원리 시연으로 사용.
실험 A - 무제한 fork bomb
multipass exec blast-vm -- bash -c ':(){ :|:& };:'-
결과: VM이 안 뻗었습니다, nginx 계속 200.
-
원인: 모던 systemd가 유저 슬라이스에
TasksMax상한을 기본 적용
→ fork bomb이 유저 슬라이스 안에 갇힘.
새 로그인(ssh exec)은 막혔지만system.slice의 nginx는 무사함.
-
교훈: fork bomb 방어는 요즘 OS 기본 탑재. + 하이퍼바이저가 VM을 1CPU/512M로 캡하니 Mac은 애초에 안전.
실험 B - 커널 패닉
multipass exec blast-vm -- sudo bash -c 'echo 1 > /proc/sys/kernel/sysrq; echo c > /proc/sysrq-trigger'| 패닉 전 | 패닉 후 | |
|---|---|---|
| VM | uptime 79s, nginx 200 | nginx TIMEOUT, ssh 연결 불가 = 완전 다운 |
| MAC boot time | Jul 23 23:05:26 | Jul 23 23:05:26 (불변) |
| MAC uptime | 47일 | 47일 (계속 증가) |
-
게스트 커널을 강제 패닉 → VM 네트워크·ssh·nginx 전부 사망.
25초 후에도 다운 유지(panic=0라 자동 재부팅 안 함). -
Mac boot time 1초도 안 변함, uptime 47일 그대로 = Mac 커널 무사.
-
증명: VM은 자기 커널을 가짐. 게스트 커널을 죽여도 호스트(Mac) 커널은 하드웨어 경계로 분리돼 무영향.
3-7-4. 컨테이너 vs VM — blast radius 종합
| 공격 | 컨테이너 (팀 서버) | VM (Mac) |
|---|---|---|
| CPU 폭주 | cgroup cpu.max가 1코어로 봉쇄 | 하이퍼바이저가 1 vCPU로 봉쇄 |
| 메모리 폭주 | cgroup memory.max OOM-kill로 봉쇄 | 하이퍼바이저가 512M로 봉쇄 |
| fork bomb | cgroup / systemd TasksMax로 봉쇄 | systemd TasksMax • 하이퍼바이저 |
| 커널 패닉 | = 호스트 커널 패닉(공유 커널; 런타임이 /proc 차단) | 게스트 커널만 죽고 호스트 무사 |
컨테이너 격리는 소프트웨어 경계(cgroup+namespace)로 자원을 봉쇄하되 커널을 공유합니다.
→ 커널 레벨 실패·탈출엔 근본적으로 취약합니다.(런타임이 일부 차단할 뿐)
VM 격리는 하드웨어 경계로 커널까지 분리합니다. → 커널 패닉조차 게스트 안에 갇힙니다.
이것이 격리 강도 Docker < LXC < VM의 근본 이유죠.
3-8. 스냅샷
Docker Commit (팀 서버)
time docker commit docker-nginx nginx-snap:v1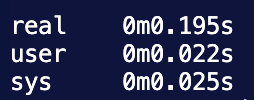
0.195s, 증분 0B (이미지 161MB지만 전부 base 레이어 공유).
overlay2 = 레이어 CoW라 즉시.
CoW (Copy on Write)
바뀔 때(쓸 때) 복사하는 것입니다.
스냅샷 뜨는 순간엔 실제로 안 베끼고, 나중에 뭔가 바뀔 때 그 부분만 복사하는 방식입니다.
LXC snapshot (팀 서버)
time lxc snapshot lxc-nginx snap1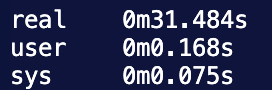
- 31.5s (!), STATEFUL=NO (FS만, 메모리 X).
- 이 서버 LXD가 dir 백엔드 → 스냅샷 = 1.4GB rootfs 통째로 복사합니다 (CoW 아님).
zfs/btrfs였으면 즉시.
dir 백엔드
그냥 평범한 폴더에 저장하는 것입니다.
스토리지 백엔드컨테이너 파일을 디스크에 실제로 어떻게 저장하는지의 방식(엔진).
LXD는 여러 개 중 고를 수 있습니다: dir, zfs, btrfs, lvm...
dir 백엔드는 그중 제일 단순한 것:
- 컨테이너 rootfs를 그냥 호스트의 평범한 폴더에 파일 그대로 넣음. (/var/snap/lxd/.../lxc-nginx/rootfs — 위에서 봤던 그 경로)
- CoW 같은 똑똑한 기능이 없음. 그래서 스냅샷 = 그 폴더를 통째로 복사(cp/rsync).
1.4GB면 1.4GB 다 베낌 → 31초.- 장점: 단순, 아무 파일시스템에서나 됨.
- 단점: 스냅샷·복제 느리고 공간 두 배로 먹음.
반대로 zfs/btrfs 백엔드를 골랐으면 → CoW라서 스냅샷을 즉시. 이 서버는 dir 방식이라 느렸던 것입니다.
| tier | 시간 | 단위 | 메커니즘 |
|---|---|---|---|
| VM | 0.044s | 디스크(+RAM) 통째 | qcow2 CoW |
| Docker | 0.18s | 이미지 레이어 (+볼륨) | overlay2 CoW |
| LXC | 38.5s | rootfs 통째 | dir 전체 복사 |
VM - qcow2 CoW라 즉시. (정지 상태 → 디스크만. 실행 중이면 RAM도)
의외로 제일 느린 건 VM이 아니라 LXC였고, 오히려 VM이 제일 빨랐습니다.
→ 스냅샷 속도·크기는 tier(컨테이너 vs VM)가 아니라 스토리지 백엔드가 좌우하는 것을 알았습니다.
- CoW(overlay2·qcow2·zfs·btrfs): 증분만 기록 → 즉시.
- 전체복사(LXD dir): rootfs 통째 복사 → 느림.
하지만 무엇을 담느냐는 tier 고유: Docker=FS diff(이식성 최고), LXC=rootfs, VM=디스크(+실행 시 RAM).
속도는 백엔드, 단위·이식성은 tier 입니다.
결론
-
앱 무게는 어디든 비슷합니다. 차이는 격리 단위의 무게에서 발생합니다.
무게 순서: Docker < LXC < VM — 메모리·디스크 모두 동일 경향.
-
격리·보안도 같은 스펙트럼: 컨테이너 프로세스는 호스트에 노출되고, 네트워크·FS도 직접(VM) vs NAT/union(컨테이너).
단 LXD는 user namespace로 컨테이너 root를 비특권화해 기본 보안은 Docker보다 강합니다.
- 장애 격리: 컨테이너는 cgroup으로 자원 폭주를 봉쇄하되 커널 공유, VM은 커널 패닉조차 게스트에 가둡니다(커널 분리).
- 스냅샷 속도는 tier가 아니라 스토리지 백엔드(CoW vs 전체복사)가 좌우 — 직관에 속으면 안됩니다.
- 측정 규율: 반드시 같은 잣대(
anon등 캐시 제외), 같은 범위(service vs instance)를 맞출 것.
다음엔 마지막으로 Docker vs LXC vs VM 뭘 골라야 하는지 정리하는 문서입니다.
감사합니다.
정택준
Team: https://nangman.cloud/ko
E-mail: taekjunnnn@nangman.cloud